Gemini Live 開始將語音對話變成可執行動作,減少你在應用程式之間來回切換。這次更新瞄準的是日常處理待辦事項時最容易中斷節奏的那一步。
一邊講電話、一邊行路,或者手上正做緊其他事時,最麻煩往往唔係記低待辦,而係之後仲要再打開日曆、記事或清單工具逐個輸入。Gemini Live 今次更新,正正係想將語音對話直接接駁到生產力工作流,令你講完就可以即時推進下一步,而唔係停留喺一段只會回應問題嘅聊天。
Google 把這次升級放在 Gemini Live 內,主打用聲音委派待辦事項。公開內容雖然未詳細列出所有支援動作,但方向已經相當明確:Gemini app 不再只做對答,而係更貼近可代你整理、記錄同安排事項嘅 Agentic 工具。對平日靠手機快速處理雜務、會議後即場補記重點,或者想減少手動輸入嘅人,分別會幾直接。
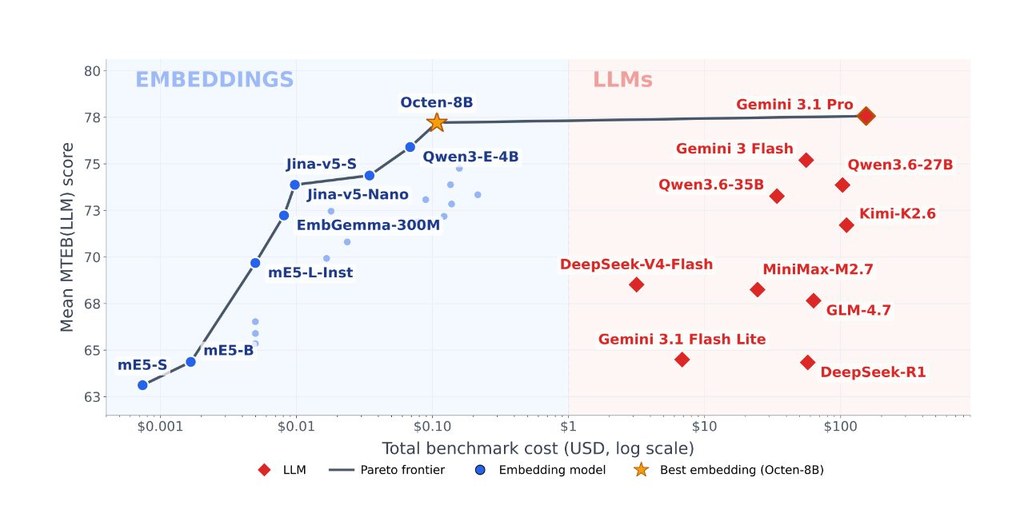
做語意搜尋、分類或文件聚類時,LLM已能在多項測試追上專門的文字嵌入模型;但每次評測成本最高相差1,431倍,令「是否應取代Embedding pipeline」成為成本與能力之間的取捨。本頁屬研究論文內容,並非可直接下載的單一模型頁面;未有提供可確認的 base model 或 fine-tuned from 資訊,因此無法判定某個模型的原始基礎模型。
研究比較10個、來自6個家族的 large language models (LLMs),以及26個參數量由118M至14B的 embedding models,測試涵蓋37項 MTEB(LLM) 任務,包括分類、semantic textual similarity (STS)、聚類、pair classification 和 retrieval。最佳 LLM Gemini 3.1 Pro 得分77.6,最佳 embedding model 得分77.2,差距只有0.4分。
Embedding models 在分類、相似度和聚類表現較合適
LLM 在需要推理的 retrieval 任務較有優勢
LLM 每次 benchmark pass 成本約154美元,embedding model 約0.11美元
開源 LLM 在同一 GPU 上慢約2.5至736倍
reasoning tokens 佔 LLM inference 成本28%至81%
研究亦指出,降低 reasoning budget 對多數模型的 retrieval 品質沒有明顯傷害,反映混合式流程更合理:以 embedding model 負責大部分相似度搜尋,再把需要理解語境或多步推理的查詢交給 LLM。
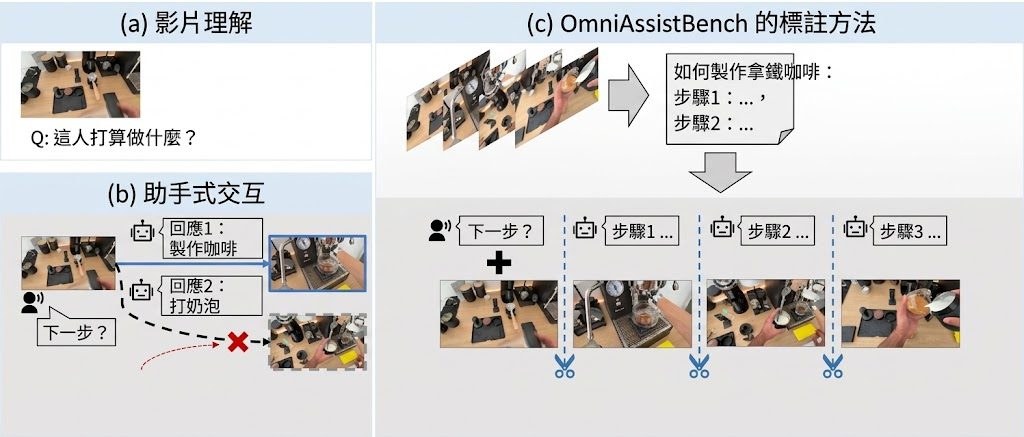
由 HKUST(香港科技大學)、The University of Hong Kong(香港大學) 與 The Chinese University of Hong Kong(香港中文大學) 及小紅書組成的開發團隊,將焦點放到一個很多多模態代理都未真正處理好的難題:影片唔再係幾秒剪輯,而係接近一個半鐘頭、仲要持續互動。StreamArena 屬於資料集與評測工具包,處理的是 continuous streaming video understanding,目標係用統一方法檢驗代理在長時間影音流之中,能否即時理解、隔一段時間後仍然記得內容,並在合適時機用工具或主動回應。