Diffusion Controller:讓模型更準確聽懂提示詞

Diffusion Controller以輕量控制網絡改善提示詞對齊,同時保留原有影像質素與生成穩定性。

Og image

當影像模型明白你要一隻「戴太陽眼鏡的蜥蜴」,卻只生成蜥蜴,或勉強加入眼鏡後令面部變形,問題往往不在畫面是否逼真,而在提示詞要求與生成結果之間難以取得平衡。Google Research提出的 Diffusion Controller,正是針對這種提示詞對齊與影像質素互相牽制的情況而設計的輕量「steering damper」網絡。
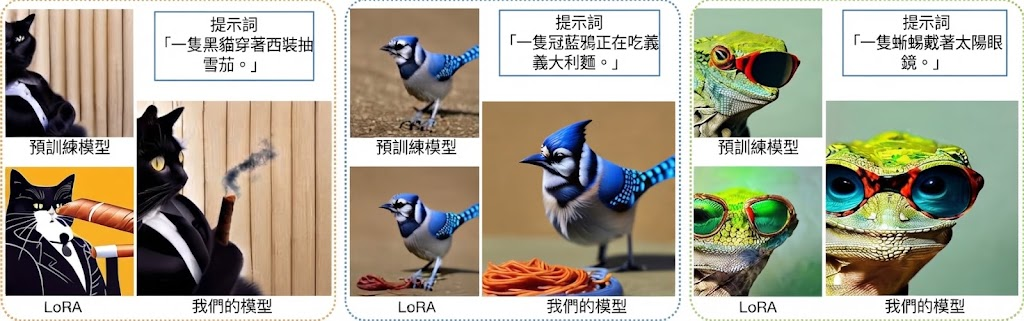
Diffusion Controller可以接到包括 access-restricted、closed-source 模型在內的現有影像生成模型,無需改動基礎模型的核心結構,便能在生成過程中施加更精準的控制。它將原本由隨機噪聲逐步還原成影像的 denoising process,重新理解為一個連續、平滑的 control problem,讓控制訊號不必只在個別步驟中硬性修正結果。

  • 改善文字提示與生成影像之間的 prompt alignment
  • 以輕量 add-on network 控制現有模型,兼容 access-restricted、closed-source 模型
  • 在提升指令符合度的同時,維持 baseline stability 和原有影像質素
  • 將 inference-time guidance 與模型微調放入同一套分析框架
  • white-box 版本在所述測試中取得相對 baseline model 的 90% 勝率

過往做法通常分成兩條路線:一類是在 inference time 使用 classifier-free diffusion guidance,調整文字提示對生成過程的影響;另一類則透過 parameter-efficient adapters,例如 LoRA、reward-weighted regressions 或 policy gradients,對模型行為進行較重的微調。Diffusion Controller嘗試以統一的數學語言連接這些控制方式,減少工程師靠反覆試驗,在使用者偏好、提示詞要求和影像質素之間摸索的需要。

Google Research表示,Diffusion Controller的輕量版本表現優於用於配合人類偏好的業界標準方法;完全解鎖、可直接修改模型內部權重的 white-box 版本,則相對 baseline model 取得 90% 勝率。這些結果反映項目適合需要精準遵循文字描述、同時不希望破壞原有生成穩定性的影像工作流,但提供的內容未包括下載連結、安裝步驟或完整使用流程,讀者仍需等待論文或官方程式碼資料作進一步驗證。
項目主頁 · Paper

Categories: Google, Gemini, Image, 影像處理, 提示詞, 框架

Dream-RSI:讓 AI 先在探索紀錄中演練,再投入昂貴的搜尋

Dream-RSI 把 AI 過往探索過程變成可重播的模擬環境,讓新策略先離線比較,再挑選勝出者投入下一輪搜尋,減少試錯成本。

Google

當 AI 要花數千輪提出和評估方案,探索方向選得不好,計算資源便會浪費在無效搜尋上。Dream-RSI 是一套用來改進 AI 探索策略的遞迴自我改進框架,讓策略先在既有探索紀錄中演練,再決定是否投入昂貴的線上搜尋。

它不另建一個學習出來的世界模型,而是把代理過往建立的探索樹當成可重播的模擬器。系統在線上收集搜尋歷史,再離線測試多個候選策略;選出的策略才會部署到下一輪,並帶回新的探索紀錄,逐步擴大可供演練的經驗池。這做法省去逐一實跑候選策略的成本,但模擬範圍受限於過往探索到的路徑,未曾出現的情況仍須在線上驗證。

目前公布的測試涵蓋演算法工程、數學最佳化及 GPU kernel 工程,共八項任務。在演算法工程中,與 Recursive Fixed Exploration 相比,下游執行速度提高 1.22 倍,探索計算量減少 1.74 倍,呼叫次數比 SimpleTES 少 162 倍;GPU kernel 的四項測試全部改善,同等預算下效能提高 2.09 倍。數學最佳化則有三項中的兩項達到或超越所選基線,結果仍需按任務解讀,不能視為所有搜尋問題都會有相同收益。

這套方法較適合需要長時間、多輪探索的演算法與工程研究團隊,尤其是每次線上評估成本高昂的工作。程式碼仍在準備發布,現階段可閱讀技術報告與論文了解方法和結果;儲存庫尚未提供可直接安裝執行的公開版本。

  • 探索樹被重用為策略演練環境,不必為每個候選策略重新執行完整搜尋。
  • 每輪勝出的策略會投入線上搜尋,並補充新的探索歷史。
  • 已測試三個領域、八項任務,GPU kernel 測試四項全有改善。
  • 模擬器只涵蓋已探索的搜尋空間,公開程式碼仍在準備中。

項目主頁 · GitHub

Categories: 開源, Embedding, Google, Gemini, 框架

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bash 同 frames,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, 庫, Anthropic, 動畫, Dataset 數據集

jarvis-voice-butler:識睇住嘢同你傾偈 + 開瀏覽器幫你查資料

用講嘢就可以叫 AI 幫你上網、搜尋、填表,仲配上一把英式管家口吻。這個項目把 LiveKit Agents、Google Gemini Live 同 Playwright 串成一套聲控代理人。

Repository image for ruxakK/jarvis-voice-butler

聲控助手最麻煩嘅地方,往往係講完一句佢就要重新聽成段指令,又或者根本無法直接代你落手做嘢。Jarvis 直接針對呢個卡位,把 LiveKit Agents 框架、Google Gemini 3.1 Flash Live 即時語音模型,同 Playwright 操控嘅 Chromium 瀏覽器三樣嘢扣埋一齊。你可以理解成一個識講英式冷笑話嘅 AI 管家:你開口叫佢搜尋資料、撳掣、打字、捲頁、讀網頁內容,佢都會即時用「Enceladus」把聲回應你,過程仲支援自適應打斷同搶先生成。

對比起一般只能對答嘅語音 bot,呢個項目最大嘅突破係將語音輸入直接打通到瀏覽器操作層。佢內建十一個工具,包括開網址、搜尋、讀取同檢查頁面、撳掣、打字、捲動、撳掣鍵同截圖,仲有一個 confirm_browser_action 安全閘,去處理會造成實際後果嘅動作,例如提交表單或者刪除資料。視訊鏡頭輸入亦支援,等 AI 可以「睇到」你。

How to build a JARVIS AI Voice Agent for FREE | Full Livekit Tutorial (2026)

如果你想由頭砌起,作者用 uv 管理 Python 依賴,前端就用 Next.js 加 React,而家嘅程式庫亦用 Python 寫評估測試,覆蓋代理行為、瀏覽器操作同 prompt 表現。前端介面跟住會播一段自訂粒子動畫,連 Flutter 手機客戶端都一齊包埋,等你可以用手機當遙控。

呢類項目最適合做內部自動化研究助理,或者需要示範 Computer-use agents(CUAs)點樣融入聲音介面嘅團隊。值得留意嘅限制係實作仍處於早期階段,prompt 同安全策略都係寫死嘅版本,如果你想用佢處理高風險任務,仍然要自行加多一層審批同監察。

GitHub

Categories: 開源, Agentic, Google, Gemini, Audio, 框架, 工具, Python, 庫, 語音, 動畫

Wenyi 把整本書放進記憶:一次譯完一本書,角色名終於唔再走樣

Wenyi 是一款針對小說、專書同長篇敘事嘅開源翻譯工具,主打逐章掃描、術語即時對齊同可斷點續譯,支援 DeepSeek、OpenAI、Gemini 等多個模型供應商。

wenyi emblem

好多人試過用大型語言模型 (LLM) 翻譯小說或學術專書,往往喺第三、四章就發現角色名譯咗另一個譯法,或者術語前後矛盾,要回頭逐段人手修正。Wenyi 就係針對呢個常見痛點而設計嘅 Python 開源工具,主打長篇文本嘅翻譯流程。佢會事先將全書掃描一次,為每個章節建立摘要同全書概要,再喺逐批翻譯時一齊注入,令模型對脈絡同角色關係有長期記憶。

工具同時內建術語管理模組,會隨翻譯過程自動抽取人名、地名同專有詞彙,並偵測前後唔一致嘅譯法,要求人手仲裁,再影響後續批次。咁樣嘅設計對譯者、編輯同人氣翻譯團隊特別有用,可以避免「譯到後期先發現譯名漂移」嘅慘況。Wenyi 仲提供可選嘅多階段品管:先以主力模型做初譯,再由較強模型做潤稿,最後以證據導向嘅方式做整書 AI 審閱,適合對品質要求高、但又想慳人手嘅場景。

操作上,每批翻譯都有 checkpoint 落盤,章節狀態有獨立追蹤,任何時候中斷都可以用同一個指令續譯。支援嘅模型供應商包括 DeepSeek、OpenAI、OpenRouter、OrcaRouter、Google Gemini、Ollama、vLLM 及任何 OpenAI 兼容端點,可分為三個方便嘅 tier,亦可每個操作揀唔同模型。輸出格式方面,佢會直接寫返入原 EPUB 嘅 XHTML 模板,嘗試保留樣式、圖片、目錄同錨點,對電子書排版敏感嘅讀者會幾啱用。

要注意嘅限制係,Wenyi 仍然依賴上游模型嘅語言能力同上下文窗口,對語氣、文風同微妙雙關嘅判斷無可避免會受模型本身限制;長篇翻譯嘅成本同時間亦會隨章節增加。文檔列明需要 Python 3.10 或以上,社群主要喺 Discord 運作。

重點摘要:
– 全書預掃描 (Whole-book prescan):每章摘要 + 全書概要同時注入翻譯批次
– 即時術語同衝突偵測,可人手決議後回寫後續翻譯
– 支援 DeepSeek、OpenAI、Gemini、Ollama 等多 LLM,可分三層 tier
– 提供 checkpoint 續譯,中斷後同一指令可接返
– 多階段品管:初譯 → 強模型潤稿 → 全書 AI 審閱,並原生保留 EPUB 排版

GitHub

Categories: 開源, Google, OpenAI, DeepSeek, Gemini, Image, 工具, Ollama, Python

Dr. Claw 把 AI 研究流程收進一個可審核工作台

一款開源 AI 研究助理,把文獻回顧、實驗、寫作整合在同一介面,讓人類決策與 AI 執行之間留下可追蹤的紀錄。

Dr. Claw

跑過 AI 研究的團隊都遇過同樣的痛:Claude Code、Gemini CLI 等命令行編碼代理(coding agents)能讀寫檔案、撐住長對話,但文獻回顧、構思、實驗、寫論文、投期刊這些步驟散落在聊天工具、IDE、終端機、寫作軟件之間,中間決策也難以回頭追溯。Dr. Claw(GitHub: OpenLAIR/dr-claw)針對的正正是這個碎片化問題——它不是另起爐灶造一個新代理,而是把現有命令行編碼代理(Claude Code、Gemini CLI、Codex,以及透過 OpenRouter 接入的數百個模型)包進一個可控、可審核、人在回路(human-in-the-loop)的工作流。

項目覆蓋 survey → ideation → experiments → paper writing → slides & promotion 整條研究生命週期,與只懂執行程式碼的 CLI 代理相比,差異在於「全流程編排層」。底層靠三個關鍵設計撐起這層:持久化狀態物件(persistent state objects)、可重用技能庫(reusable skill library),以及多執行器協調(multi-executor coordination),把計劃、執行、寫作綁成一條可恢復的循環。論文亦明確指出,比起只共享同一後端執行器的裸 CLI 代理,Dr. Claw 在研究完整性上得分更高,同時保留可審計、可回溯的過程痕跡。

對獨立研究者、AI 實驗室團隊、需要把研究流程制度化的單位而言,這套架構的價值在於把人類決策(目標、約束、驗收)與 AI 執行清楚分開,並透過 checkpoint 反饋(Verify / Revise / Retry / Handoff)保留介入點。它支援本地部署(自家機器、自家 GPU、自家資料),亦提供桌面版(.dmg / .exe)或 npx dr-claw 零安裝啟動,甚至能在終端機直接 dr-claw chat 跑 agentic 對話。

項目已被 EMNLP 2026 System Demonstrations track 收錄(arXiv: 2609.00365),並採用 AGPL-3.0 搭配上游 GPL-3.0 元件授權,免費、無訂閱。需要留意的是,它自定位為 Anthropic Claude Science 的開源、模型中立替代方案,主打全生命週期而非單純計算分析。

GitHub · Paper

Categories: 開源, Agentic, 模型, OpenAI, Gemini, 軟件, 工具, IDE, 庫, 編程, Anthropic, Skill 技能

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

SimLoss 用單次生成多階段圖像描述

由 UMass Amherst 與 Adobe Research 團隊開發,SimLoss 想解決圖像描述太籠統的老問題。它把細節監督搬到 embedding space,換來更快推理與更高描述精細度。

Repository image for srynsh/SimLoss-Image-Captioning

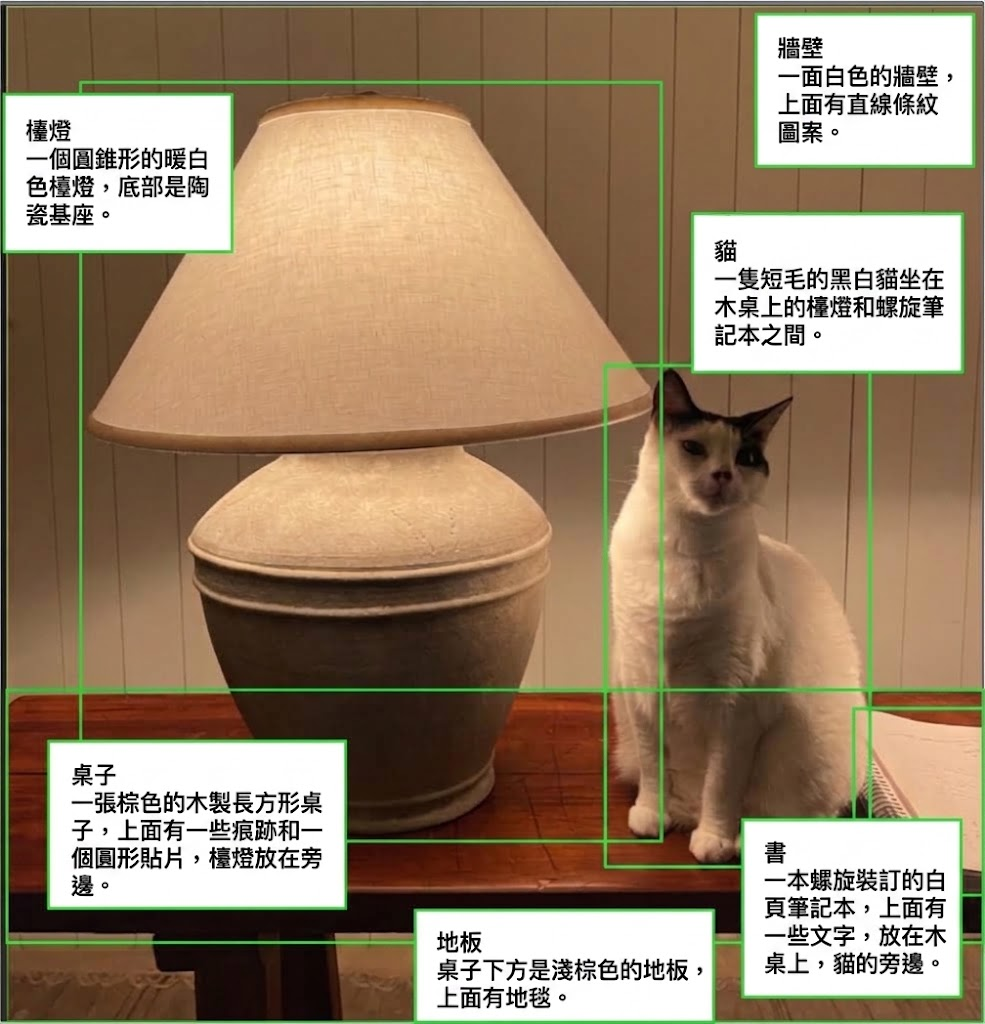
UMass Amherst 與 Adobe Research 團隊,瞄準的是圖像描述常常只講到大意、漏掉材質、數量、紋理同位置關係的問題。SimLoss 屬於影像 captioning 模型訓練方法,核心不是再加一條冗長後處理流程,而是令 Vision-Language Model 在單次生成前,先把隱藏狀態對齊影像 embedding,直接補回細節監督。

它的技術關鍵,在於用 reference-free 的 embedding-space objective 取代人手撰寫細粒度 captions,亦唔需要先跑多階段系統去製造 pseudo-captions。SimLoss 列出兩條路線:SimLoss FFT 會透過本地可用的 Qwen3-VL-Embedding-2B 反向傳播;SimLoss GRPO 則把 Gemini Embedding 2 當成 black-box reward。兩者都建基於 Qwen2.5-VL-7B-Instruct captioning policy,但前者偏向直接做表徵對齊,後者更接近以獎勵訊號微調。

同類方法常見做法,是生成、拆解、驗證、重寫逐步修補描述內容;SimLoss 揀的是保留 single-pass inference,換取更低延遲,再用對比式學習補回細節。代價是它仍然依賴外部 embedding 模型品質,而且項目展示的是研究基準與訓練框架,不是即裝即用的成品服務。

IIW-400 測試中,SimLoss FFT 配合 Qwen2.5-VL-7B backbone,把 precision 由未調整 backbone 的 0.788 提升到 0.849,F1 與多階段 CapMAS 接近到難以區分,同時推理速度約快 20 倍;SimLoss GRPO 則拿到最強 recall。呢個取捨幾實際:想要更準確地講出畫面細節,又唔想接受多步驗證延遲的團隊,會比一般 captioning fine-tune 更感受到差別。

  • 同一儲存庫放入 SimLoss、CapMAS、PAPO、DCScore RL 等基線,方便直接比較
  • 單次生成保留低延遲,同時補足 attributes、counts、textures、materials、spatial relations
  • 提供方法分目錄、資料與 checkpoint 說明,但大型資料與模型檔案未隨儲存庫附上

研究、內容理解、影像搜尋標註,甚至要為電商圖片或視覺資產建立更細緻描述的團隊,都會較容易受益。安裝與執行入口在儲存庫內有 setup 與各方法,但目前公開資訊主要指向研究復現流程;想完整重跑訓練或延遲基準,仍要另外處理資料集、checkpoint 同對應運行環境。

項目主頁 · GitHub

Categories: 開源, Embedding, 視覺模型, 多模態模型, Qwen, Gemini, Image

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

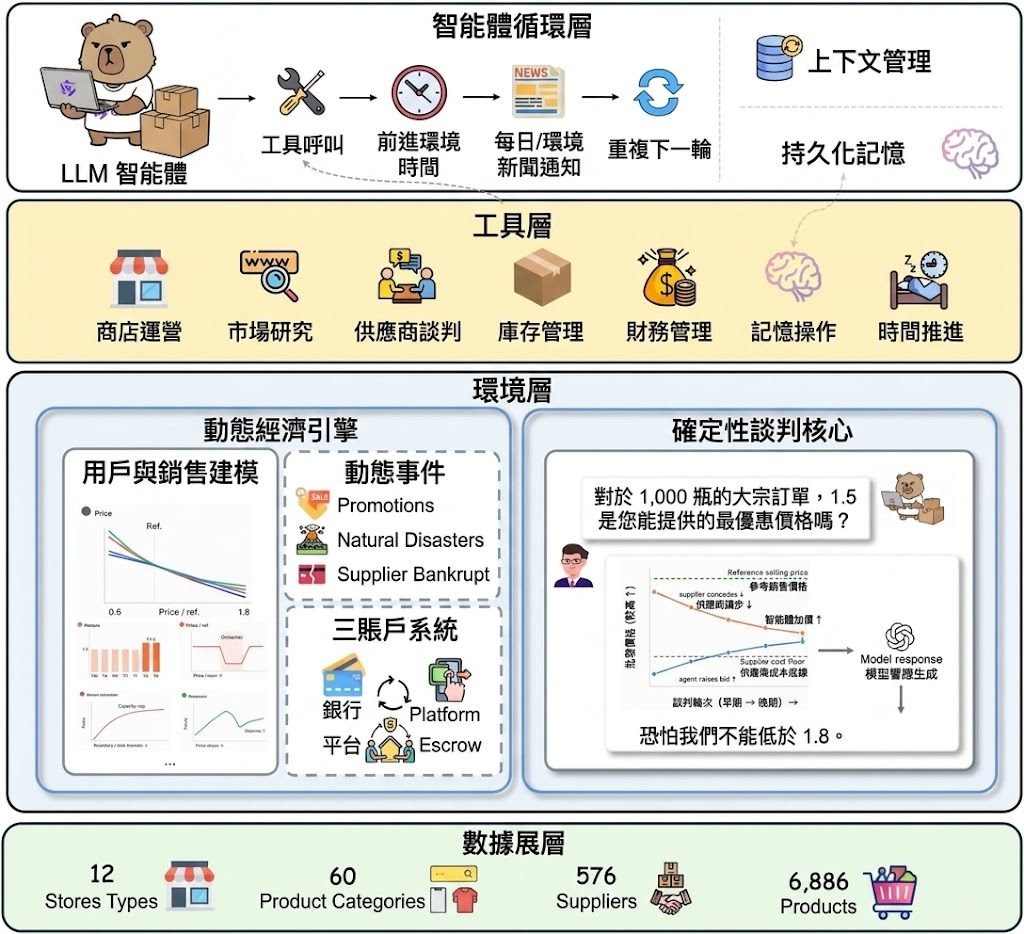
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, Google, OpenAI, DeepSeek, Gemini, Python, Anthropic, Dataset 數據集

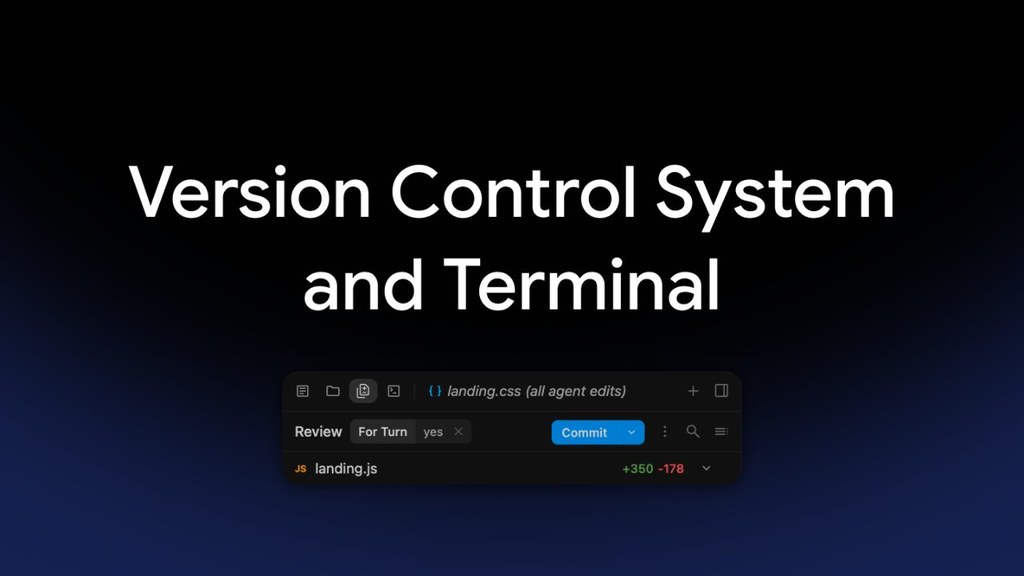
Google Antigravity 把版本控制與終端機帶入 AI 開發流程

Google Antigravity 將版本控制和終端機操作納入 AI 輔助開發,讓編程工作由單次指令延伸至可追蹤、可檢查的完整流程。

Hero image preview

當 AI 不只產生程式碼,還要修改檔案、執行指令及整理變更時,版本控制和終端機就成為確保工作可追蹤的關鍵。Google Antigravity 將這些開發工具納入同一套 AI 輔助流程,協助使用者管理由模型完成的程式編輯工作。

流程可以涵蓋檢視程式庫狀態、執行終端機指令,以及核對 AI 作出的檔案變更。使用者毋須只依賴對話內容判斷結果,而是可以配合版本差異和指令輸出,逐步確認每項修改是否符合預期。

這種安排適合需要反覆修改程式、測試結果及回溯變更的編程工作流。它處理的不是單純產生範例程式碼,而是 AI 參與開發後,如何保留人手審查、版本記錄和操作可見性的問題。

  • 將 AI 編程與版本控制流程連接
  • 支援透過終端機執行開發指令
  • 方便檢視及核對檔案變更
  • 適合需要測試、回溯和協作的項目

使用時仍然需要檢查指令內容、檔案差異和執行結果,尤其涉及刪除檔案、修改設定或操作外部服務的情況。版本控制可以降低回復成本,但不能取代開發者對變更風險的判斷。

項目主頁

Categories: Agentic, Google, Gemini, IDE, 編程

Page 3 of 11
1 2 3 4 5 … 11