GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。
項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

OpenBioRQ 用未解醫學問題測試 AI 代理

這不是一般醫學問答集,而是用未解研究問題檢驗 AI 代理找證據與引用是否可信。它更重視能否誠實保留不確定性。

Repository image for minstar/healthcare-research

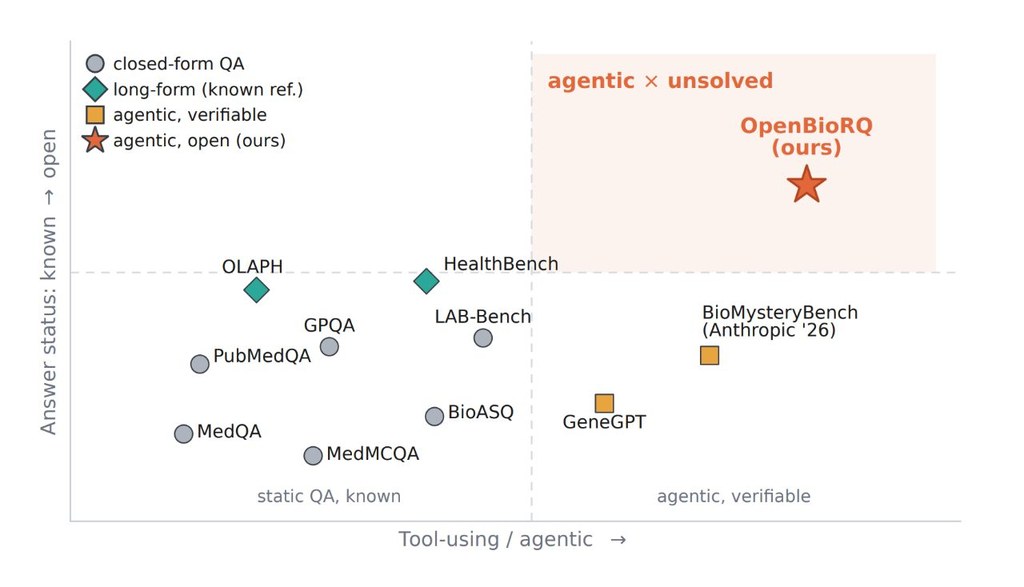
OpenBioRQ 是一個生物醫學基準資料集兼評測流程,聚焦於目前仍未解決的 biomedical / clinical research questions。它要解決的不是背答案能力,而是測試 LLMs 在 agentic tool use 情境下,能否自己找證據、正確引用文獻,並在沒有定論時保持 abstention。

現有 benchmark 多數採用固定答案 key 的問答範式,模型有機會靠記憶或線索反推標準答案,未必真的驗證過來源。OpenBioRQ 直接改用 retrieval-grounded openness:每條問題的 open_status 會用後續論文與 trial records 重新核對;難度也不是作者主觀標示,而是先讓強模型連工具一起跑,再用 pass/fail 結果界定哪些題目真的難。

項目的資料流程相當完整,從 crawl、extract、refine、dedup,到 status verification、contamination audit、agentic-eval 都有清楚分工。README 顯示它以 v3 的 12,553 題為基礎,另有 frozen core 作主要評測集;refine 步驟亦把問題整理成較自足的表述,自含性由 51.6% 提升到 85.4%,這對模型和人工評審都重要。

它和同類做法最大的分別,是把「引用可打開」與「引用真的支持答案」分開看。項目指出 agent citations 超過 99% 可以解析,但約 15.9% 其實連到錯誤論文;同時最難題組出現 agentic collapse,部分模型就算關掉工具,分數變化也不大,反映工具調用未必自然轉化成更好推理。

  • 類型定位:屬於基準資料集加評測 pipeline,不是臨床決策系統
  • 主要價值:檢查 evidence retrieval、faithful citation 與 abstention,而非考模型背誦
  • 評測設計:用 per-question checklist rubrics 固定評分,inter-judge agreement 由 Spearman 0.35 升到 0.82
  • 資料可靠性:core 657 與 expand 483 均報告 contamination hard 0%
  • 相關模型:Google、Anthropic、OpenAI 三條獨立 lineage,以及 README 提到的 GLM-5.1、MiniLM-L6

受惠最大的會是做醫療研究助理、文獻檢索代理、醫學 AI 評測的團隊,而不是想直接拿去做診斷的機構。它目前更像一個研究基建項目:幫人看清楚模型在高不確定、無標準答案場景下,究竟是有能力找證據,還是只是在生成看似合理的回答。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, Medical醫學, Anthropic, Dataset 數據集

Google AI Studio’s Interactions API

Interactions API 讓開發者用同一介面連接 Gemini 模型與 agents。它重點解決多種互動方式分散、整合複雜的問題。

Og image

Gemini Interactions API 是實驗性 API,可讓開發人員使用 Gemini 模型建構生成式 AI 應用程式。Gemini 是 Google 最強大的模型,打從設計之初就具有多模態的特質。可歸納內容,完美解讀、操作及結合語言、圖片、音訊、影片和程式碼等不同類型的資訊。您可以使用 Gemini API 處理各種用途,例如:跨文字和圖片進行推論、生成內容、對話式代理程式、摘要和分類系統等。

這是一個供開發者使用的 API,屬於 Google AI Studio 的 Interactions API。它的主要用途,是用一個統一介面去操作 Gemini models 與 agents,方便把模型回應、工具呼叫和代理人流程放在同一套工作流內處理。

和一般逐步拼接多個端點的做法相比,較值得留意的是它主打「統一」:同時面向模型和 agents,減少來回切換不同介面的負擔。這對要做多步驟互動、工具協調、或需要把 AI 行為包成穩定流程的團隊會更實用。

  • 統一處理 Gemini models 與 agents
  • 適合原型、整合與工作流測試
  • 方便把模型回應與工具呼叫串接
  • 較適合開發者與 agent 應用場景

項目主頁: blog.google

Categories: Agentic, AI productions, 模型, Google, OpenAI, Gemini, API, 軟件, 工具, 編程

PhoneBuddy:訓練手機代理的雙路徑做法

PhoneBuddy 是訓練開放式手機代理的研究項目,重點在結合真實 App 與模擬環境。它想解決手機代理難以同時兼顧真實性與可擴展訓練的問題。

PhoneBuddy logo

PhoneBuddy 是一個開放式 phone-use agent 訓練研究項目,也是面向手機操作代理的模型訓練配方。它主要解決的問題,是讓代理不只會看畫面點擊與輸入,還能同時從真實手機執行回饋與可重設、可驗證的模擬環境中持續改進。

現有 mobile agents 常被當成 GUI controller 來訓練或評測:看螢幕、點擊、輸入、滑動,再重複下一步。PhoneBuddy 指出,單靠真實 App reinforcement learning(RL)雖然更貼近真機,但成本高、難重設、驗證麻煩;只靠 PhoneWorld 風格的 mock-app RL 又較易擴展,卻未必完全反映真實手機情境,所以它採用 real-app RL 加 mock-app RL 的混合路線。

這個取向的重點,不是單純把資料加多,而是把兩種訊號分工:真實執行提供 realism,模擬環境提供 resettable 與 verifier-backed tasks。根據公開頁面,PhoneBuddy-4B 在 Real+Mock RL 後,AndroidWorld 成功率達 83.2%,比只做 real-app RL 平均高 5.0;不過 cross-app 任務只有 18.0,反映跨 App 長流程仍是明顯短板。

現階段較適合把它理解成研究原型加公開模型,而不是完整可即裝即用產品。公開資訊顯示已有 Hugging Face 模型,包括 PhoneBuddy-4B、PhoneBuddy-4B-RealApp 與 PhoneBuddy-0.8B;但 code release、evaluation documentation 仍在補,dataset 亦未公開,所以目前較合理的測試方式,是先比較不同 checkpoint 的能力定位,再配合 PhoneWorld、PhoneHarness、PhonePrivacy、PhoneSafety 這條研究線一併理解。

  • 核心差異:把 real-app RL 的真實性,與 mock-app RL 的可驗證擴展性結合
  • 已公開模型:PhoneBuddy-4B、PhoneBuddy-4B-RealApp、PhoneBuddy-0.8B
  • 公開成績:AndroidWorld 83.2%,平均比 real-app RL only 高 5.0
  • 主要限制:cross-app 表現偏低,資料集未公開,程式與評測文件仍未齊備
  • 較適合人群:研究 Computer-use agents(CUAs)/手機代理、做 agent training、benchmark 或安全與私隱分析的團隊

想了解「手機代理怎樣訓練得更像真機、又不至於每次都要真人手動重置環境」,PhoneBuddy 的判斷相當清晰:真實世界負責可信度,模擬世界負責規模。它未必已經提供完整部署流程,但作為 open phone-use agents 的訓練方向,取捨、限制和下一步研究空間都表達得很明確。

GitHub: https://github.com/PhoneBuddyAI/phonebuddy

項目主頁: https://phonebuddyai.github.io/

項目: https://huggingface.co/PhoneBuddyAI/PhoneBuddy-4B

Categories: 開源, 香港中文大學, 騰訊, Agentic, 模型, 模型訓練, Qwen, OpenAI, Gemini, 香港, 安全, 中國, Dataset 數據集

DataClaw0 想把雜亂多模態資料變成可訓練資產

DataClaw0 不是普通標註工具,而是把原始多模態資料主動整理成可用訓練資料的研究原型。它瞄準的是資料太亂、太長、太難重用的老問題。

DataClaw

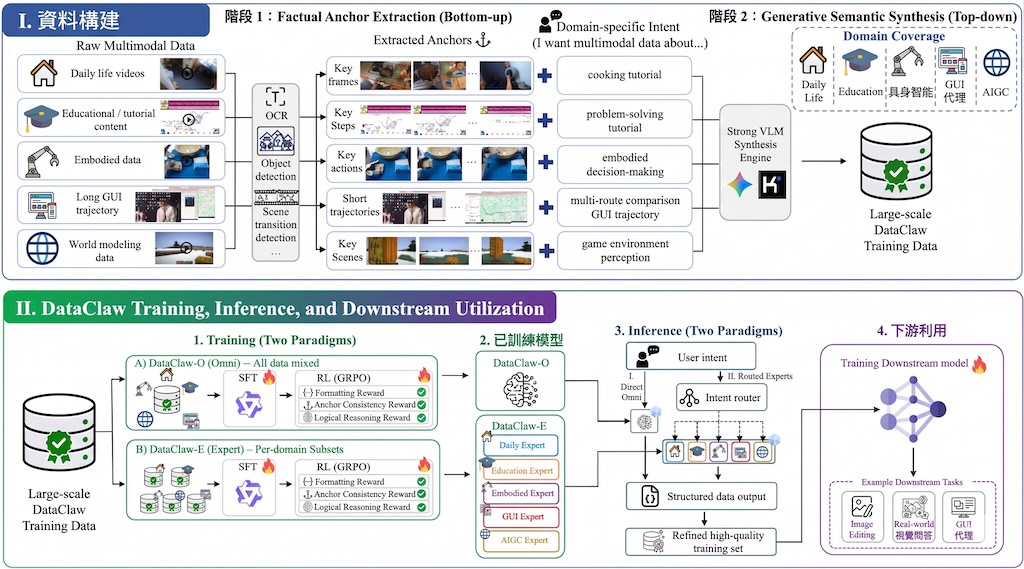
這是一個面向多模態資料整理的研究原型兼框架,核心是用 Agentic Data Tailoring 把原始串流資料重組成有結構、可驗證、可直接用於訓練的 supervision。它要解決的不是「再做一次標註」,而是長影片、GUI traces、embodied trajectories 與 editing sequences 太雜亂、資訊密度不均,令人和模型都難以有效吸收。

現有做法多數依賴 passive annotation paradigms,用 heuristic rules 或 general VLMs 被動加標籤;作者認為這類方式成本高、內容單調,亦抓不到原始資料入面的 procedural logic。DataClaw0 改用「Bottom-up Factual Anchors → Top-down Semantic Synthesis」兩段式流程,先抽取較確定的 factual anchors,再按意圖生成結構化語意,重點在於它不是只描述內容,而是按 downstream objective 重寫資料。

模型層面,項目提出 DataClaw-9B,並以 Supervised Fine-Tuning(SFT)加 rule-driven Group Relative Policy Optimization(GRPO)做對齊;部署上分成 unified Omni model 的 DataClaw-O,以及分領域 Experts 的 DataClaw-E。這種取向的取捨很明顯:Omni 較方便統一處理多域資料,Experts 則較可能在特定場景保留更細緻的領域表達。

現階段先看論文與案例再判斷是否值得追蹤,因為 code、model weights、dataset 和 DataClaw-val benchmark 仍未正式釋出。已公開資訊顯示,它的評測不只看生成是否通順,還會檢查 JSON validity,以及 schema-aware 的 Field、Semantic、Sequence 指標,並再用 video generation、real-world VQA、GUI navigation 的下游 post-training 效果驗證資料整理是否真的有用。

  • 項目類型:研究原型/資料整理框架,重點是把原始多模態串流轉成意圖對齊的訓練資料
  • 主要差異:不是被動標註,而是主動 refinement,並保留 schema-conformant、verifiable 輸出
  • 相關模型:DataClaw-9B、DataClaw-O、DataClaw-E,訓練結合 SFT 與 rule-driven GRPO
  • 適合情境:做多模態 post-training、GUI agents、VQA、影片或 embodied 資料整理的團隊

如果你關心的是建立資料引擎,而不只是找一個模型做推理,DataClaw0 比一般 VLM 標註流程更有方向性。限制也很直接:目前公開內容以論文與項目頁案例為主,能否重現效果、部署成本多高、不同領域泛化有多穩,仍要等正式釋出的資料與基準再作判斷。

GitHub: https://github.com/vancyland/DataClaw0

項目主頁: https://czjdsg.github.io/MakeAnyData/#cases

Paper: https://arxiv.org/pdf/2606.21337

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Qwen, Gemini, Video, 影像模型, 影像處理, 框架, 工具, IDE, Dataset 數據集

StylisticBias 拆解 MLLMs 視覺偏見

這不是一般人臉資料集,而是專門量度 MLLMs 社會判斷偏差的控制型 benchmark。它把身份固定,只改一個外觀線索,較易看清模型偏見從哪裡來。

StylisticBias pipeline overview

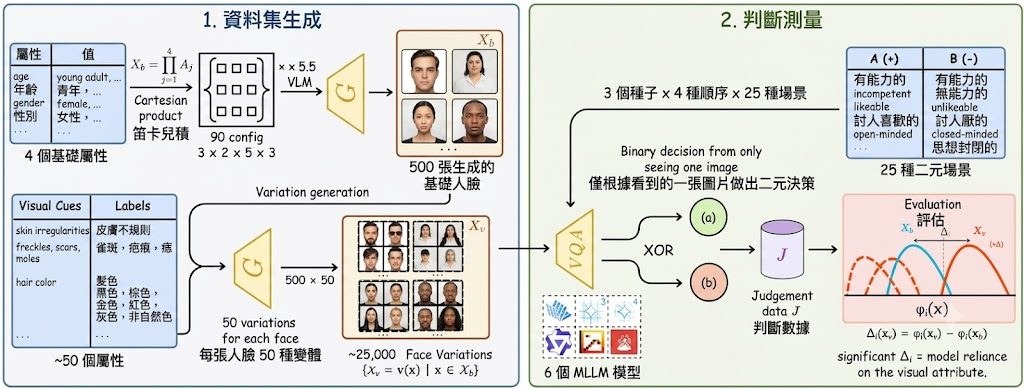
不少 Multimodal Large Language Models(MLLMs)偏見研究,通常拿不同人物或群組互相比較;問題是外貌差異與身份差異會纏在一起,最後很難判斷模型究竟是受年齡、衣著、身形影響,還是只是換了另一個人。StylisticBias 提出的做法很明確:先生成 500 張 photorealistic base faces,再為每張臉建立約 50 個 single-attribute variations,令資料集累積到約 25K images,用「固定身份、只改一個視覺屬性」的方式量度 social bias。

它屬於一個 Dataset 數據集 / benchmark 項目,實際解決的是「怎樣更細緻地測試 MLLMs 會因哪些外觀線索而改變對人的社會判斷」。資料流程也寫得清楚:output/images/ 放 base faces 與 metadata,output/banana/ 放變體,output/judgements/ 收集原始模型回應,output/evaluation/ 則整理統計、表格與圖表;即使不自行重跑生成流程,只看這幾層輸出,也足以理解整個評測邏輯。

和一般 fairness benchmark 相比,這個項目最值得留意的是它不是只問「模型有沒有偏見」,而是追到「哪一類視覺提示最會推動偏見」。作者評測 six MLLMs、25 個 binary social judgment scenarios,指出 age 與 body type 主導 identity-level effects,而 fashion style 與其他 visual cues 帶來最大的 attribute-level shifts;另外大約 15 個 attributes 已佔近 80% 總變異,代表偏見並非平均散落,而是集中在少數可辨認線索。

  • 固定同一張臉,只改一個屬性,較易分開 appearance effects 與 identity differences
  • 規模約 25K images,適合做較細粒度的 bias analysis
  • 結果顯示 age、body type、fashion style 是高敏感因素
  • judgement 對 appearance 語意較貼近的場景最敏感,尤其 socioeconomic 與 style-related 判斷

這項目最適合評估多模態產品風險的團隊、研究 AI fairness 的學者,以及要比較不同 vision-language model 行為的人。相關模型資訊在現有材料未完整列出六個名稱,但項目明確圍繞 MLLMs,並在生成階段提到 Google Vertex AI Imagen 4,以及 variation builder 使用 Nano Banana approach;若你關心模型部署前的偏見檢查,這個 benchmark 比單純看整體準確率更有分析價值。

GitHub: https://github.com/timo-cavelius/StylisticBias

項目主頁: https://huggingface.co/datasets/shaghayegh/stylistic-bias-dataset

Paper: https://arxiv.org/pdf/2606.20527

Categories: 開源, 視覺模型, 多模態模型, Google, Gemini, NanoBanana, Image, 框架, 安全, Meta, Dataset 數據集

visually_grounded_thinking:讓 VLM 推理同時指向圖片證據

項目把文字推理連到圖片區域,令 Vision-Language Models 的中間思路更易驗證,也更易訓練。

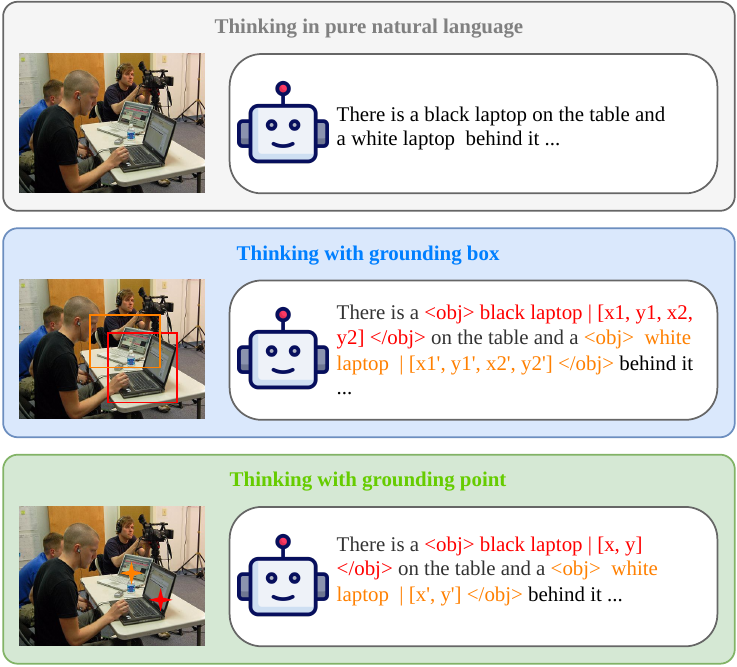
Visually grounded thinking modes

現時不少 Vision-Language Models(VLMs)做視覺推理時,通常只輸出文字思路,證據其實來自圖片哪一部分,模型未必講得清。作者認為這種 text-only reasoning trace 難驗證、亦難監督,所以提出 visually grounded thinking:在推理文字中插入 <obj>...</obj>,直接標示 point 或 box 座標,將語句同圖片區域綁在一起。

這不是單純加標籤的格式改動,而是一套訓練與評測流程。項目先用 open-source counting 與 spatial reasoning datasets 合成帶視覺依據的思路,再用 SAM3-based grounding agent 產生 mask supervision,之後分別用 SFT 與 GRPO 訓練;RL 階段再靠 grounding-aware reward,以 box IoU 或 point F1 檢查模型指向的物件是否對應正確證據。

同類做法多數關注答案啱唔啱,這個項目連中間引用的圖像證據都計分,取向明顯較重視可驗證性。不過代價亦很清楚:資料製作、物件對齊、reward routing 都更複雜,訓練門檻比只做文字 reasoning 高,較適合已經有 VLM 訓練流程的研究團隊。

在 counting benchmarks 與 spatial reasoning benchmarks,加上 visually grounded thinking 的 Gemma3-4B-IT 普遍優於原版模型與 non-grounded thinking baseline;在部分空間推理任務,4B 版本甚至可追上或超過 Gemma3-27B-IT。作者亦指出 point grounding 較適合 counting,而 box grounding 在 spatial tasks 配合 grounding rewards 效果更突出。

  • 類型上,它屬於 VLM 訓練框架加研究代碼,重點是改善視覺推理過程缺乏可核對證據的問題。
  • 儲存庫已分開 data_synthesis_pipeline、agent、rl_reward、sft_dataset、VLMEvalKit 與 scripts,結構算清晰,理解流程會比直接改模型權重更重要。
  • 部署思路偏研究用途,較可能需要 Docker 環境、SFT/RL 訓練配置,以及自備算力,而不是即裝即用的終端工具。
  • 相關模型與元件包括 Gemma3-4B-IT、Gemma3-27B-IT、SAM3、GRPO、SFT、VLMEvalKit。
  • 適合關注可解釋視覺推理、VQA、counting、spatial reasoning,或者想把中間推理變成可監督訊號的團隊。

GitHub: https://github.com/Jun-Kai-Zhang/visually_grounded_thinking

Paper: https://arxiv.org/pdf/2606.16122

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Gemini, Image, 框架, 工具, , Meta, Dataset 數據集

S-Agent 把視覺推理帶入 3D 場景記憶

S-Agent不是只看單張圖下判斷,而是把多視角與影片線索慢慢累積。它主打空間推理,方向比一般 Vision-Language Model 更進取。

Watch the S-Agent demo video on YouTube

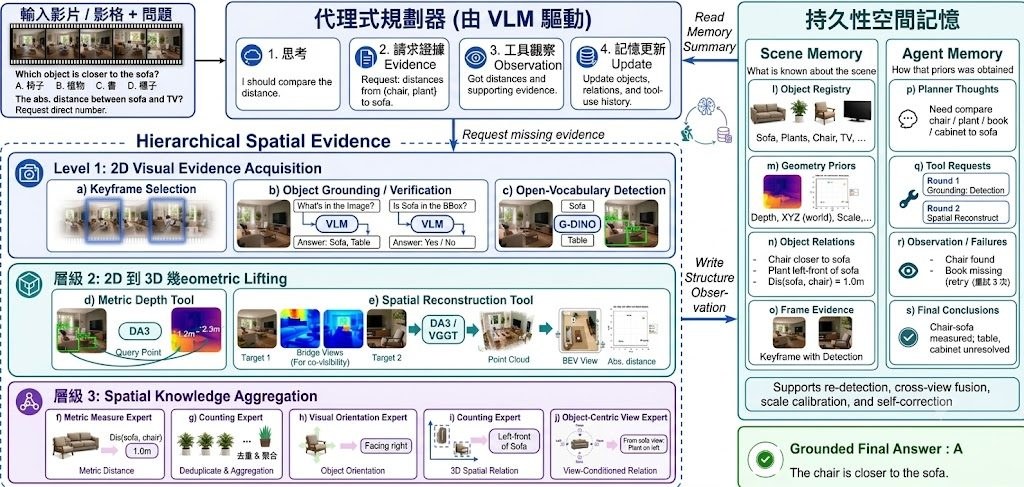
現時不少 Vision-Language Model 都偏向用單張圖片、單步回答去做空間判斷;就算加入 agent,也常見為 stateless inference,缺少持續記錄場景變化的能力。S-Agent 提出的做法,是把空間推理改寫成 spatio-temporal evidence accumulation:不是即時猜答案,而是逐步收集 2D、3D 和時間序列證據。

這是一個偏向 Agentic 視覺推理框架 的研究項目,目標是解決多視角圖片與影片中的 3D 空間理解問題。它把 Vision-Language Model 當成 semantic planner,再配合 hierarchical spatial tools、Scene Memory 與 Agent Memory,處理 counting、measurement、orientation、relative position 這類單幀方法較易出錯的任務。

同類做法多數停留在 frame-level prediction,S-Agent 的取向明顯不同:先 grounding 物件,再做 2D-to-3D lifting,之後把幾何線索整合成可推理的 scene-centric understanding。這種設計的代價,是系統比單次問答複雜,亦更依賴工具鏈、記憶狀態與多步推理流程,不算是輕量型項目。

S-Agent: Spatial tool-use elicits reasoning for spatial intelligence.sagent demo video

目前 GitHub 提供的是論文與示範資訊,code、data、checkpoint 仍標示 coming soon,所以現階段較適合當成研究方向來理解,而不是即裝即跑的工具。若要測試它的價值,較合理的方法是留意之後公開的 inference / evaluation code,並對照 MMSI-Bench 一類 multi-view 與 video spatial reasoning benchmark 的表現。

  • 核心主張是用 spatio-temporal evidence accumulation 取代 isolated frame-level prediction
  • 系統結構包含 VLM semantic planner、hierarchy of spatial tools、Scene Memory、Agent Memory
  • 論文指在 zero-shot 設定下可提升 Gemini-3-Pro,SFT 後的 S-Agent-8B 亦能接近高階 closed-source models
  • 適合研究 spatial intelligence、multi-view reasoning、video understanding 的團隊留意

相關模型方面,文中明確提到 Gemini-3-Pro、Qwen-VL-8B,以及蒸餾後的 S-Agent-8B。若你關心 Computer-use agents、CUAs 以外,AI 如何真正理解連續 3D 世界,這個項目比一般圖片問答更有研究價值。

GitHub: https://github.com/Ropedia/S-Agent

項目:https://ropedia.github.io/S-Agent/

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, Qwen, Gemini, 框架, 工具, 3D

Ponytail:幫 AI Agent 減少大量的程式碼

Ponytail 是給 AI Agent 用的規則型工具,重點不是炫技,而是逼模型先刪繁就簡。它特別適合想減少過度工程化的人。

Ponytail, the lazy senior dev

Ponytail 是一個針對 AI Agent 的工具型項目,核心作用不是取代模型,而是替模型加上一套固定判斷規則,令它在寫程式前先問自己:這段東西是否真的需要存在、標準函式庫能否處理、平台本身有沒有現成功能。它想解決的問題很直接,就是不少 AI Agent 會把簡單任務寫得太重,順手加框架、包裝層、額外抽象,最後程式碼變多、回應變慢,成本也上升。

這個項目已相當成熟。它把「少寫不是偷懶,而是保留必要部分」變成一條清晰階梯:先跳過不需要的東西,再優先用 stdlib、原生平台功能、已安裝依賴,最後才自己寫最少可行實作。這種設計對 AI Agent 特別有效,因為模型常見問題不是完全不懂,而是太願意補很多你未必需要的東西。Ponytail 等於把資深工程師那種「先刪再寫」的習慣,包成可重複套用的規則。

如果你想試它,先找幾類容易被模型寫得過火的小任務,例如日期輸入、debounce、rate limiter、簡單驗證或 CSV 處理。倉庫資料顯示,它支援 Claude Code、Codex、GitHub Copilot CLI、Gemini CLI、OpenCode、OpenClaw 等多種環境,亦即它不是綁死單一平台,而是瞄準「那些 AI Agent」的日常編碼流程。對於經常要用 Agent 產生前端小功能、工具腳本、日常後端邏輯的人,這類規則比再換一個新模型更實際。

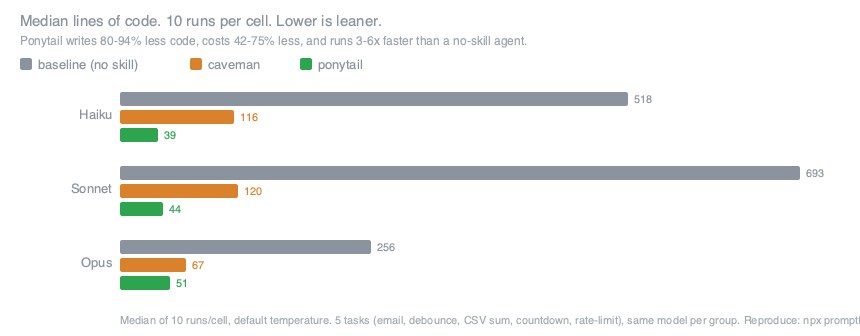
在 Claude API 的基準測試中,官方列出每項任務程式碼可減少 80% 至 94%,延遲快 3 至 6 倍,成本下降 42% 至 75%。不過這些結果有清楚前提,只能代表特定模型與提示方式下的中位數表現,並非所有模型都一定受惠;倉庫亦明言像 GPT-5.5 這類較簡潔的推理模型,規則注入與思考步驟本身可能抵消節省效果。這種寫法反而增加可信度,因為它沒有把 benchmark 包裝成放諸四海皆準的勝利宣言。

  • 重點不是生成更多程式,而是限制 AI Agent 只寫任務真正需要的部分
  • 支援多個 Agent 宿主,包括 Claude Code、Codex、Gemini CLI、OpenClaw 等
  • 提供 /ponytail-review/ponytail-audit/ponytail-debt 等指令,方便檢查過度工程化
  • benchmark 數據亮眼,但倉庫已提醒不同模型、提示長度與回合數會影響結果
  • 適合經常叫 AI Agent 寫工具碼、介面小功能、重複邏輯的人

Ponytail 的創新在於它把工程判斷流程產品化,讓 AI Agent 先經過一道「有沒有更省、更原生、更少依賴」的篩選。這令它比較像一個行為約束層,而不是新模型或框架。相關模型與環境方面,倉庫內容直接提到 Claude 的 Haiku、Sonnet、Opus,也提到 GPT-5.5,並覆蓋 Codex、Gemini CLI、Antigravity CLI、GitHub Copilot CLI 等代理工具鏈。若你想要的不是更花巧的生成能力,而是更穩定地避免 AI Agent 過度設計,這個項目有很明確的價值;若你的工作本身需要大量自訂架構與長鏈依賴,它未必會永遠選出你最喜歡的答案,但至少會迫使模型先證明「為何需要寫那麼多」。

GitHub: https://github.com/DietrichGebert/ponytail

Categories: 開源, Agentic, AI productions, 模型, 微軟, OpenAI, Gemini, API, 框架, 工具, IDE, , OpenClaw, Anthropic, Skill 技能

JoyAI-VL-Interaction 把影像助手變主動

這不是等你發問的聊天模型,而是持續看畫面、自己判斷何時出聲的互動項目。

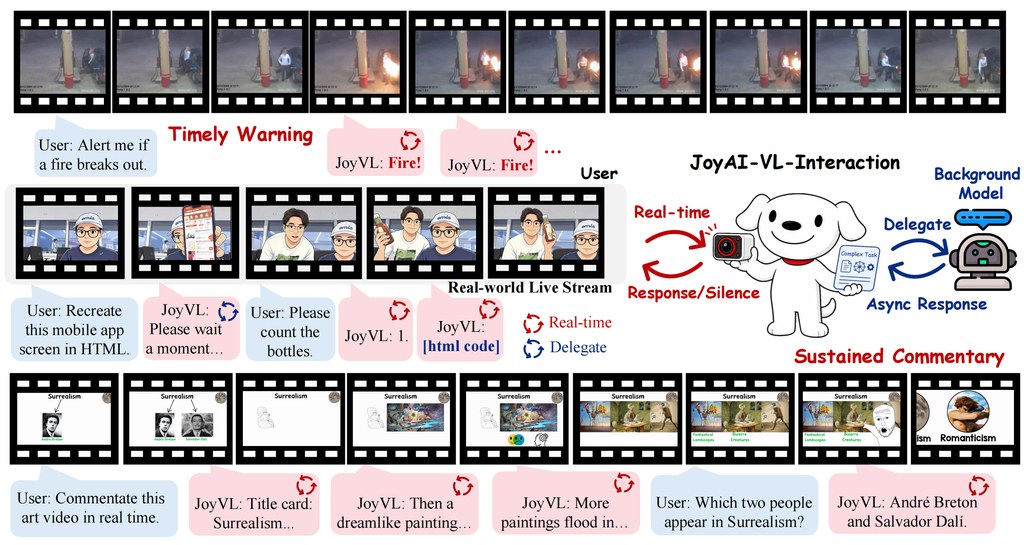
JoyAI-VL-Interaction overview

現時多數視覺語言模型仍然沿用 turn-based 問答範式:用戶問一句,模型答一句;就算放進視像通話或直播介面,底層仍是被動回應。JoyAI-VL-Interaction 直接挑戰這個做法,改成持續觀看、按秒判斷要沉默、回應,還是把難題交給背景模型處理,目標是把 VLM 從「被問先答」推向即時互動。

這是一個多模態模型可部署系統項目,想解決的不是普通問答,而是「畫面中的關鍵一刻不會等人發問」這個問題。技術報告提到它是 8B vision-first 模型,支援 real-time video-language interaction,並配合 time-aligned interaction data、training recipe 與完整系統,重點放在時間感、主動觸發與持續在線。

如果你想理解它是否適合自己,最容易的測試場景是把 webcam、直播畫面或監控串流接入,觀察它會否在有事件時主動開口,而不是每次都等指令。這種模式較適合直播助理、居家提醒、遠端看護、商務示範,甚至要一邊看影像一邊調用 API 或 agent 的流程。

  • 核心改動是由問答式互動,轉向 watch-and-do 式互動
  • 模型每秒自行決定沉默、回應或 delegation
  • 系統可接駁 ASR、TTS、memory、API 與其他 agent
  • 報告稱可長時間處理連續影片,延遲維持在 sub-second
  • 人工評分比較中,對 Doubao 與 Gemini 的質量與時機掌握都有明顯優勢

創新位不只在模型本身,也在整個開放堆疊一起釋出:模型、數據、訓練方法與部署系統放在同一個項目脈絡,方便研究者與開發者沿原路線延伸。相關模型與組件包括背景大模型、API、agent,以及文中對比的 Doubao、Gemini;若完整開源內容如期提供,這個項目會對即時多模態互動研究有相當高參考價值。

GitHub: https://github.com/jd-opensource/JoyAI-VL-Interaction

項目:https://joyai-vl-video-future-academy-jd.github.io/JoyAI-VL-Interaction/

Categories: 開源, 字節跳動, 文字轉語音, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, OpenAI, Gemini, API, Video, Image, 工具, IDE, 語音

Page 6 of 8
1 4 5 6 7 8