Google Harness² 讓 Agent 自我改良執行系統

Harness² 能在模型不變下,按任務改進提示詞、工具與技能,並將經驗沿用至後續任務。

Harness²

Agent 的落差往往不只來自模型能力,提示詞、工具配置、記憶和任務編排同樣影響結果。Google Research 開源的 Harness²,便是一個處理這層「執行系統」的研究框架:它固定模型權重,先按眼前任務調整 harness,再把成果與經驗帶到下一項任務。

它的核心是兩層遞迴。Task-level recursion 透過 Propose–Probe–Compose,先提出修改、在相同任務測試效果,再整合有效部分;Harnessing-level recursion 則把已採用的 harness 與有證據支持的經驗寫入持久 improvement harness,協助後續改進。這種取捨是把資源由重新訓練模型,轉向持續優化模型周邊配置。

  • 模型權重固定,主要改進 prompts、tools、memory、skills 與 orchestration。
  • 不依賴標準答案,以同一任務不同執行結果的行為差異作為回饋。
  • 支援 parallel、sequential recursion,以及 OpenCode、Codex executors。
  • 可配合 JobBench、LAB、WorkBuddy-Bench 測試。

在四種 model–harness 組合中,Harness² 為 GLM-5 與 Gemini 3.5 Flash 的基礎 harness 帶來提升:WorkBuddy-Bench 最高增加 11.5 分,JobBench 增加 4.5 分,LAB partial pass rate 增加 11.8 個百分點;提高 task-level recursion budget 還可繼續增加結果。不過,資料涵蓋三個專業 benchmark,尚不足以證明所有工具和模型組合都能受惠,而且每輪提出、測試及整合會增加執行成本。

需要多工具、複雜編排或持續接力的 Agent 團隊,較能感受到這種架構的價值;維護者可用 JobBench 流程建立環境,再按自身 executor 與評估基準測試。研究人員亦可沿用遞迴設計,但應核對額外呼叫、錯誤傳播及 improvement harness 累積錯誤等問題。
項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Google, Gemini, 提示詞, 框架, 工具, Dataset 數據集, Skill 技能

OpenGCUA 讓電腦代理跨越 GUI 限制

OpenGCUA 把視覺操作、AX Tree、API 與指令整合,讓代理按任務選擇完成工作的方式。

OpenGCUA. Open the full stack of generalist computer use. GPT-6 made computer use the frontier. We make it open. Tested

當電腦代理不再只靠滑鼠點擊,處理複雜工作便可以同時讀取畫面、Accessibility Tree、應用程式 API 和命令列。OpenGCUA 是一個開源 Computer-use agents(CUAs)項目,建構 generalist computer-use agent(GCUA)完整堆疊,解決 GUI-only 代理在效率和操作彈性上的限制。

模型會按任務決定要觀察甚麼、採取哪種行動,以及如何整理上下文;除了 GUI 操作,也能呼叫 app API、執行 shell commands,並透過 code execution 把多個步驟組成帶有迴圈和條件的程式。OSWorld 整合範例提供 screenshot-action 和 code-action 路徑,macOS 14+ harness 則以選單列應用程式在本機裝置執行代理,仍屬 preliminary。

OpenGCUA 亦提供 Cross-Device SDK,嘗試用同一套 programming interface 連接電腦、瀏覽器和手機。這比固定規則的工作流更靈活,但也代表命令、API 和 GUI 權限需要更嚴格的隔離;項目目前仍在逐步開放模型、harness、SDK、trajectories、效率優化和評估工具。

OSWorld-v2 的 82 個 offline tasks 中,八個 frontier models 的平均 partial score 由 GUI-only execution 的 45.3 提升至 64.9,增加 19.6 分;每項任務平均步數減少 53%,六個模型的 output tokens 亦減少 27.2%。較弱模型獲益較大,例如 GLM-5.3-Flash 增加 35.2 分,DeepSeek-V4.1-Flash 增加 29.8 分。

  • 同時支援 GUI、AX Tree、CLI、API 和 code execution
  • 附有八個模型的 evaluation trajectories,包括 GPT-6 Astra、Claude Opus 5 和 Gemini 3.8 Flash
  • 可用 OSWorld 整合範例研究 screenshot-action 與 code-action
  • macOS harness 和 Cross-Device SDK 方便研究本機及跨裝置工作流

研究 Computer-use agents、需要分析代理行為,或希望把電腦、瀏覽器和手機操作納入同一工作流的團隊,會較容易從中受益。項目適合用作研究和實驗基礎,未宜直接視為成熟的日常自動化產品;本機執行、權限控制、模型相容性及仍在開發的模組,都會影響部署難度。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, DeepSeek, Gemini, API, 工具, Mac, 編程, Anthropic, Dataset 數據集

Gemini 4 Argon 解決更複雜問題

Gemini 4 Argon 正式向開發者、企業、科研人員及一般用戶開放,主打處理高難度問題。

Og image

面對需要更強分析能力的工作,Google 現已開放 Gemini 4 Argon 使用。這款 frontier model 面向開發者、企業、科學家及一般消費者,讓不同場景的用戶都能接觸 Google 最新一代 Gemini 模型。

Gemini 4 Argon 定位為處理「最艱難問題」的模型。

主要亮點

  • 原生多模態 MoE:支援文字、圖片、音訊及影片輸入。
  • 統一 1M-token 視窗:輸入、thinking tokens 與輸出共用約 104 萬 tokens,單次輸出亦可超過以往的 64K 限制。
  • 可調推理深度:API 提供 low、medium、high thinking levels,方便平衡速度、成本與解題能力。
  • 偏向深度工程工作:Google 展示了跨數百個檔案重構,以及讓 Agent 無人值守執行整晚的案例。
  • API 型號:gemini-4-argon,可透過 Gemini API、Google AI Studio 及 Google Antigravity 使用。

價格與限制

2026 年 11 月 30 日前,API 推廣價為每百萬 input tokens 2 美元、output tokens(包括 thinking tokens)10 美元;12 月 1 日起分別加至 4 美元及 20 美元,而且沒有免費 API tier。

項目主頁

Categories: 模型, Google, Gemini, 安全

DeepMind Sierra AI 原生即時語音

Google DeepMind 與 Sierra AI 討論原生音訊模型,聚焦即時語音互動的速度、自然度與工程限制。

Og image

語音助手要做到自然對話,關鍵不只是把文字轉成聲音,而是要在用戶說話期間理解內容、掌握語氣,並快速作出回應。Google DeepMind 的 Valeria Wu 與 Sierra AI 的 Soham Ray 透過對談,介紹原生音訊模型如何處理這類即時語音 AI 的核心問題。

討論內容集中於 native audio models,以及建立更流暢即時語音系統時遇到的挑戰。相較於把語音先轉成文字、再交由文字模型處理的流程,原生音訊模型直接處理音訊訊號,有機會保留更多語調、停頓和對話節奏;但系統仍要兼顧理解準確度、回應延遲和運算成本。

內容涵蓋的重點包括:
– 原生音訊模型如何支援更自然的語音互動
– 即時對話中延遲與回應流暢度的取捨
– 建立高質素 voice AI 所面對的工程挑戰
– Google DeepMind 與 Sierra AI 對下一代語音體驗的觀察

這段內容適合關注語音介面、客服自動化、AI agent 和多模態模型的讀者。影片沒有提供完整技術規格或獨立效能測試,因此較適合作為理解發展方向與產品設計難題的入門材料,而不是部署指南。

影片介紹

Categories: Agentic, AI productions, 模型, 多模態模型, Google, Gemini, Video, Audio, 語音, 安全

Google Foresight:會議筆記與個人資料留在 Mac

Foresight 在 Mac 本地聆聽會議、整理筆記,亦能按你的檔案即時回答問題。

開會時只需記下零碎提示,Google AI Edge Foresight 便可配合本機轉錄內容整理成較完整的會議筆記。工具支援 Google Meet、Zoom,以及面對面或離線對話,音訊和文字都在 Mac 處理,不必上傳雲端。

Foresight 亦能連接本地項目資料夾、Google Drive、參考文件、圖表、網頁連結和日曆,建立與工作相關的背景資料。對話期間,它可透過聊天檢索內容;Live Assistance 更會聆聽問題,在相關資料出現時主動顯示附有引用來源的 context cards,減少會議前準備和反覆確認資料的時間。

技術核心包括 740M 參數的 EmbeddingGemma 2。這個 on-device multimodal embedding model 會把文字、圖片、影片和音訊映射到同一向量空間,支援跨模態語意檢索;配合 Gemma 4,可在裝置上建立即時的 Retrieval-Augmented Generation(RAG)流程,避免網絡延遲。

  • 會議轉錄、音訊與檔案留在 Mac
  • 支援影片會議、面對面及離線對話
  • 可把速記提示整理成完整筆記
  • 支援跨文字、圖片、影片和音訊檢索
  • 具備聊天及 Live Assistance 兩種取用資料方式

頁面提供 macOS 下載入口。需要高度重視資料私隱、又經常在多個本地檔案之間切換的人,較容易感受到這種本機 AI 工作流的便利。

項目主頁

Categories: AI productions, RAG, Embedding, 多模態模型, Google, Gemini, Video, Image, Audio, 工具, Mac

WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

VIEScore2 讓影像評分不再只剩一個分數

VIEScore2 同時評估影像質素、語意一致性與缺陷位置,將難以解讀的分數轉成可追蹤的修改方向。

teaser

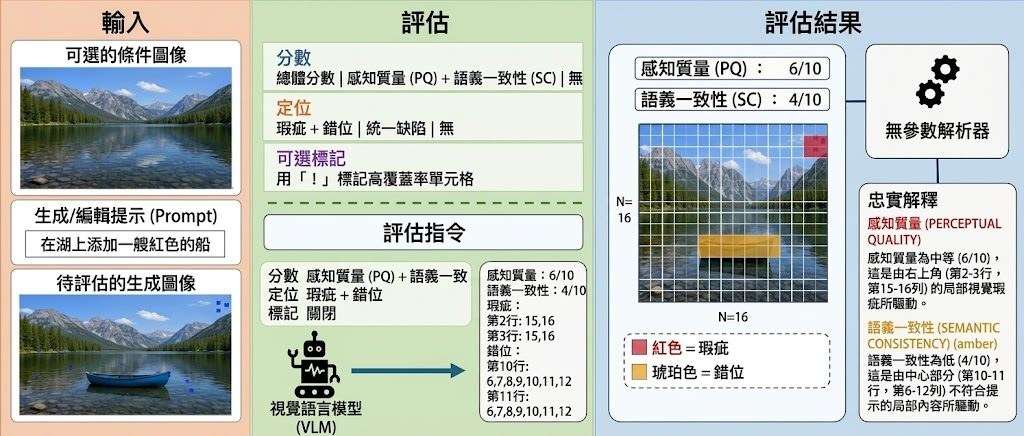
評估 AI 生成或編輯影像時,單一分數往往只能告訴你好不好,卻說不出問題在哪裏。VIEScore2 屬於影像評估模型,處理生成圖、編輯圖、提示詞及可選的條件影像,並在一次模型運算中輸出質素、語意一致性和缺陷位置。

Qwen3-VL-8B 經微調後,以自回歸方式同時預測 perceptual-quality(PQ)、semantic-consistency(SC)及 16×16 defect grid;artifact 和 misalign 兩個通道可分開標示視覺瑕疵與語意錯位。參數免訓練的 parser 再把網格結果穩定轉成文字解釋,避免說明內容與定位結果互相矛盾。

相比只輸出總分的評估器,VIEScore2 提供較具操作性的空間線索;相比通用 VLM,模型則專注於影像評分和缺陷定位,代價是網格以 16×16 單元表達,細節精度有限。訓練資料把 ImagenWorld、RichHF-18K、PAL4VST、COCO 的遮罩或熱圖,以及 EvalMuse-40K 的分數資料統一成同一格式,再以 SFT 和 GRPO 配合 cell-level Dice、分數準確度及格式有效性獎勵訓練。

GitHub 儲存庫提供評估協議、資料 manifests、外部測試集轉換器,以及 run_eval.py;可使用本地 checkpoint,亦支援 OpenAI、Gemini 和 Anthropic API backend。主要套件包括 AbHuman、AGIQA-3K、EvalMuse、PAL4VST 等評估集,適合研究影像生成模型、建立自動質量檢查流程,或分析編輯結果的錯誤位置。

  • 評分更完整:同時輸出 PQ、SC、缺陷網格及文字解釋。
  • 結果較接近人評:主要測試集 overall-score SRCC 為 0.601,最佳 VLM baseline 為 0.491。
  • 定位能力具競爭力:6 個定位基準中有 3 個取得最高 grid IoU,5 個進入前三。
  • 限制清晰:網格定位仍屬區域級提示,並需要按儲存庫協議整理資料與輸入格式。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, API, Image, 提示詞, 庫, Anthropic

WorldSonus 為影片補上可互動立體聲音

WorldSonus 將影片動態、文字指令和立體聲音同步起來,讓世界模型生成的畫面不再只有無聲場景。

WorldSonus architecture

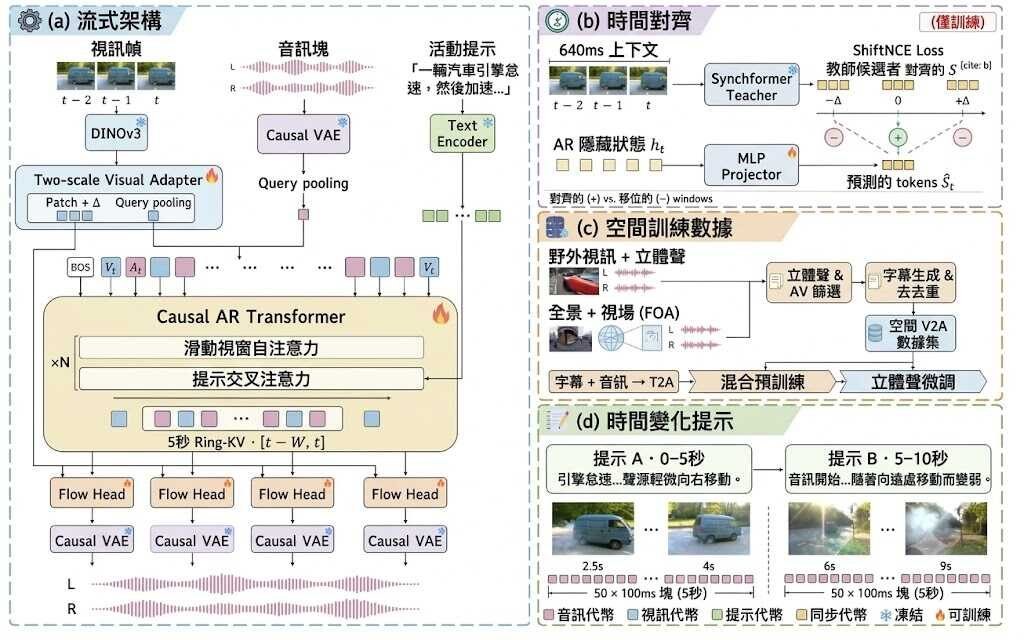
影片中的腳步、流水和列車聲可以隨畫面變化,甚至在生成途中接受新的文字指令。WorldSonus 是一個影片轉音訊模型,處理世界模型和互動影片缺少同步聲音的問題,並以每 100 毫秒一段的方式生成 48 kHz 立體聲。

它採用 streaming causal autoregressive diffusion 架構,讓影片畫面經過兩種時間尺度的視覺 token 後,交由 AR transformer 和 rectified-flow head 生成音訊。生成模型、audio decoder、normalization statistics,以及凍結的 DINOv3 和 T5Gemma 2 視覺/文字編碼器分工合作;文字提示可在 chunk 邊界更新,同時保留聲音連續性。

• 支援離線生成和 streaming generation,兩者使用同一條三幀生成路徑
• Visual temporal differences、Ring-KV 歷史狀態和 causal decoder convolution states 會跨 chunk 保留
• 可用影片加提示詞控制聲音,也可只用影片作條件
• 輸出為 stereo 48 kHz 音訊,片段長度會按 100 毫秒 chunk 向下取整

研究結果給出的 real-time factor (RTF) 是 0.41,並在開放領域 video-to-audio benchmark 中達到或超越部分雙向模型的聲學質素和空間對齊表現。不過參考實作沒有承諾固定延遲,模型和編碼器亦要在串流開始前載入,不能直接把 RTF 當成使用者必然取得的端到端延遲。

測試需要 Python 3.10 或以上、支援 CUDA 的 GPU、FFmpeg 和 ffprobe,GPU 驅動程式要預先安裝;設定程序會安裝 CUDA 12.4 的 PyTorch wheels。模型權重和編碼器可從 Hugging Face 下載,適合研究世界模型、影片生成、互動模擬或需要空間聲音的內容製作團隊,但硬件要求和上游模型的授權/存取條件仍需先核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, AI productions, 模型, 世界模型, NVIDIA, Gemini, Video, Audio, 提示詞, 香港, Python, Dataset 數據集

VeriHarness 長流程 AI 任務的修訂

長時間 AI 任務不再只靠一次輸出或投票,VeriHarness 讓模型查證分歧與共識,再交付有證據支援的成果。結果同一模型也能做驗證!

VeriHarness

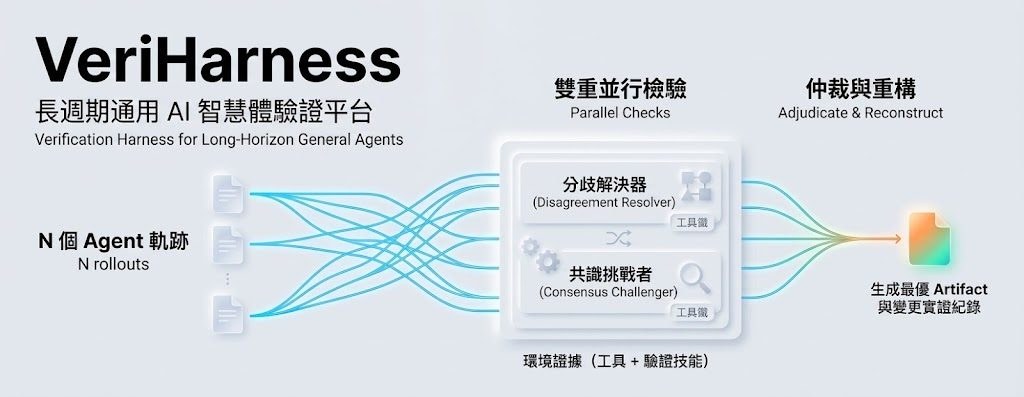
長時間 AI 任務容易在細節中累積錯誤,單靠一次 rollout 或多數票未必能找出共同誤判。VeriHarness 是一個面向 long-horizon general agents 的 verification harness,讓產生答案的同一個模型檢查環境證據、修訂成果,並記錄每項改動的原因。

它會把 N 次獨立 rollout 交給兩條調查流程:disagreement resolver 核對不同嘗試提出的主張,consensus challenger 則專門反查所有嘗試都同意的內容。兩邊取得文件、資料或可重新計算數值後,再由 adjudication 選取或重建 artifact,處理了「分歧不等於錯誤、共識也可能共同出錯」的取捨。

透過 Gemini on Vertex AI 或 Claude on Vertex AI 執行驗證;wb 與 wsb 評分器則在網絡容器中處理文件、試算表、程式碼及多檔案工作區任務。項目同時公開約 26,000 次 rollout,方便研究團隊重現流程或比較自己的 verifier。

結果顯示,Gemini 3.5 Flash 作為 generator 和 verifier 時,證據支援的修訂比單次 rollout 平均高 6.2 分;Claude Opus 4.8 則高 6.4 分,五個 benchmark 的十個 model–benchmark settings 均取得最高 primary selection score。這些數字反映選擇與修訂能力,不能直接等同完整 artifact 必然正確。

  • 適合長流程工作:文件、試算表、程式碼及多檔案任務均可納入檢查。
  • 核心差異:同一模型負責產生與驗證,優勢來自 rollout pool 結構及環境證據,而非更強的 judge。
  • 研究價值:分開測試 disagreement 與 consensus,能定位模型反覆犯下的共同錯誤。
  • 使用限制:需要模型服務、評分容器及可檢查的任務環境,配置成本高於單次生成。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, Google, Gemini, Anthropic, Dataset 數據集

ThinkV2V 讓影片編輯先思考再生成

ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

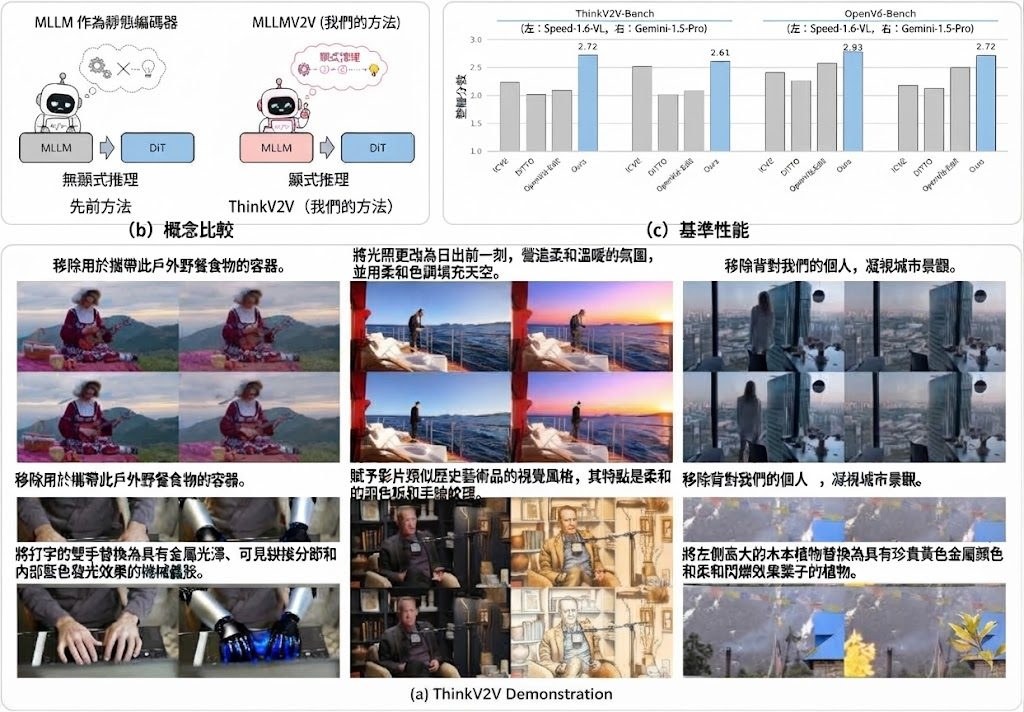
面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

Page 2 of 11
1 2 3 4 … 11