VIS-Ground 讓互動影片真正記住前文與要求

觀眾暫停影片後提出要求,VIS-Ground 會把來源、已播內容與指令整理成可驗證的生成約束。

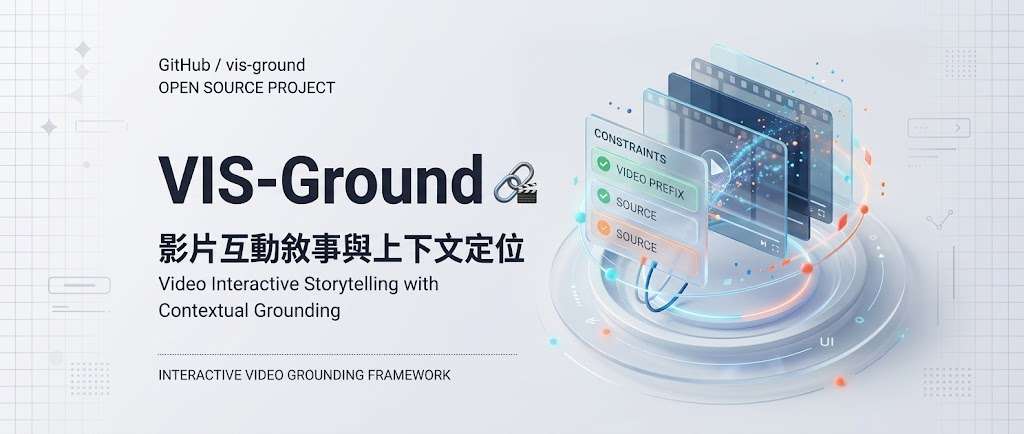
VIS-Ground teaser

觀眾要求「用船運藥,而且不要弄濕」時,系統不能只理解一句新指令,還要記得橋已斷、目的地是祖母家,以及故事原本交代的背景。VIS-Ground 屬於互動影片生成研究框架,處理的正是來源資料、影片前段與觀眾介入之間容易互相牴觸的依賴關係。

它先以 Structured Context Abstraction 對齊 grounding source、已渲染的 video prefix 和 viewer request,再以 Generation Constraints Induction 抽取對下一段影片真正有關的條件,最後經過 plan、verify、revise、render 循環,檢查成片是否同時符合劇情連貫、知識來源和觀眾要求。這比單純把新提示詞交給影片生成器更重視前文約束,但代價是流程更複雜,也需要額外驗證。

  • 以可執行 constraint model 連接文字來源、影片內容與互動指令
  • VIS-Bench 包含 250 個 sources、1,004 個 viewer interventions 和 2,008 個 instances
  • 評估涵蓋 source faithfulness、story continuity、interaction fulfillment 及 joint score
  • 在 Omni-1.1-Flash、Veo 3.1 和 MiniMax-H3 三個 video backbones 均取得最高 composite score
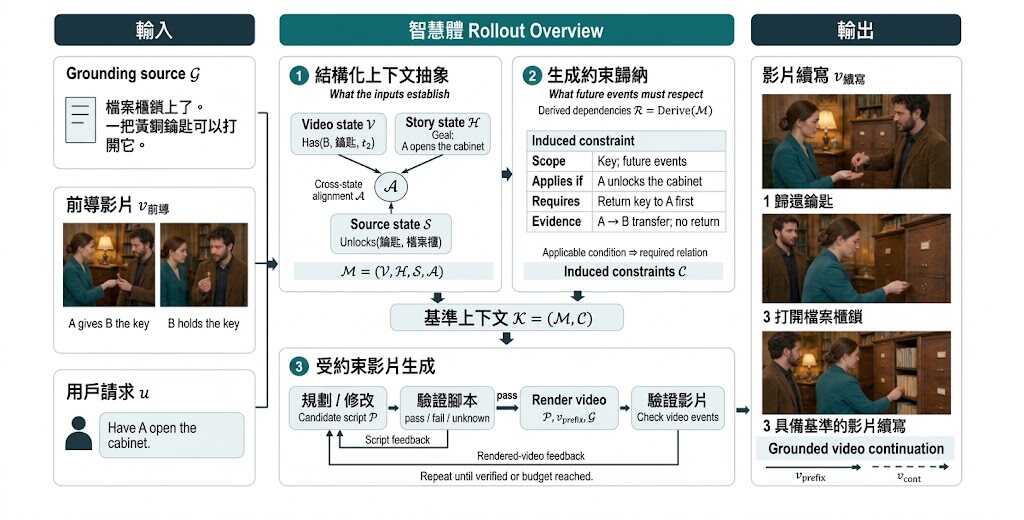
Composite score 為 Omni-1.1-Flash 84.2、Veo 3.1 84.6、MiniMax-H3 78.8,較各自最強 baseline 高 12.3、15.3 和 3.4 分;提升主要集中在 story continuity。這些結果反映方法能跨越不同影片生成 backbone 工作,但資料只涵蓋 1,004 個互動介入,未足以代表所有敘事類型。

適合研究互動敘事、可控影片生成和多模態代理的團隊,用來測試「觀眾改變故事後,生成結果能否守住既有事實與新限制」。GitHub 目前只列出代碼、VIS-Bench 資料和評估腳本預告在 2026 年 12 月 15 日前釋出,因此暫時缺乏可按步驟安裝及本地測試的完整資訊。
項目主頁 · GitHub

Categories: 開源, AI productions, 多模態模型, Video, 提示詞, 框架, Dataset 數據集, MiniMax

ExpActivator:讓 GUI 代理學懂何時啟用個人經驗

ExpActivator 不再把所有相關歷史硬塞進每一步,而是按畫面、時間與情境判斷哪些經驗真正適用。

當個人 GUI 代理執行多步任務時,相關歷史未必適合每一個畫面;ExpActivator 把這個取捨轉化成經驗啟用問題。它屬於免訓練的個人 GUI 代理框架,處理歷史操作何時應該介入當前決策,以及何時應該保持沉默。

逐步啟用會把新畫面放入凍結 GUI backbone 的 latent space,尋找相近的歷史狀態,再把對應動作交給 policy 作參考,代理可以採用、修改或拒絕。任務級啟用則只會在時間和情境都支持時提出重複意圖,否則選擇 abstain;相比把整段檢索歷史附加到 context,歷史不再被視為每一步都有效。

PersonalAlign 評估涵蓋 775 個個人化執行 episodes、7,915 個 actions,以及 215 個正面和 100 個負面 proactive suggestion states,測試 Qwen3-VL-8B、MAI-UI-8B、Qwen3.5-9B 和 GUI-Owl-1.5-8B。以 Qwen3-VL-8B 為例,ExpActivator 的開首步驟成功率為 70.06%,後續步驟為 26.67%,高於無歷史的 28.26%和 18.43%;研究頁亦報告平均軌跡步驟成功率提升約 28%,proactive suggestion 的 MCC 約為最強基線的 2.3 倍。

適合研究個人化 GUI 代理、重複工作流程和主動建議的團隊測試。項目不會訓練模型或預測參數,PersonalAlign 提供安裝及執行流程,但需另取 PersonalAlign 的 Fingertip20k;記憶應採用每位使用者按時間排列的前 80%,避免與執行測試 episodes 重疊。

  • 按畫面逐步啟用歷史動作,而非只按任務檢索
  • 按時間與情境判斷是否提出主動建議
  • 凍結 backbone,無需重新訓練模型
  • 同時測試個人化執行與 proactive suggestion
  • 依賴外部 Fingertip20k 歷史資料及多個 GUI backbone

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 庫, UI/UX

Video-RSI:不改模型權重,讓影片代理自行進化

Video-RSI 透過改寫提示詞、工具、記憶與執行邏輯,提升影片理解代理的準確度及取樣效率。

Video-RSI framework: Solver execution, active video investigation, and cost-aware harness evolution.

影片理解代理遇到答錯問題時,未必需要重新訓練模型。Video-RSI 是一個開源框架,讓代理重新檢視影片,補充視覺、字幕及 OCR 證據,再把失敗原因轉化為可重用的程式修改;模型權重則保持不變。

項目由 Solver 和 Editor 配合:Solver 執行影片問答,Editor 調查失敗案例,並演化 prompts、tools、memory 及 execution logic。相比只調整模型參數,這種做法把改善集中在可執行 harness,較適合需要快速反覆修正工作流程的研究團隊。

  • 透過額外視覺、transcript 及 OCR 證據分析錯誤
  • 以 accuracy 和 visual-frame cost 共同篩選修訂版本
  • 提供 Initial harness、final harness、inference 及 evolution framework
  • 預設支援 DeepSeek-V4-Pro 和 Qwen3.6-Plus 等 OpenAI-compatible service 模型

評測會在私有 Gate set 以答案準確度及視覺影格處理成本配對選擇版本。項目資料所述結果指向更佳的 accuracy–efficiency trade-off:演化後 harness 在維持競爭力準確度的同時,處理較少影格,但未有公開具體分數或基準逐項差距。

要測試項目,需要 Linux、Python 3.12、兼容 API 服務,以及本地 RapidOCR 3.9.2 PP-OCRv6 small detection and recognition models;影片輸入採 JSONL,包含問題、選項、片長及絕對路徑,也可載入 faster-whisper large-v3 產生的 transcript。需要留意,允許 provider calls 會使用付費模型 API,因此成本控制和本地 OCR 準備是部署前的重要取捨。

項目主頁 · GitHub

Categories: 開源, 模型訓練, Qwen, DeepSeek, API, Video, 提示詞, 框架, 工具, Linux, Python

StereoBind 讓生成聲音跟隨畫面移動

StereoBind 不只同步影片與聲音,還嘗試讓聲音方向跟隨畫面中的發聲物體移動,為沉浸式生成補上空間感。

StereoBind logo

當畫面中的車輛、人物或物件移動,聲音不應只在時間上同步,還要讓聽者感覺聲源位置一同改變。StereoBind 屬於聯合影片與音訊生成模型的研究項目,處理的正是立體聲與可見聲源之間的動態空間對應問題,面向 AR/VR、互動遊戲及沉浸式內容製作較有價值。

StereoBind 在預訓練的 joint audio-video generator 上加入視覺來源的 motion tracks,將畫面中的移動軌跡傳給音訊生成流程。Simple Summary Tokens 壓縮來源內容與動態資訊;Spatial Track Encoder(STE)編碼每個時間點的標準化 2D 位置;ResidualTrackRoPE 則把相對軌跡變化加入 temporal attention,令模型同時理解聲源所在位置及移動方向。

  • 以軌跡連接視覺來源與 stereo audio
  • StereoWorld-29K 提供附帶 motion tracks 的立體聲影音資料
  • StereoWorldBench 用來量度聲音是否跟隨可見聲源
  • 目標是改善空間對齊,同時保留整體影音品質

StereoWorld-29K 不只是訓練資料,亦包含由真實影片及軌跡控制合成場景整理而成的幾何監督;StereoWorldBench 則針對聲音與畫面來源在時間上的空間一致性作評估。項目資料稱實驗能大幅改善立體聲生成的空間對齊,但目前提供的資訊未列出具體分數、基準模型或延遲數據,因此未能判斷它在不同場景的實際優勢幅度。

GitHub 儲存庫目前仍屬公開發布前狀態,inference code、training code、設定檔、checkpoints、StereoWorld-29K 及評估套件尚未提供,亦沒有可照做的安裝流程。研究團隊、影音生成模型開發者,以及需要聲音方向隨畫面移動的 AR/VR 和遊戲製作流程,可以先把它理解成一套待公開的 trajectory-conditioned 聯合生成框架;現階段較適合閱讀研究概念及等待後續資源,而不是立即部署。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Video, World-Action Model, Audio, 框架, 庫, Dataset 數據集

RSI-Anything:用世界模型推動跨領域遞迴自我改進

RSI-Anything 把預測、行動回饋與學習串成循環,讓同一套框架應對程式修復、GUI 操作及實驗規劃。

RSI-Anything overview: diverse domains, JEPA-Anything predictive foundation, action and interaction, and recursive self-

當系統需要由多個候選行動中揀選較佳方案,RSI-Anything 會先預測後果,再透過外部評估修正下一輪決策。它屬於建基於世界模型的通用框架,處理的是模型如何利用互動經驗持續改善,而不只是在單次任務中產生答案。

框架以 JEPA-Anything 作為預測基礎,將候選生成、預測引導選擇、外部評估、學習和保留成果串成「Propose → Predict → Select → Evaluate → Learn → Retain」循環。不同領域可自行定義狀態、行動、預測目標和回饋,因此同一流程能延伸至 code repair、GUI interaction、laboratory planning、reaction optimization 及 immune science。

可從以下幾點理解其價值:
– 以世界模型預測行動後果,減少只靠試錯作決策的需要
– 以外部回饋檢驗選定行動,將經驗帶入下一輪學習
– 支援程式修復、GUI 操作和實驗規劃等不同工作情境
– Hugging Face 提供 RSI-Anything 數據集,包含 image、text 及 3.2k rows,分為 train 3k 與 test 200

資料集包括 historical_actions、candidate_next_actions、reasoning 和 next_action,較適合研究候選行動選擇及實驗流程推理;項目未在所提供內容中列出具體性能數字,因此應先視為研究框架與資料資源,而非已證實能普遍自我提升的成熟系統。

項目主頁 · GitHub

Categories: 開源, 模型, 世界模型, Image, 框架, Python, Dataset 數據集

[技術文章] HARNESSSQL 讓 SQL 代理在真實資料庫中學習

SQL 代理不再只需一次生成查詢,而是在可執行資料庫內探索、修正錯誤並完成任務。

Hero image preview

面對陌生資料庫,SQL 代理往往要先查看 schema、檢查欄位和值,再執行試探查詢、分析錯誤,最後修訂並提交 SQL。HARNESSSQL(Harness-Native Training for SQL Agents in Realistic Database Environments)是一套面向這類互動流程的後訓練框架,針對模型訓練只學習「問題直接對應查詢」、但推理時才加入執行工具的落差作出修正。

傳統 Text-to-SQL 通常把資料庫視為靜態提示內容,難以涵蓋長時間、多回合的探索。HARNESSSQL 建立隔離且可執行的資料庫環境,配合隱藏的 execution oracles,讓教師模型直接在目標 SQL harness 內完成互動,並只保留經驗證的操作軌跡進行 full-sequence SFT,之後再以 execution reward 進行 RL。

項目的核心做法包括:
• 將 schema 檢查、工具呼叫、查詢執行及錯誤修正納入訓練流程
• 以 sandbox 控制資料庫狀態,保存結果與錯誤回饋
• 只使用可驗證的成功軌跡,減少錯誤示範干擾
• 讓模型適應 Spider 2.0-SQLite 的互動式任務

在 Spider 2.0-SQLite 上,Qwen3-8B 的 execution accuracy 由 15.5% 升至 45.2%,Qwen3-14B 則由 22.2% 升至 54.8%;訓練所得能力亦能轉移至 BIRD-Interact 和 LiveSQLBench。結果反映,資料庫代理要處理複雜工作流,訓練階段同步保留執行 harness,比只在推理階段補上工具更能縮小訓練與使用環境的差距。

Paper

Categories: 開源, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, Qwen, 微軟, 框架, 香港, 工具, 庫, 強化學習

WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

OuroWorld 讓靜態 3D 世界循環動起來

OuroWorld 把靜態 3D 場景轉成可由移動鏡頭觀看、動作無限循環的 3D cinemagraph,亦毋須手動製作遮罩。

OuroWorld Logo

想把重建好的 3D 場景變成有火焰、流水、物件活動或光線變化的循環畫面,OuroWorld 提供了一條直接的處理流程。它屬於 mask-free 的 3D 動態生成框架,會將任何來源的靜態 3D Gaussian Splatting (3DGS) 場景轉成可從不同視角觀看的 3D cinemagraph。

項目不只處理流體般的局部變化,也涵蓋一般形變、物件運動及 illumination change;輸入可以來自傳統重建,亦可以是 HY-World 2.0、Marble 或 Lyra 2.0 等 3D world model。相比需要逐個區域製作遮罩的流程,OuroWorld 減少了前期標註工作,但動態內容的控制精度和生成結果仍要視乎輸入場景與模型能力。

測試時需準備符合格式的 3DGS 場景,以及描述鏡頭的 camera JSON。c2w 使用 OpenCV convention 的 4×4 camera-to-world pose,K 以像素表示,principal point 必須位於影像中心;項目亦提供 ouroworld-import world 方式匯入場景,沒有 camera JSON 時會採用預設鏡頭配置。README 的資料格式說明對接駁外部 3D 世界尤其重要。

可留意的重點包括:
– 由靜態 3DGS 場景生成動態 3D cinemagraph
– 支援移動鏡頭,而非只輸出固定視角動畫
– 不需人工 mask,並處理形變、物件運動與光線變化
– 可接駁重建場景及多種 3D world model
– 筆者被拒下載 Hugging Face 由 Meta 管理的權重

對 3D 重建、世界模型展示、互動場景預覽及視覺內容製作團隊而言,OuroWorld 的價值在於把靜態資產延伸成可循環播放的動態內容。它較適合研究原型和展示項目,正式製作前仍應檢查鏡頭參數、場景格式,以及長時間循環時是否出現動作或光照接縫。

項目主頁 · GitHub

Categories: 開源, 模型, 世界模型, Image, 框架, 3D, 動畫, Dataset 數據集

SparseDecoding 針對 LLM 解碼加速至 1.48 倍

SparseDecoding 針對生成階段重新校準剪枝,兼顧模型準確度與解碼速度。

Og image

大型語言模型(Large Language Model,LLM)逐個生成 token 時,延遲往往受記憶體讀取限制;SparseDecoding 以解碼階段為核心重新設計剪枝流程,減少需要讀取的非零參數,處理稀疏模型加速與輸出質素之間的取捨。

傳統剪枝方法通常從固定自然語料收集 calibration activations,再計算 Hessian;但模型生成 token 時會依賴自己早前產生的內容,兩者分佈不一致,令剪枝後的表現受影響。SparseDecoding 改為在 dense model 進行 autoregressive generation 時,按層收集模型自行生成的 activation,並略過 prefill 階段,讓校準資料更貼近真正解碼流程。

系統部分則針對解碼主導的 sparse matrix-vector(SpMV)運算,加入支援 N:M sparsity 的 bitmask indexing 與 fixed-step traversal kernel。這和主要優化 prefill 的 sparse matrix-matrix multiplication(SpMM)方案不同,後者在部分 autoregressive decoding 情境下未必能超越 dense throughput。

實驗涵蓋 Llama-3.1-8B、Llama-3.3-70B 及 Qwen3-14B/32B,在 WritingBench 和 ClassEval 等測試中維持具競爭力的結果;A100 上的端到端 decoding speedup 最高達 1.48×,不同稀疏模式則約為 dense 模型的 1.34 至 1.48 倍。

  • 以模型自行生成的 token 作 decoding-aware calibration
  • 略過 prefill activation,聚焦 autoregressive decoding
  • 提供優化 N:M SpMV kernel,支援 bitmask indexing
  • 在 50% 權重保留率及 2:4 sparsity 下測試
  • 目前屬於 preprint,程式碼標示為即將提供

項目主頁

Categories: 模型, 模型訓練, Qwen, 框架, LLaMa

RobotWorld:把多模態智能體放進機械人世界測試

想比較多模態模型控制不同機械人的能力,RobotWorld 提供 84 項模擬任務及隱藏評測。

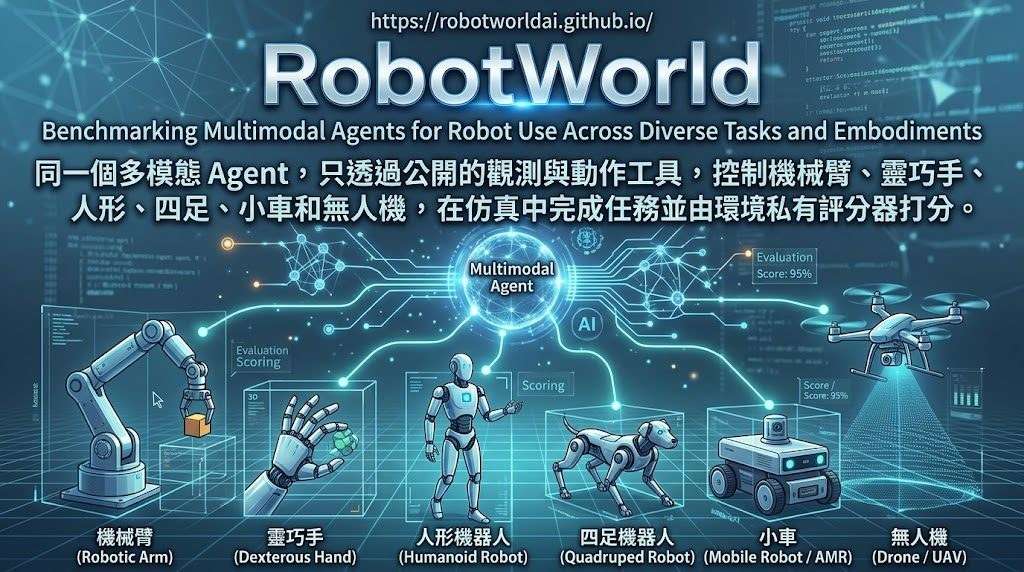
Watch RobotWorld in 45 seconds

想測試模型能否由影像和狀態資訊控制機械人,而不只是回答完成任務,RobotWorld 提供一套跨模擬器的機械人基準測試項目。它屬於具身智能體評測框架,讓多模態代理透過觀察與動作介面控制機械臂、靈巧手、人形機械人、四足機械人、汽車及無人機,處理 84 項任務和 20 個 benchmark integrations。

代理只能讀取允許的相機影像、關節及任務狀態,再發出受限制的控制指令;環境會回傳執行收據和新觀察,讓代理修正下一步。任務結果由代理看不到的 hidden evaluators 判定,避免模型自行聲稱成功而取代環境驗證,亦能揭示物件狀態遺失、子目標停滯和錯誤完成判斷等失敗原因。

  • 評測方式:預設每項任務進行三次 rollout,並停用 environment-side code control。
  • 涵蓋範圍:由 manipulation、locomotion 延伸至 driving 和 flight。
  • 執行流程:需要還原 source、準備指定 assets、建立 Docker images、編譯 runtime,以及設定模型 API credentials。
  • 限制:已註冊任務不代表全部都有已驗證的成功軌跡,部分依賴和受限制資料集仍需另行取得。

相比只測文字答案或單一機械人的方法,RobotWorld 把模型推理、感知、控制和環境回饋放入同一條閉環,較適合研究團隊比較不同多模態模型、重現評測流程,或為新任務和新 embodiment 擴充測試。代價是安裝和資源準備較複雜,結果亦會受模擬器、模型設定及每項任務預算影響。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, API, Image, World-Action Model, Robotic, 框架, Anthropic, Dataset 數據集

Page 6 of 34
1 … 4 5 6 7 8 … 34