LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

WorldExam:檢驗世界模型影片的反應力

它不只看畫面像不像,還會測模型能否保住世界一致性與反應。WorldExam 把世界模型影片拆成四層診斷。

WorldExam overview

WorldExam 把重點放在世界模型(world models)影片最常被忽略的地方:畫面好看之外,世界有沒有維持住,場景會不會對動作作出合理反應。它屬於基準測試項目,用來評估可控制影片生成在外觀、操控、空間一致性與內在反應上的表現。

它提供 1,474 個測試案例,涵蓋 camera-driven、action-driven、language-driven 三種控制介面,並劃分為四個診斷層次與八個任務。使用時可依照項目提供的測試案例與統一評估流程,檢查模型在不同場景、不同視角和不同互動條件下的穩定度。

和只看視覺質素或指令跟隨的做法相比,WorldExam 更在意模型有沒有維持空間一致性,以及能否推斷場景應有的反應。它把 scene revisit、terrain interaction、object interaction、social interaction 等情境都納入,適合做影片生成、世界模型、互動式內容與機械人視覺相關研究的團隊。

  • 同時測外觀、操控與世界反應,不只看畫面順不順眼
  • 支援三種控制介面,較貼近不同應用流程
  • 測試案例覆蓋室內外、3D render、電影鏡頭、動畫與 dashcam
  • 有任務級與整體指標,方便比較不同模型
  • 對想看模型有沒有「懂場景」的團隊特別有用

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 世界模型, 框架, 3D, Dataset 數據集

[技術文章] StyleForge 以反事實推理統一室內家具風格配搭

面對固定間隔的室內佈局,StyleForge 不再逐件揀家具,而是連同整個房間一齊判斷風格協調。你可以把它理解成一個會追蹤跨家具衝突的選件框架。

Hero image preview

固定佈局的室內家具風格配搭,難點唔係搵到單件外觀相符嘅家具,而係放埋一齊之後會唔會撞色、撞材質,甚至整體氣質唔夾。StyleForge 就係針對呢個問題而設,喺唔改變家具類別、位置、朝向同比例嘅前提下,幫系統為每個家具槽位揀出更一致嘅組合。

現有做法多數只係逐件檢索,或者靠靜態關係去描述房間,結果容易忽略全局配搭。StyleForge 改用 scene-level structured selection framework,先由凍結嘅 multimodal large language model(MLLM)抽取風格線索,再由可學習嘅候選分佈配合 dynamic hypergraph style field,捕捉家具之間更高階嘅依賴。

佢另一個重點係 counterfactual style preference learning。做法係將每個候選視為當前風格場入面嘅局部替換,然後用 Mahalanobis energies 去評估同上下文嘅相容性,訓練時再交替優化風格場同候選 logits;推理時只更新房間專屬嘅候選 logits,逐步修正跨槽位衝突。

  • 同時考慮單件相關性同整體房間協調
  • 用動態 hypergraph 去表達跨家具依賴
  • 以反事實推理檢查候選喺場景中的相容性
  • 推理階段只調整房間專屬 logits,模型主體保持凍結
  • 喺 3D-FRONT 上做出較一致嘅固定佈局家具安排

作者喺 3D-FRONT 上展示咗更高嘅 furniture retrieval 表現,同時亦提升 scene-level style coherence。對做虛擬室內設計、3D 內容製作,或者需要穩定室內擺設嘅 immersive embodied environments,呢種「先睇整體,再揀單件」嘅方法會更貼近實際需要。

Paper

Categories: 框架, 3D, 中國

Montara 本地優先影片工作台

想用同一套時間軸管理生成、剪接同輸出影片,Montara 提供咗一條幾務實嘅路。它唔靠單一雲端服務,先確保你能穩定產出真正可播放嘅 MP4。

Montara engine matrix demo preview

做影片流程最麻煩,往往唔係生成一段畫面,而係素材、剪接決定、旁白、輸出格式同後續修改散落喺唔同工具。

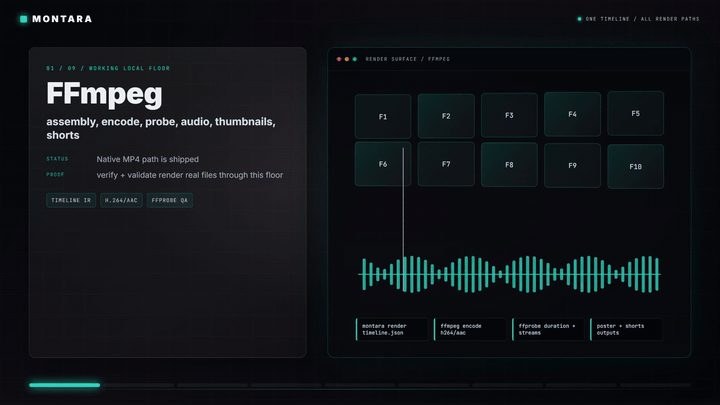
Montara 就係朝住呢個痛點而來:一個本地優先嘅開源影片製作工具/框架,用 Timeline IR 做唯一時間軸來源,將規劃、編輯、渲染同交接串返埋。

它吸引嘅地方,在於先處理「冇雲端都要交到片」呢個現實限制。就算零 API keys,仍可經 FFmpeg 走本地 fallback 輸出可觀看 MP4,連字幕卡、語音路徑同部分媒體都預留咗本地方案;有裝 Remotion 就做 native smoke,冇裝亦會退回 FFmpeg,呢種設計比起只展示理想雲端流程嘅項目踏實得多。

同類做法常見係綁死某個生成服務或者某款剪片介面,Montara 反而把 provider 放成可插拔層,會建立 request、做 redaction、支援 dry-run 同 live-audit,但付費雲端呼叫要明確開啟。代價亦好清楚:它而家最成熟嘅係時間軸驗證、編輯操作、渲染路徑、editor bridge 匯入匯出,同埋真實 MP4 渲染與 post-render QA;README 亦講明長片規模仍屬 roadmap,唔係所有電影級工作流都已全面驗證。

  • Timeline IR 把場景計劃、剪接決定、匯入 editor cut 同生成素材收斂成一份 JSON
  • 本地路線完整,FFmpeg 係通用底線,部分 video/image/speech/music 有 fallback
  • 可匯出 EDL、OTIO、FCPXML,方便轉去 Premiere、Resolve、Final Cut 繼續做
  • provider 機制重視審計與可驗證性,適合要保留流程紀錄嘅團隊 較受惠嘅會係想把 AI 生成同傳統後期接埋嘅內容團隊、要保留本地控制權嘅創作者,或者打算讓 agent 參與影片流水線嘅開發者。

Montara 已經唔止係 demo 級拼裝,因為它把「可編輯來源」、「真實渲染結果」同「可交畀剪輯軟件接手」放埋同一條線;不過想追求高度成熟嘅長篇製作,仍要留意目前覆蓋範圍主要集中喺已測試嘅 renderer 同橋接能力。

GitHub

Categories: 開源, Agentic, API, Video, 影像處理, 框架, LTX

PALATE 改寫角色扮演 AI 才算演得好

現有角色扮演評測用固定對話歷史加統一評分尺,難以反映真實用戶體驗。PALATE 改為訓練專屬用戶模擬器並生成個人化評分準則,讓評估貼近每個用戶的真實感受。

Overview of the PALATE evaluation pipeline

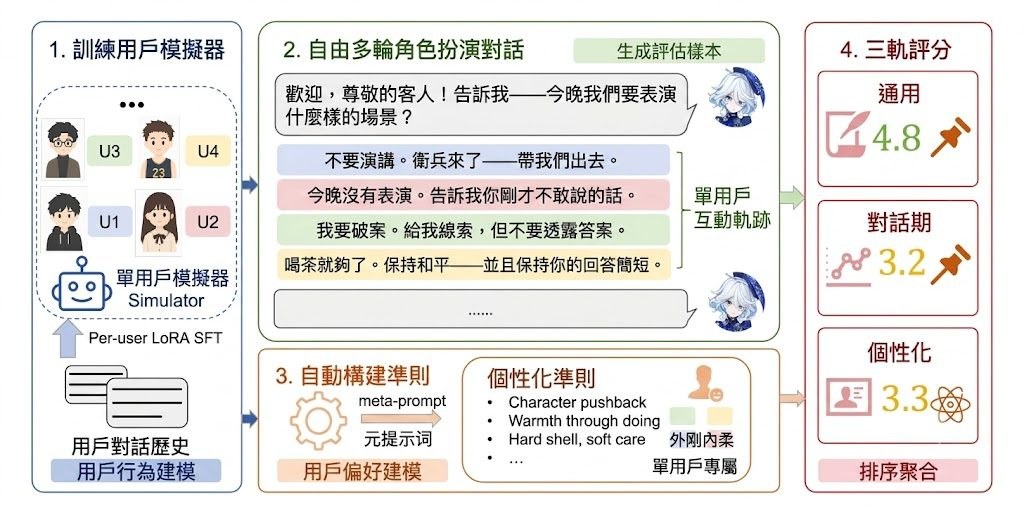
PALATE(Person-Aligned LLM-Simulated-User Assessment with Tailored Evaluation)的核心做法,是為每位參與者訓練一個專屬的 LoRA 用戶模擬器,讓模擬器和候選角色扮演 AI 自由多輪對話,再從該用戶的歷史數據自動生成一套個人化評分尺。評估拆成三條軌道:針對特定用戶–AI 配對的個人化體驗品質、跨用戶通用的回合級角色扮演品質,以及整個對話過程的連貫性與發展。

角色扮演 RPAs(Role-playing agents ) 的表現好不好,往往不只是模型本身的問題,而是和它對話的那個用戶決定。現有基準普遍要求模型接續一段預寫好的「借用對話」,再用統一的評分尺去評那段回應,結果把模型能力、前置對話品質、個人偏好混在一起打分。中國科技大學與 MetaStone 的團隊指出,這種做法忽略了用戶之間的巨大差異,也無法在真正的多輪場景下做科學評估。

團隊用 16 個候選系統生成 1,600 條獨立軌跡進行評測。個人化軌跡上,Qwen3-Max 領先;GPT-5.4 在通用軌跡表現最佳;Claude Sonnet 4.6 則主導會話軌跡。值得注意的是,沒有任何模型在所有五位用戶上都勝出,反映出個人化評測的必要性。個人化評分尺與人類判斷的一致性達到 0.613,高於通用評分尺。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 框架, 中國, Dataset 數據集

OmegaUse-OfficeVal 量度 Office 代理能力

想比較 LLM agents 做 Office 工作交付得好唔好,單靠主觀打分唔夠。OmegaUse-OfficeVal 用可執行驗證器同經濟訊號,將評測流程整理成可重跑的框架。

OmegaUse-OfficeVal benchmark framework

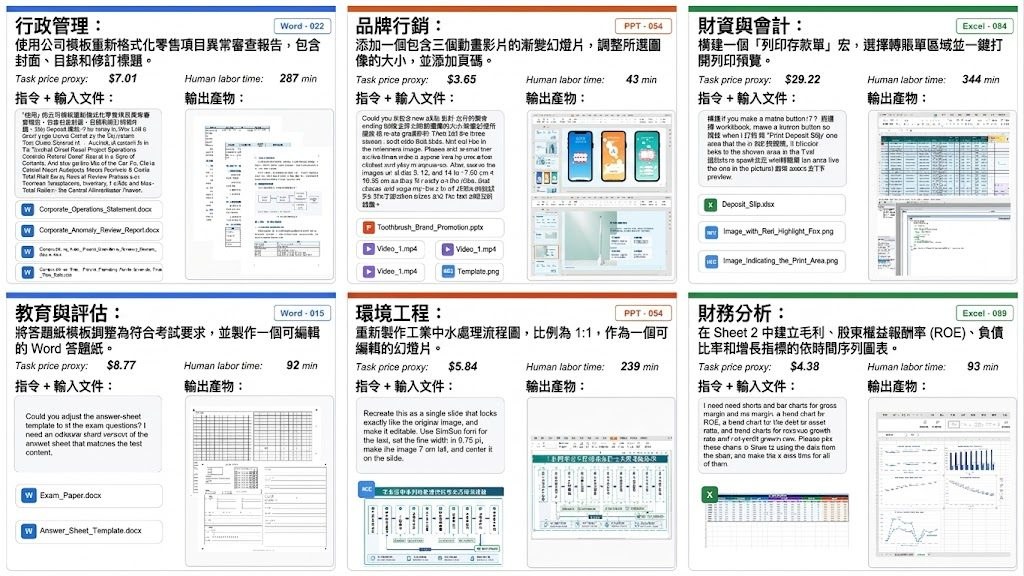
做 Office-suite 長流程任務,最難唔係叫模型產生文件,而係點樣穩定判斷交付物到底合格未。OmegaUse-OfficeVal 把這件事做成一個 Python 框架,同時連接 benchmark 思路與驗證流程:它收 ZIP 提交、先做安全檢查,再逐個執行 100 個 Office document evaluators,最後輸出 JSON 同 CSV 報告,適合用來評測 LLM agents 在 Office 任務中的完成度。

呢個項目的取向幾鮮明:重點唔放喺即場互動,而係放喺可重複、可審核、可批量執行的驗證。網站資料亦交代,OmegaUse-OfficeVal 對應的是一組有經濟 grounding 的長時程 Office-suite tasks,100 個任務平均要 2.32 小時人手完成,並附有人力時間與 task price proxy,方便把模型推理成本同人類成本放埋一齊看。相比只做最終分數排行,這種設計更接近團隊挑選 agent、比較交付價值時會遇到的問題。

它不是把資料集、提交內容同工作目錄全部包在倉庫內,而是把評測框架與 verifier source code 分開提供,benchmark data 另外發佈。Python 3.10 以上可跑,Windows、macOS、Linux 都支援 normal mode;其中 91 個 verifiers 可跨平台執行,另有 9 個 verifiers 依賴 Windows 上的 Office COM,相關環境未齊時會被跳過或只限指定平台處理。

  • 以 evaluate(directory: str) -> dict 統一 100 個驗證器介面,方便批量評測與整合
  • 收件前先檢查 ZIP traversal、加密、大小、檔案數量與壓縮比,安全性考慮算完整
  • 每個 verifier 在隔離 subprocess 執行,可設定 concurrency 同 timeout,減少互相干擾
  • 輸出採用 machine-readable JSON、CSV,而且每個 verifier 各有結果,後續分析較方便

這個倉庫裡主要體現在覆蓋範圍與流程穩定性,而唔係模型速度本身:可見進度、目前 verifier ID、執行 channel 同耗時,對跑大批提交會實用。它更像一個面向 Agentic 評測、研究復現同內部驗收的基建項目;想測 Office 類代理,尤其想把安全收件、隔離執行、可讀報告放進同一條流水線,這個項目的完成度相當高。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 框架, Mac, Linux, Python, Dataset 數據集, 百度

Octafuse Gateway:幫 Agent 管好多模型入口

Octafuse 團隊做的不只是轉發層,而係把模型、工具同配額管理收埋到同一個入口。對要同時接多個 AI 服務嘅團隊,呢種集中控制會直接省下不少營運工序。

Octafuse Gateway 运营概览

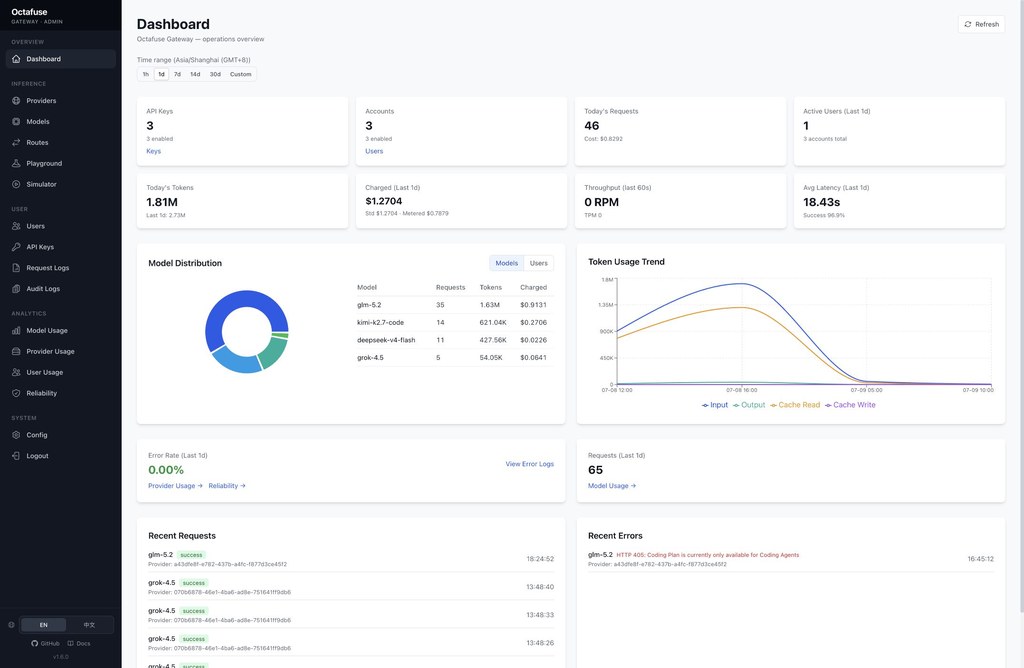
Octafuse 團隊把重點放在 Agent 工作流,而唔係只做一個轉發請求的薄層。Octafuse Gateway 屬於可自託管開源 AI gateway,處理的是多供應商模型、圖像、語音轉寫同 Agent Tools 分散管理的問題,特別適合已經有多組 API Key、不同模型來源,甚至自建服務要一齊協調的團隊。

它最有價值的地方,在於把「接得通」進一步做成「管得住」。同類項目常見重點是模型代理與相容 API,Octafuse Gateway 另外加強了路由、故障轉移、預算、審計、三賬本計費,同埋公開能力目錄,令 Agent 可以透過統一入口發現同調用資源,而管理者亦可以追蹤成本與用量。

部署方向,支援 Cloudflare Workers + D1,以及 Docker 配合 Postgres / MySQL 自託管;Node.js 20+ 亦是明確要求。原始資料未展示完整安裝步驟,但有 operator 文件、Admin 管理界面、Playground 同 Simulator,反映它不是只給開發者讀 API 文件,亦有一套管理與聯調介面可用。

  • 兼容 OpenAI Chat Completions、Anthropic Messages、Gemini、OpenAI Images 與 OpenAI Audio Transcriptions API
  • 可集中管理 Provider API Key、RPM / TPM、並發、熔斷狀態與剩餘容量調度
  • 內置 Provider 與模型導入模板,減少逐個端點手動維護
  • 提供 /v1/tools/* 接入 Agent Tools,現有 web-search、web-fetch、web-deep-search
  • 有 Playground、Simulator、審計與成本觀察能力,方便排查路由與計費設定

它強調的是可靠調度與營運控制,而非單一模型跑分。對需要向內部團隊、客戶或不同項目發放獨立 API Key 的環境,這種以資源治理為核心的取向,比單純聚合模型端點更完整,但相對也代表配置面會更廣,較適合已有多模型、多使用者或多成本中心需求的團隊。

GitHub

Categories: 開源, Agentic, OpenAI, Gemini, API, 框架, Anthropic

Galahad:12B 凍結模型零解碼作答的工業經驗

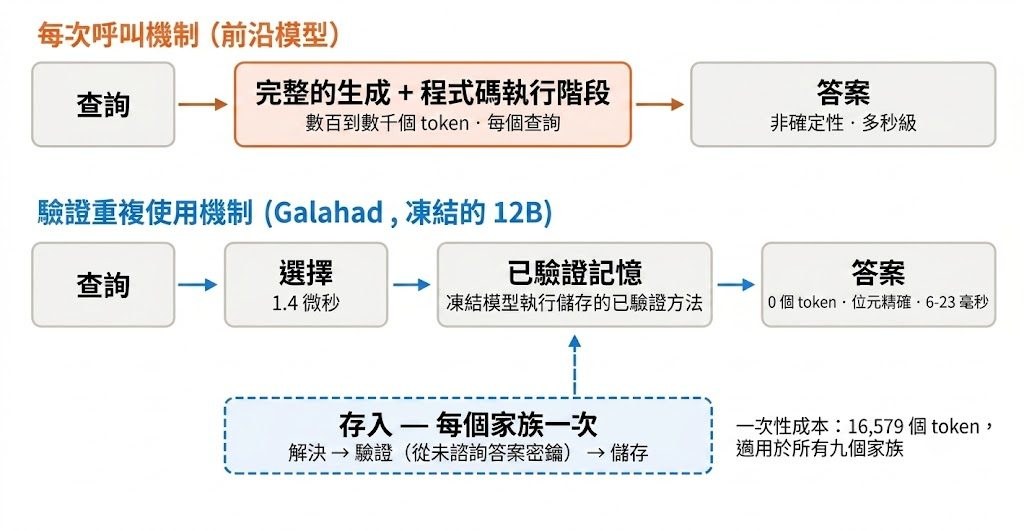
你可以把它理解成:模型不重新推理,而是直接重用已驗證過的求解結果,每次都一模一樣,而且不耗 GPU。

Repository image for corbenicai/galahad-bench

這套 Galahad 系統背後的關注點很直接:今天要提升語言模型,就要重訓練,每次都得重新生成答案,既貴又隨機。他們選擇反向操作——模型參數完全凍結,只在旁邊持續累積已驗證的解題記憶。同一個 12B 模型,對於已處理過的題目家族,直接命中記憶中的求解器,整數級精確一致,每次結果都完全相同,而且生成 token 數為零;對於新題目,則照常從零推理解答。系統聲稱在 180 個全新題目、橫跨九個題目家族上,讓四個來自不同供應商、架構各異的開源模型全部拿到 180/180,並且每次回答都不耗任何生成 token。

這個做法最值得留意的,是它對「記憶」一詞的重新定義。系統內部存的是可被獨立外部 oracle 自動驗證的執行式解題結果,不是用相似度檢索找出來的近似片段。作者在特別批評了業界慣用的近似向量相似度檢索:在一個 4,500 條已驗證答案的庫上,這種方法有 94.3% 機率選錯項目,而精確定址則零錯誤。換句話說,對於可驗證、可執行的知識,相似度近似檢索不是表現稍差,而是幾乎不可用,精確定位是必須的設計前提,不是可選偏好。

對於要部署閉環計算、形式化證明、程式碼執行這類可驗證任務的團隊,這套思路很有吸引力:記憶檢索耗時約 1.4 微秒,完整重用流程 6 至 23 毫秒,每次重用只耗 36 毫瓦時電力,相對於一次性求解兼驗證所需的 81.1 瓦時,節能差距明顯。模型本身不重新訓練,能力靠記憶累積,這對想控制運算開支、又需要可重現輸出的場景,例如 CI 中的程式生成或單元測試,是務實的取捨。

但限制也要看清楚:作者指出在公開基準的從零推理上,前沿模型依然遠勝任何 12B;Galahad 的強處是對「已被系統解決並驗證過」的題目家族做到零成本重用,不等於通用智能提升。負面控制也排除了另一種解釋——把記憶清空,系統一道也解不出來,這進一步確認能力確實來自記憶層,不是模型本身突然變聰明。對於想關注的是開源權重能否落地到工業管道的讀者,這份來自 Corbenic AI 的工業經驗報告值得留意,因為它把「訓練之外如何持續累積能力」這條路寫成了可量化的章節。

  • 模型凍結,能力改由外部已驗證記憶承擔,180 題零 token 滿分
  • 精確定址取代向量相似度檢索,在 4,500 條庫上錯誤率 94.3% 對 0%
  • 重用耗時 6–23 毫秒、每次 36 毫瓦時,對比一次性求解 81.1 瓦時
  • 開源模型架構無關:四個不同 dense 與 MoE 模型皆達 180/180
  • GitHub 目前僅放測試頁占位,引擎源碼尚未公開釋出

GitHub · Paper

Categories: 開源, Qwen, DeepSeek, Gemini, 框架, Dataset 數據集

Gemini Spark 登陸香港:AI 代你長時間跟進工作

想交低指示後由 AI 繼續處理雜務,Gemini Spark 就是朝這個方向而來。它把電郵、文件、搜尋與排程串連起來,減少你反覆催促。

Og image

最易理解 Gemini Spark 的方式,是把它看成一個會在背景持續運作的 Agentic AI 助手:你先交代目標,它再慢慢把零散工序接起來,處理那些花時間、又不想不停重複提示的工作。Google 已在香港推出這項服務,定位很清楚,就是幫用家把日常行政與資料整理自動化。

它接上的重點,不是單次問答,而是整段工作流。Gemini Spark 運行於 Google 的雲端基礎設施,能原生連接 Workspace 工具,例如 Gmail 和 Docs,毋須另外設定,就可以整理混亂的電郵往來、彙整行業消息、從舊文件抽資料做後續安排,甚至進行網上資料搜集、比較選項與完成預訂。

Google 提到,系統以 tasks、custom skills 和 schedules 這類機制去安排工作,讓用家用自然語言交代規則、例行事項與時間觸發條件,毋須寫程式。另一個分別在於,它不會因為你闔上手提電腦或鎖上手機就停下來,背景流程仍可繼續運作,較適合需要長時間跟進的文書與研究工作。

  • 支援背景持續執行,不用反覆重新提示
  • 可原生連接 Gmail、Docs 等 Workspace 工具
  • 能處理資訊整理、排程準備、網上研究與預訂類工作
  • 高風險動作前會先要求明確同意

控制權仍然留在用家手上。Google 表示,Gemini Spark 會按照用家指示運作,用家可決定何時啟用,以及容許它接觸哪些應用程式;遇到交易或發送電郵等高風險操作,系統亦會先徵求明確授權。現時香港由 Google AI Ultra 訂閱用家率先使用,Google AI Pro 用家的開放時間會在未來數星期逐步擴展。

項目主頁

Categories: Agentic, Google, Gemini, 提示詞, 框架, 香港, 工具, 編程, Skill 技能

VCSD 點樣逼可以 Vision-Language Models 真係睇圖

同一條問題配原圖同抹走內容嘅控制輸入,VCSD用兩次預測差異教模型分清邊啲答案真係來自視覺訊息。它瞄準嘅唔係加大模型,而係減少模型「冇睇圖都答到」嘅錯位。

Cover Figure overview

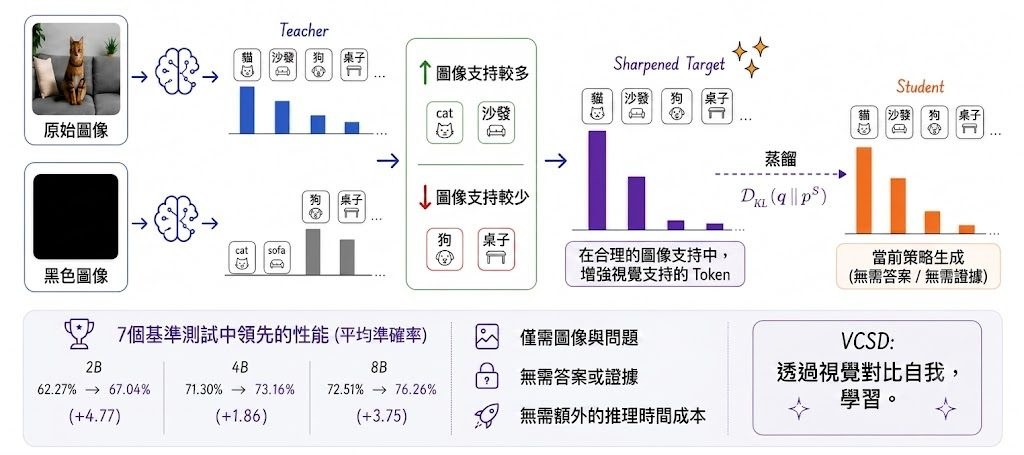
不少 Vision-Language Models 會表面上處理圖片,實際卻沿住語言慣性作答。VCSD 屬於模型訓練方法,針對嘅正正係呢種「答案似乎合理,但未必真係由圖像帶動」嘅問題:它讓同一個 EMA teacher 分別看原圖同內容被抹走嘅 control input,再用兩者對每個 response token 嘅分佈差異,提煉出更依賴視覺內容嘅學習目標。

現有 on-policy self-distillation(OPSD)多數靠 privileged answers 或 visual evidence 製造 teacher 比 student 更強嘅訊號,VCSD反過來把 image-content removal 變成非對稱來源。做法唔係直接獎勵某幾個字,而係用原圖分佈 p_hi 同控制輸入分佈 p_ctrl 嘅 log-probability 差,配合 α 調整對比強度,再用 β-plausibility mask 限制只喺 teacher 原本已視為可信嘅 token 集合內重新分配機率;README 亦講明 β 設成 0.0 會令訓練崩潰,代表呢個護欄唔係裝飾,而係方法成立嘅關鍵。

項目目前仍然係 work in progress,代碼、設定同文件都可能再改。倉庫已放出訓練資料格式線索,例如 train.parquet 需要 prompt 同 image 欄位,train_answer.parquet、val_answer.parquet 用作 answer-conditioned validation;訓練則建基於繼承自 verl 嘅 GRPO/PPO 流程,VCSD 相關改動集中喺 verl/trainer/ppo/vcsd.py、verl/workers/actor/dp_actor.py 同 actor 設定檔,表示它比較似可插入現有 RL 訓練管線嘅附加目標,而唔係一套獨立框架。

  • 核心取向係用 visual contrast 代替 privileged answers 或 visual evidence
  • 學生模型學習嘅係 full-vocab KL 目標,唔係逐 token 手動加權
  • control input 可設成 black、degrade 或 noimg,用來測試答案有幾多真係靠圖像
  • 已公開結果顯示,VCSD 在 ViRL39K 上對 Qwen3-VL 與 Qwen3.5 系列均比 matched OPSD 更好

從已公開數字看,Qwen3-VL 在七個 benchmark aggregate 上由 2B 的 62.27 升到 67.04、4B 由 71.30 升到 73.16、8B 由 72.51 升到 76.26,方向相當清楚:它想改善嘅唔係推理時計算量,而係訓練期間點樣把「圖片真正提供咗乜嘢」變成更乾淨嘅監督訊號。對已經有 Vision-Language Models RL 訓練流程、又想減少外部 teacher 與額外標註依賴嘅研究團隊,呢個項目值得跟進;不過現階段仍要接受文件未齊、介面可能變動,以及結果主要來自論文與項目頁面披露。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Image, VLA, Robotic, 框架, Dataset 數據集

Page 8 of 26
1 … 6 7 8 9 10 … 26