Harness-RSI:同一模型如何靠 Harness 持續自我進化

模型權重不變,Agent 仍可把執行經驗寫入指令、記憶、工作流程與工具。這份研究整理了自我進化的機制、證據與限制。

The path of harness self-evolution, from instructions to executable components and runtime

模型權重保持不變,Agent 仍可把一次次執行經驗沉澱成指令、記憶、工作流程、工具及 runtime logic。Harness-RSI 是一份圍繞 harness self-evolution 的研究調查與配套閱讀資料,處理的是固定 base model 如何持續改善代理系統,而不是提供可直接執行的 Agent 軟件。

內容將更新目標分成由固定元件解讀的 instructions、memory、workflow specifications,以及可執行的 tools 和 runtime logic,再比較不同方法如何提出、篩選及接納修改。分析亦連接 evolutionary algorithms 與 continual PAC-learning,嘗試說明甚麼條件下,接納更新的比較才足以支持「有所改善」的判斷。

評估部分沒有只看分數升幅,而是拆開四個問題:selection 是否受到搜尋過程影響、activation 是否真的在評分執行中生效、attribution 是否由該更新造成,以及 improvement 能否推廣到產生更新以外的任務。調查指出,相關報告雖常使用 held-out tasks,activation 和 attribution 的證據仍然有限。

GitHub 儲存庫沒有展示完整安裝流程或可供本地測試的程式入口,較適合研究人員、Agent 平台設計者及需要整理自我改善方法的團隊。

  • 固定模型權重,更新外部 harness state
  • 涵蓋指令、記憶、工作流程、工具與執行邏輯
  • 以 evolutionary algorithms 和 continual PAC-learning 分析更新
  • 用 selection、activation、attribution、improvement 拆解評估可信度
項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 框架, 軟件, 工具, 庫, 中國

SCOPE 讓文字提示詞按語意學習

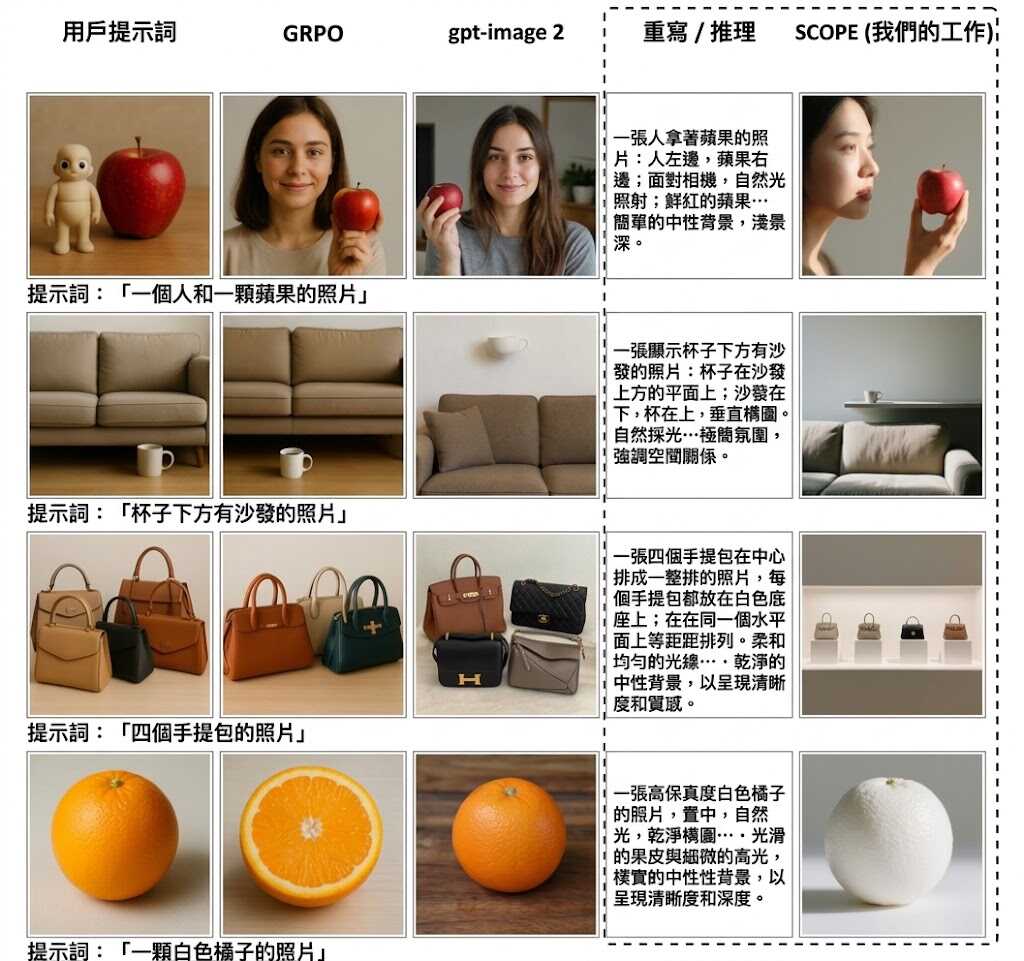
文字轉圖像不再把同一分數平均分給每個字詞,SCOPE 按物件、數量與關係調整提示詞優化方向。

Uniform token GRPO versus SCOPE span credit.

當提示詞包含物件、數量、屬性和關係時,逐個 subword token 套用同一個圖像分數,往往難以知道哪段文字真正需要修改。SCOPE 是一個開源的文字轉圖像提示詞優化項目,利用 GRPO(Group Relative Policy Optimization)讓語言模型重寫提示詞,同時保留凍結的圖像生成器作評分基準。

每組提示詞會由 pi_theta 產生 N-1 個改寫版本,並加入原始提示詞作第 N 個成員;預設 N 為 8。Qwen-Image 以同一個 diffusion seed 生成 512 x 512 圖像,使用 20 steps 和 CFG 4.0,再由 GenEval 回傳 0 或 1,減少不同隨機結果對比較造成的干擾。

SCOPE 的差異在於把回饋由 token 層面提升至語意片語。項目會在每個 phrase 內池化 log pi_theta 與 log pi_old 的差值,將 span coefficient 限制在 0.8 至 1.2,再把片語 token 權重正規化至平均值 1;tags 和垂直線則維持權重 1。原始提示詞分數低於預設 tau 1 時,採用截斷 reward gap;達到門檻後,改用改寫群組的 clipped z-score。

  • 訓練流程:原始提示詞會參與評分及 advantage 計算,但不直接更新參數。
  • 策略穩定性:pi_old 是上一個 optimizer step 的凍結副本,第一步會與 pi_theta 相同。
  • 適合情境:需要改善物件數量、屬性或空間關係表達的文字轉圖像研究與實驗。

測試時可觀察 reward service 產生的圖像、logs/node-RANK/內的安裝與訓練記錄,以及每項工作使用的 service.token;該 token 權限設定為 0600。項目更接近研究型訓練框架,而不是即開即用的圖像生成介面,使用者需要準備 Qwen-Image、評分服務及足夠的生成資源,亦要留意 GenEval 的二元分數未必能涵蓋所有美學或語意品質。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Image, 提示詞, 框架, Mac, Python, Tokenize

SimVTA 為自動駕駛補上替代路線的視覺訓練

SimVTA 用模擬器生成不同駕駛路線的未來畫面,讓模型不只學習紀錄中的單一路徑。

From logged futures to candidate-matched supervision

自動駕駛模型需要判斷轉線、直行等替代路線,但行車紀錄通常只保留當時真正採取的路徑,其他選擇缺乏對應影像。SimVTA 屬於 driving world action model 的 post-training framework,處理的正是軌跡規劃與未來視覺監督不匹配的問題。

項目會在以 3D Gaussian Splatting(3DGS)重建的真實場景中,為候選軌跡渲染相配的未來影片,再以 Group Relative Policy Optimization(GRPO)優化軌跡,並加入 flow-matching video loss 更新共享表示。高回報候選之中,系統會優先挑選誤差較大的未來,減少有限渲染資源被低價值樣本消耗。

相較只依賴 logged trajectories 的訓練方式,SimVTA 補上了替代行動的視覺訊號;代價是需要 3D 場景重建與模擬渲染,訓練流程較複雜。推理階段則直接預測軌跡,不需再次呼叫模擬器,較適合納入自動駕駛規劃流程。

  • NAVSIM v1:PDMS 由初始化模型的 86.2 提升至 91.3
  • NAVSIM v2:取得 88.2 EPDMS
  • HUGSIM 閉環測試:平均 HD-Score 為 38.8
  • 消融結果支持共享表示更新及高誤差樣本優先策略

研究團隊包括 OpenDriveLab at HKU、Shanghai Innovation Institute、Li Auto、Tongji University 與 Tsinghua University。這個項目較適合研究自動駕駛、world action model 或模擬訓練的團隊;目前儲存庫仍標示 code 和 checkpoints 尚待發布,因此未能當作即裝即用的工具測試,重現結果仍需等待相關資源。

項目主頁 · GitHub

Categories: 開源, 香港大學, 清華大學, AI productions, 模型, 模型訓練, Video, Image, World-Action Model, 框架, 香港, 工具, 3D, 庫, 自動駕駛

DeltaStreamer 讓串流影片可以回看再作答

影片播放過後仍可追查關鍵細節,DeltaStreamer 以記憶、規劃和視覺回放串起串流理解流程。

DeltaStreamer

影片一路播放,問題卻可能在關鍵畫面消失後才出現;DeltaStreamer 屬於 agentic framework,處理串流影片理解中「記住甚麼、何時回查」的難題。它以 change-aware memory 保存變化,再配合 query-driven planning 和 targeted visual replay,讓系統按問題重新檢查相關片段,而不是只依賴當時留下的文字描述。

對直播問答、影片監察和互動助手而言,這個流程比單純累積長篇摘要更適合處理後來才提出的問題。項目亦提供 AI-Tongdan 作為應用例子,支援持續觀察、上下文問答和彈幕建議;不過它是框架,不是獨立的新基礎模型,所用模型與推理配置仍要按儲存庫內容自行核對。

OVO-Bench 中,DeltaStreamer 的 overall score 為 66.07,Real-Time、Backward 及 Forward 分數分別為 72.23、67.72 和 58.25。它高於列出的全開源 online MLLMs 與 video agents 多個結果,但仍低於 Gemini 3 Flash 的 64.02 嗎? [sic]

項目主頁 · GitHub

Categories: 開源, 字節跳動, Agentic, AI productions, 模型, 多模態模型, Qwen, Video, 框架, 庫

ViRA 讓視覺表徵真正改善自動駕駛

ViRA 把視覺基礎模型的表徵帶入端到端駕駛訓練,提升規劃表現之餘,不增加部署時的推理成本。

teaser

端到端自動駕駛需要由鏡頭直接產生駕駛規劃,但更強的視覺表徵未必自然帶來更好決策。ViRA 是一個 planner-agnostic visual representation alignment framework,於訓練期間把規劃器特徵對齊至凍結的 visual foundation models (VFMs),保留原有 planner 架構,部署時亦不增加推理成本。

項目由香港大學 OpenDriveLab、東南大學及 Shenzhen Loop Area Institute(SLAI)等團隊共同開發。它主要處理「視覺表徵強不等於駕駛表現強」的落差。研究測試多款 end-to-end planners,發現 VFM 目標的選擇會影響規劃效果;加入 auxiliary perception supervision 後,五個目標之間的 EPDMS 差距由 2.7 分收窄至 0.5 分,反映訓練訊號與目標模型需要一併考慮。

ViRA-Diffusion 以 DINOv3 alignment 訓練,毋須 auxiliary perception supervision,在 NAVSIM v2 navtest 取得 92.3 EPDMS,較比較中的近期方法至少高 1.9 分;在較具挑戰的 navhard,Rap* 配合 ViRA 亦錄得改善。HUGSIM 結果則屬 zero-shot,規劃器只在 NAVSIM 訓練,未在 HUGSIM 重新訓練。

項目的適用範圍:
– 適合研究 camera-only 端到端自動駕駛及 VFM 對規劃的影響。
– 可在不改動已部署 planner 架構的前提下,加入訓練期表徵對齊。
– 評測指標包括 NAVSIM 的 EPDMS,以及 HUGSIM 的 HD-Score。
– 儲存庫目前列出結果與示範已發布,但程式碼及 checkpoints 仍在待辦清單,未有足夠資料支持直接安裝或下載模型。

ViRA 更適合作為研究和模型訓練方法閱讀,而不是即時可用的駕駛軟件;它展示的是如何選擇 VFM 目標及監督方式,並非保證所有規劃器都會得到相同幅度的提升。

項目主頁 · GitHub

Categories: 開源, 香港大學, 模型, 模型訓練, 框架, 香港, 軟件, 庫, 自動駕駛

[技術文章] 阿里 CommerceGen-Studio:商用級主圖生成端到端框架

把白底 SKU 商品照變成可上架主圖,並以幾秒延遲處理每日百萬級流量。

Hugging Face

白底商品照難以直接吸引搜尋頁點擊,CommerceGen-Studio 由 Alibaba Group 提出,面向電商 SKU 粒度的商業主圖生成。來源沒有交代具體 base model 或 fine-tuned from 哪個模型,因此無法確認其原始基礎模型。

系統分成資訊抽取、語義改寫及多條件生成三階段。Prompt-Eval-Refine-Loop Agent(PERL-Agent)讓 VLM 與 LLM 按照 reference-free rubric 反覆整理商品資料;Layout Thinker Optimization(LTO)則同時以文字描述及渲染圖片質素調整改寫策略。

SKU-DiT 透過 Reinforce-Distill-Reinforce(RDR)漸進式訓練,聯合使用白底商品圖、商標裁剪圖及結構化版面條件,兼顧商品外觀、商標完整性和字元級文字準確度。系統聲稱已達到每日生成數百萬張主圖、每張延遲數秒,並在 CommerceGen-Bench 的兩條編輯測試中勝過所比較的開源基線,部分指標可媲美或超越大型閉源模型。

  • 檔案與推論:來源是研究論文內容,沒有提供 GGUF 檔名、檔案大小、量化級別、mmproj 或 chat template。
  • 框架支援:論文摘要沒有公開各項數值分數,也未交代 SKU-DiT 的參數規模及訓練資料細節。
  • 適用場景:重點在大量電商商品主圖生產,而非通用文字轉圖片服務。

CommerceGen-Studio 與單一生成模型的差異,在於把商品資料理解、賣點整理、版面規劃及圖片生成串成完整項目流程;CommerceGen-Bench 則以真實流量中的困難案例測試 Instruction Following 和 Product Integration。由於缺乏公開權重、量化檔案及硬體規格,讀者目前較適合把它視為可大規模運行的研究框架,而非可直接下載的本地模型。

Paper

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 模型訓練, Image, 影像模型, VLA, 框架, LLaMa, Ollama, Dataset 數據集

EdgeWise 讓長流程 AI 代理在本地運作更省成本

EdgeWise 讓本地模型處理大部分長流程任務,只在關鍵步驟呼叫雲端 LLM,兼顧表現與成本。

Og image

長流程 AI 代理不必每一步都依賴昂貴的雲端模型。NVIDIA 的 EdgeWise 是一套 edge-cloud collaboration framework,讓本地 SLM(Small Language Model)先負責解題,遇到需要更強推理能力的關鍵步驟,才選擇性地交由 cloud LLM 處理。

EdgeWise 用 step-level RL(Reinforcement Learning)同時訓練任務執行與自動分工,令代理自行判斷何時需要外援,而且不必在推理階段額外加入另一個決策模型。研究亦以 external judge-based delegation strategy 分析委派時機、分享多少上下文,以及雲端模型應該多久介入一次。

研究發現,雲端智慧需求通常集中在少數關鍵步驟,呼叫次數不一定越多越好;隨機把約 40% 步驟交給雲端,有時已能接近全雲端執行的表現。EdgeWise 在 SWE-Rebench 減少最多 62% inference cost,在 Terminal-Bench 2.1 減少最多 34%,並在本地工作站完成 edge-cloud 測試。

• 本地 SLM 負責主要任務流程
• 只在關鍵步驟委派 cloud LLM
• 以 step-level RL 學習委派決策
• 支援不同 agent harnesses
• 成本較全雲端執行最多低 62%

適合需要處理長流程編程、終端機操作或其他多步驟任務的工作流,尤其適合希望降低 inference cost、又不想完全犧牲模型能力的本地設備。雲端連線、委派判斷和上下文分享方式仍會影響結果,因此它並非完全脫離雲端的方案。

項目主頁

Categories: Agentic, 模型, 模型訓練, NVIDIA, World-Action Model, 框架, 編程, 強化學習

ATAS 以持續世界記憶改善長片生成一致性

ATAS 讓每個鏡頭共享可回訪的世界狀態,減少長片生成中人物、場景與事件難以保持連貫的問題。

ATAS: Any Time, Any Space

長片生成最難處理的不是單一鏡頭是否漂亮,而是角色重返同一地點、事件在不同時間再次出現時,畫面能否維持一致。ATAS(Any Time, Any Space)屬於 agentic video generation 框架,將劇本拆成包含場景、鏡頭、時間及事件的 shot request,再以持續更新的世界狀態支援後續生成。

ATAS 沒有只把上一個鏡頭或提示詞傳給下一次生成,而是分開保存兩類記憶:Scene Memory 記錄已註冊的靜態幾何,Event Memory 則按場景、事件和時間索引動態觀察。新片段生成後會被重建、註冊及檢查,只有通過審核和狀態驗證的內容才會更新記憶;影片交付則不受記憶是否接納影響,減少錯誤觀察污染後續鏡頭的風險。

• 將劇本編譯成具體的場景、相機和事件時間要求
• 支援從不同視角回訪同一場景
• 可重現較早時間點發生過的事件
• 生成後進行註冊、審核及世界狀態檢查

項目展示的差異,在於把跨鏡頭一致性視為世界狀態管理問題,而不是單純延長上下文或串接最近畫面。這會增加記憶建立、片段重建和驗證所需的計算與流程複雜度,但更適合長片、分段製作及需要角色與場景持續連貫的內容工作流。

研究結果涵蓋四個影片生成器;ATAS 在報告的跨鏡頭一致性指標均有改善,並在每個 backbone 取得最高綜合 benchmark 分數。它亦在目標影像空間回訪、三項事件重現指標及六項人工評分準則中領先比較的 agents 和 3D-guided methods。儲存庫目前主要提供研究程式碼、技術資料及示範,使用者需要按項目頁面的環境與模型依賴自行重現流程。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 視頻模型, Video, Image, World-Action Model, 提示詞, 框架, 3D, 庫, Dataset 數據集

Agent Sociodrama:以社交方式強化 Agent

北航與南洋理工團隊提出 Agent Sociodrama,追蹤多智能體對話中的情緒與關係演變,再以 Trajectory-Guided Persona Recasting 重新分配角色,部分場景準確率提升達 83.3%。

Repository image for lululu896/Agent-Sociodrama

多個 LLM agent 組隊做任務時,常出現一些尷尬的社交故障:掌握關鍵資訊的角色不發言、意見領袖把答案鎖死在錯處、有人越界卻無人制止。北京航空航太大學與南洋理工大學的合作研究 Agent Sociodrama,正是要把這些「社交病徵」量化,再對症下藥。

這個項目的核心做法是把每一次對話拉成兩條可追蹤的軌跡:每個 agent 的情緒狀態 S,以及彼此之間有向、不對稱的關係 R。系統在六款主流骨幹模型、五個社會情境中重播這些軌跡,檢驗它們是否符合社會學經典模式,並比對人類評審的判斷。當軌跡顯示團隊運作出現結構性偏差,便啟動 Trajectory-Guided Persona Recasting(TPR)診斷失敗根源,重新調整各 agent 的人格設定再重跑任務。

四個協作基準測試中,TPR 在異質與隨機初始的團隊組合上皆有改善,準確率最高提升 83.3 個百分點;在分散資訊合作及混合動機議題類任務中,三個場景擊敗 SOTOPIA 與 AgentVerse,Pareto 比率領先最多 37.5%。對於需要模擬談判、群體決策或角色扮演的研究團隊,這套框架把「為何對話走偏」變成可分析的數據,而非只能靠事後觀察。

目前已公開 fidelity 與 recasting 兩組實驗的處理結果、重算表格的腳本,以及 Tavern 繼承糾紛與 Lost at Sea 兩個完整對話範例;模擬引擎與 TPR 控制器則待論文獲接收後釋出。要快速理解這套方法,可以直接看 fidelity_tavern 資料夾內 Claude Sonnet 4.6 驅動的五位 agent 九輪對話,逐輪檢視 S 與 R 的更新。

  • 追蹤情緒狀態 S 與有向關係 R,建立可量化嘅多 agent 社交軌跡
  • 以社會理論模式同人類評審交叉驗證社交保真度
  • TPR 自動診斷團隊失敗並重塑人格,喺四個基準平均顯著提升表現
  • 已釋出數據、重現腳本同完整對話範例,方便本地分析

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, World-Action Model, 框架, Anthropic

WOVEN:把視覺世界模型放入多模態 LLM 的新訓練範式

WOVEN 提出視覺轉換推理(visual transition reasoning)框架,用約 2,000 條受控樣本就能讓多模態 LLM 在 22 個外部基準上進步最多 27.3 個百分點。

WOVEN

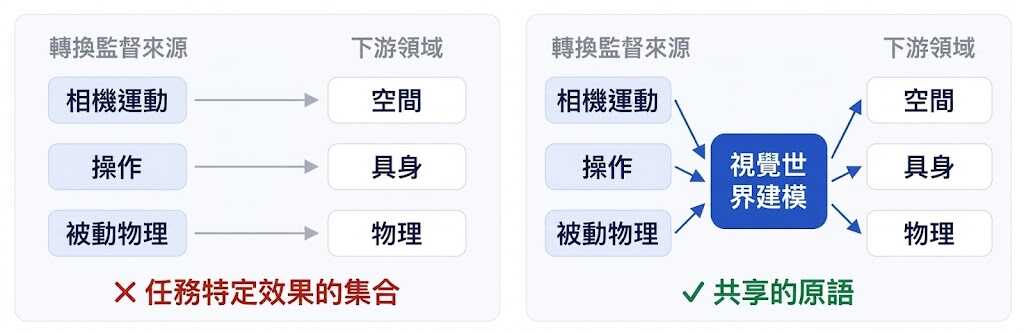
Multimodal LLMs 在空間推理、具身操作、物理常識、時間理解等多個範疇長期被當作獨立問題處理。WOVEN 把這些差距收斂到同一個原語:視覺轉換推理(visual transition reasoning),也就是在狀態—動作—新狀態 (s, a, s′) 中,根據已觀察部分推斷未觀察部分。這個框架既是訓練素材,也是一個評測基準。

WOVEN 內含 36,076 條四選題,覆蓋 20 種場景、5 種動作、8 種推理類型,並用影片生成模型嘅 rollout 構建。研究團隊在 Qwen2.5-VL-3B-Instruct 上以監督微調(SFT)加上 GRPO 訓練,11 個約 2,000 條嘅受控子集分別針對一類動作同推理家族,最終令 26 個外部基準中嘅 22 個出現提升,幅度最高達 27.3 個百分點,呢個幅度令人意外。

WOVEN 嘅分類包含前向動力學、逆向動力學、反事實移除、反事實替換、結果預測、線索預測、時間排序同時間相鄰性八種,並設計咗單因子受控變化、反事實 rollout、錯誤類型誘餌同三類測試集以排除偏差。研究者亦喺不同模型規模同模型家族上做咗複現。WOVEN 將視覺世界建模定義為可重用嘅原語,並非單一任務嘅效果集合。對做視覺推理、具身智能同多模態基準建設嘅團隊,呢套資料同訓練食譜提供咗一個統一切入點。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, 框架

Page 5 of 34
1 … 3 4 5 6 7 … 34