Deepseek Recipe 幫本地推論後端連接多格式 API

在本地跑 DeepSeek 模型、想同時提供 Messages、Chat Completions 與 Responses 三種 API 格式?這個 Rust + Python 工具庫把格式轉換、prompt 渲染與 token 編碼一條龍包辦。

DeepSeek

對想自建 DeepSeek 推論服務嘅開發者來說,最頭痛往往唔係模型本身,而係點樣令自家後端兼容外界各種 API 格式。deepseek-recipe 就係針對呢個痛點而來——它用 Rust 寫核心邏輯,再提供 Python bindings,專門負責將 Messages、Chat Completions 同 Responses 三種主流請求格式統一轉換成 DeepSeek 內部嘅 Conversation 結構,再渲染成模型識讀嘅 prompt,最後用附帶嘅 tokenizer 編碼成 token ID。

呢個庫定位相當清晰:佢只處理格式轉換同 prompt 拼裝,模型推論、工具執行、HTTP 傳輸呢啲都交返俾呼叫方自己負責。換句話講,開發者可以揀任何推論引擎,再喺外面搭一層 recipe 做「翻譯員」,咁就可以用同一個後端撐起多個對外 API 端點。對於正在從 Ollama、vLLM 或自家 CUDA 服務過渡到 DeepSeek 模型嘅團隊嚟講,等於慳咗大量重複開發。

它對 DeepSeek V4 同 V4.1 有針對性處理:V4.1 支援圖像(會用 OpenCV 預處理),V4 則會把圖片替換成 [Unsupported Image] 字串,避免下游出錯。Thinking mode 方面亦照顧周到,無設定時自動補 8192 tokens,開啟 thinking 預設 65536,開到 max effort 就去到 131072。Structured output 同樣齊全,Chat Completions 嘅 json_schema、regex,以至 Responses 嘅 text.format 都做咗驗證同轉寫,並會喺 InferenceOptions 揀選對應嘅 OutputConstraint,畀呼叫方決定要唔要開 constrained decoding。

工具支援亦係重點之一。Function tools 全部覆蓋,V4.1 仲額外支援 Messages 嘅 deferred tool loading 同 Responses 嘅 client-executed tool search,對做 agent 框架嘅人特別有用。串流方面,token usage 會回報 reasoning_tokens,logprobs 喺 Responses 格式下亦會被轉成 InferenceOptions。不過要留意,圖片抓取組件 ReqwestImageFetcher 預設連任何地址都得,如果服務面向不可信來源,記得裝返 DestinationFilter。
GitHub

Categories: 開源, Agentic, 模型, NVIDIA, DeepSeek, API, Image, 框架, 工具, Ollama, Python, 庫, Tokenize

DeepInfer 開放 DeepSeek 離線推理核心

DeepInfer 把 DeepSeek 大規模服務的離線推理核心開源,涵蓋高效 kernels、並行排程與解碼加速,但未包括完整線上服務組件。

Prefill: non-cached input throughput vs. latency

對需要自行建立高效模型服務的團隊,DeepInfer 提供了一條更接近 DeepSeek 生產環境的技術路徑。這個框架負責離線推理,處理模型執行、批次排程與輸出生成;KV cache 系統、Prefill/Decode 分离及跨資料平行副本負載平衡則須另行整合。

  • 支援 DeepSeek-V4.1-Flash,涵蓋模型與 sampler runtime、FlashMLA、DeepGEMM、DeepEP 等最佳化 kernels。
  • 以 DSpark draft tokens 配合信心度排程驗證,減少解碼階段等待;預設最大 draft 長度為 5。
  • 支援 MoE EP、EPLB、Attention DP、balanced CP,以及 CPU 與裝置執行重疊的非同步批次排程。
  • 提供 SWA bounded replay、structured outputs、batch-invariant inference 與 deterministic sampling,方便控制成本和重現結果。

它與一般模型框架的分別,不在新增模型能力,而在於把 DeepSeek 線上服務累積的低延遲機制整理成可編譯的推理框架,代價是硬件與整合門檻較高。環境要求包括 Linux、Python 3.12、GCC 13 或以上;NVIDIA 路線使用 CUDA 13 及 SM100 GPU,另有 Huawei Ascend 950 NPU 版本,部分功能只支援 NVIDIA。

對吞吐量、推理成本和結果一致性敏感的 AI 平台團隊,DeepInfer 的價值較明顯。它提供 batch-invariant inference、regex、JSON schema 與 EBNF grammar 約束,但官方未提供吞吐量或延遲數據;公開內容亦未涵蓋完整部署指南與線上服務元件,較適合具備 GPU、NPU 及分散式系統經驗的團隊從源碼整合。

GitHub

Categories: 開源, 華為, 模型, NVIDIA, DeepSeek, 框架, 線上服務, Linux, Python

CoPE 讓 Agent 逐步預測行動,節省一半訓練樣本

CoPE 以多步行動預測補強 Agentic RL,在不增加推論成本下,提升語言智能體的學習效率。

CoPE

長軌跡只靠完結時一次獎勵學習,往往會令多數步驟欠缺直接回饋。CoPE 是建基於 AgentGym-RL 及 verl 分支的強化學習框架,透過逐步預測智能體接下來會採取的 K 個行動,為每個決策位置加入更細緻的訓練訊號。

模型骨幹同時負責 acting 與 forecasting:智能體按既有 policy 行動,並在每一步預測未來行動;完成 rollout 後,真實行動序列會監督預測結果,再把學習成果蒸餾回同一個 policy。關閉相關功能後,訓練路徑便維持標準 Group Relative Policy Optimization(GRPO),方便按研究需要比較。

  • 每一步預測 K 個後續行動,補充終結獎勵欠缺的分步監督。
  • acting 與 forecasting 共用一個模型,不需額外模型或預訓練階段。
  • 推理時仍逐步行動,不加入額外運算開支。
  • 支援 SciWorld、ALFWorld、WebShop、AppWorld 及 τ²-bench 五個互動環境。

結果顯示,CoPE 在上述環境擊敗 GRPO 與 predictive-auxiliary baselines;樣本效率最高提高 2 倍,其中 ScienceWorld 為 2.0 倍、AppWorld 為 1.6 倍。任務成功率相對 GRPO 在 ALFWorld、WebShop 與 ScienceWorld 分別增加 5.0、12.5 及 8.0 個百分點。

配置需要 Python 3.10 訓練環境及獨立環境服務;WebShop 使用 Python 3.8,τ²-bench 需要 Python 3.12 或以上,並須取得 AgentGym submodule。這套架構適合研究互動式語言智能體、計算成本受控的團隊,以及比較 action forecasting 與稀疏獎勵訓練方法的開發者,但多環境配置與 GPU 需求增加了安裝門檻。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 框架, Python, Meta, 強化學習

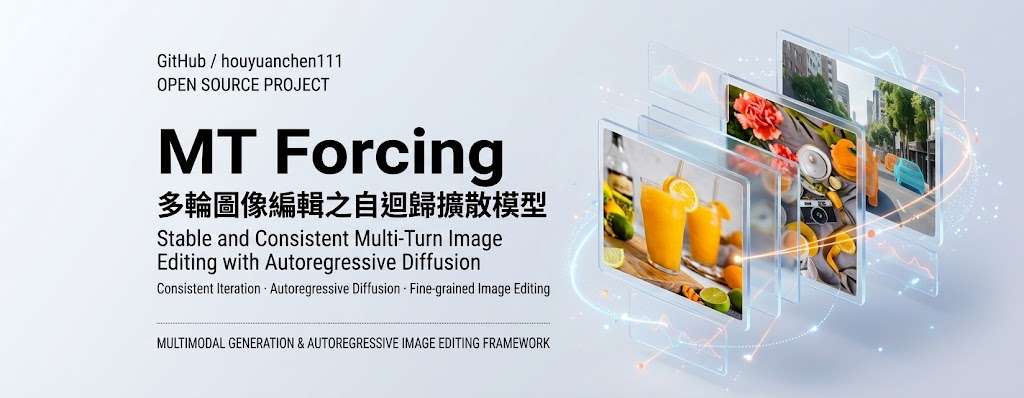
MT-Forcing:多輪改圖守住細節唔再走樣

連續改同一張圖時,主體、紋理與構圖往往會慢慢偏離;MT Forcing 以多輪訓練與教師引導改善這類累積錯誤。

MT Forcing teaser

連續要求「改杯色、加條紋、再調光線」時,圖片往往未到最後一輪已經失真。MT Forcing 是針對多輪圖像編輯的訓練框架,配合自迴歸擴散模型,減少每輪修改帶來的漂移。

方法把單輪 DMD(Distribution Matching Distillation)與 Teacher-Forcing Guidance 結合:學生模型逐步編輯自己生成的歷史,凍結的單輪教師則從原圖一次套用累積指示,提供分布層面的引導。參考真實編輯軌跡後,模型既要改善畫質,也要維持跨輪次內容關係。

  • 以自身多輪輸出作為訓練歷史
  • 引入單輪 DMD 改善視覺品質
  • 用 Teacher-Forcing Guidance 減少誤差累積
  • 展示最長十五輪及八輪編輯比較

官方程式碼要求 Python 3.11.13、NVIDIA CUDA GPU,以及指定 checkpoint、架構資源和擴充 U1.5 tokenizer;配置完成後,可在同一工作階段依序執行多個編輯提示。公開資料未交代完整硬件門檻、推理速度或標準化定量結果,因此較適合作為需要 NVIDIA GPU 的研究重現工具,而非直接比較成本已知的消費級服務。

它以 SenseNova-U1.5 作為相關基礎模型,並在多輪比較中加入 MT Forcing。對需要逐步修訂產品 concept、人物姿勢或場景細節的設計團隊,單輪教師可作品質參照。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 清華大學, 模型, 模型訓練, NVIDIA, Image, 影像模型, 框架, 工具, Python, Tokenize

Scene-Designer:智能 3D 場景生成與設計

Scene-Designer 把場景生成、質素評估與反覆修正放進同一套 Agent 訓練流程,減少無效改動。

Scene-Designer bear logo

3D 場景生成最難的地方,往往不是砌出物件,而是知道場景是否合理,以及修正錯誤時避免愈改愈亂。Scene-Designer 是一個面向 Agentic 3D Scene Generation 的研究框架,目標正是讓模型學習設計場景、評審質素,再按評語作有效修正。

  • 以 Scene-OTA-35K 的 Observation–Thought–Action 軌跡學習設計與修改流程。
  • 透過 Scene-OTC-15K 的 Observation–Thought–Critic 經驗,比較場景質素。
  • 用 Branch-ranking reward 比較同一父場景產生的分支。
  • 以 Improvement reward 判斷子場景是否真正優於原場景。

Causal Trajectory Consolidation 會移除沒有下游貢獻的無效操作,同時保留有效決定及必要中間狀態。Scene perturbations 則刻意加入佈局偏差、功能退化和物理違規,再建立偏好比較,令模型不只是 spotting 錯誤,而是學習指出哪個場景較好。

Scene-GRPO 結合分支排名與改進獎勵,讓代理在相同起點的候選場景中選擇較佳設計,並減少沒有帶來實際進步的反覆修改。這種做法比只追求最終生成結果的訓練多了一層質素判斷,亦直接回應通用模型「識錯但不懂有效修正」的問題。

研究團隊比較了模型與 GPT-5.2 在成對場景比較及四場景偏好排序上的表現;首頁亦提供十組 prompt-to-scene 示範。不過,公開資料未交代完整安裝流程,Hugging Face 上已列出 Scene-Builder-Qwen3-VL-8B-Instruct 模型與 Scene-OTC-Bench 資料集,較適合具 3D 生成、Agent 訓練及模型評估經驗的團隊先行研究。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, OpenAI, 影像模型, World-Action Model, 框架, 3D, Dataset 數據集

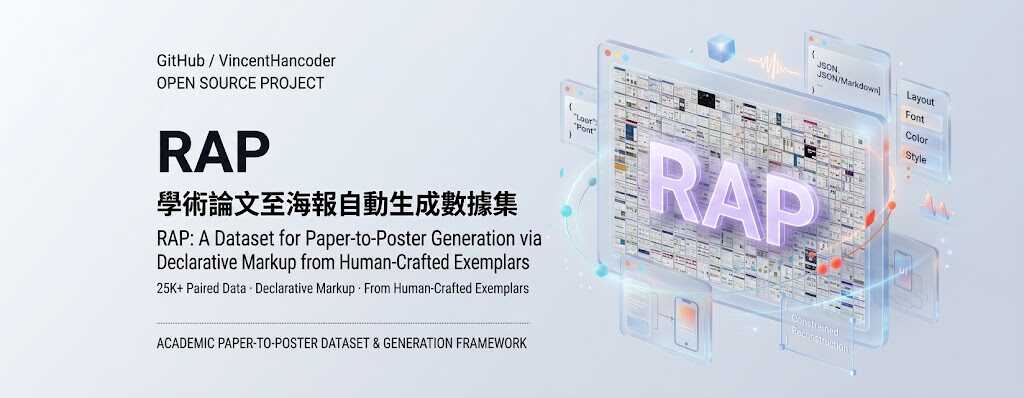
RAP-25K 用 AI 把論文自動排版成為海報

清華、港大、美團等團隊把 25,435 對 NeurIPS、ICLR、ICML 論文與海報反解為可填空嘅 HTML 模板,等 AI 唔再從零設計版面,而係取用人類做過嘅版型再改內容。

做會議海報本質係一次迷你視覺代碼:一篇論文要做成 Poster,要同時處理摘要、視覺排版同程式實現。RAP 將呢件事變成可量度嘅任務,開放俾模型訓練同評測。

佢屬於一個資料集加框架嘅組合:核心係 PosterReverse-25K,由 NeurIPS、ICLR、ICML(2022–2026)合共 25,435 套論文同海報組成,每份海報會被自動 pipeline 反解成帶類型、可填空嘅 HTML/CSS,連摘要同三層分類(領域/任務/方法)都一齊整理好。配套仲有一份 RAP-150 測試集,每個領域留 10 篇俾公平比較。

同類做法多數只標註版面框或者小量樣本,要靠 VLM 或人手評分。RAP 嘅差別係每個樣本都可以渲染同原海報直接對比,做到客觀驗證,唔再靠主觀評審。佢提供兩條路線:PosterRAG 係免訓練嘅多智能體流程,會先檢索真實模板再填入新內容;另一條就用同一批 triplet 對 Qwen3.8-27B 做全參數 SFT 加 GRPO 訓練。

對研究人員同會議籌備團隊最直接:寫完一篇論文想快速整海報,可以利用檢索模板避開從零排版;做視覺代碼、版面生成或 VLM 訓練嘅團隊,都能直接用呢批已驗證 triplet 做監督。項目提供 Hugging Face Space demo 同模型權重。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Dataset 數據集

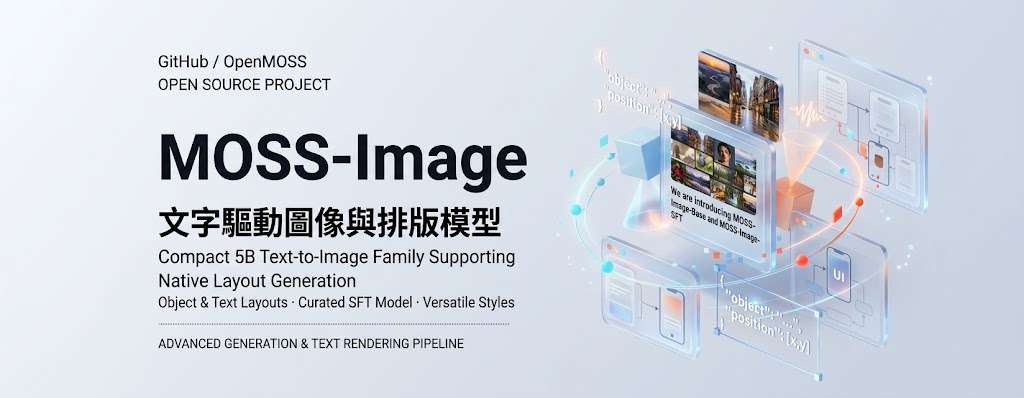
MOSS-Image 支援 JSON 排版的 5B 文字生圖模型

MOSS-Image 推出的 5B 參數文字生圖模型,能夠直接在 prompt 內用 JSON 描述物件位置、標籤與邊界框,毋須額外 ControlNet 也能控制版面。

MOSS-Image

用文字生圖最常遇到的卡位,是 prompt 寫得再精準,模型依然把主體放錯位置或把文字渲染得歪七扭八。OpenMOSS 開源的 MOSS-Image 把這個矛盾寫進模型架構本身:除了自然語言 prompt,它同時接受結構化 JSON 輸入,裏面可以逐個列出物件的標籤、描述與 yxyx 格式邊界框,由模型原生處理版面配置,毋須借助外掛 ControlNet 或額外 inpainting 步驟。

對於做海報、漫畫分鏡或產品 mockup 的人來說,這種介面比「再抽幾次卡」來得直接。生成結果可以直接根據 JSON 編輯調整單一物件的位置或文字內容,方便反覆迭代。模型骨幹約 5B 參數,支援長達 4K token 的 prompt,文字渲染能力亦比同類開源模型紮實,並同時覆蓋動漫與寫實風格。

New top local AI image generator is here!

現階段提供 Base 與 SFT(curated-data 微調)兩個版本,權重以 Apache-2.0 釋出,部署上已有 SGLang、vLLM-Omni 與 ComfyUI 的 day-0 支援,配合 Python 及 Gradio 共用的 Diffusers pipeline,本地或雲端皆可即時跑起 demo。

重點摘要:

  • 原生版面控制:JSON prompt 直接描述物件、位置與邊界框,毋須外掛 ControlNet。
  • 5B 緊湊骨幹:兼顧生成效率與微調彈性,prompt 可長達 4K token。
  • 雙版本開源:Base 與 SFT 權重皆公開,Apache-2.0 授權。
  • 多元框架支援:SGLang、vLLM-Omni、ComfyUI 同日適配,並提供 Hugging Face Spaces 線上 demo。
  • 風格覆蓋廣:動漫與寫實風格並重,文字渲染品質為主打賣點之一。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, NVIDIA, Image, 框架, Python, 蘋果

KTP(Knowledge-Transfer-Probing) 統一多模態模型做知識轉移考核

清華與 Z.AI 團隊提出 KTP 評測協議,專門測試統一多模態模型從圖像生成學到的新知識能否透過純文字問答取出,逐步補上視覺與語言之間的知識流動缺口。

knowledge transfer probing

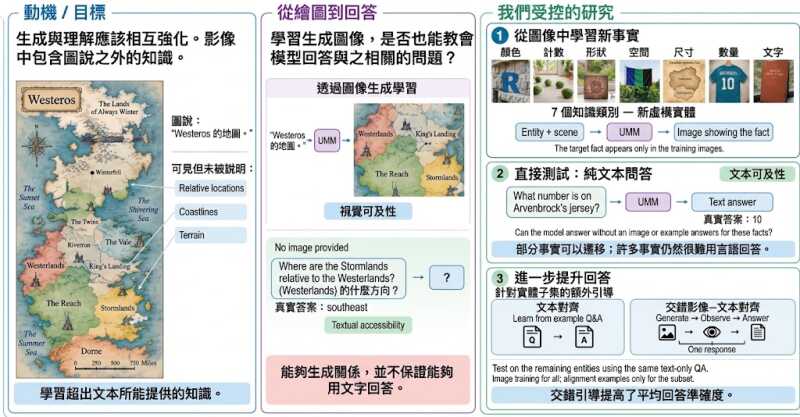
統一多模態模型(Unified Multimodal Models, UMMs)一邊做圖像生成、一邊做語言理解,但訓練時從圖像吸收的知識,一直難以量化究竟有多少真的能在純文字 QA 場景派上用場。Knowledge Transfer Probing(KTP)這個項目正正填補這個缺口:它設計了一套受控的評測協議,先以圖像生成訓練把新知識餵進模型,再以純文字問答檢驗模型能否取出。

團隊跨越七個知識類別(色彩、數量、形狀、相對空間、相對大小等),在三個 UMM 上觀察到一個關鍵現象:直接從視覺監督遷移到語言的知識,效果並不均勻,部分類別知識存取明顯偏弱。有趣的是,在部分實體上做 Textual Alignment 或 Interleaved Image-Text Alignment 對齊訓練後,模型在未對齊的其餘實體上同樣能改善知識存取,其中交錯式對齊的平均準確率比純文字對齊更高。

項目屬於研究型資料集與評測框架,隨倉庫釋出 KTP-Data(分為 train/ 與 eval/),訓練檔涵蓋文字生成圖像、文字對齊及交錯圖文對齊三類樣本,評估檔則提供文字可達性(QA 題目與參考答案)與視覺可達性(生成提示與屬性)。評分腳本只用 Python 標準庫,跑分結果會輸出 results.jsonl 與 summary.json,方便研究者直接替換自家模型回應做比較。

對正在訓練或微調 UMM 嘅團隊而言,KTP 提供一個可重現的基準去量度「圖像生成帶來多少純文字世界可用的知識」,同時指出交錯對齊是一條有實證支持的改進路徑。多模態模型研究者、訓練數據設計者,以及關心視覺-語言聯合表徵架構的人都會從中受益。

這個項目的限制同樣需要留意:KTP 目前只覆蓋七類視覺屬性,且只測試三個 UMM,並未涵蓋複雜語境或多輪推理,結論的普遍性仍有待擴充樣本驗證。

項目主頁 · GitHub

Categories: 開源, 清華大學, 模型, 多模態模型, 模型訓練, Image, 框架, Python, 庫, Dataset 數據集

OfficeTown 模擬真實職場流程

Office Intelligence 團隊把辦公室變成可執行的訓練場,讓 AI 代理用 Excel 等真實工具完成對帳、覆核等文書任務,再從中累積學習素材。

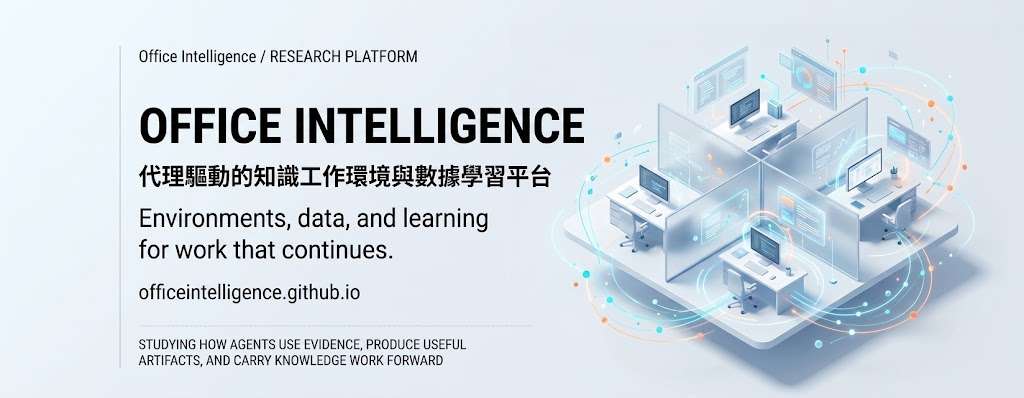
A cutaway office with research and analysis desks, a review meeting, and a shared-material cabinet. Four annotations explain roles, artifacts, review, and retained context.

文書工作不像回答一條 prompt 咁單純——開工前要先知道自己係邊個角色、手上有咩檔案、工具開咗未,做完仲要有人覆核。Office Intelligence 就係圍繞呢種「連續作業」嘅場景,幫知識工作代理(knowledge-work agents)搭建貼近真實嘅練習環境。

團隊將呢套框架劃分為四個部分:OfficeTown 提供可執行嘅工作環境,包括角色、權限與開機狀態;DocAtlas 處理文件層面嘅證據與脈絡;XL-DocBench 負責評估交付成果嘅品質;harness 則串接工具介面與審批流程。任務設計以「請求→證據→交付→覆核→下一個任務」嘅循環為核心,每次執行嘅過程都會留底,成為下一輪學習嘅素材。

以一個金融對帳任務為例,代理需要用 Excel 整理三條例外紀錄,喺交付嘅工作底稿中交代差異同處理建議,並標出尚缺嘅證據。呢類任務唔係計較答得幾快,而係睇交付物能否交到下一個人手上覆核。

呢個框架比較適合關注代理長流程作業、文件自動化同企業流程自動化嘅開發者同研究團隊。辦公室場景比純 prompt 模擬更貼近部署環境,對建立可審核、可追溯嘅 AI 工作助手有直接參考價值。OfficeTown 嘅公開版本仍在籌備中,有興趣嘅讀者可留意官方網站嘅後續更新。

項目主頁

Categories: Agentic, 模型訓練, 框架, 工具, 動畫

into-the-unknown:探索未知:AI 智能體能自主撰寫科學論文嗎?

把 15 個領域科學家親自為自己論文提出的延伸方向交給 AI Agent,要求 Agent 真的把研究做出來並寫成後續論文。

A path climbs a mountain under the night sky to an open door full of stars

與其請 AI 寫摘要、改改 bug,「Into the Unknown」要求 Agent 從零完成一段小型研究:閱讀一篇科學家寫的論文,再依據科學家親自提出的延伸方向,跑實驗、收集結果,最後交出一篇誠實且完整的後續論文。15 道題目橫跨不同學科,每一道都來自真正做研究的人對自己工作的下一步構想,而不是從公開資料庫拼湊出來的人工題。

針對想做比較的人,配套已經齊備:Hugging Face 上釋出資料集與 Agent 完整軌跡、檔案系統與產出論文,網站設有排行榜,歡迎提交新 Agent 的論文。Agent 端支援 Claude Agent SDK(opus-4.8、opus-5、opus-5.5、fable-5)、OpenAI Codex 系列(sol-5.6、astra-6),以及以 OpenHands 為底層的 glm-5.3。

想自建評測流程,只要 git clone 儲存庫、執行 prepare_tasks.py 把指定題目的程式碼與資料下載到 tasks/paper{1..15}/,再安裝對應 Agent 框架即可逐題評估。這樣做的好處是可以重現 Agent 的執行路徑與檔案系統,後續審視其論文是否真實反映實驗結果。

與一般 benchmark 不同,它考核的不只是答對或答錯,而是 Agent 面對開放、未定義的研究問題時,能否維持學術誠信並產出符合領域標準的成果。這對做 AI for Science、Agent 評測,以及想了解 Agent 在長程科學任務上瓶頸的團隊特別有參考價值。

項目主頁 · GitHub

Categories: 開源, Agentic, OpenAI, API, 框架, Clone, 庫, Anthropic, Dataset 數據集

Page 4 of 34
1 2 3 4 5 6 … 34