DeepSeek Harness 把多 Agent 協作變成可控工作台

[教學影片]DeepSeek Harness 讓 DeepSeek dsh 變成可啟動 Web UI 的開發者工作台,重點放在多個 Agent 並行處理、動態工作流同插件擴展。它適合要在複雜程式碼庫入手審計、協作同加速探索嘅使用場景。

Og image

DeepSeek Harness 把 DeepSeek dsh 做成一個可啟動 Web UI 的開發者工作台,處理的是複雜程式碼庫入面要同時分工、同步同收斂結果的問題。影片實測重點放喺並行只讀審計、動態派生 SubAgent,同埋最後將多路輸出整合返去。

它同一般單一路徑的助理做法不同之處,在於可以按工作內容拆成多個 Agent Teams,再根據任務需要即時調整流程。這種安排適合審查、分析同探索型工作,因為不同子任務可以同時展開,唔使一條線慢慢行。

片中亦提到插件開發門檻較低,代表它不只係拿來跑預設流程,仲可以按團隊習慣加功能。對要處理既有代碼、要快速驗證想法,或者想將 AI 工具接入日常開發流程的人,這種擴展性會更實用。

重點摘要:
– 以 Web UI 包裝 DeepSeek dsh,方便直接操作
– 支援多個 Agent 並行工作,減少單線等待
– 可動態派生 SubAgent,按任務拆分工作
– 插件擴展門檻較低,方便接入自訂流程
– 適合複雜程式碼庫審計、協作同探索任務

項目主頁

Categories: 開源, Agentic, DeepSeek, 教學, 編程, 安全, UI/UX

VoxEMW:把 Mac 變成 1.3 秒回應的私人語音助手

VoxEMW 將語音處理放在 Apple Silicon Mac,手機只需透過瀏覽器或 iOS 客戶端對話,回應速度與音色克隆是最大賣點。

Repository image for emwstudio/VoxEMW

對住手機講完一句話,約 1.3 秒後便聽到固定角色用克隆聲線回答,VoxEMW 屬於開源語音助手項目,處理判停、轉寫、對話調度及語音合成,解決語音對話延遲高、角色聲線難以保持的問題。Mac 負責主要語音管線,只有 LLM 大腦經 DeepSeek API 上雲,日常成本相對可控。

整套流程由 Silero 加 SmartTurn 負責判斷何時真正講完,Qwen3-ASR-0.6B-hf 在 MPS 上轉寫,再由 DeepSeek v4-flash 產生回覆,Qwen3-TTS-1.7B-Base 以 MLX 6bit 執行零樣本音色克隆。參考聲音配合逐字台詞便可註冊角色,首段聲音約 0.5 秒生成;中途打斷時,已播放及已聽內容會寫回上下文,對話較不容易斷層。

一块 4090 跑通 AI 视频通话全栈:Qwen3.8-27B 本地部署,对话时延 2 秒

項目需要 Apple Silicon Mac 作本地伺服器,實測以 M5、16GB 記憶體可以流暢運行,模型及環境約需下載 4GB。瀏覽器可直接連接本機介面;iPhone 或 iPad 則要透過局域網 HTTPS/WSS 連線,並自行處理 TLS 證書、Xcode 簽署及免費帳戶七日側載限制。

• 回應最快 1.26 秒,中位數約 1.6 秒,實際速度仍受網絡及 API 影響
• VAD、STT、TTS 留在本機,DeepSeek API 按 token 收費
• 支援流式字幕、空回覆重試及語音中斷後續接
• 全屏星空會隨說話及聲波變化,增加角色互動感

相比全程雲端方案,VoxEMW 減少語音資料離開家中 Mac,但需要一部 Apple Silicon Mac 長期運行;相比完全離線方案,DeepSeek API 帶來額外費用及資料傳輸考慮。適合想建立固定聲線角色、研究低延遲語音管線,或有 Mac 作家庭伺服器的開發者,普通使用者則要先接受證書、模型環境及 API 金鑰設定等門檻。

GitHub

Categories: 開源, 文字轉語音, Qwen, DeepSeek, API, 框架, Mac, 語音, 蘋果

DeepSeek API 加入圖片理解,支援截圖與圖表分析

DeepSeek-v4-flash-vision-exp 可把圖片與文字放在同一個請求,處理截圖、圖片描述及圖表分析。

Og image

處理產品截圖、掃描文件或圖表時,DeepSeek API 現在可讓文字問題與圖片一併送出,由 deepseek-v4-flash-vision-exp 回應內容。這個視覺模型適合用於圖片描述、讀取截圖文字,以及分析圖表等需要結合視覺與語言的工作流。

API 採用 OpenAI-compatible Chat Completions 格式,請求中的 content 不再只是單一字串,而是由文字和圖片區塊組成;Responses API 亦支援以 input_image content parts 傳送圖片。開發者可按項目需要選擇圖片提交方式,文件列出三種方法,其中包括直接內嵌 Base64 圖片,以及提供公開可存取的 http(s) 圖片網址。

支援的圖片格式包括 JPEG、PNG、GIF 和 WebP。系統會按檔案實際內容判斷格式,而不是依賴檔名或宣告的 MIME type;使用 Base64 內嵌本地圖片較直接,但編碼後的資料會計入 48 MiB request body 上限。

  • 可同時分析文字與圖片
  • 適合讀取截圖文字及分析圖表
  • 支援 JPEG、PNG、GIF 和 WebP
  • 兼容 Chat Completions 與 Responses API
  • Base64 圖片會受 48 MiB 請求大小限制

需要把圖片理解接入現有 OpenAI SDK 或 API 工作流的開發者,可沿用熟悉的請求結構,再按圖片來源選擇內嵌資料或公開網址。圖片網址必須可供模型下載,並受 8192 字元長度限制。

項目主頁

Categories: Agentic, DeepSeek, API, Image

Agent Lightning v1.0:把代理訓練接回真實工具流

Agent Lightning v1.0 讓代理在保留工具、上下文和環境的情況下直接訓練。它也把 Kubernetes、程式編寫和獎勵防作弊流程一併整合起來。

logo

Agent Lightning v1.0 針對一個常見卡位:代理訓練往往要靠額外沙箱或改寫流程,令工具、控制流和環境脫節。這個項目把訓練直接接回真實 agent harness,代理可以經由 Agent Lightning v1.0 proxy 運作,而不用改動原本架構。

它的設計取向相當清晰,核心程式碼大約 3,500 行,重寫後把複雜度壓低。代理亦可直接作為 Kubernetes Jobs 執行,不必依賴外部 sandbox 服務,對要跑長時間 rollout 或分散式訓練的團隊會方便很多。

文檔同時提供完整的 coding-agent 訓練流程,涵蓋資料清理、reward-hacking 防護和訓練腳本。這代表它不只停留在概念層面,而是把一條可落地的訓練管線交到使用者手上。

  • 保留工具、上下文、控制流和環境在訓練迴圈內
  • 透過 proxy 接入現有 agents,減少改動成本
  • 原生支援 Kubernetes Jobs,部署更直接
  • 提供 coding agent 範例,連資料清理和防作弊流程都包進去
  • 適合做具互動工具、程式執行或多步推理的 agent 訓練

項目主頁

Categories: 開源, Agentic, 模型訓練, 微軟, DeepSeek, API, Vibe Coding, Python, 編程

DeepSeek Harness 把 Agent 變成插件

DeepSeek Harness 想解決的唔係單一 Agent 功能,而係點樣把模型、工具同工作流拆開重組。對想長期調整 Agent 流程的團隊,呢個方向比單次 demo 更有參考價值。

Repository image for deepseek-ai/deepseek-harness

DeepSeek Harness 把 dsh 做成一個面向開發者的 Agent harness,重點不在於再包一層聊天介面,而是把模型、工具、技能、會話、沙箱、存儲、循環、調度同 UI 全部拆成插件,讓團隊用配置去換件、重組,同時保留可追蹤的執行過程。它處理的是 Agent 進入真實工作流後,經常要改工具鏈、換模式、查執行軌跡的維護問題。

你可以直接用 npx @deepseek-ai/dsh web 啟動 Web UI,也可以從原始碼安裝;兩種方式都指向同一件事:DeepSeek 並非只想交付一個可試玩的介面,而是提供一個可延伸的開發底座。現階段它仍屬 developer preview,兼容性破壞會持續出現,較適合願意跟住 API 與插件生態一齊迭代的團隊。
跟不少把能力寫死在框架內的做法相比,DeepSeek Harness 把 Cordis 放在核心位置,內核只負責插件載入、卸載與依賴關係,Agent 能力則交由插件之間透過服務與事件協作。好處是替換模型、工具或 preset 時毋須大改源碼;代價是系統理解成本較高,穩定性亦未到可安心鎖版的階段。

它提供標準模式、PTC 模式、極簡模式同創造模式,反映出同一套底層同時照顧編碼 Agent、基準測試同自訂 preset。當中較值得留意的是 Trajectory 視圖與僅追加式會話日誌,系統會記錄提示詞、工具調用、結果、子 Agent 調度與上下文注入,對除錯、回放、分叉同檢索都幾有用,但官方未提供明確基準分數,現時較難直接用量化結果同其他 Agent 框架比較。

  • 用 Cordis 作核心,將 Agent 各層能力拆成可替換插件
  • 可經 Web UI 快速測試,亦可由原始碼部署到自訂環境
  • Trajectory 與事件流日誌有助追查每一步決策與工具操作
  • developer preview 階段變動頻密,較適合開發者與研究型團隊
  • 重點價值在可組合工作流,而唔係單一模型能力展示

項目主頁 · GitHub

Categories: 開源, Agentic, DeepSeek, API, 工具, Skill 技能, UI/UX

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

Reasonix:DeepSeek AI 編碼 agent,用 cache-first 降低長會話嘅 token 成本

Reasonix 係 DeepSeek 嘅終端 AI coding agent,以 cache-first loop 壓低長會話嘅 token 成本,適合反覆改碼、工具呼叫同團隊迭代。支援 CLI/TUI、桌面、Web UI 同 ACP 編輯器整合,配合 /plan、MCP 同 sandbox 權限控制。

Reasonix

Reasonix 是 DeepSeek 一個面向桌面及終端的 AI coding agent,核心價值唔係花巧介面,而係將長會話裡不斷累積的上下文成本壓低。它適合要一路改檔、一路試工具、一路追問模型的人,特別是團隊日常做修補、重構同埋持續迭代時,對 token 成本同回合延遲都會有明顯感受。

Reasonix 主打 cache-first loop,令 prompt 前綴保持 byte-identical,配合 DeepSeek 的 prefix cache 去提升長會話命中率。項目同時提供 CLI/TUI、桌面端、local browser UI,同埋支援 ACP-compatible editor integration,部署方式亦算直接:CLI 可用 npm 安裝,桌面版則有 macOS、Windows、Linux 套件可選。

Deepseek's ~OFFICIAL Code: RIP Claude,Codex! This is CRAZY GOOD!

Reasonix 唔係純粹包住模型嘅殼,而係圍繞工具呼叫修正、成本控制同 sandbox 權限去設計。/plan 會先要求模型規劃,再進入實作;MCP(Model Context Protocol, MCP)亦作為一等入口,方便把外部工具合入同一個 registry。這種做法較適合重視可控性、可追蹤性,亦需要長時間跑 session 的開發流程。

要留意嘅係,呢條 TypeScript 線已經進入 maintenance mode,主力開發搬去 Go rewrite,同步文件亦指向 main-v2 同 migration guide。現時更合理嘅理解方式,係將佢視為一個仍可用但已凍結方向的終端編碼 agent 版本,重點價值在 cache 效率、工具整合與成本壓縮,而唔係追求最新功能擴張。

  • 長會話下,prefix cache 命中率可維持在 90%+,輸入 token 成本可明顯下降
  • 同一套引擎可喺 CLI/TUI、桌面端、Web UI 同編輯器接入使用
  • /plan、權限控制同 workspace sandbox 一齊限制工具呼叫,取向偏向可控
  • 適合經常改碼、反覆驗證、又在意推理成本嘅個人或團隊

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, DeepSeek, Vibe Coding, Mac, Linux, 編程

DeepSeek-V4-Flash-0731:輕量化 Agent 模型追上大模型

想要較少啟動參數,又保留強 Agent 表現,DeepSeek-V4-Flash-0731 就係呢類取向。它把重點放在工具調用、編碼同自動化任務,速度與能力之間取得幾實際的平衡。

Og image

要兼顧回應速度、部署成本同 Agentic 能力,DeepSeek-V4-Flash-0731 走的是「較少啟動參數換取高效任務表現」的路線。頁面已清楚寫明它與 DeepSeek-V4-Flash-DSpark 採用相同模型結構,並且附帶 speculative decoding module,所以它不只是一般聊天模型,而是明顯朝工具使用、自動化操作與程式任務優化的版本。

它屬於 DeepSeek-V4-Flash 官方正式發布版,取代 preview 版本,並強調 agentic capabilities 有明顯提升。模型卡同時指出它的模型結構與 DeepSeek-V4-Flash-DSpark 一致,代表推理流程很可能圍繞主模型加速草稿模組來設計。

效能數字是最值得留意的部分。它在 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon-Verified、Agents’ Last Exam、AutomationBench Public 等基準上,普遍明顯高於 DeepSeek-V4-Flash(Preview),部分項目亦超過 DeepSeek-V4-Pro(Preview)。這種進步集中在 terminal 操作、程式庫理解、資安演練、軟件修復同工具鏈任務,反映它更像為 Computer-use agents、程式代理與自動化流程而調整,而不只是追求一般問答分數。

  • 與 DeepSeek-V4-Flash-DSpark 同結構,並附帶 speculative decoding module
  • 官方正式版取代 preview,重點提升 agentic capabilities
  • 多個 Agent/編碼基準明顯優於 DeepSeek-V4-Flash(Preview)
  • 啟動參數較少,但表現可與部分強勢閉源模型接近

部署資訊方面,內容只提供一則討論帖,提到可用兩台 DGX Spark 配合 ghcr.io/bjk110/vllm-spark:unholy-fusion-prod-ready 作最少設定部署;但模型頁面片段未列出上下文長度、GGUF 格式量化檔、mmproj、檔案大小、chat template 注意事項或 v2 檔名變更,因此不能推斷 llama.cpp、Ollama、LM Studio 的支援細節,也不能提供 Q4_K_M 一類量化建議。現有資料較適合把它理解成一個偏向高效率 Agent 任務的 DeepSeek 模型發布,而不是本地 GGUF 部署導向的模型。

模型

Categories: 開源, Agentic, 模型, DeepSeek, LLaMa, Ollama

DeepSeek-V4-Flash 公測版重點更新

DeepSeek 把 V4-Flash 推上正式版 API 公測,焦點唔止係模型名稱更新,而係 Agent 工作流明顯變得更能打。對寫碼、自動化同工具調用有需求的人,呢次變更值得留意。

Og image

想用同一個 API 入口處理寫碼、自動化操作同工具調用,2026-07-31 呢次更新最值得留意。DeepSeek-V4-Flash 正式版已經開放 API 公測,調用方式維持不變,只要把模型名稱設為 deepseek-v4-flash,就可以切換到最新版本,對現有接入項目來講改動相對少。

今次更新的重點唔係介面改版,而係 Agent 能力明顯加強。官方列出的 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon verified 同 Automation Bench (Public) 等基準分數,都指向同一件事:V4-Flash 針對 Coding Agent、終端操作、工具使用同全棧開發場景做咗強化,而且公開測試成績已經高過 V4-Pro-Preview。

技術上,DeepSeek-V4-Flash-0731 的模型結構、尺寸都同 DeepSeek-V4-Flash-Preview 一致,更新集中在後訓練,意味住提升主要來自調整模型行為,而唔係換咗一個更大架構。它同時原生支援 Responses API 格式,亦有針對 Codex 做適配,對已經圍繞 API 建立 Agent 工作流的團隊會更易接入。

幾個重點可以直接整理如下:
– deepseek-v4-flash 已可直接使用正式版 API 公測
– API 調用方式不變,現有項目遷移成本較低
– Agent 能力是今次更新核心,涵蓋 coding、terminal 同 tool use
– Responses API 已原生支援,並針對 Codex 做咗適配
– 今次只更新 V4-Flash API,DeepSeek-V4-Pro API 以及 APP/WEB 端模型未有改動

使用上亦要留意邊界。現有資料有提供模型名、相容格式同基準測試結果,但未見更完整的安裝步驟、下載方式或者端到端接入流程;另外,官方亦講明今次並未更新 DeepSeek-V4-Pro API。對想盡快把 Agent 能力接入現有產品的人,V4-Flash 呢次公測比較像一次低改動、偏向工作流升級的更新。

項目主頁

Categories: Agentic, 模型, DeepSeek, API, Vibe Coding, 工具, 編程

Galahad:12B 凍結模型零解碼作答的工業經驗

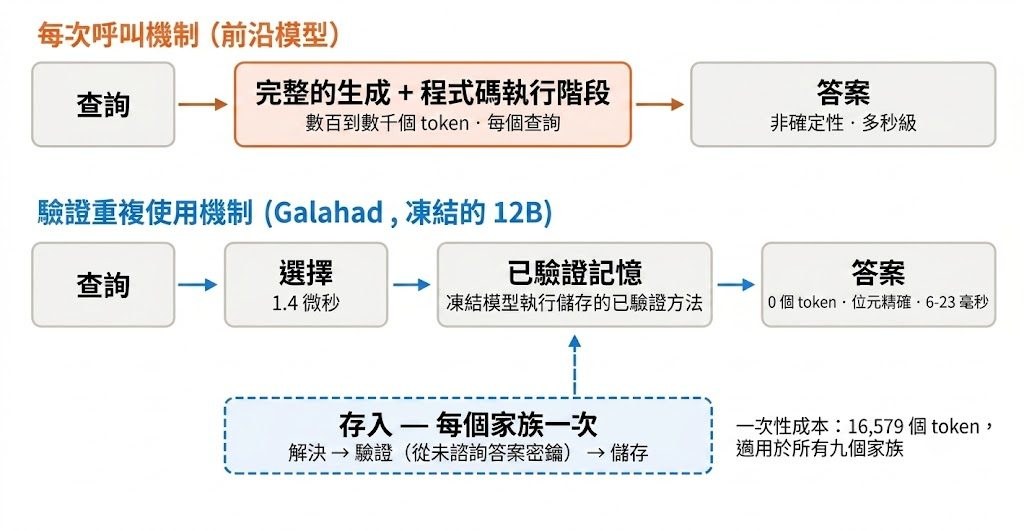
你可以把它理解成:模型不重新推理,而是直接重用已驗證過的求解結果,每次都一模一樣,而且不耗 GPU。

Repository image for corbenicai/galahad-bench

這套 Galahad 系統背後的關注點很直接:今天要提升語言模型,就要重訓練,每次都得重新生成答案,既貴又隨機。他們選擇反向操作——模型參數完全凍結,只在旁邊持續累積已驗證的解題記憶。同一個 12B 模型,對於已處理過的題目家族,直接命中記憶中的求解器,整數級精確一致,每次結果都完全相同,而且生成 token 數為零;對於新題目,則照常從零推理解答。系統聲稱在 180 個全新題目、橫跨九個題目家族上,讓四個來自不同供應商、架構各異的開源模型全部拿到 180/180,並且每次回答都不耗任何生成 token。

這個做法最值得留意的,是它對「記憶」一詞的重新定義。系統內部存的是可被獨立外部 oracle 自動驗證的執行式解題結果,不是用相似度檢索找出來的近似片段。作者在特別批評了業界慣用的近似向量相似度檢索:在一個 4,500 條已驗證答案的庫上,這種方法有 94.3% 機率選錯項目,而精確定址則零錯誤。換句話說,對於可驗證、可執行的知識,相似度近似檢索不是表現稍差,而是幾乎不可用,精確定位是必須的設計前提,不是可選偏好。

對於要部署閉環計算、形式化證明、程式碼執行這類可驗證任務的團隊,這套思路很有吸引力:記憶檢索耗時約 1.4 微秒,完整重用流程 6 至 23 毫秒,每次重用只耗 36 毫瓦時電力,相對於一次性求解兼驗證所需的 81.1 瓦時,節能差距明顯。模型本身不重新訓練,能力靠記憶累積,這對想控制運算開支、又需要可重現輸出的場景,例如 CI 中的程式生成或單元測試,是務實的取捨。

但限制也要看清楚:作者指出在公開基準的從零推理上,前沿模型依然遠勝任何 12B;Galahad 的強處是對「已被系統解決並驗證過」的題目家族做到零成本重用,不等於通用智能提升。負面控制也排除了另一種解釋——把記憶清空,系統一道也解不出來,這進一步確認能力確實來自記憶層,不是模型本身突然變聰明。對於想關注的是開源權重能否落地到工業管道的讀者,這份來自 Corbenic AI 的工業經驗報告值得留意,因為它把「訓練之外如何持續累積能力」這條路寫成了可量化的章節。

  • 模型凍結,能力改由外部已驗證記憶承擔,180 題零 token 滿分
  • 精確定址取代向量相似度檢索,在 4,500 條庫上錯誤率 94.3% 對 0%
  • 重用耗時 6–23 毫秒、每次 36 毫瓦時,對比一次性求解 81.1 瓦時
  • 開源模型架構無關:四個不同 dense 與 MoE 模型皆達 180/180
  • GitHub 目前僅放測試頁占位,引擎源碼尚未公開釋出

GitHub · Paper

Categories: 開源, Qwen, DeepSeek, Gemini, 框架, Dataset 數據集

Page 3 of 6
1 2 3 4 5 6