DeepSeek 為 Agent 和 RAG 補上即時資料來源

DeepSeek Search 與 Fetch API 將網頁搜尋與單頁抓取整合成兩個 API,為 Agent 和 RAG 應用補上即時資料來源。

Og image

當 Agent 或 RAG 應用需要查找最新網頁資料,單靠模型內置知識往往不夠。DeepSeek API 現已提供 Search 與 Fetch 兩個原始 JSON API,讓應用程式可以搜尋網頁,再按需要讀取指定頁面的內容。

Search API 由 DeepSeek 自研搜索引擎支援,會按 query 返回結構化結果,包括標題、網址及摘要;將 need_content 設為 true,則可一併取得網頁正文。Fetch API 則針對單一網址抓取內容,並以 Markdown 文本返回,方便後續交給模型處理。

搜尋條件可透過 site:、lang:、after:、before: 及精確短語等語法收窄範圍,也能排除指定網站或關鍵詞。count 可設定返回 1 至 50 筆結果,ori_question 則可補充使用者原始問題,協助系統理解搜尋意圖。

• 適合建立需要即時資料的 Agent 與 RAG 工作流
• Search 用於找資料,Fetch 用於讀取指定頁面
• 支援中文及多語言搜尋條件
• 兩個 API 均使用 Bearer API Key 鑑權
• 搜尋沒有匹配結果時會返回空陣列

兩個接口共用 https://api.deepseek.com Base URL,分別對應 /v1/tools/search 與 /v1/tools/fetch。開發者需要自行處理 API 呼叫、結果篩選及網頁內容交給模型前的整理,文件目前提供 cURL 和 Python requests 範例,適合直接接入現有資料問答流程。
項目主頁

Categories: Agentic, RAG, DeepSeek, API, 軟件, Python

OpenGCUA 讓電腦代理跨越 GUI 限制

OpenGCUA 把視覺操作、AX Tree、API 與指令整合,讓代理按任務選擇完成工作的方式。

OpenGCUA. Open the full stack of generalist computer use. GPT-6 made computer use the frontier. We make it open. Tested

當電腦代理不再只靠滑鼠點擊,處理複雜工作便可以同時讀取畫面、Accessibility Tree、應用程式 API 和命令列。OpenGCUA 是一個開源 Computer-use agents(CUAs)項目,建構 generalist computer-use agent(GCUA)完整堆疊,解決 GUI-only 代理在效率和操作彈性上的限制。

模型會按任務決定要觀察甚麼、採取哪種行動,以及如何整理上下文;除了 GUI 操作,也能呼叫 app API、執行 shell commands,並透過 code execution 把多個步驟組成帶有迴圈和條件的程式。OSWorld 整合範例提供 screenshot-action 和 code-action 路徑,macOS 14+ harness 則以選單列應用程式在本機裝置執行代理,仍屬 preliminary。

OpenGCUA 亦提供 Cross-Device SDK,嘗試用同一套 programming interface 連接電腦、瀏覽器和手機。這比固定規則的工作流更靈活,但也代表命令、API 和 GUI 權限需要更嚴格的隔離;項目目前仍在逐步開放模型、harness、SDK、trajectories、效率優化和評估工具。

OSWorld-v2 的 82 個 offline tasks 中,八個 frontier models 的平均 partial score 由 GUI-only execution 的 45.3 提升至 64.9,增加 19.6 分;每項任務平均步數減少 53%,六個模型的 output tokens 亦減少 27.2%。較弱模型獲益較大,例如 GLM-5.3-Flash 增加 35.2 分,DeepSeek-V4.1-Flash 增加 29.8 分。

  • 同時支援 GUI、AX Tree、CLI、API 和 code execution
  • 附有八個模型的 evaluation trajectories,包括 GPT-6 Astra、Claude Opus 5 和 Gemini 3.8 Flash
  • 可用 OSWorld 整合範例研究 screenshot-action 與 code-action
  • macOS harness 和 Cross-Device SDK 方便研究本機及跨裝置工作流

研究 Computer-use agents、需要分析代理行為,或希望把電腦、瀏覽器和手機操作納入同一工作流的團隊,會較容易從中受益。項目適合用作研究和實驗基礎,未宜直接視為成熟的日常自動化產品;本機執行、權限控制、模型相容性及仍在開發的模組,都會影響部署難度。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, DeepSeek, Gemini, API, 工具, Mac, 編程, Anthropic, Dataset 數據集

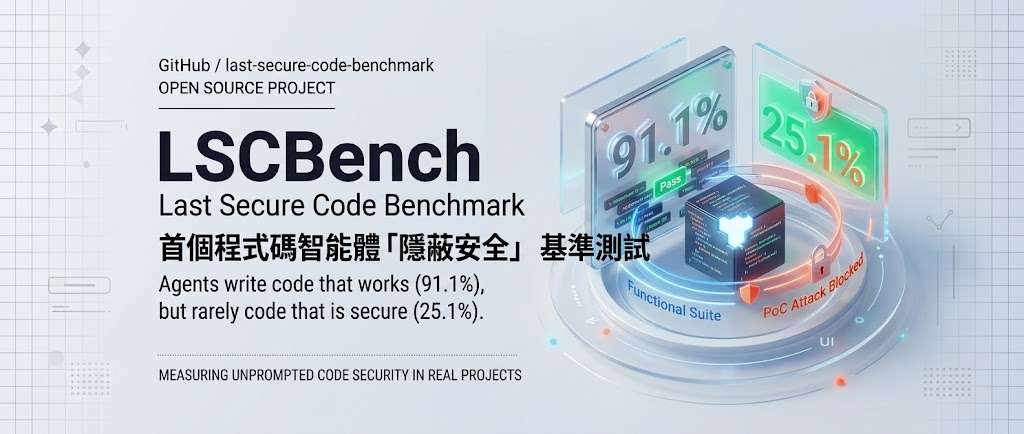
LSCBench 揭示 AI 編程代理安全盲點

LSCBench 以不提安全的真實漏洞重建任務測試編程代理,結果顯示能正常運作與同時安全的程式碼仍有明顯距離。

Qwen

當編程代理只收到功能規格、完全沒有被提醒要處理安全問題時,能否自行避開已知漏洞?Last Secure Code Benchmark(LSCBench)正是用來回答這個問題的開源基準測試項目:它從真實項目移除曾經包含漏洞的程式碼,再要求代理按規格重建,最後以功能測試及重現原有攻擊的安全測試共同評分。

LSCBench 共設 450 個任務,涵蓋 150 個漏洞情境,包括 115 個 Common Vulnerabilities and Exposures(CVE)案例及 35 個專家編寫的 Java 應用程式,支援 C、C++、Go、Java、JavaScript、PHP 和 Python。每個情境分成 function、file 及 repo 三種粒度,分別測試代理修補最小函式、相關檔案,以及較完整程式庫的能力。

六個模型在 450 個任務中大多能產生可運作程式碼,但同時通過功能和安全測試的比例最高只有 25.1%。Claude Fable 5 配合 Claude Code 取得最高 Func∧Sec 比例,GPT-5.6-Sol 的安全測試通過率則以 25.8% 稍高;Kimi-K3 雖然功能通過率達 91.3%,兩項測試同時通過的比例只有 16.4%,反映功能完成度與安全性並非同一件事。

  • 測試焦點:編程代理沒有收到安全提示,必須自行辨認風險。
  • 評分方式:功能測試確認程式可運作,安全測試重播原有攻擊。
  • 資料範圍:450 個任務、150 個漏洞情境、7 種程式語言。
  • 粒度差異:同一情境會在 function、file、repo 三個層次出現。

LSCBench 屬於面向 Computer-use agents(CUAs)及 coding agents 的安全基準測試,實際解決的是「生成的程式碼能否在沒有安全提示下仍然避免已知漏洞」這個評估缺口。對模型開發團隊、安全工程師及採用 AI 輔助編程的團隊而言,項目提供了比單看功能通過率更接近真實風險的檢查方式;不過,測試結果只涵蓋指定漏洞與攻擊重現流程,不能取代完整 code review、模糊測試及正式安全審計。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, OpenAI, DeepSeek, Python, 庫, 編程, 安全, Anthropic, Dataset 數據集, Kimi

Video-RSI:不改模型權重,讓影片代理自行進化

Video-RSI 透過改寫提示詞、工具、記憶與執行邏輯,提升影片理解代理的準確度及取樣效率。

Video-RSI framework: Solver execution, active video investigation, and cost-aware harness evolution.

影片理解代理遇到答錯問題時,未必需要重新訓練模型。Video-RSI 是一個開源框架,讓代理重新檢視影片,補充視覺、字幕及 OCR 證據,再把失敗原因轉化為可重用的程式修改;模型權重則保持不變。

項目由 Solver 和 Editor 配合:Solver 執行影片問答,Editor 調查失敗案例,並演化 prompts、tools、memory 及 execution logic。相比只調整模型參數,這種做法把改善集中在可執行 harness,較適合需要快速反覆修正工作流程的研究團隊。

  • 透過額外視覺、transcript 及 OCR 證據分析錯誤
  • 以 accuracy 和 visual-frame cost 共同篩選修訂版本
  • 提供 Initial harness、final harness、inference 及 evolution framework
  • 預設支援 DeepSeek-V4-Pro 和 Qwen3.6-Plus 等 OpenAI-compatible service 模型

評測會在私有 Gate set 以答案準確度及視覺影格處理成本配對選擇版本。項目資料所述結果指向更佳的 accuracy–efficiency trade-off:演化後 harness 在維持競爭力準確度的同時,處理較少影格,但未有公開具體分數或基準逐項差距。

要測試項目,需要 Linux、Python 3.12、兼容 API 服務,以及本地 RapidOCR 3.9.2 PP-OCRv6 small detection and recognition models;影片輸入採 JSONL,包含問題、選項、片長及絕對路徑,也可載入 faster-whisper large-v3 產生的 transcript。需要留意,允許 provider calls 會使用付費模型 API,因此成本控制和本地 OCR 準備是部署前的重要取捨。

項目主頁 · GitHub

Categories: 開源, 模型訓練, Qwen, DeepSeek, API, Video, 提示詞, 框架, 工具, Linux, Python

WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

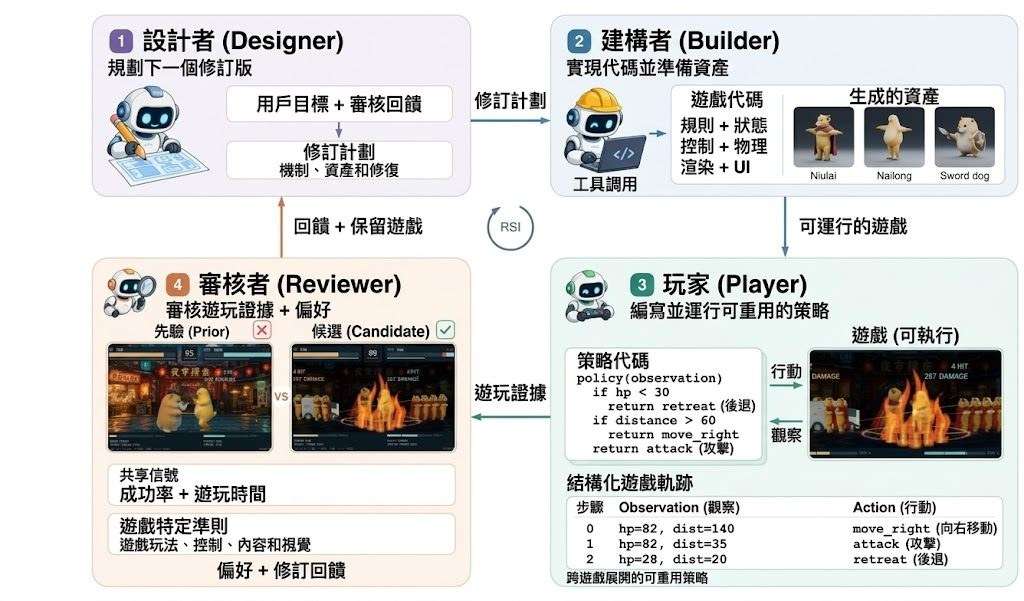
Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。

項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

CIA-minimal-repro:與思維鏈一致性改進模型訓練

CIA 將模型是否真正使用關鍵資訊,與 CoT 是否說出相關內容分開量度,再用 RS-B 和 DPO-A 改善兩者的一致性。

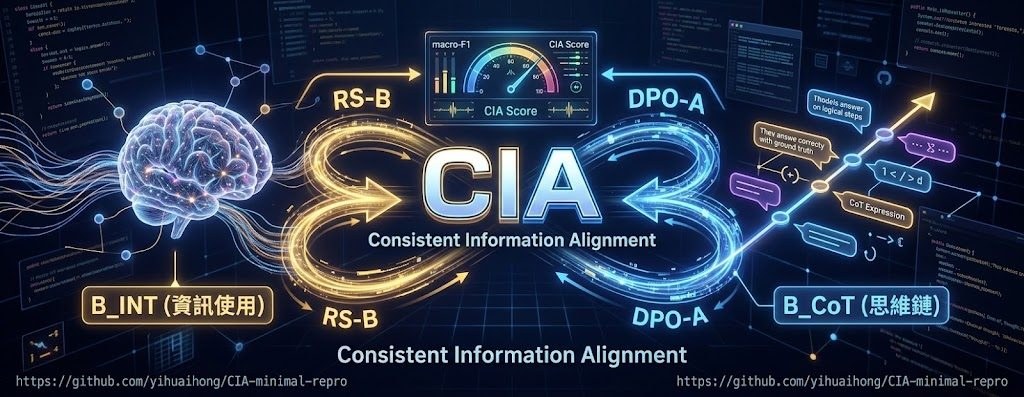
Repository image for yihuaihong/CIA-minimal-repro

當模型答對問題,卻未必真正用到提示中的關鍵資訊,CIA 以可驗證的方式拆開這個差異。這個 GitHub 項目屬於模型訓練及評估程式碼,處理模型內部資訊使用(B_INT)與 Chain of Thought(B_CoT)表述是否一致的問題,並以 macro-F1 定義 CIA 分數。

RS-B 和 DPO-A 使用同一批資料起步:基礎模型為每個提示取樣 16 個回答,再按內部使用資訊、CoT 表述及答案正確性標記。RS-B 保留 B_INT 與 B_CoT 一致的回答進行 SFT,即使答案未必正確;DPO-A 則按正確性加一致性排序,將每題排名最高及最低的回答配對作 DPO,取捨更偏向同時追求正確和忠實表述。

評估涵蓋 TwoHop、Hint 和 Mult 三項任務。TwoHop 以線性 probe 讀取隱藏狀態,Hint 使用 Qwen2.5-32B-Instruct 判斷 CoT 是否承認提示,Mult 則以 causal corruption test 檢查答案會否跟隨被修改的中間乘積;這些方法比單看最終答案更能暴露模型是否真正依賴關鍵步驟。

  • 可重現範圍:提供 RS-B、DPO-A、訓練流程及三項任務的評估入口。
  • 限制:儲存庫只有程式碼,不包含資料、模型權重、probe 權重或實驗結果。
  • 硬件要求:預設以 2 張 GPU 配合 Accelerate 和 DeepSpeed ZeRO-3,原始實驗使用 80 GB A100、H100 及 H200。
  • 檢查方式:TwoHop 每 15 步儲存 checkpoint 並選驗證集峰值,Hint 和 Mult 則只保留最終模型。

研究人員可用它重跑訓練及檢查指標定義,已有 Hugging Face Open R1 訓練環境的團隊亦較容易接入;但缺少資料與權重,不能直接下載後重現結果。項目更適合作為研究管線的精簡骨架,而非開箱即用的完整模型。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, DeepSeek, 框架, 庫, 深度學習

[技術文章] DeepSeek-V4.1-Flash 百萬上下文 KV Cache 壓到四分之一

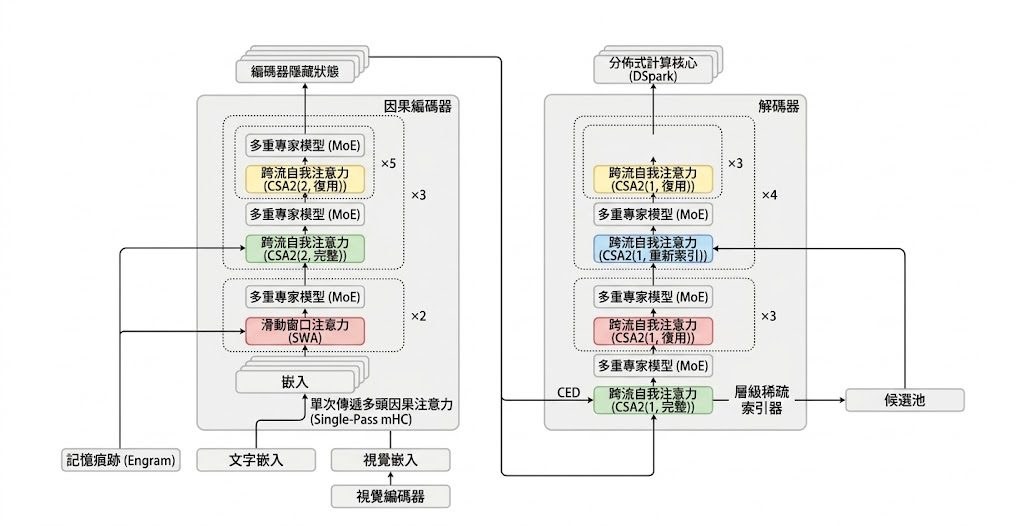
百萬 token 上下文背後最大的成本壓力來自 KV cache。DeepSeek-V4.1-Flash 用 CED 架構配合 CSA2,將每個 token 的記憶體用量壓到大約 890 bytes。

Hero image preview

長文 agent 跑得愈久,KV cache 累積得愈快,HBM 容量、頻寬、SSD 傳輸成本幾乎同步飆升;DeepSeek 團隊認為,這才是 scaling down 長上下文部署成本的主要瓶頸,而不單是推論計算本身。

為處理這道難題,DeepSeek-V4.1-Flash 採用 Causal Encoder-Decoder(CED)架構:prefill 階段啟用 8B 參數,decode 階段啟用 16B 參數,讓輸入極長但輸出相對短嘅 agent workload 成本結構更友善。Backbone 規模去到 552B,並支援長達一百萬 token 嘅上下文。

記憶體方面,Compressed Sparse Attention 2(CSA2)加入跨層 KV cache reuse 與分層稀疏 indexer,再搭配 FP4 KV cache,使常駐 HBM 嘅 global KV cache 降到每個 token 約 890 bytes,相對 V4-Flash 縮減約四倍、相比 V1 更達到 437 倍幅度。透過 SWA Bounded Replay 部署優化,落在 SSD 或 host memory 嘅 persistent footprint 更壓到大約 V4-Flash 嘅八分之一。即使 cache 大幅縮減,模型在 agentic 基準上仍比 baseline 表現更好。

預訓練採用 45T token 嘅多模態語料,後訓練亦經過完整流程,使 V4.1-Flash 在文本與多模態 agent 場景都保持穩定輸出。模型 checkpoint 已於 Hugging Face 開源,可供社群自行部署驗證。

  • 552B 參數 MoE 骨幹,支援 100 萬 token 上下文。
  • CED 架構令 prefill 僅啟用 8B 參數、decode 啟用 16B 參數。
  • CSA2 + FP4 KV cache 將 global KV cache 壓至 890 bytes/token。
  • SWA Bounded Replay 進一步將 persistent KV cache 降至 V4-Flash 約 1/8。
  • 45T token 多模態預訓練 + 完整後訓練,agentic 表現優於前代。

Paper

Categories: 開源, 模型, DeepSeek

Wenyi 把整本書放進記憶:一次譯完一本書,角色名終於唔再走樣

Wenyi 是一款針對小說、專書同長篇敘事嘅開源翻譯工具,主打逐章掃描、術語即時對齊同可斷點續譯,支援 DeepSeek、OpenAI、Gemini 等多個模型供應商。

wenyi emblem

好多人試過用大型語言模型 (LLM) 翻譯小說或學術專書,往往喺第三、四章就發現角色名譯咗另一個譯法,或者術語前後矛盾,要回頭逐段人手修正。Wenyi 就係針對呢個常見痛點而設計嘅 Python 開源工具,主打長篇文本嘅翻譯流程。佢會事先將全書掃描一次,為每個章節建立摘要同全書概要,再喺逐批翻譯時一齊注入,令模型對脈絡同角色關係有長期記憶。

工具同時內建術語管理模組,會隨翻譯過程自動抽取人名、地名同專有詞彙,並偵測前後唔一致嘅譯法,要求人手仲裁,再影響後續批次。咁樣嘅設計對譯者、編輯同人氣翻譯團隊特別有用,可以避免「譯到後期先發現譯名漂移」嘅慘況。Wenyi 仲提供可選嘅多階段品管:先以主力模型做初譯,再由較強模型做潤稿,最後以證據導向嘅方式做整書 AI 審閱,適合對品質要求高、但又想慳人手嘅場景。

操作上,每批翻譯都有 checkpoint 落盤,章節狀態有獨立追蹤,任何時候中斷都可以用同一個指令續譯。支援嘅模型供應商包括 DeepSeek、OpenAI、OpenRouter、OrcaRouter、Google Gemini、Ollama、vLLM 及任何 OpenAI 兼容端點,可分為三個方便嘅 tier,亦可每個操作揀唔同模型。輸出格式方面,佢會直接寫返入原 EPUB 嘅 XHTML 模板,嘗試保留樣式、圖片、目錄同錨點,對電子書排版敏感嘅讀者會幾啱用。

要注意嘅限制係,Wenyi 仍然依賴上游模型嘅語言能力同上下文窗口,對語氣、文風同微妙雙關嘅判斷無可避免會受模型本身限制;長篇翻譯嘅成本同時間亦會隨章節增加。文檔列明需要 Python 3.10 或以上,社群主要喺 Discord 運作。

重點摘要:
– 全書預掃描 (Whole-book prescan):每章摘要 + 全書概要同時注入翻譯批次
– 即時術語同衝突偵測,可人手決議後回寫後續翻譯
– 支援 DeepSeek、OpenAI、Gemini、Ollama 等多 LLM,可分三層 tier
– 提供 checkpoint 續譯,中斷後同一指令可接返
– 多階段品管:初譯 → 強模型潤稿 → 全書 AI 審閱,並原生保留 EPUB 排版

GitHub

Categories: 開源, Google, OpenAI, DeepSeek, Gemini, Image, 工具, Ollama, Python

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

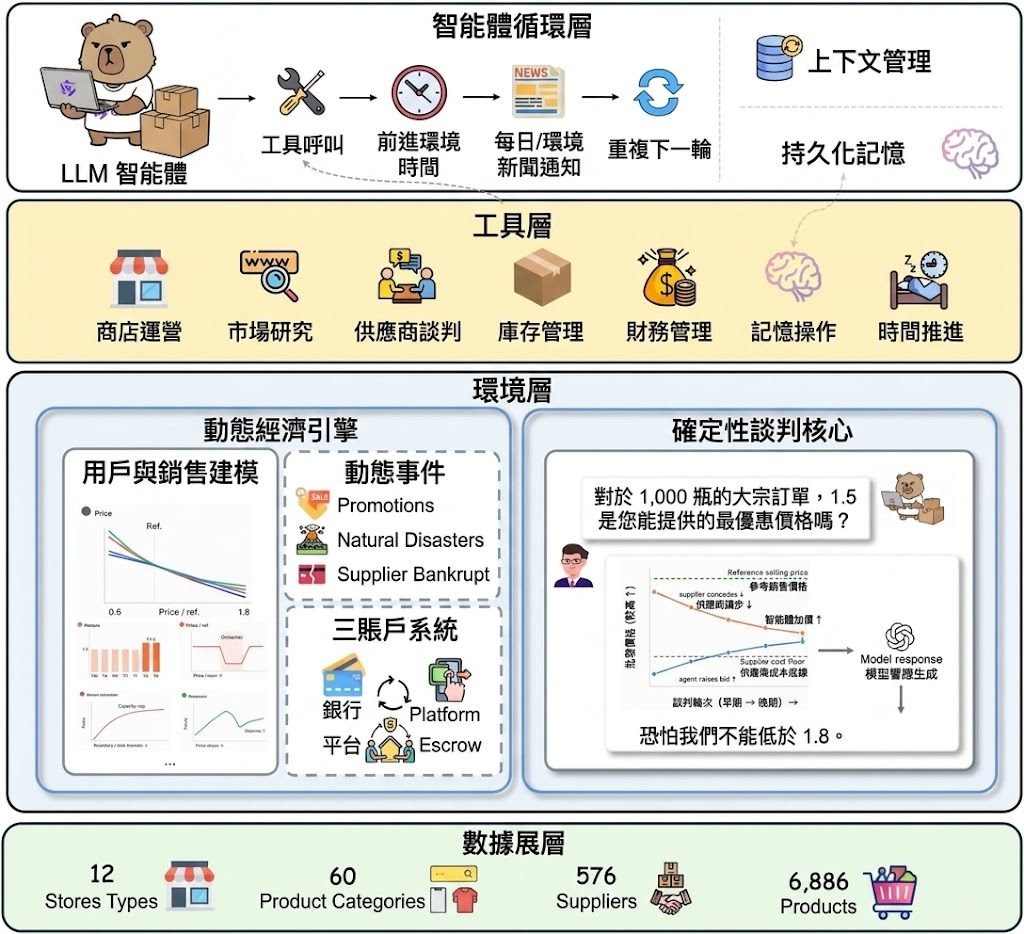
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, Google, OpenAI, DeepSeek, Gemini, Python, Anthropic, Dataset 數據集

Page 2 of 6
1 2 3 4 … 6