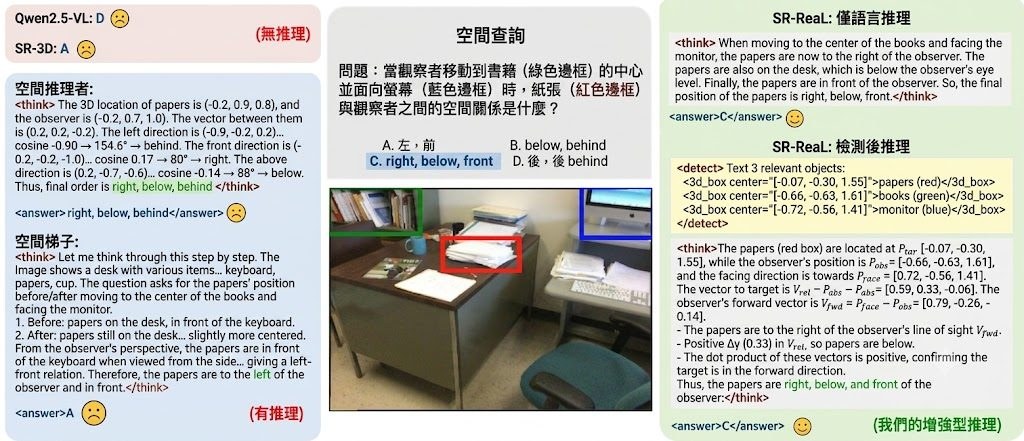
SR-REAL 把空間推理拆成兩條路

SR-REAL 不是只靠文字推理,也加入 3D 定位再判斷。它想解決空間 VLM 遇到距離、方位、多步推理時常出錯的問題。

Repository image for jiyt17/SR-REAL

現有 spatial VLM 往往用單一路線回答空間問題,不是純文字 chain-of-thought,就是直接靠感知結果輸出答案;作者認為這種固定範式難以同時處理語意推理與精確幾何判斷。SR-REAL 提出的做法,是把空間推理分成 Language-Only Reasoning(LOR)與 Detect-Then-Reason(DTR)兩條互補路徑,前者逐步文字推理,後者先找 3D 幾何線索,再做明確幾何推斷。

這個項目屬於框架加訓練流程實作,核心是強化 spatial vision-language models 在複雜空間問答中的判斷能力。它不是單純新增資料集,而是從 cold-start supervised fine-tuning 到 reinforcement learning(RL)都重新安排,並加入 region-to-3D 介面,令模型可把 region tokens 連到 3D 座標、中心點或 bounding boxes。

SR-REAL 重點集中在資料準備與訓練前處理。流程上會先用 SPAR、EmbodiedScan 等來源整理物件對應與 3D 座標,再由 expert.py 生成推理鏈,配合 qwen3.py 抽取物件名稱,最後組成 DTR 指令微調資料;若不想自行重建,也可直接下載作者已整理好的 Hugging Face 數據。這表示它較適合有 Python、資料處理及多模態訓練基礎的研究團隊,而不是即裝即用的終端工具。

和同類做法相比,SR-REAL 不假設所有空間問題都應該用同一種 reasoning path。作者的取向很清楚:語意關係適合 LOR,涉及明確位置、距離、中心點、框選區域的題目則交給 DTR;代價是整個資料構建與訓練流程更複雜,對 grounding 資料品質亦更敏感。

  • 重點不在單一模型結構,而在 LOR + DTR 雙路徑推理設計
  • DTR 會先處理 region tokens 與 3D 幾何線索,再做空間判斷
  • 訓練分為 cold-start supervised fine-tuning 與 reinforcement learning(RL)兩段
  • 已提及 accuracy、format、detection rewards,顯示評測不只看答對與否,也看輸出格式及幾何對齊
  • 相關模型與資料來源包括 spatial VLM、SR-3D、Qwen3、SPAR、EmbodiedScan、SpatialRGPT、Omni3D、CA1M、OmniNOCS

SR-REAL 在多個 spatial benchmarks 有明顯提升,並強調單一 RL-trained model 可同時支援兩條路徑,且不用 per-task tuning 也能跨資料集泛化。不過儲存庫片段未完整列出詳細分數與對照表,因此較穩妥的判斷是:這是一個研究味很重、方法論清晰的項目,適合關注 spatial reasoning、3D grounding、multimodal instruction tuning 的團隊拿來重現與延伸。

GitHub: https://github.com/jiyt17/SR-REAL

項目主頁: https://sr-real.github.io/

Categories: 香港大學, Agentic, 模型, 多模態模型, 模型訓練, Qwen, Google, NVIDIA, OpenAI, DeepSeek, 框架, 香港, 工具, 3D, Python NLP, Python, , 編程


awesome-deepseek-agent:接通 DeepSeek 代理清單

這個儲存庫不是模型本身,而是一份實用導航,幫你把 DeepSeek 接入常見 AI 工具。對想快速試用的人來說,方向清楚又省時間。

Repository image for deepseek-ai/awesome-deepseek-agent

如果你想用 DeepSeek,但又唔想逐個工具自己摸索設定,這個儲存庫的價值就很直接:它把多個常見 AI 代理與編碼助手的接入方法整理成一份清單。重點不是提供新功能,而是幫你少走彎路,較快完成第一次啟用。

上手方式相當清晰,一般先準備好 DeepSeek 平台的 API key,再按你正在使用的工具去看對應指引。README 顯示每份教學都圍繞安裝、設定與首次運行,對初學者來說,比起翻官方文件更容易找到入口。

它解決的主要問題,是不同工具各有不同的接法,初次整合時容易混亂。這個專案把 Claude Code、GitHub Copilot、GitHub Copilot CLI、Codex、OpenCode、AstrBot、OpenClaw、Hermes、Crush、Pi、nanobot 等放在同一處,讓你可以按自己習慣的工作環境選擇,而不是先被工具差異拖慢。

較有意思的地方,在於它不是只面向單一類型軟件。你會見到終端機編碼助手、VS Code 內建助手、聊天平台代理,甚至可擴充技能或 MCP 的工具都被納入,反映 DeepSeek 模型可用的場景比單純寫程式更闊;文中亦提到可快速開始使用 DeepSeek-V4-ProDeepSeek-V4-Flash

  • 適合想試用 DeepSeek、但未決定用哪個前端工具的人
  • 對開發者、技術團隊,以及要部署聊天代理的用家都實用
  • 整理了多個相關工具與模型入口,方便橫向比較
  • 核心價值在於教學彙整,不是重新發明代理框架

整體來看,這是一個偏「索引型」的實用資源,特別適合想在幾分鐘內完成第一步的人。若你已經知道自己會用哪個客戶端,它能充當快捷門;如果你仍在比較工具,它亦提供了一個不錯的起點,但更深入能力仍要回到各工具本身的文件確認。

網址: https://github.com/deepseek-ai/awesome-deepseek-agent

Categories: 開源, DeepSeek, , 中國


DeepSeek-R1 的強化學習可視化

影片主要講解 DeepSeek R1 模型背後的強化學習演算法,並著重於如何透過人類回饋來訓練獎勵模型。包括如何根據人類對不同回應的偏好來調整獎勵值。接著深入探討 “近端策略優化”(Proximal Policy Optimization)演算法的細節。同時亦探討如何利用 “優勢函數”(Advantage Function)避免偏離原始策略。最後,影片亦解釋了如何運用群體策略優化成高於平均水準的回應,同時亦阻止了低於平均水準的回應,而因此提升了模型的推理能力。

影片主要講解 DeepSeek R1 模型背後的強化學習演算法,並著重於如何透過人類回饋來訓練獎勵模型。包括如何根據人類對不同回應的偏好來調整獎勵值。接著深入探討 “近端策略優化”(Proximal Policy Optimization)演算法的細節。同時亦探討如何利用 “優勢函數”(Advantage Function)避免偏離原始策略。最後,影片亦解釋了如何運用群體策略優化成高於平均水準的回應,同時亦阻止了低於平均水準的回應,而因此提升了模型的推理能力。

Reinforcement Learning in DeepSeek-R1 | Visually Explained
Categories: 開源, 模型, DeepSeek, 教學

以 Gradio 本地運行 RAG DeepSeek R1

影片教你如何建立一個簡單的 Web 應用程式,使用 Ollama LangChain 和 Gradio,透過檢索增強生成 (RAG) 來查詢 PDF 文件。無論你是 AI 的初學者或已有經驗,只要有興趣用 Web 運行 AI 模型,這教學都非常實用。由於支持離線運作,因此能夠增加安全性,保障私隱,特別是對於使用 AI 處理公司內部文件嘅任務。

影片教你如何建立一個簡單的 Web 應用程式,使用 Ollama LangChain 和 Gradio,透過檢索增強生成 (RAG) 來查詢 PDF 文件。無論你是 AI 的初學者或已有經驗,只要有興趣用 Web 運行 AI 模型,這教學都非常實用。由於支持離線運作,因此能夠增加安全性,保障私隱,特別是對於使用 AI 處理公司內部文件嘅任務。

Run DeepSeek R1 Locally With Ollama | Build a Local Gradio App for RAG
Categories: RAG, DeepSeek, Ollama

DeepSeek-VL2-small 視覺模型

DeepSeek-VL2-small 是 DeepSeek-VL2 的小型版本,混合專家 (MoE) 視覺語言模型,旨在提升 DeepSeek-VL 的視覺效能。此模型在視覺問答、光學字元辨識和文件理解等多種任務上展現了卓越的能力。DeepSeek-VL2-small 擁有 28 億(2.8b)個參數,在效能上可與現有的其它開源模型競爭,甚至超越它們。模型的程式碼採用 MIT 許可證,模型本身的使用則受到 DeepSeek 模型許可證的約束,允許商業用途。

DeepSeek-VL2-small 是 DeepSeek-VL2 的小型版本,混合專家 (MoE) 視覺語言模型,旨在提升 DeepSeek-VL 的視覺效能。此模型在視覺問答、光學字元辨識和文件理解等多種任務上展現了卓越的能力。DeepSeek-VL2-small 擁有 28 億(2.8b)個參數,在效能上可與現有的其它開源模型競爭,甚至超越它們。模型的程式碼採用 MIT 許可證,模型本身的使用則受到 DeepSeek 模型許可證的約束,允許商業用途。

Categories: 開源, DeepSeek, 影像處理

Deepseek 的 5 個有趣實驗

作者進行五個關於 DeepSeek R1 以及其他模型(Claude 3.5、OpenAI)的實驗。實驗一測試模型生成 3D 瀏覽器模擬程式碼的能力,結果 DeepSeek R1 成功完成;實驗二結合 Claude 的功能與 DeepSeek R1 的推理機制,實現更複雜的資訊處理;實驗三探討模型在一個數值猜測遊戲中的推理過程,展現了模型的思考步驟;實驗四修改經典的河渡問題,測試模型是否能跳脫既有訓練資料的限制,DeepSeek R1和Claude成功解決,OpenAI則失敗;實驗五則以情境題測試模型的連續推理能力,多個模型皆能得出正確結論。整體而言,影片旨在展示大型語言模型的程式碼生成、工具使用、推理能力以及突破訓練資料限制的潛力,並分享作者對模型能力的觀察與思考。

作者進行五個關於 DeepSeek R1 以及其他模型(Claude 3.5、OpenAI)的實驗。
實驗一測試模型生成 3D 瀏覽器模擬程式碼的能力,結果 DeepSeek R1 成功完成;
實驗二結合 Claude 的功能與 DeepSeek R1 的推理機制,實現更複雜的資訊處理;
實驗三探討模型在一個數值猜測遊戲中的推理過程,展現了模型的思考步驟;
實驗四修改經典的河渡問題,測試模型是否能跳脫既有訓練資料的限制,DeepSeek R1和Claude成功解決,OpenAI則失敗;
實驗五則以情境題測試模型的連續推理能力,多個模型皆能得出正確結論。
整體而言,影片旨在展示大型語言模型的程式碼生成、工具使用、推理能力以及突破訓練資料限制的潛力,並分享作者對模型能力的觀察與思考。

I Did 5 DeepSeek-R1 Experiments | Better Than OpenAI o1?
Categories: 模型, DeepSeek, 新聞

Page 4 of 4
1 2 3 4