WATER:WordArt 場景文字識別新突破

復旦大學與騰訊 WeChat Vision 團隊推出 WATER 項目,從數據與模型兩端突破藝術文字識別瓶頸,於 WordArt-Bench 創下 90.40% 準確率。

overview

這是一個由復旦大學(上海多模態具身 AI 重點實驗室)與騰訊 WeChat Vision 聯合發佈的研究項目(屬於數據集+模型基準組合),同時收錄於 ECCV 2026。針對 WordArt-oriented scene TExt Recognition(WATER)這項任務,原有 STR 數據集與方法普遍圍繞「規則場景文字」與「固定模板輸入」建構,難以應對 WordArt 高度自訂的字體、紋理與版面,因此表現受限。WATER 從兩端突破:數據方面構建 2M 規模合成數據集 WATER-S,模型方面提出支援任意形狀輸入的 STR 基線 WATERec。

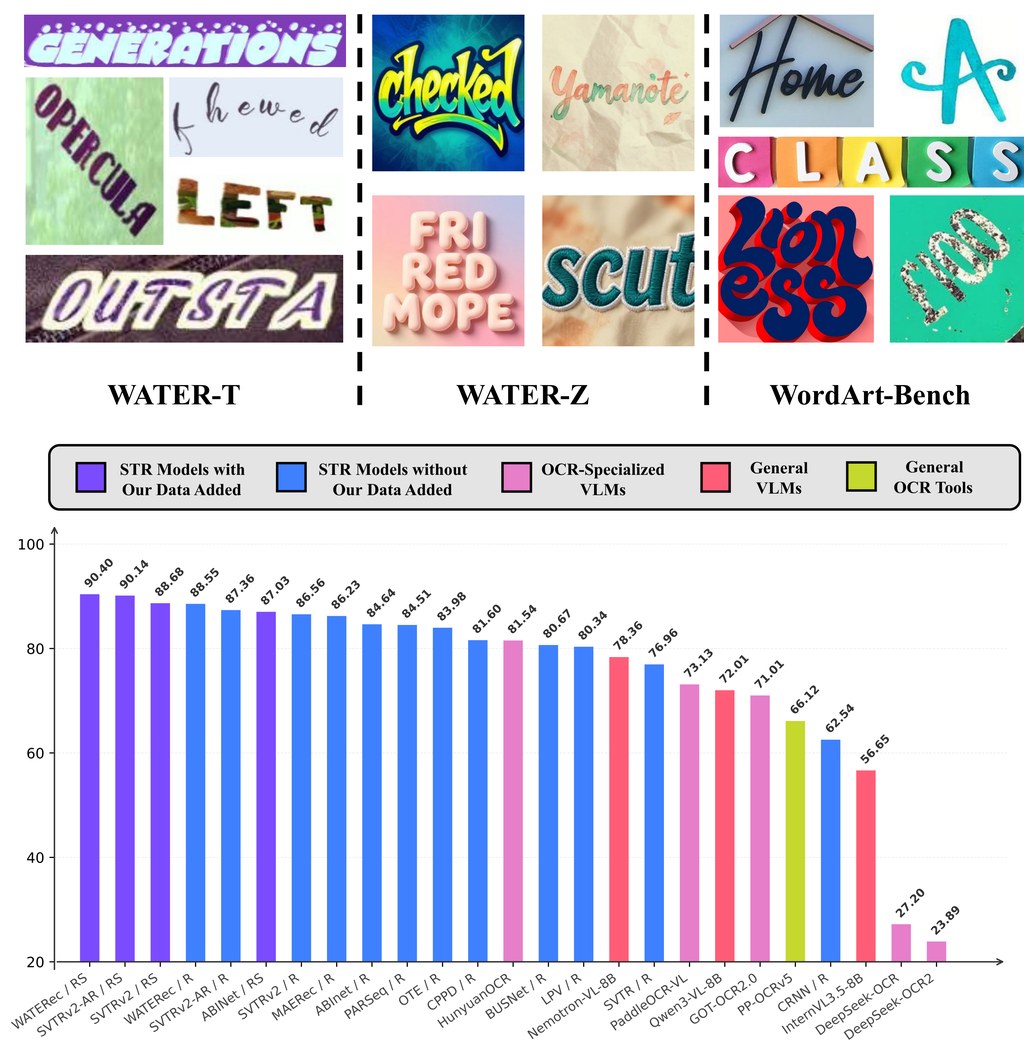
WATER-S 數據集設計包含兩個互補子集:WATER-T(1M)由 SynthWordArt 渲染引擎透過 11,250 款藝術字體生成,提供高可控的精準合成樣本;WATER-Z(1M)則結合 Qwen3-VL 提示詞挖掘與 Z-Image 影像合成,覆蓋更真實且多元的場景。再搭配 WATER-R(3.2M,整理自 Union14M-L、WordArt、WAS-R 並去重)作為真實訓練集,整體數據規模較既有藝術文字數據提升數百倍。

WATERec 模型架構採用類似 NaViT 的編碼器搭配 RoPE,支援任意形狀輸入,再以自回歸解碼器處理複雜版面,從結構上打破固定模板 STR 的瓶頸。在 WordArt-Bench 上以 90.40% 準確率成為首個突破 90% 的結果,大幅超越 HunyuanOCR(81.54%)及其他通用或 OCR 專用視覺語言模型。

使用方法需配合外部資源:WATERec 訓練與推理程式碼位於 OpenOCR-WATERec 倉庫;模型權重、數據集(包含 WordArt-Bench)、273K 條 WATER-Z 提示詞模板與 112K 款藝術字體皆託管於 HuggingFace。複製本倉庫後,可透過 SynthWordArt/ 目錄取得 WATER-T 渲染流程,prompts/ 目錄提供 caption_mining.py 與 fewshot_expansion.py 兩階段提示詞挖掘,Z-Image/gen_zimage.py 支援多 GPU 並行生成,eval_vlm/ 則整合 Qwen3-VL-8B、InternVL3.5-8B、GOT-OCR2.0、DeepSeek-OCR-2、PaddleOCR-VL、PP-OCRv5、HunyuanOCR、Nemotron-VL-8B 等基線評測腳本。

重點摘要:
– 復旦大學與騰訊 WeChat Vision 團隊合作,獲 ECCV 2026 收錄
– WATER-S 含 WATER-T(字體渲染)與 WATER-Z(VLM + 影像合成)兩條合成路徑
– WATERec 以任意形狀編碼器 + 自回歸解碼器突破固定模板限制
– WordArt-Bench 90.40% 為首次突破九成,超越 HunyuanOCR 等專用 VLM
– 所有模型、數據、字體與提示詞均開源於 HuggingFace

從評估對照來看,不論是通用 VLM、OCR 專用 VLM 或一般 OCR 工具,在 WordArt-Bench 上皆明顯落後於 WATERec,反映藝術文字仍是當前多模態模型的弱項。對從事海報辨識、品牌素材處理、廣告設計自動化,以及需要處理高度風格化文字的團隊而言,這套數據+模型組合是目前少數針對該場景強化的開源方案。
GitHub: https://github.com/YesianRohn/WATER

模型: https://huggingface.co/Yesianrohn/WATERec-Models

Categories: 開源, 北京大學, 騰訊, 模型, 視覺模型, 多模態模型, DeepSeek, Image, 深度學習, 中國, Dataset 數據集

Unlimited-OCR:長文件 OCR 新取向

這是一個主打長篇文件解析的 OCR 模型項目。它針對多頁、長輸出內容時速度與記憶體壓力變大的問題作出調整。

Baidu Inc.

Unlimited-OCR 是一個 OCR 視覺文字辨識模型項目,也可視為一個針對長文件解析而改造的研究原型。它主要用來把圖片或 PDF 內的大量文字與版面內容一次過轉成可輸出的解析結果,重點是處理多頁文件時盡量減少記憶體負擔。

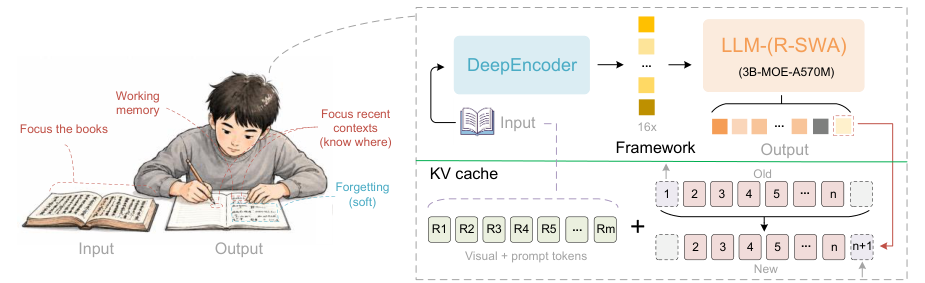
現有 end-to-end OCR 做法以 DeepSeek-OCR 為代表,會用 large language model(LLM)作 decoder,優點是能借助語言先驗提升辨識效果,但輸出一長,KV cache 會一路累積,令顯存需求上升、生成愈來愈慢。Unlimited-OCR 的做法是保留高壓縮 encoder,再把 decoder 的 attention 層改成 Reference Sliding Window Attention(R-SWA),讓每個 token 持續關注 reference tokens 與有限長度的前文,目標是把 KV cache 維持在常數規模。

這個取向最值得留意的地方,不是單純追求單頁最高精度,而是把「one-shot long-horizon parsing」放在核心位置。跟一般 full attention 比,它犧牲的是傳統全域注意力形式,換來多頁文件在 32K 長度下仍可做單次 forward pass;跟 vanilla SWA 比,它又保留 visual tokens 作為穩定參照,避免狀態傳遞後愈來愈模糊。

部署路線相當明確:項目提供 Hugging Face Transformers 推理方式,測試環境寫明需 NVIDIA GPU,並以 Python 3.12.3、CUDA 12.9 為基礎;單張圖片可在 gundam 與 base 兩種設定中選擇,多頁與 PDF 則使用 base 配置。想先了解效果,也可直接看 Hugging Face Spaces demo 或 ModelScope 版本,再決定是否自行落地。

  • 類型定位:OCR 模型/研究原型,解決長文件、多頁解析時記憶體與速度惡化問題
  • 核心差異:以 Reference Sliding Window Attention(R-SWA)取代 decoder 全部 attention layers
  • 適合情境:長 PDF、批量文件數碼化、需要版面解析與長輸出的團隊
  • 相關模型:DeepSeek-OCR、Unlimited-OCR;文中亦提到 R-SWA 可延伸到 ASR、translation
  • 限制判斷:目前公開資訊主力放在推理與方法設計,具體評測數字仍要回看 arXiv 論文原文才適合作更細比較

對需要處理保單、報表、掃描檔、書籍或多頁行政文件的團隊,這個項目的吸引力會比一般單頁 OCR 更高。若你的工作重點是短文字截圖、手機快拍辨識,Unlimited-OCR 的優勢未必完全發揮,但對長輸出穩定性與部署在 GPU 環境的可行性,它展示了一條很清楚的改良路線。

GitHub: https://github.com/baidu/Unlimited-OCR

Paper: https://arxiv.org/pdf/2606.23050

Categories: 開源, 模型, 視覺模型, NVIDIA, DeepSeek, Image, Python NLP, Python, Meta, 百度

SR-REAL 把空間推理拆成兩條路

SR-REAL 不是只靠文字推理,也加入 3D 定位再判斷。它想解決空間 VLM 遇到距離、方位、多步推理時常出錯的問題。

Repository image for jiyt17/SR-REAL

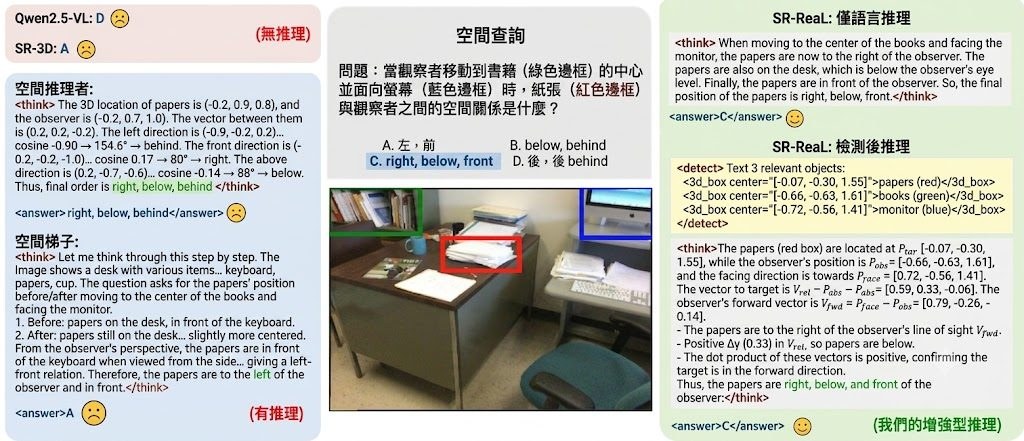
現有 spatial VLM 往往用單一路線回答空間問題,不是純文字 chain-of-thought,就是直接靠感知結果輸出答案;作者認為這種固定範式難以同時處理語意推理與精確幾何判斷。SR-REAL 提出的做法,是把空間推理分成 Language-Only Reasoning(LOR)與 Detect-Then-Reason(DTR)兩條互補路徑,前者逐步文字推理,後者先找 3D 幾何線索,再做明確幾何推斷。

這個項目屬於框架加訓練流程實作,核心是強化 spatial vision-language models 在複雜空間問答中的判斷能力。它不是單純新增資料集,而是從 cold-start supervised fine-tuning 到 reinforcement learning(RL)都重新安排,並加入 region-to-3D 介面,令模型可把 region tokens 連到 3D 座標、中心點或 bounding boxes。

SR-REAL 重點集中在資料準備與訓練前處理。流程上會先用 SPAR、EmbodiedScan 等來源整理物件對應與 3D 座標,再由 expert.py 生成推理鏈,配合 qwen3.py 抽取物件名稱,最後組成 DTR 指令微調資料;若不想自行重建,也可直接下載作者已整理好的 Hugging Face 數據。這表示它較適合有 Python、資料處理及多模態訓練基礎的研究團隊,而不是即裝即用的終端工具。

和同類做法相比,SR-REAL 不假設所有空間問題都應該用同一種 reasoning path。作者的取向很清楚:語意關係適合 LOR,涉及明確位置、距離、中心點、框選區域的題目則交給 DTR;代價是整個資料構建與訓練流程更複雜,對 grounding 資料品質亦更敏感。

  • 重點不在單一模型結構,而在 LOR + DTR 雙路徑推理設計
  • DTR 會先處理 region tokens 與 3D 幾何線索,再做空間判斷
  • 訓練分為 cold-start supervised fine-tuning 與 reinforcement learning(RL)兩段
  • 已提及 accuracy、format、detection rewards,顯示評測不只看答對與否,也看輸出格式及幾何對齊
  • 相關模型與資料來源包括 spatial VLM、SR-3D、Qwen3、SPAR、EmbodiedScan、SpatialRGPT、Omni3D、CA1M、OmniNOCS

SR-REAL 在多個 spatial benchmarks 有明顯提升,並強調單一 RL-trained model 可同時支援兩條路徑,且不用 per-task tuning 也能跨資料集泛化。不過儲存庫片段未完整列出詳細分數與對照表,因此較穩妥的判斷是:這是一個研究味很重、方法論清晰的項目,適合關注 spatial reasoning、3D grounding、multimodal instruction tuning 的團隊拿來重現與延伸。

GitHub: https://github.com/jiyt17/SR-REAL

項目主頁: https://sr-real.github.io/

Categories: 香港大學, Agentic, 模型, 多模態模型, 模型訓練, Qwen, Google, NVIDIA, OpenAI, DeepSeek, 框架, 香港, 工具, 3D, Python NLP, Python, 庫, 編程


awesome-deepseek-agent:接通 DeepSeek 代理清單

這個儲存庫不是模型本身,而是一份實用導航,幫你把 DeepSeek 接入常見 AI 工具。對想快速試用的人來說,方向清楚又省時間。

Repository image for deepseek-ai/awesome-deepseek-agent

如果你想用 DeepSeek,但又唔想逐個工具自己摸索設定,這個儲存庫的價值就很直接:它把多個常見 AI 代理與編碼助手的接入方法整理成一份清單。重點不是提供新功能,而是幫你少走彎路,較快完成第一次啟用。

上手方式相當清晰,一般先準備好 DeepSeek 平台的 API key,再按你正在使用的工具去看對應指引。README 顯示每份教學都圍繞安裝、設定與首次運行,對初學者來說,比起翻官方文件更容易找到入口。

它解決的主要問題,是不同工具各有不同的接法,初次整合時容易混亂。這個專案把 Claude Code、GitHub Copilot、GitHub Copilot CLI、Codex、OpenCode、AstrBot、OpenClaw、Hermes、Crush、Pi、nanobot 等放在同一處,讓你可以按自己習慣的工作環境選擇,而不是先被工具差異拖慢。

較有意思的地方,在於它不是只面向單一類型軟件。你會見到終端機編碼助手、VS Code 內建助手、聊天平台代理,甚至可擴充技能或 MCP 的工具都被納入,反映 DeepSeek 模型可用的場景比單純寫程式更闊;文中亦提到可快速開始使用 DeepSeek-V4-Pro 與 DeepSeek-V4-Flash。

  • 適合想試用 DeepSeek、但未決定用哪個前端工具的人
  • 對開發者、技術團隊,以及要部署聊天代理的用家都實用
  • 整理了多個相關工具與模型入口,方便橫向比較
  • 核心價值在於教學彙整,不是重新發明代理框架

整體來看,這是一個偏「索引型」的實用資源,特別適合想在幾分鐘內完成第一步的人。若你已經知道自己會用哪個客戶端,它能充當快捷門;如果你仍在比較工具,它亦提供了一個不錯的起點,但更深入能力仍要回到各工具本身的文件確認。

網址: https://github.com/deepseek-ai/awesome-deepseek-agent

Categories: 開源, DeepSeek, 庫, 中國


DeepSeek-R1 的強化學習可視化

影片主要講解 DeepSeek R1 模型背後的強化學習演算法,並著重於如何透過人類回饋來訓練獎勵模型。包括如何根據人類對不同回應的偏好來調整獎勵值。接著深入探討 “近端策略優化”(Proximal Policy Optimization)演算法的細節。同時亦探討如何利用 “優勢函數”(Advantage Function)避免偏離原始策略。最後,影片亦解釋了如何運用群體策略優化成高於平均水準的回應,同時亦阻止了低於平均水準的回應,而因此提升了模型的推理能力。

影片主要講解 DeepSeek R1 模型背後的強化學習演算法,並著重於如何透過人類回饋來訓練獎勵模型。包括如何根據人類對不同回應的偏好來調整獎勵值。接著深入探討 “近端策略優化”(Proximal Policy Optimization)演算法的細節。同時亦探討如何利用 “優勢函數”(Advantage Function)避免偏離原始策略。最後,影片亦解釋了如何運用群體策略優化成高於平均水準的回應,同時亦阻止了低於平均水準的回應,而因此提升了模型的推理能力。

Reinforcement Learning in DeepSeek-R1 | Visually Explained
Categories: 開源, 模型, DeepSeek, 教學

以 Gradio 本地運行 RAG DeepSeek R1

影片教你如何建立一個簡單的 Web 應用程式,使用 Ollama LangChain 和 Gradio,透過檢索增強生成 (RAG) 來查詢 PDF 文件。無論你是 AI 的初學者或已有經驗,只要有興趣用 Web 運行 AI 模型,這教學都非常實用。由於支持離線運作,因此能夠增加安全性,保障私隱,特別是對於使用 AI 處理公司內部文件嘅任務。

影片教你如何建立一個簡單的 Web 應用程式,使用 Ollama LangChain 和 Gradio,透過檢索增強生成 (RAG) 來查詢 PDF 文件。無論你是 AI 的初學者或已有經驗,只要有興趣用 Web 運行 AI 模型,這教學都非常實用。由於支持離線運作,因此能夠增加安全性,保障私隱,特別是對於使用 AI 處理公司內部文件嘅任務。

Run DeepSeek R1 Locally With Ollama | Build a Local Gradio App for RAG
Categories: RAG, DeepSeek, Ollama

DeepSeek-VL2-small 視覺模型

DeepSeek-VL2-small 是 DeepSeek-VL2 的小型版本,混合專家 (MoE) 視覺語言模型,旨在提升 DeepSeek-VL 的視覺效能。此模型在視覺問答、光學字元辨識和文件理解等多種任務上展現了卓越的能力。DeepSeek-VL2-small 擁有 28 億(2.8b)個參數,在效能上可與現有的其它開源模型競爭,甚至超越它們。模型的程式碼採用 MIT 許可證,模型本身的使用則受到 DeepSeek 模型許可證的約束,允許商業用途。

DeepSeek-VL2-small 是 DeepSeek-VL2 的小型版本,混合專家 (MoE) 視覺語言模型,旨在提升 DeepSeek-VL 的視覺效能。此模型在視覺問答、光學字元辨識和文件理解等多種任務上展現了卓越的能力。DeepSeek-VL2-small 擁有 28 億(2.8b)個參數,在效能上可與現有的其它開源模型競爭,甚至超越它們。模型的程式碼採用 MIT 許可證,模型本身的使用則受到 DeepSeek 模型許可證的約束,允許商業用途。

Categories: 開源, DeepSeek, 影像處理

Page 5 of 6
1 … 3 4 5 6