Supra-Router-51M:AI 嘅智能分流

51.7M 參數嘅微型路由模型,自動判斷請求該交由本地小型模型定雲端大型模型處理。

Og image

Supra-Router-51M 係一個基於 SupraLabs/Supra-1.5-50M-Base-exp 基礎模型微調而成嘅小型語言模型(SLM),定位係多模型生態系統嘅邊緣路由閘道。佢嘅主要用途係分析用戶輸入嘅提示詞,判斷該請求適合由本地小型模型處理,定係需要轉交雲端大型模型,從而優化整體運算資源分配。

模型採用 Multi-Task Sequence Generation(多任務序列生成)嘅方法,唔係單純做二元分類。佢會先輸出一連串結構化資訊,包括語義領域(Domain)、複雜度評分(Complexity 1-5)、數學需求(Math)、程式碼需求(Code),最後先輸出路由決定(Route)。呢種設計令模型喺做最終判斷前,先建立內部特徵激活圖,避免細模型容易出現嘅權重崩塌問題。

訓練方面使用咗 SupraLabs/Prompt-Routing-Dataset 數據集(992 筆樣本),訓練 5 個 Epoch,但喺 Epoch 3(eval_loss 為 0.1342)已達到峰值後就回退保存,避免後段過度擬合。支援序列長度達 3840 tokens,使用 bfloat16 精度,喺 CPU/GPU 都能做到次毫秒級推論速度。推論時必須用 greedy decoding(do_sample=False)以確保決策穩定性。

使用時需要將用戶查詢包裝喺特定格式(Task: [Prompt] Analysis:)入面,模型會輸出 pipe-separated 嘅結構化字串,包含完整嘅提示詞遙測資訊。配合 FastAPI 等閘道框架就可以部署成生產環境嘅自動分流系統。

由於模型只有 51.7M 參數,運行門檻極低,適合邊緣裝置同需要即時決策嘅場景,但佢嘅路由準繩度仍然受制於訓練數據集規模較細呢個限制。

重點摘要:
– 基於 SupraLabs/Supra-1.5-50M-Base-exp 微調,僅 51.7M 參數
– 採用多任務序列生成架構,先分析提示詞特徵再決定路由
– 訓練數據集 992 筆,3840 tokens 序列長度,次毫秒級推論
– 支援 FastAPI 閘道部署,需使用 greedy decoding 確保穩定
– 適合邊緣裝置資源調度,限制係訓練數據規模較小
項目主頁

Categories: 開源, 模型, 框架, LLaMa, Dataset 數據集

TAP:先學動作,再學指令的 VLA 路線

這是一個針對 Vision-Language-Action 模型訓練瓶頸提出的新框架。它用較少專家示範,換取接近大型資料訓練的操作能力。

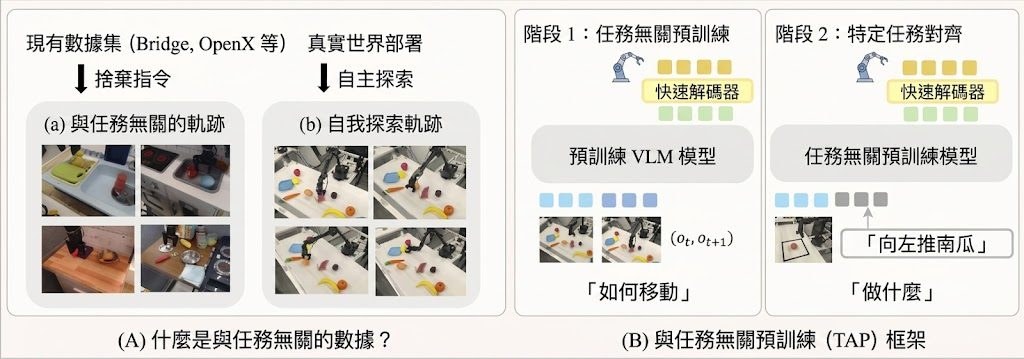
TAP Framework Overview

TAP(Task-Agnostic-Pretrain) 是一個 Vision-Language-Action(VLA)模型訓練框架,屬於研究原型兼訓練方法。它要處理的核心問題,是 VLA 長期依賴大量 expert demonstrations,導致機械操作能力難以用較低成本擴展。

現有做法多數直接把「how to move」與「what to do」一齊學,通常需要 observation、instruction、action 這類完整示範資料;作者認為這種固定範式混淆了 physical competence 與 semantic alignment 兩個目標,結果是語言標註被過度用喺本來可以自我監督學習的動作能力上。Task-Agnostic Pretraining(TAP)因此改成兩階段:先用無標註互動資料透過 self-supervised Inverse Dynamics 學 transferable motor priors,再用少量 expert demonstrations 做 task-specific alignment。

這種取向同標準 behavior cloning、以大量網路或專家軌跡堆出來的 VLA 路線唔同。TAP 的取捨很明確:它未必追求一次過把語義和動作全學齊,而是先把可遷移的「點樣郁」拆出來,換來更低標註成本,同時提高對背景、視角變化的穩定度;代價是整個方法仍然要靠第二階段示範去把語言指令對齊到具體任務。

項目已經交代了測試方式:這不是即裝即用應用程式,而是要跟住論文設定,載入 HuggingFace 提供的模型,重現兩階段訓練,再用 SIMPLER benchmark 與真實 WidowX-250s 場景驗證。數字上,TAP-20k 在 SIMPLER 的 Avg-All 為 33.32%,高過 Standard BC 的 23.15%;真實環境中只用 200 個 expert demos,面對 background texture shift 仍有 45% success,viewpoint variation 亦有 20%,而部分 baseline 會跌到 0%。

  • 用 self-supervised Inverse Dynamics 先學動作先驗,減少對語言標註依賴
  • 以約 30 小時 autonomous play 加少量 expert demonstrations,對比 1M+ expert trajectories 路線更慳資料
  • 在 SIMPLER benchmark 勝過 Standard BC,接近或超過部分現有 VLA 模型
  • 對 visual distractors、background texture shift、viewpoint variation 的抗干擾能力較強
  • 相關模型包括 RT-1-X、OpenVLA、Nora、Octo,以及 README 提到的 TAP-20k

項目較適合做 Embodied AI、robot learning、VLA 訓練流程研究的團隊參考,尤其係想用學術規模算力驗證新訓練路線的人。它現階段更像一套值得跟進的方法論,而唔係面向一般用戶的完成品工具。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 教學, Clone, Dataset 數據集

RDM:一步生成影像的新取向

RDM 係一個一步式影像生成研究項目,目標係用一次網絡推理,做出接近多步模型質素的圖像。

iRDM post-trains four-step FLUX.2 [klein] into a one-step generator at matched quality; GenEval and PickScore climb past

RDM 是一個一步式影像生成研究項目,也是面向 one-step visual generation 的訓練方法。它要解決的問題很直接:把原本需要多次採樣的生成流程,壓縮成一次 network evaluation,仍然盡量保住影像質素。

現有做法通常會依賴 online teacher、adversary,或者追蹤 trajectory 來蒸餾多步生成器;作者認為這類範式訓練成本高、流程複雜,亦容易被單一訊號牽著走。RDM 改用 Representation Distribution Matching,把生成圖與真實圖在多個 frozen pretrained encoders 之下的特徵分佈對齊,核心比較方式是 squared MMD with a Gaussian kernel,同時配合 Nyström attraction、within-batch repulsion,以及 joint image-text law。

這個取向和同類方法的差異,在於它不靠 online teacher、no adversary、no trajectory,訓練邏輯更像直接校準「生成分佈是否接近真實分佈」。作者亦刻意不用單一 encoder,而是用一組 frozen encoders(10 train + 4 held out),再用 proportional Lagrangian controller 平衡各個表示空間,這個設計明顯是想減少模型只迎合某一種評分器的問題。

README 已交代基本理解方式:安裝後可用 ImageNet-256 影像樹做訓練與驗證,也可沿 FLUX text-to-image 路線配合 COCO、GenEval、Pick-a-Pic 做評測;另有 Hugging Face demo 與 checkpoints,可直接看輸出效果。部署上它較像研究型訓練框架,不是即開即用的終端應用,較適合有 GPU 資源、想重現論文結果或做後訓練實驗的團隊。

性能數字有辨識度。RDM 報稱達到 one-step ImageNet state of the art,SW_r14 為 1.30;在 FLUX.2 [klein] 的 post-training 路線中,one-step 模型於 GenEval 達到 0.826,高於 four-step teacher 的 0.794,PickScore 亦升到 22.76,高過 teacher 的 22.58。相關模型與組件包括 FLUX.2 [klein]、open_clip、DreamSim,以及多個 frozen pretrained encoders;整體更適合關注模型訓練、生成效率與影像評測方法的研究或產品項目。

  • 項目類型:研究型訓練方法/框架,重點在一步式影像生成
  • 核心差異:不用 online teacher、adversary、trajectory,改做分佈匹配
  • 測試方式:可用 ImageNet-256、COCO、GenEval、Pick-a-Pic 驗證結果
  • 主要取捨:流程更乾淨,但仍需要資料準備、GPU 資源與完整評測環境
  • 受益情境:想把多步生成器壓成單步模型的研究團隊與影像生成項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型訓練, Stable Diffusion, Image, 影像模型, txt2img, 框架, Dataset 數據集

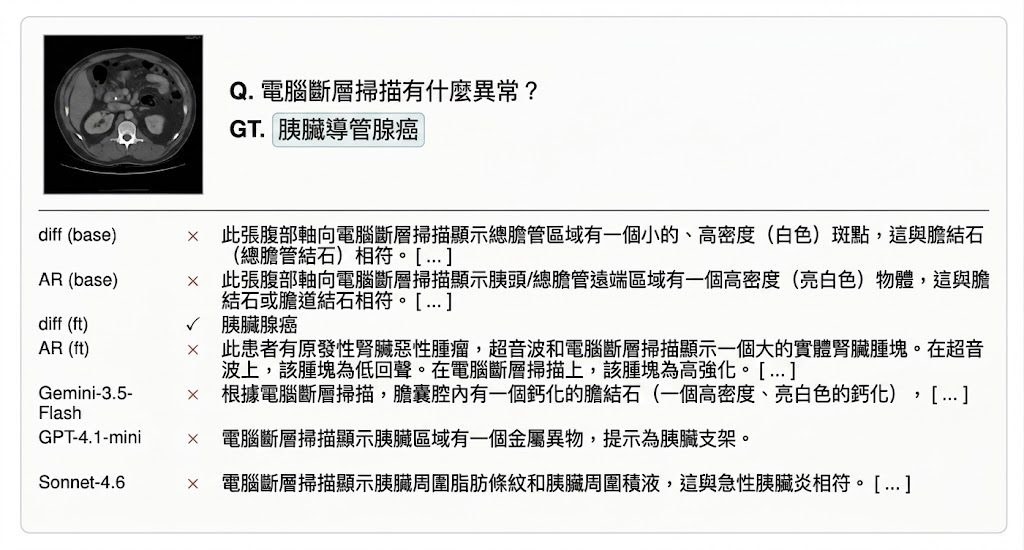
discrete_diffusion_RRG:離散擴散模型點樣寫胸肺 X 光報告

這是一個醫學影像語言模型微調與評測項目,重點是比較 DiffusionGemma 與自回歸基線。它也示範任何順序補全文本在放射報告草稿中的價值。

Repository image for mxvp/discrete_diffusion_RRG

這是一個醫學影像語言模型微調與評測項目,核心是把 image-conditioned discrete-diffusion language model 與 autoregressive baseline 放在同一家族骨幹下直接比較。它主要處理 chest X-ray VQA 與放射報告補全,目標不是單純生成文字,而是讓模型根據 X 光影像回答問題,或在已知部分句子的情況下補寫其餘內容。

項目的設計重點在於控制變因:DiffusionGemma 與 Gemma-4-26B 使用相近的 backbone family、vision tower、資料與 LoRA 配方,令比較更集中於生成方式本身。diffusion 路線把報告當成可逐步去噪的 decoder canvas,autoregressive 則沿用 next-token 順序生成;前者的優勢是可以做 any-order infill,用雙向脈絡補空位,後者則較接近現時多數 VLM 的常見做法。

部署與測試門檻不算低。模型權重透過 Hugging Face IDs 載入,設定檔要接駁本地 JSON 資料索引;倉庫也提供 synthetic: {n: 16} 這種小型 smoke test,適合先確認流程有沒有跑通。硬件要求比較明確,diffusion backbone 需要支援 bf16 的 GPU,而且記憶體大約要 80 GB,這已經把它定位成研究團隊或具備高階 GPU 環境的醫療 AI 項目。

效能表現有幾個值得留意的點。支援內容提到 Discrete Diffusion Language Models 在醫療 VQA 上可追平,甚至略勝同系 autoregression,解碼速度亦可達 3.5 至 4.4 倍;不過目前較完整的準確度重心仍放在 VQA,而報告生成部分主要展示互動式 infill 能力,未算是完整臨床報告生成系統。語義評分還可接 LLM judge,但這部分需要額外 API 金鑰,也表示結果解讀仍有一定研究性質。

  • 類型上,它較接近研究原型加評測程式碼,不是即裝即用的臨床軟件。
  • 主要資料來源包括 VQA-RAD、SLAKE、VQA-Med 與 MIMIC-CXR。
  • 相關模型包括 DiffusionGemma-26B、Gemma-4-26B,並以 LoRA 方式微調。
  • any-order infill 是最有辨識度的能力,適合先固定部分報告內容,再由模型補全其餘位置。
  • 適合需要比較生成範式、研究 radiology report drafting,或想驗證 discrete diffusion 在醫療場景表現的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, Google, Gemini, API, Image, Medical醫學, Dataset 數據集

AnyGroundBench 點出影片定位模型盲點

AnyGroundBench不是新模型,而是專門測試影片理解能力的 benchmark。它把專業場景放入同一套規則,直接揭示現有 VLMs 的適應落差。

Repository image for rinost081/AnyGroundBench

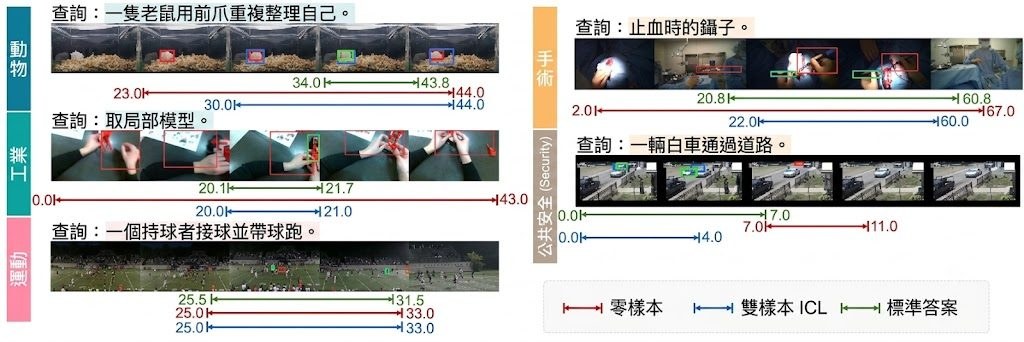
AnyGroundBench 是一個影片 grounding benchmark,也是面向專業領域的資料集與評測基準。它主要用來測試 Vision-Language Models(VLMs)在 animal、industry、sports、surgery、public security 幾類場景中,能否把文字描述準確對應到影片中的時間、位置,以及時空同時發生的事件。

現有做法多數停留在 general、daily-life benchmark 的 zero-shot 測試,重點是看模型有沒有通用理解力;作者認為這種範式無法反映專門場景,因為稀有視覺概念、複雜動作關係與領域術語,通常不會在通用資料裡被充分學到。AnyGroundBench 因而把評測重心轉去 domain adaptation,並加入 dedicated training subsets,令測試不再只問模型「有沒有見過」,而是進一步量度它「能不能適應新領域」。

這個項目的差異,在於它把 temporal、spatial、spatio-temporal annotations 用統一方式整理,並混合 newly captured videos 與 existing datasets。資料來源涵蓋 mouse、american_football、Animal-Kingdom、MECCANO、EgoSurgery 等,覆蓋面比單一領域 benchmark 廣,亦更接近研究團隊、產業分析、醫療影像研究與安全監測場景會遇到的資料分佈。

項目提供 Hugging Face dataset、project page:這不是即插即用應用程式,而是供研究與模型比較的 benchmark。部署重點不是介面安裝,而是按 domain 讀取整理後的資料,然後以 STVG、TVG、SVG 三類任務跑推理與評分;指標分別用 vIoU@0.3、tIoU@0.3、sIoU@0.3。

  • 類型屬於 benchmark / 資料集,目的是測量 VLMs 的 specialized-domain video grounding 能力
  • 舊範式以 zero-shot general benchmark 為主,新設計改為檢查 domain adaptation 與 In-Context Learning(ICL)是否真的有效
  • 評測涵蓋 temporal、spatial、spatio-temporal 三層,較容易看出模型究竟是看錯時間、找錯位置,還是兩邊都失準
  • 已評測 15 個 state-of-the-art VLMs,結果指出現有模型在 specialized domains 的 zero-shot 與 ICL 表現都不穩定

建議模型包括 GPT-4o、GPT-5.1、Gemini-2.5-Flash 等 proprietary VLMs;現有結果顯示,加入 2-shot ICL 雖然在部分 domain 有改善,但整體仍未解決 specialized-domain spatio-temporal reasoning 的缺口。對研究 VLM evaluation、video grounding、視覺模型遷移能力的團隊來說,這個項目最有價值的地方,是它把「通用測試看似可用」與「專業場景仍然失手」之間的差距量化出來。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, Video, 安全, Dataset 數據集

PAW:把英文編譯成本地函數

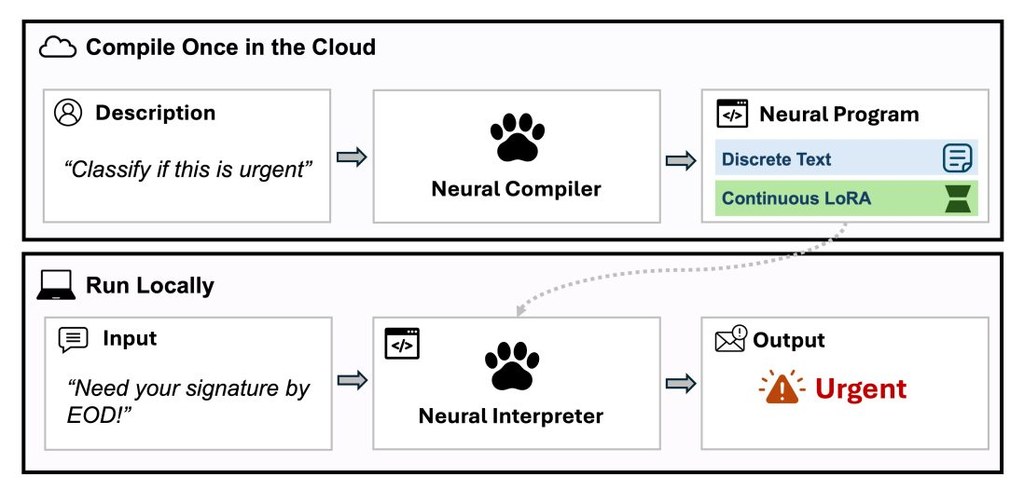
PAW(programasweights-python) 不是一般 LLM 封裝,而是把文字需求變成可離線執行的小型神經函數。它瞄準規則難寫、又不想長期依賴 API 的文字處理工作。

Repository image for programasweights/programasweights-python

PAW(programasweights-python)是一個 Python 工具兼研究原型,屬於把「自然語言」規格編譯成小型神經函數的項目。它要解決的是一類很難用正則表達式或硬編碼規則寫穩定的工作,例如修復壞掉的 JSON、模糊搜尋、分類、抽取欄位,以及把文字意圖對應到正確操作。

現有做法通常有兩條路:一條是手寫規則,遇到錯字、格式飄移同邊界情況就容易失準;另一條是把每次輸入都送去 LLM API,換來較高彈性,但會帶來網絡依賴、成本同重現性問題。Program-as-Weights(PAW)提出的做法,是先用一個 compiler 把英文描述編譯成可重用的神經程式,之後每次呼叫都在本機執行,定位由「每次都問模型」改成「先造好工具再反覆用」。

安裝路線相當直接:Python 端可透過套件取得預編譯函數,亦可自行 compile;瀏覽器端則有 @programasweights/web,但只限用 paw-4b-gpt2 這條較細的 runtime。部署取捨也寫得清楚,paw-4b-qwen3-0.6b 準確度較高,程式體積約 22 MB,本地推理約 0.05 至 0.5 秒;paw-4b-gpt2 準確度較低,但程式只有約 5 MB,支援 WebAssembly,較適合前端或輕量分發。

項目的技術定位:作者把這類問題稱為 fuzzy-function programming,並釋出 FuzzyBench 這個 10M examples 數據集,用 4B compiler 為 frozen interpreter 產生 parameter-efficient adapters。文中指出,0.6B Qwen3 interpreter 執行 PAW 程式時,效果可接近直接 prompting Qwen3-32B,同時把推理記憶體壓到約五十分之一,並在 MacBook M3 達到 30 tokens/s;這些數字有助理解它不是單純包裝模型,而是在成本、可重用性與離線能力之間重新分配。

  • 核心價值:把一次性的自然語言需求,轉成可重複呼叫的本地函數
  • 適合情境:日誌分流、格式修復、文字分類、資料抽取、意圖路由
  • 主要取捨:比直接調用大型 API 更可控、可離線,但編譯器與 runtime 選型會影響準確度與體積
  • 相關模型:paw-4b-qwen3-0.6b、paw-4b-gpt2,論文亦以 Qwen3-32B 作對照
  • 受益團隊:重視本地執行、穩定輸出、低成本重複推理的開發團隊會較易受惠

這個項目最適合放在「規則太脆弱、API 又太重」的中間地帶。它未必取代通用 LLM,但對一批固定任務而言,先編譯、後離線執行的方式更像真正可落地的工程工具。

項目主頁 · GitHub · Paper

Categories: 開源, Qwen, API, Python, 編程, Dataset 數據集

AgenticDataBench:數據代理基準點樣睇

這是一個評測 data agents 的 benchmark。它用真實任務同技能標註,檢查模型是否真係識做數據工作。

example

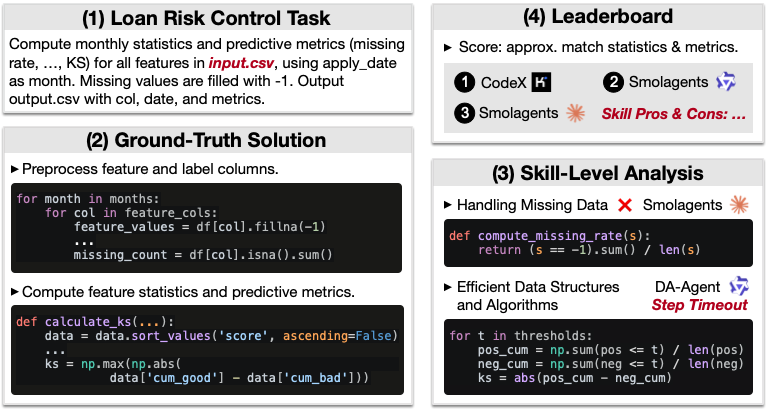
AgenticDataBench 是一個用來評測 data agents 的 benchmark,而唔係直接幫人做分析的模型或應用。它要解決的是:LLM-based data agents 能否穩定完成 data science workflow,並且用可比較、可重現的方式量度表現。

現有做法多數只用零散任務、單一資料集,或者只看最終答案,較難知道代理究竟卡在哪個步驟。這個項目改用 344 個任務、15 個領域,再配合細緻的 skill labels 同 ground-truth,將問題拆成可重用的 data science skills,例如缺失值處理一類操作模式,令評測唔只得總分,仲可以見到技能層面的強弱。

部署同理解方式都幾直接:資料集可由 HuggingFace 下載後放入 testbed/datasets/,任務、gold 標註同結果目錄已經分開,另外保留咗 98 個 private test tasks 維持 leaderboard 的可信度。README 亦提到需要設定 API keys,反映它主要係一個開放測試台,方便用不同 agent harness 跑同一批任務,而唔係單機即開即用的終端工具。

同類 benchmark 相比,它的取向唔係追求最少題目下的快速排行,而係強調真實性、技能覆蓋率同冗餘控制。項目一方面收錄真實 B2B fintech use cases,另一方面用 skill-aligned hierarchical clustering 同系統化生成流程補足缺少真實任務的領域,這種做法的代價是建置與維護較重,但換來更完整的比較基線。

  • 覆蓋 15 個領域,包含真實 B2B fintech 任務
  • 提供 tasks、ground-truth、skills 同 results 結構化內容
  • 支援比較不同 agent harness,如 Smolagents、DA-Agent、Claude Code、CodeX
  • 已列出 Qwen3.5-397B-A17B、Kimi-K2.5、Claude Sonnet 4.6 的初步實驗

這個項目最適合做 data agent 研發、模型選型同內部驗證的團隊,也適合研究人員用來檢查代理在哪類 data skills 失分。性能資訊目前以 leaderboard 結果為主,重點不只是 accuracy,仲包括 skill-level insight;相關模型至少包括 Qwen3.5-397B-A17B、Kimi-K2.5 同 Claude Sonnet 4.6。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, Agentic, Qwen, API, Anthropic, Dataset 數據集, Skill 技能

Graph-GRPO:教模型先畫知識圖再作答

這是一個訓練語言模型的開源項目,重點是先整理知識圖,再輸出答案。它想改善純文字推理難以追蹤思路的問題。

Repository image for lamm-mit/graph-preflexor-grpo

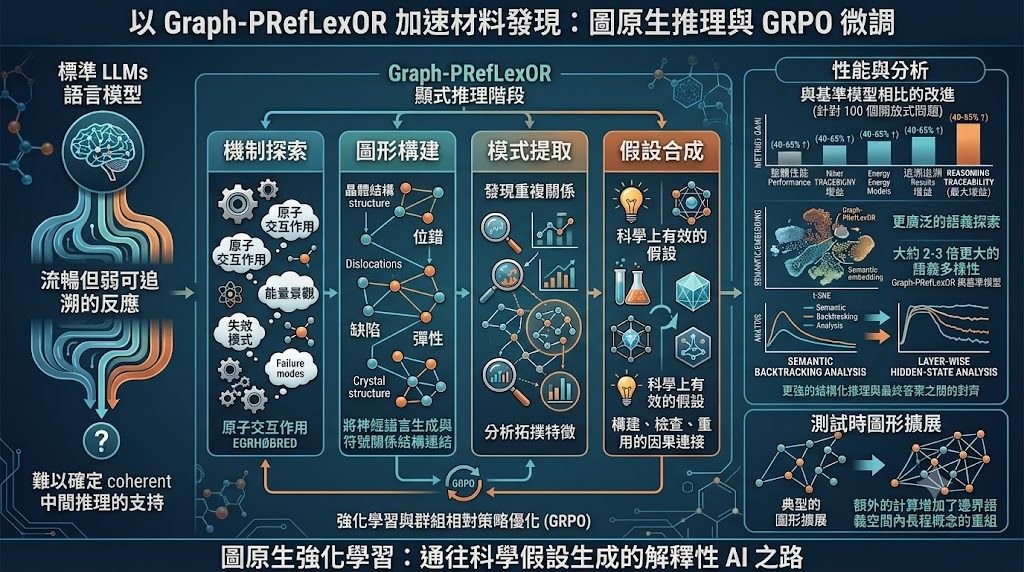
這是一個用來訓練語言模型的推理項目,核心屬於模型訓練流程兼研究原型。它要解決的問題,是模型回答問題時往往只輸出文字結論,推理結構難以檢查;Graph-GRPO 先要求模型把概念、關係與規律整理成 knowledge graph,再整合成答案。

現有做法多數依賴 chain-of-thought 或一般文字式 reasoning,把中間思路寫成自然語言。作者認為這種範式雖然靈活,但節點、因果、約束與抽象規律不易固定表示,因此提出 graph-native 的訓練方式:先用 ORPO(Odds Ratio Preference Optimization)或 SFT(Supervised Fine-Tuning)學格式,再用 Graph-GRPO 做強化學習,直接獎勵正確性、格式完整度與 graph utility。

項目的設計相當明確:節點類型限制為 entity、attribute、process、event、outcome、law、claim,關係亦只保留 12 種 verbs,並用 Pydantic 做結構化解析與 schema validation。這種取向的好處是輸出較易驗證,甚至能自動修補無效 graph;代價是表達自由度較低,未必適合非常開放、需要細膩語氣或鬆散聯想的回應。

部署與理解方式也算清楚,整個流程分成資料生成、run_orpo_graph 或 SFT 訓練,再進入 run_grpo_graph 強化階段,並以 LoRA 疊加在基礎模型上。README 亦提到可透過 OpenAI-compatible endpoint 驅動 ideation engine,把多輪生成的 graph_json 累積成可擴展知識圖,用於創意探索、問題延伸與比較不同前沿模型的表現。

  • 適合想研究可追蹤推理、結構化回答與可驗證中間步驟的團隊
  • 已釋出相關模型,基礎模型包括 Qwen-8B 與 Llama-3.2-3B-Instruct
  • 獎勵設計公開列出 correctness、format、graph utility 三部分權重
  • 亮點不在單純答得快,而在於把 reasoning 過程轉成可檢查的 graph object

在目前提供的內容中的性能不算完整,較明確的是訓練路徑、輸出結構與後續 ideation 用途,而 supporting context 另提到這條路線也延伸到 scientific hypothesis generation。整體來看,這個項目較適合研究型開發者、做 Agentic workflow 的團隊,以及想把 LLM 回答過程由黑盒文字轉成結構化證據鏈的人使用。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 模型訓練, Qwen, OpenAI, API, KnowledgeGraph, LLaMa, Anthropic, Meta, Dataset 數據集

PerceptionRubrics 點出多模態評測盲點

呢個項目用更貼近人類觀感的方式,重新檢查多模態模型有無看錯重點。它唔係再鬥平均分,而係追查關鍵事實有無答錯。

Performance Comparison

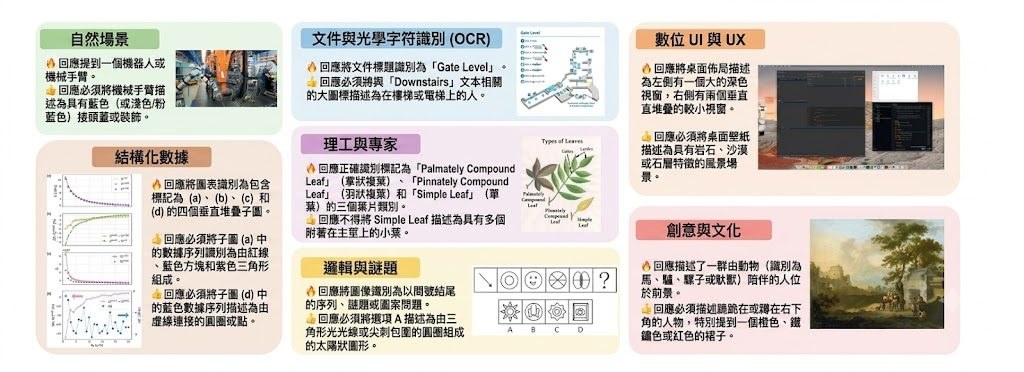
PerceptionRubrics 是一個多模態評測框架兼資料集,主力檢查 Multimodal Large Language Models 是否真正看清圖片內容,而唔係只係在傳統 benchmark 拿到高分。它要解決的問題很直接:現有 caption 評測常用 holistic semantic matching 或平均分,容易把嚴重錯誤沖淡,但人類閱讀結果時,關鍵事實一錯,整體輸出已經未必可信。

作者把舊有範式拆開重做,改用 atomic auditing,把每張圖分解成可核實的細項,再分成 Must-Right 與 Easy-Wrong 兩條 rubric 流。Must-Right 針對必要事實,Easy-Wrong 針對模型常見的細節遺漏、幻覺或誤判;再配合 gated scoring,只要必要視覺事實出錯,就會被明顯扣分,而唔係被其他小分數平均掩蓋。

資料規模方面,項目提供 1,038 張 information-dense images,同超過 10,000 條 instance-specific rubrics,來源是用 Circular Peer-Review 建立的 Golden Captions,再蒸餾成評測規則。覆蓋範圍包括 natural scenes、OCR documents、GUIs、charts、STEM、logic puzzles 同 creative/cultural images,明顯偏向高資訊密度、容易出現感知失真的場景。

測試方式不算複雜:這個 GitHub 儲存庫主要提供 evaluation code 和 data,較適合研究團隊、模型開發者,或者需要比較多個 MLLMs 表現的人,把模型輸出的 captions 對照 rubric 計分。它不是部署給終端用家的應用程式,而是拿來驗證模型在圖像理解任務到底穩不穩;使用前亦要接受一點,這類更嚴格的評分會令模型成績比傳統 leaderboard 更難看,但診斷價值更高。

  • 核心取向是由 holistic semantic matching 轉向 atomic auditing
  • Must-Right 與 Easy-Wrong 直接對應關鍵事實與常犯細錯
  • gated scoring 強調「關鍵錯一項就要反映出來」
  • 資料集中在 GUIs、文件、圖表等高密度視覺任務
  • 適合用來比較 20+ 主流 MLLMs 的感知可靠性,而唔只係比較平均分

項目指出模型經常能辨認零碎元素,卻未能同時滿足多個關鍵視覺約束,尤其在 GUIs、documents 同 structured charts 更明顯。README 與 supporting context 亦提到曾評測 20+ 主流 MLLMs,包括 GPT-5.5;不過這個儲存庫重點仍然是評測框架本身,而唔係推出新模型,所以較值得留意的是它怎樣暴露 perception brittleness,而不是單一排行榜名次。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 多模態模型, Qwen, OpenAI, DeepSeek, Gemini, Dataset 數據集

ABot-M0 用 600 萬軌跡訓練機械人操作

ABot-M0 是面向機械人操作的 VLA foundation model,結合大型資料與新動作學習方法。它重點解決機械人資料分散、控制不穩定和跨任務泛化問題。

ABot-M0 model overview

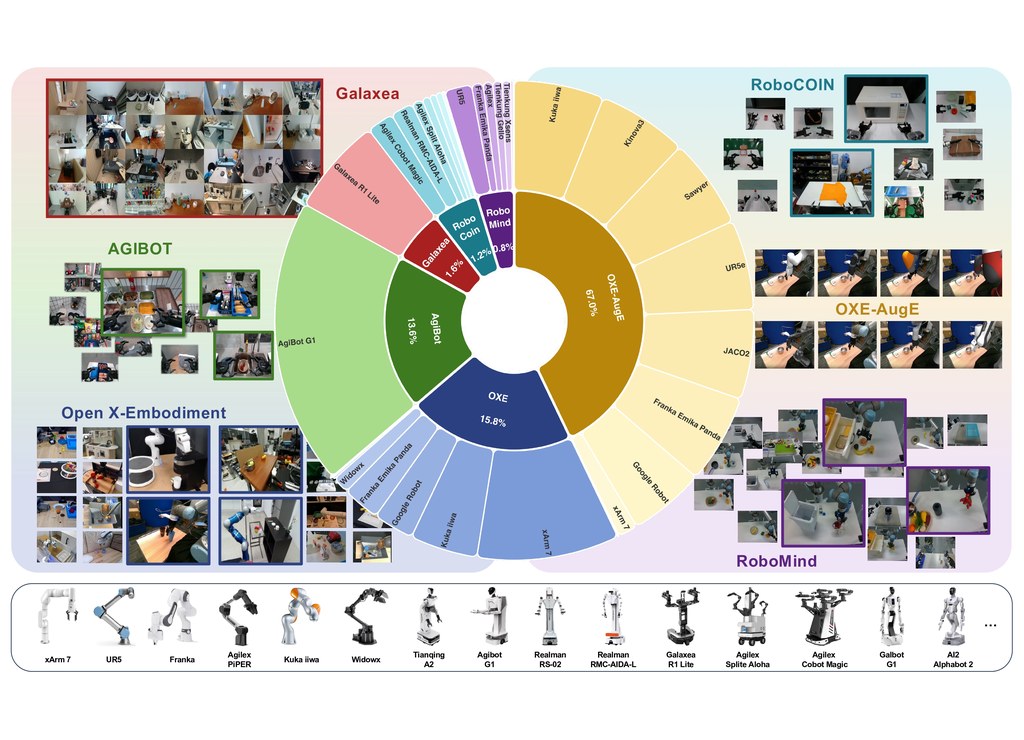
這是一個面向機械人操作的 Vision-Language-Action(VLA)foundation model,名為 ABot-M0。它主要用來讓機械人根據視覺與指令完成操作任務,並處理資料分散、動作表示不一致,以及控制模型訓練效率偏低的問題。

ABot-M0 的基礎來自 UniACT-dataset。這個資料集整合 6 個公開資料來源,包含 OXE、OXE-AugE 與 AgiBot-Beta,合共超過 600 萬條 trajectories、9,500 小時以上互動資料,並覆蓋 20 多種機械人形態;資料亦經過清理、標準化與統一,將動作轉成 end-effector 座標系中的 delta actions,旋轉則採用較穩定的 rotation vector 表示。

它和常見 diffusion 式控制方法的主要差異,在於採用 Action Manifold Learning(AML)。一般 diffusion model 多數學習預測 noise,ABot-M0 則直接做 Direct Action Prediction(a-prediction),輸出乾淨的動作序列;這種做法把學習重點由「擬合噪聲」轉成「投影到可行動作流形」,理論上更有效率,也更有助提升解碼速度與 policy stability。

另一個實用方向是模組化 3D perception。ABot-M0 支援 plug-and-play 模組去加強 3D 空間理解,對涉及精準位置、姿態與複雜操作步驟的任務會更有幫助;同時,它亦用「pad-to-dual」策略統一 single-arm 與 dual-arm 任務,令同一模型可覆蓋更廣的操作場景。

  • 整合超過 600 萬條 trajectories,資料規模相當大
  • 以 UniACT-dataset 統一不同來源與不同機械人表示方式
  • 採用 Action Manifold Learning(AML),直接預測動作而非噪聲
  • 支援 plug-and-play 3D perception 模組,提升複雜任務精度
  • 適合關注 robotic manipulation、VLA 與通用機械人控制的讀者

現有資料重點放在方法設計與資料規模,具體基準分數與完整比較結果在這份內容中未完全展開。即使如此,ABot-M0 已清楚展示一條很具代表性的路線:先用大規模統一資料打底,再用更貼近可行動作結構的學習方式,提升機械人操作模型的泛化與穩定性。

項目主頁

Categories: 開源, 模型, 視覺模型, 多模態模型, VLA, Robotic, 3D, Dataset 數據集

Page 24 of 29
1 … 22 23 24 25 26 … 29