EdgeBench 用 134 個長任務量度智能體成長

模型識幾多,未必等於學得幾快。EdgeBench想回答的,是智能體在真實環境中隨時間互動後,能力會怎樣上升。

ligo gw

跑一次就評分的基準,通常只能看出模型本身已經識乜;EdgeBench關注的是另一件事:當智能體放進接近真實工作的環境,連續做十幾個鐘、接收回饋再反覆修正,它究竟會唔會愈做愈好。這是一個研究 environment learning 的 benchmark,核心問題不是單次答對率,而是學習曲線能否反映長時間互動後的能力變化。

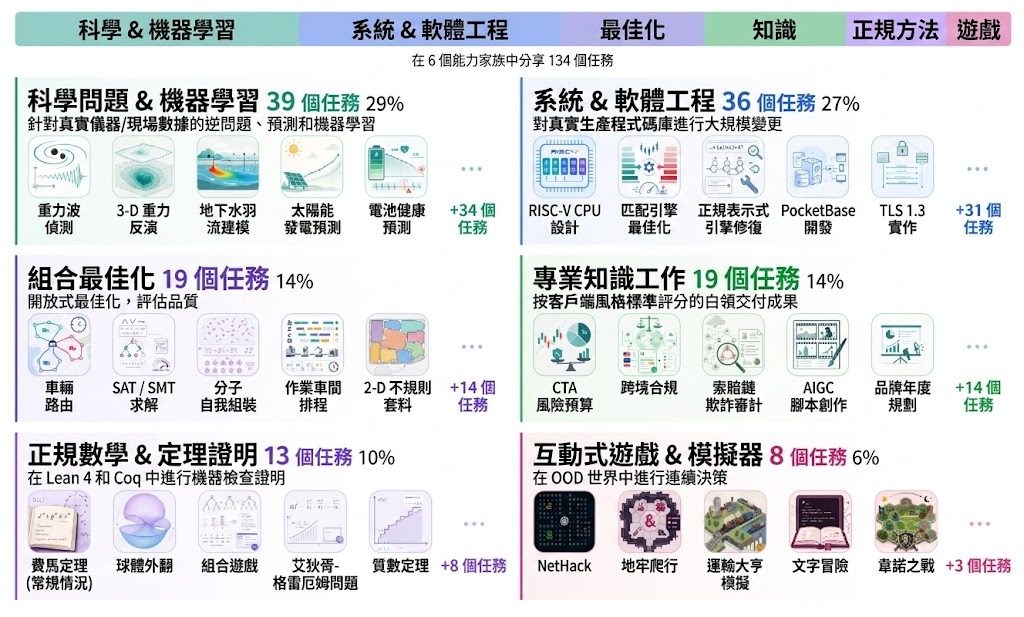
它把 134 個任務分成六大類,包括科學與機器學習、系統與軟件工程、組合最佳化、知識工作、形式數學同遊戲,而且每個任務最少運行 12 小時,部分延伸到 72 小時以上。這個設計接近真實工作流,因為智能體需要面對 build logs、test failures、objective values、simulator traces、實驗誤差等回饋,而唔係只靠一次生成結果交卷。

同常見 benchmark 相比,EdgeBench的差異在於它量度「隨經驗累積而改善」的能力。研究者指出,多個模型在 134 個任務上的整體表現,都可用 log-sigmoid function 擬合,R²約為 0.997 至 0.999,表示 environment interaction time 與表現提升之間有相當穩定的關係。這令它不只是一張排行榜,也是一個用來觀察 scaling laws of environment learning 的分析工具。

  • 覆蓋 134 個真實世界長時任務,重點放在學習速度與上限
  • 任務橫跨科學、編程、最佳化、知識工作、數學與遊戲
  • 每項任務持續 12 小時以上,部分超過 72 小時
  • 回饋訊號來自接近真實工作的執行環境,而非單次靜態題目
  • 整體學習曲線可用 log-sigmoid function 高精度擬合

這套 benchmark 對做 Agentic 項目、長流程自動化、程式代理與研究型智能體的人最有參考價值,因為它直接呈現模型在長時間任務中的耐力、修正能力與邊做邊學的幅度。現有資料集中在 benchmark 設計、任務結構、資料集與分析結果,未提供具體安裝步驟或完整使用流程;能確定的是,這個項目由 ByteDance Seed 發表,並附有 Paper、GitHub 與 Dataset 入口。
項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, Agentic, 模型訓練, DeepSeek, 框架, 軟件, 編程, Anthropic, Dataset 數據集

Deform360 補上可變形物體世界模型短板

做布料、繩索、海綿這類可變形物體研究,最缺的往往不是模型,而是夠完整的真實數據。Deform360把多視角影像、觸覺與3D標註放在同一套資料流程內,定位相當清晰。

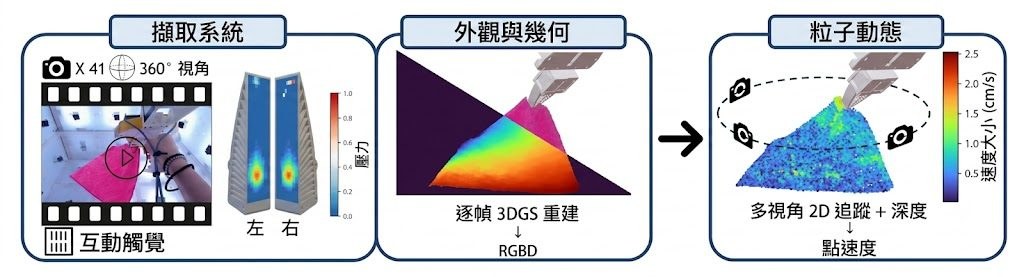
Deform360: per-frame 3D reconstruction alongside 360-degree multi-view capture.

一遇到布料、線材或柔軟玩具,很多世界模型很快就會暴露盲點:畫面看得到表面變化,卻未必掌握形變本身。Deform360屬於Dataset 數據集項目,集中處理的正是可變形物體研究長期缺少的真實多模態資料,讓2D video world models與3D particle world models可以放在同一基準下比較。

它的吸引力不只在於量大,還在於資料結構相當完整。項目收錄198件日常可變形物體、1,980段機械人互動、215.7小時累積錄製內容,配合41部同步720p RGB相機做360°拍攝,另有雙手UMI-based tactile grippers的四組16×32觸覺串流。對研究團隊來說,這代表不只是「有影片可看」,而是可以對齊視覺、觸覺、相機幾何與3D粒子標註去做分析。

跟不少只提供單視角影片、少量物件,或者只放最終標註的資料集相比,Deform360更重視重建與對齊流程。作者採用markerless visuotactile tracking pipeline,把ArUco calibration、3D Gaussian Splatting、CoTracker3與physics-informed refinement串起來,目的不是包裝成一鍵訓練工具,而是把可重用的資料契約、幾何工具、annotation I/O與multimodal alignment utilities公開。

  • 針對198件可變形物體,涵蓋多視角影像、觸覺與dense 3D particle annotations
  • 適合比較2D video world models與3D particle world models在真實形變上的差異
  • GitHub 目前主要釋出資料存取、preprocessing、geometry與對齊工具
  • 未附world-model baselines、training code、pretrained checkpoints或一鍵端到端流程

部署與測試的理解方式也要先講清楚:這不是拿來即刻訓練完整模型的全包框架。現有儲存庫提供Python 3.10以上的安裝入口,並連到 Hugging Face 資料集;你可以把它當成研究資料管線與讀取工具,用來下載資料、做相機去畸變、處理觸覺對齊、載入標註與幾何資訊。原始資料沒有提供完整基線訓練流程,因此較適合已有world model、tracking或robot learning流程的團隊接入。

性能方面,項目頁面有交代基準結論:ParticleFormer在held-out episodes預測較好,pretrained Cosmos在unseen objects的視覺指標領先,但可能偏離指令動作。這種結果也反映Deform360的價值不在於替某一類模型背書,而是把可變形動態、視覺觀測與觸覺證據放回同一個較公平的測試場。相關模型與方法脈絡包括2D video world models、3D particle world models、ParticleFormer、Cosmos,以及資料製備中用到的 CoTracker3 與 3D Gaussian Splatting。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 世界模型, 模型訓練, Video, Robotic, 3D, Python, Dataset 數據集

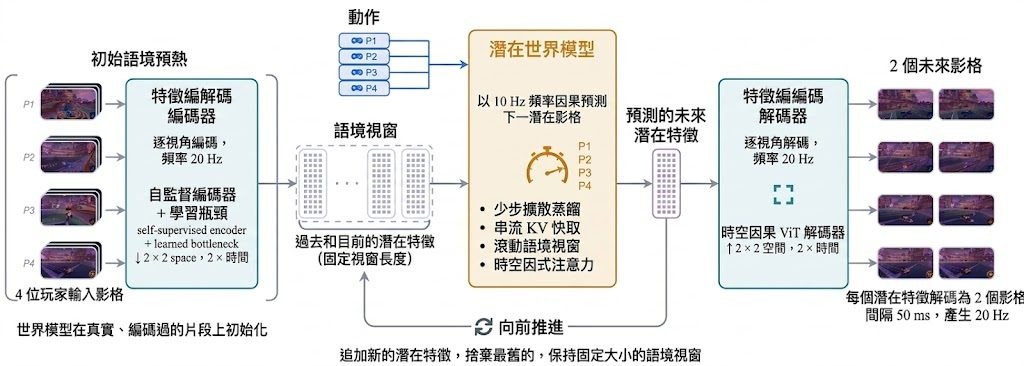
MIRA 把《Rocket League》變成可互動世界模型

MIRA 唔係單純重播比賽片段,而係讓四名玩家動作一齊驅動畫面生成。你可以把它理解成一個能即時模擬 2v2 對戰走勢的世界模型研究項目。

Repository image for mira-wm/mira

打機畫面一路變化,背後又有四名玩家同時輸入動作,呢類情境一向好難靠 world model 穩定重建。MIRA 屬於開源框架兼研究型模型項目,處理的是多人互動環境中,如何按四條 action streams 即時生成《Rocket League》對戰畫面,令 2v2 比賽可以直接在模型內運行。

現有做法多數集中在 single-player world models,其他角色通常只被當成環境一部分;作者明確反對呢種 fixed framing,因為多人場景入面,畫面變化要分得清楚邊個玩家造成。MIRA 改用 multiplayer conditioning,並配合 Representation Autoencoders 同 latent diffusion,目標唔只係畫面似真,而係令物理互動、攻守切換同多角色行為保持連貫。

個項目的取向相當鮮明:它唔係先追求最輕量部署,而係用 5B parameters 模型換取即時互動與長時間 rollout 穩定性。資料來自 10,000 小時 gameplay,README 亦公開了 RocketScienceDataset,當中每個 sample 都包含四個同步視角、逐格 keyboard action 同 game state,對做世界模型、VLA 或互動模擬研究的團隊都很有參考價值。

  • 屬於開源框架加世界模型研究項目,重點是部署、資料使用與評估多人互動生成
  • 與單人 world model 最大分別,在於同時按四名玩家動作生成畫面,而唔係把其他玩家當背景擾動
  • 官方指出模型可在單張 NVIDIA B200 GPU 上以 20 FPS 生成完整 2v2 對戰
  • 相關資料集 rocket-science 提供同步視角、動作與 game state,方便重做測試與分析
  • README 提供 pixi 環境安裝與 test suite 入口,但更完整部署細節仍要靠原始程式與技術報告配合理解

就公開結果看,MIRA 最有說服力的地方唔係單一 benchmark 數字,而係它把「多人動作歸因」變成核心問題,再補上對物理理解的 targeted evaluations。官方亦表示,雖然模型只用短片段訓練,distributional quality 可維持到五分鐘量測範圍,實驗中甚至能持續更長時間;不過硬件門檻高,定位更接近前沿研究平台,而唔係一般人可隨手在本地執行的輕量工具。

項目主頁 · GitHub · Paper

Categories: 開源, 世界模型, NVIDIA, Gemini, VLA, Dataset 數據集

InternVLA-A1.5:機械人策略一體化新路線

想像同一個模型既睇得明畫面與指令,又會預想下一步場景,再直接輸出動作。InternVLA-A1.5吸引之處,正正在於它把這三件事收在同一套機械人政策裡。

InternVLA-A1.5 teaser

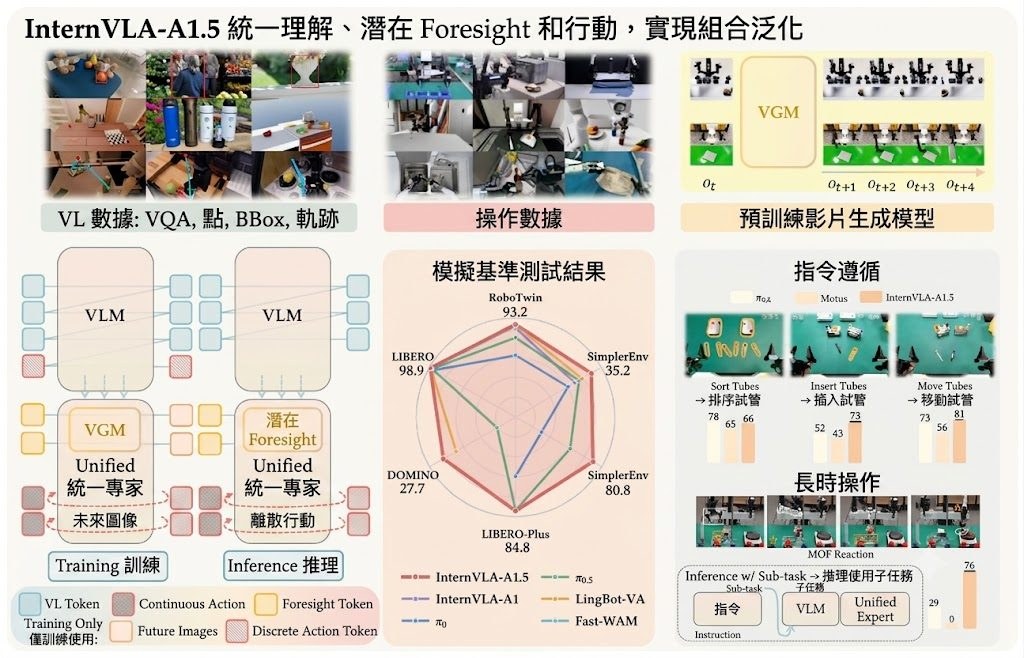
機械人操作最麻煩的地方,往往不是單純辨認畫面,而是要同時理解指令、估計接下來會發生什麼,再穩定地做出連續動作。InternVLA-A1.5屬於開源框架兼機械人政策模型,焦點放在把 vision-language understanding、latent visual foresight 與 action generation 合併,減少多模組串接帶來的延遲與協調成本。

它的取向很清楚:不少做法會把感知、未來預測、控制分開訓練或分開部署,InternVLA-A1.5則把 foresight 放進同一條政策路徑,在訓練期間借助凍結的 WAN2.2-5B video generation model 提供未來動態監督,但推理時丟棄 video branch,只保留動作預測。這個設計的好處是保住「先想一步」的能力,同時避免部署到真實機械人時推理太重。

模型骨幹建基於 Qwen3.5-2B VLM,透過 shared full-attention layers 接上一個輕量 unified action expert,並保留 modality-specific Gated DeltaNet processing;動作輸出則用 flow matching 預測 continuous action chunks。README 亦提到它可用於部署、數據收集和評估真實機器人上訓練有素的操作策略,但公開資訊較集中在模型與 benchmark,具體安裝流程與真機部署步驟未見完整展開。

  • 舊路線常把理解、預測、控制拆開,這個項目改為單一 policy 統一處理
  • 訓練用 WAN2.2-5B 學未來動態,推理時移除相關分支,換取較實際延遲
  • 已在 LeRobot V2.1 dataset 微調,亦結合大規模機械人與多模態資料
  • 基準成績突出:RoboTwin 2.0 為 93.2,LIBERO 為 98.9,LIBERO-Plus 為 84.8
  • 可取得的相關模型包括 InternVLA-A1.5-base、InternVLA-A1.5-RoboTwin、InternVLA-A1.5-Libero

從定位來看,它較適合想把研究原型推近真機驗證的團隊,尤其是同時重視語言理解、視覺泛化與操作成功率的人。現階段最值得留意的,不只是分數高,而是它示範了一種更接近完整機械人工作流的整合方式;限制則是公開說明仍偏研究導向,真正落地前仍需自行補足部署細節與硬件整合資訊。

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, 視覺模型, 多模態模型, 視頻模型, Qwen, Video, VLA, Robotic, Dataset 數據集

LLM-as-a-Verifier 點樣重寫代理評分

當代理唔只要答得啱,仲要一步步做得穩,粗略打分已經唔夠。LLM-as-a-Verifier把評估拆細,令挑選、追蹤同訓練都更有依據。

LLM-as-a-Verifier

代理系統最常見的瓶頸,唔係生成唔到答案,而係你難以知道它每一步到底做得幾好。LLM-as-a-Verifier屬於開源框架,針對的正是呢個問題:它唔只為最終結果打一次分,而係用更細緻的方式為候選答案、行動步驟同任務準則提供可量化回饋。

現有做法不少仍然依賴單次判斷、粗粒度分數,或者只看最終成敗;作者認為呢種固定範式會忽略不確定性,亦難以支援 progress tracking 同 reinforcement learning。LLM-as-a-Verifier改用三個核心設計重組驗證流程:score granularity、repeated evaluation 同 criteria decomposition,並且直接對 LLM score tokens 的完整 logprob distribution 取期望值,而唔係只取單一輸出。

呢個取向令它同一般 judge-style 評分器有明顯分野。它重點唔在於產生一句評語,而係產生可反覆比較、可分解、可累積的 fine-grained feedback,所以可以用於 Best-of-N selection、pairwise compare,同埋逐步追蹤代理行為變化。README 亦展示了 Python 套件 llm-verifier 的基本用法;安裝方式有提供,但更完整的部署細節主要放在官方文件,而某些流程亦需要 VERTEX_API_KEY 或可回傳 logprobs 的 OpenAI-compatible server。

  • 支援任何 modality 的驗證框架,定位比單一 benchmark judge 更廣
  • 方法核心是細粒度評分、重複驗證、按 criteria 拆解準則
  • 可直接用於 selection、compare、track,同時連到 reinforcement learning
  • 官方列出 Terminal-Bench V2、SWE-Bench Verified、MedAgentBench、RoboRewardBench 等結果
  • 相關模型與服務包括 Qwen/Qwen3.5-9B、Qwen3-8B、Gemini 2.5 Pro,以及 OpenAI-compatible server

表現上,項目聲稱在多個 agentic benchmarks 達到 state-of-the-art,包括 Terminal-Bench V2 86.5%、SWE-Bench Verified 78.2%、RoboRewardBench 87.4%、MedAgentBench 73.3%,亦提到在 LIBERO 配合 SAC 微調 pi 0 policy 時,sample efficiency 約高 1.8 倍。呢類數字反映它較適合研究團隊、代理平台開發者,同埋想將評估訊號接入訓練迴路的人;單純只想要一個最終分數的團隊,未必需要用到它整套驗證尺度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, NVIDIA, OpenAI, Gemini, Medical醫學, Python, Anthropic, Dataset 數據集

EVA-Client 補上真實機械人部署斷層

訓練好嘅操作策略,去到真實機械人往往先開始出現混亂。EVA-Client想處理嘅,正正係部署、記錄同評測之間長期分散嘅那段流程。

EVA-Client Logo

研究團隊把模型訓練做得愈來愈完整,但一到真實機械人落地,常見情況仍然是靠零散 script、臨時橋接同各自為政嘅除錯流程撐住。EVA-Client屬於開源框架,集中處理已訓練操作策略喺真機部署、數據收集與評估之間嘅斷層,重點唔係再訓練一個新模型,而係令整個閉環更可重用。

它同一般只覆蓋單一步驟嘅工具唔同,將 transport、policy backend 同 inference strategy 放入同一套流程,支援 ROS1、ROS2、ZeroMQ 同 offline dataset,也能接 OpenPI、OpenPI-RTC、StarVLA、GR00T、mock、replay。作者明顯想修正「訓練框架成熟,但真機端仍然拼裝化」呢種既有範式,所以瀏覽器內直接整合 debug、部署、錄製、重播同比較,定位相當鮮明。

使用路徑方面,現有資料已交代可以用 .py config 串接機械人通訊、策略後端與推理策略,再透過介面喺 DEBUG、COLLECT、RESULT 分頁切換;不過完整安裝細節仍然要配合官方文件先夠穩陣。資料收集亦唔止錄影,還會保存 camera video、3D URDF scene、state charts、milestone scores,同步回放亦保留 QC PASS/FAIL 與每幀品質旗標,對做 dataset 整理同失敗分析幫助幾大。

  • 把部署、收數同評測放入同一個 browser workflow,減少真機迭代時來回切換工具
  • 支援多種 transport、backend 同 inference strategy,取向偏向兼容不同機械人與策略棧
  • 內建 live latency compensation、async strategy 同 replay,重點放喺真機穩定度而唔只係跑通
  • Teleop demos 與 model rollouts 共用同一套 on-disk layout,方便後續整理成 LeRobot v2.1 episodes

性能數字方面,現有資訊未見統一 benchmark 分數,較多是能力與流程層面的描述,所以暫時唔適合把它理解成用單一指標決勝負嘅項目。較受惠嘅會是做 VLA、VAM、WAM 或機械人操作研究嘅團隊,尤其要頻繁比較 checkpoint、遠端連 policy server、或者同時管理多款真機平台嘅場景;已列出可配合嘅相關模型與系統包括 OpenPI、OpenPI-RTC、StarVLA、GR00T,以及 LeRobot、VLA Foundry 呢類訓練側框架。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, NVIDIA, DeepSeek, Video, VLA, 3D, Dataset 數據集

speaker_disentangled_hubert:用 HuBERT 重新做好音節切分

語音切成音節,難處往往唔係分段本身,而係模型好易記住講者聲線。speaker_disentangled_hubert 針對呢個偏差落手,令 token 更接近語言內容。

Repository image for ryota-komatsu/speaker_disentangled_hubert

做語音 tokenization,最麻煩的情況往往不是音節邊界找不到,而是模型把講者特徵一併學進去,最後分出來的 token 混雜了聲線而不是語言內容。speaker_disentangled_hubert 屬於語音模型項目,核心工作是把原始語音整理成較純淨的 syllabic token,讓後續的 speech language model 更容易學到句法與語意。

現有做法多數沿用 pretrained HuBERT 的 teacher-student distillation,再用 utterance-level cross-entropy 目標去組織 frame 表徵;作者認為這種 fixed 範式會令學生模型偏向預測 speaker identity。這個項目改用 Speaker-Disentangled Chunk-Wise Regression for Syllabic Tokenization,在 fixed-length chunks 內,將加入 speaker 擾動的 student representations 拉回乾淨的 teacher targets,重點不是再加更多標籤,而是直接削弱講者資訊對音節切分的干擾。

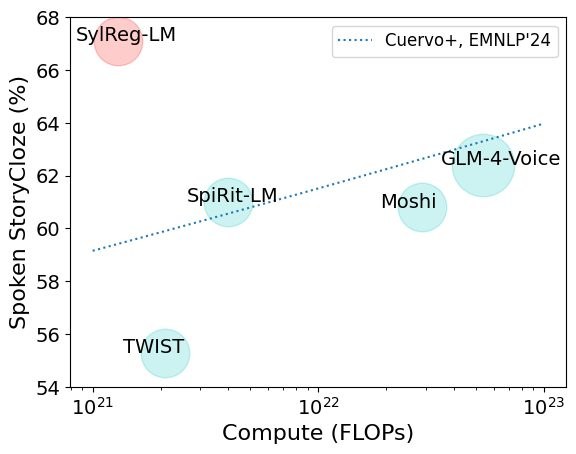
從結果來看,它的取向相當明確:寧願把訓練設計做得更細,也要換取更乾淨的 syllabic segments。論文指出,這套方法在 syllable boundary detection 與 syllabic segment clustering 都做到 state-of-the-art;再往下接 speech language model,基於這批 syllabic tokens 的模型,對比 phone-level SpiRit-LM,在 syntactic and semantic understanding 取得 7% relative improvement。對研究語音表示學習、低資源語音建模,或者想把離散語音單位接到語言模型的人,這個方向幾有參考價值。

  • 針對 HuBERT teacher-student distillation 容易混入 speaker identity 的問題
  • 用 chunk-wise regression 取代單純 utterance-level cross-entropy 訓練邏輯
  • 任務焦點包括 syllable boundary detection 與 syllabic segment clustering
  • 相關脈絡涵蓋 pretrained HuBERT、speech language model,以及 phone-level SpiRit-LM

測試與理解方式亦算直接:項目提供 Paper、Code、Model 與網頁上的 resynthesis samples、syllable segmentation 示例,先聽重建語音,再看音節分段,已經可以判斷 tokenization 有沒有保住語言結構。現有資訊未完整列出部署流程與安裝細節,所以較適合作為研究型項目閱讀、重現與比較;使用時也要留意,它的驗證主要建基於 LibriSpeech,跨語者以外的語種、錄音條件與資料分佈,仍然值得再做額外確認。

項目主頁 · GitHub · Paper

Categories: 開源, 語音, Dataset 數據集

GigaWorld-1:機械人世界模型開源路線圖

GigaWorld-1 不只是模型,亦是一套圍繞機械人世界模型的訓練與推理流程。它的重點是用模擬 rollout 協助評估 robot policy。

GigaWorld-1 Teaser

GigaWorld-1 是一個面向 robot world models 的開源工具鏈與研究原型。它主要用來訓練、推理、處理資料,並把世界模型當成 robot policy evaluation 的替代評估器,減少每次都要落真機做 rollout 的成本。

現有做法通常依賴真實機械人測試,或者用偏重短片畫質的 video world models 觀察結果;作者認為這種範式未必足夠反映 policy 是否可靠,因為短期視覺真實感不等於長時序、動作一致的 rollout 準確度。這個項目連同 WMBench 一齊提出較清晰的評測框架,重點放在 long-horizon、action-faithful rollout consistency,而不是只看畫面似唔似真。

和一般只放模型權重的 GitHub 項目相比,GigaWorld-1 較完整地公開了訓練、inference、資料處理、checkpoint conversion 及 LoRA merge 流程,取向明顯偏向可重現與可擴充。基礎模型亦不是由零開始孤立建立,而是結合 Wan、Diffusers、Helios、Genesis 等元件,反映它更像一條可調整的工作流程,而不只是單一模型展示。

  • 重點不在短期畫面好看,而在 rollout 是否長時間維持動作一致性
  • 提供 training、inference、data processing、checkpoint conversion、LoRA merge 等完整流程
  • 相關模型與元件包括 Wan、Diffusers、Helios、Genesis
  • 配套有 ToyDataset、CVPR 2026 WorldModel Track Dataset 與 WMBench benchmark

部署思路相對明確:環境以 Python 3.10+、PyTorch 2.x、Linux 為主,再按 README 準備資料、模型與推理流程;需要下載模型或資料時,亦已有獨立工具說明。硬件需求未算輕量,但首頁提到 1.3B / 5B 變體與低於 24GB 記憶體的生成設定,代表它並非只面向超大規模研究機構。

較適合受益的群體,是做 embodied AI、robotics、world model research 的團隊,以及想建立 policy evaluator 管線的人。現有資訊顯示它背後有 12,000+ 小時訓練影片、324,000+ 模擬 rollout 配對真機執行,以及 7 類 video world models、4 種 action representations 的比較;這些數字未必等於任何場景都會即插即用,但足以說明它的價值在於提供一套有 benchmark 支撐的評估方法,而不只是再多一個生成模型。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 世界模型, 模型訓練, Video, VLA, Robotic, 框架, Linux, Python, Dataset 數據集

微軟 ResearchStudio:AI 助你研究你的方案

微軟開源一套研究輔助技能組,覆蓋從模糊方向到論文發表的全流程,並以 ICLR、ICML、NeurIPS 論文集訓練出可追溯的構思模式。

logo

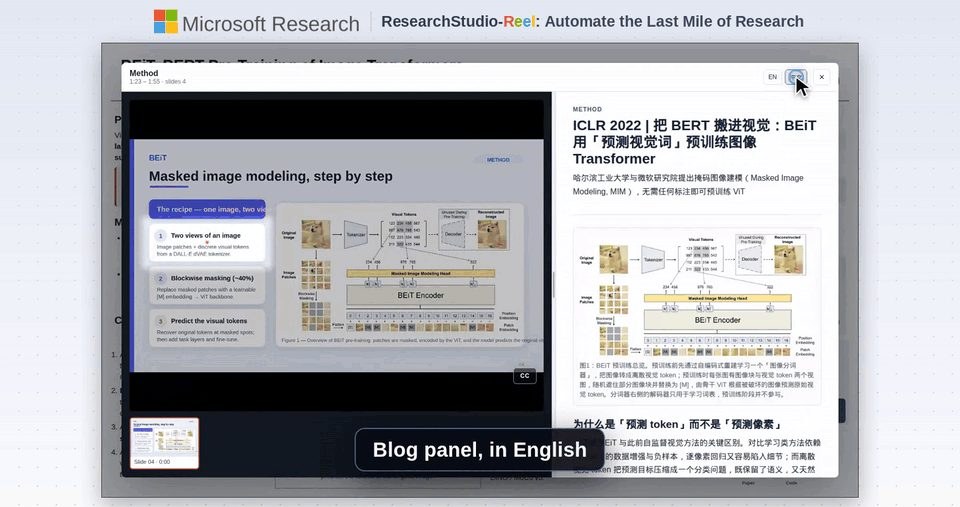
ResearchStudio 的核心任務是把大型語言模型(Large Language Model, LLM)變成研究流程中的協作角色,從構思、文獻搜尋到成稿後的展示素材皆涵蓋在內。它由兩個互補的子項目組成:ResearchStudio-Idea 處理「論文前」階段,協助將尚未成形的研究方向轉化為可辯護的構想;ResearchStudio-Reel 則處理「論文後」階段,把已完成的 PDF 轉成海報、旁白影片、雙語部落格文章及互動式摘要頁面。

傳統的 LLM 輔助構思多半只停留在「生成候選題目」這一層,研究人員仍須自行補上文獻脈絡、辨識瓶頸、區隔既有方案並評估風險。ResearchStudio-Idea 對此提出的修正做法,是從 2021 至 2025 年間 ICLR、ICML、NeurIPS 共 1,947 篇論文中歸納出 31 個反覆出現的構思子模式,再收斂成 15 個可重用的構思模式(ideation patterns),每張模式卡都附帶研究脈絡、瓶頸類型、差異化策略、支援先例與常見失敗模式。這樣的設計讓 IdeaSpark 能以「證據整備度評估 → 脈絡重建 → 瓶頸辨識 → 模式選擇 → 候選生成 → 衝突檢索 → 結果導向稽核」七個步驟,把抽象模式轉化為可追溯的研究提案。

套件內另外兩個獨立技能 Paper-Search 與 Scoop-Check 分別負責多源文獻搜尋與新穎性碰撞檢查,讓構思過程中對「現有方法如何做」與「作者為何不同」這類對比能即時取得佐證。和坊間通用寫作助手相比,ResearchStudio 的差異在於把會議投稿結果(包含口頭報告、高引用子集與被拒稿件)當作訓練素材,使生成的構想能對照真實的審稿標準。技能以 Claude Code 與 Codex 為執行環境,透過 install.sh 即可建立符號連結並完成環境配置。

適合的對象包括需要快速整理文獻的研究生、準備投稿 ML 會議的團隊,以及希望把既有論文包裝成海報或短片的學術機構。對會議投稿文化熟悉的讀者會更容易判斷模式卡的適用邊界;而非 ML 領域的使用者則可借鏡其「以證據為基礎的構思流程」這套方法論。兩篇 arXiv 論文(Idea: 2607.04439、Reel: 2607.04438)分別詳述技術細節與評估方式,值得在採用前先行閱讀。

重點摘要:

  • 全流程覆蓋:從模糊研究方向到論文發表後素材生成,由 Idea 與 Reel 兩個子項目分工處理。
  • 基於會議資料的模式庫:以 1,947 篇 ICLR、ICML、NeurIPS 論文歸納出 15 個可重用的構思模式。
  • 可追溯的構思步驟:七階段工作流程將抽象模式轉為具備文獻佐證的研究提案。
  • 獨立技能模組化:Paper-Search 與 Scoop-Check 可單獨用於文獻搜尋與新穎性檢查。
  • 依賴 Claude Code 與 Codex:需在這兩種 AI 編碼環境中執行,門檻偏向熟悉 LLM 工具鏈的研究者。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 微軟, 框架, Dataset 數據集

TasteGap:量度人類與 LLM 的 Research Taste

這是一套研究構思評測工具,用來比較人類與 LLM 想法分佈有幾唔同。它唔係只看新穎度,而是追蹤研究口味偏向。

Repository image for ziyuuc/TasteGap

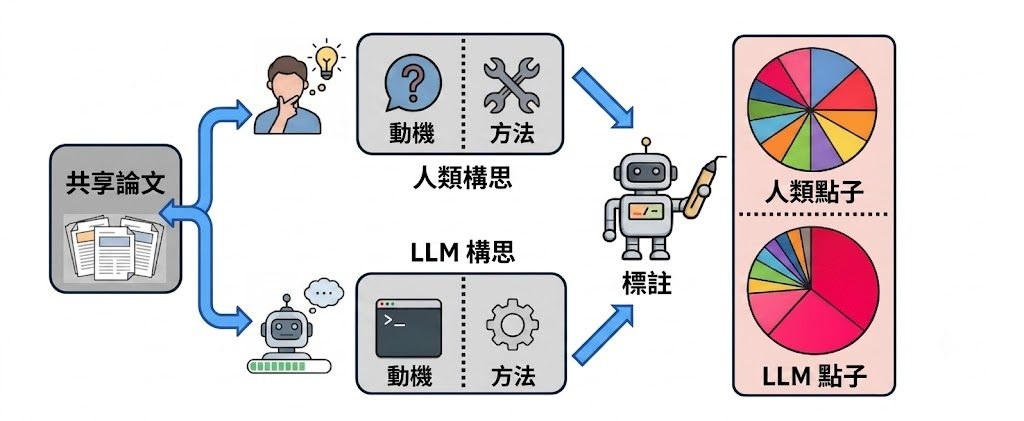
TasteGap 是一個研究評測工具與研究原型,核心工作是比較人類研究者與 Large Language Models(LLMs)生成研究構思之間的差距。它並非處理單篇提案好唔好,而是同一批文獻背景下,人類與模型會傾向提出邊類動機、邊類方法,從而量度所謂 research taste。

現有做法多數用 novelty、feasibility 或專家偏好去評分單個 idea,作者認為呢種固定範式只能判斷「像不像好主意」,但未必見到分佈偏差。TasteGap 改用 shared literature context:先從高質論文反推一組可能啟發該論文的 related works,再要求 LLM 從相同材料生成新 idea,之後用 two-axis research-taste taxonomy,分別標註 motivation 同 method,對比 human ideas 與 LLM ideas 的整體分佈。

GitHub 儲存庫目前提供 evaluation code,而唔係完整訓練框架。安裝理解上相當直接:準備 Python 依賴、設定 config.json 內的 generation 與 labeling 模型、填入 OpenAI 或兼容 API 端點,再用 JSONL 輸入跑 generate_ideas.py 同 label_research_taste.py;要重現完整資料,則需另外下載 Hugging Face 上的 IdeaSeed。輸入記錄包含 paper title、URL、domain、related works,以及人類參考 proposal 的 motivation 同 method,代表這個項目設計重點是可重跑比較,而唔係單次展示結果。

作者提出的主要判斷幾清楚:不同 LLM 生成的 idea sets 都出現一致 distributional gap。LLM ideas 較集中在 bridge-like opportunities 同 synthesis methods,人類論文參考分佈就覆蓋更廣,表示模型可以提出合理點子,但研究取向仍然較窄,亦有系統性偏移。

  • 不是一般 brainstorming 工具,而是用來量度 ideation 分佈差異的評測項目
  • 保留 human ideation 與 LLM ideation 在相同文獻脈絡下的可比較性
  • 研究口味以 motivation 與 method 兩條軸線標註,分析角度比單純打分更細
  • GitHub 內容偏向生成與標註流程,完整資料需配合 IdeaSeed dataset
  • 適合做 AI for science、LLM ideation、科研流程研究的團隊作內部基準

TasteGap 沒有綁定相關模型,只要求在 generation 與 labeling 填入可用模型,並支援 OpenAI-compatible endpoint。這種設計方便團隊橫向比較不同 LLM,但現階段儲存庫未提供完整效能表或基準腳本整理頁,因此不算是交付即用型產品。

GitHub · Paper

Categories: 開源, 模型, OpenAI, Gemini, API, 工具, Python, Anthropic, Dataset 數據集

Page 23 of 29
1 … 21 22 23 24 25 … 29