ComfyUI_MiniMaxH3_Director:一次過生成多段影片的導演台

想做長片、多段生成又唔想逐段接節點,這個項目把 MiniMax H3 的分鏡、取樣和輸出收在同一個 ComfyUI 工作流核心。

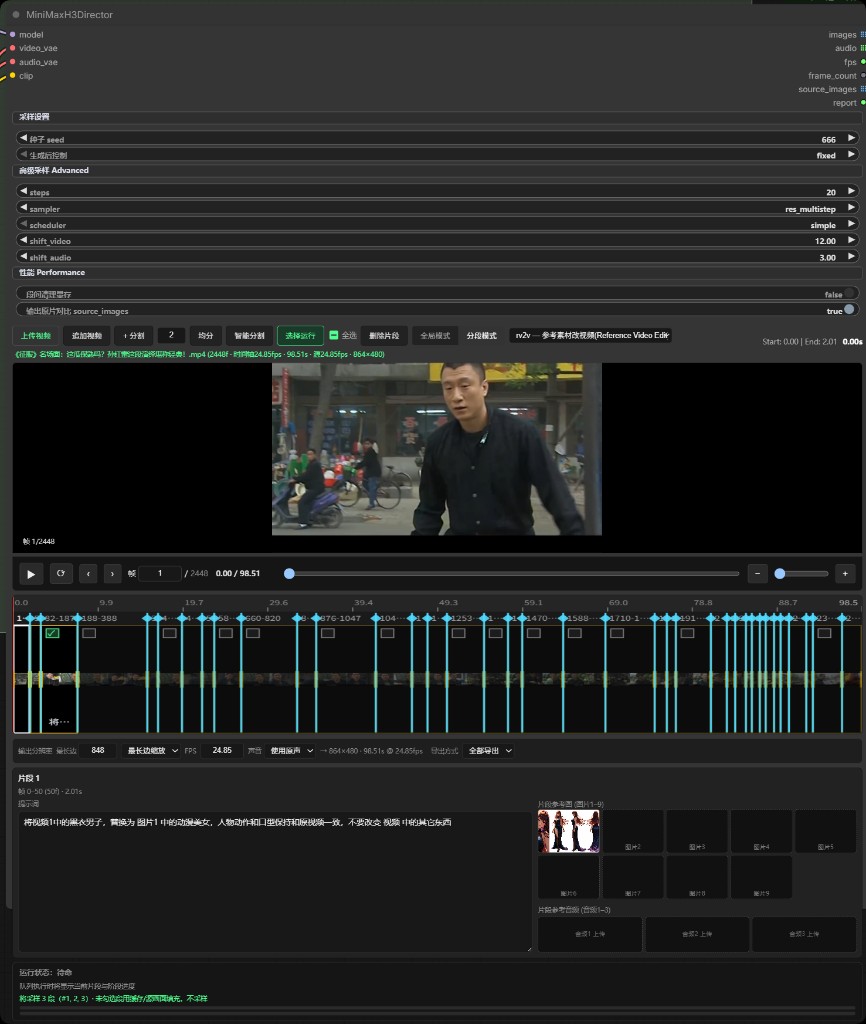
MiniMaxH3Director 工作流截图

做長影片時,最麻煩往往唔係單段生成,而係分鏡、續接、音畫輸出要分開處理。AIMixer/ComfyUI_MiniMaxH3_Director 針對的正是這個卡位:它屬於 ComfyUI 的影片生成節點插件,將 MiniMax H3 的多段規劃、條件編碼、採樣解碼和匯出合併成一個導演台,讓長視頻與多段音視頻生成流程集中管理。

它的價值不只在於把功能堆在一起,而是把幾種常見工作流放進同一個操作面。無論是 t2v、i2v、fl2v、r2v、v2v 還是 rv2v,都可沿用同一套時間軸邏輯;當中首尾幀、參考素材組、源片改寫和選擇性重跑都已經整理好,對需要反覆改段落、補鏡頭或保留原聲的創作者會實用得多。

安裝方式也算直接,前提是 ComfyUI 要升級到 v0.30.0 或以上,並已具備官方 MiniMax H3 支援。之後可用 ComfyUI Manager 透過 Git URL 安裝,或手動放進 custom_nodes,再按需要補上 scenedetect、opencv-python-headless、imageio-ffmpeg 這些依賴;模型權重與示例工作流則需另外下載。要留意的是,CLIP Loader 的 type 必須設為 minimax,而 fl2va / ref2va UNET 亦要按任務類型配對。

跟一般把多個節點逐個串起來的做法相比,這個項目明顯偏向把影片導演流程封裝成一個較完整的工作台,代價是你仍然要跟官方 MiniMax H3 節點規格保持一致,並理解不同模式背後用的是 MiniMaxH3ImageToVideo、MiniMaxH3ReferenceToVideo、MiniMaxH3SigmaShift、KSampler 與 AV 分離解碼鏈路。重點放在長片分段銜接、段間運動延續與原生立體聲輸出,較適合已經在 ComfyUI 內做影片生成、希望減少手動接線和重複操作的團隊。

  • 把多段時間軸、生成、解碼、匯出收進單一節點
  • 支援 t2v、i2v、fl2v、r2v、v2v、rv2v 多種模式
  • 可做選擇性重跑,未勾選片段可用快取或原片填補
  • 依賴官方 MiniMax H3 節點,環境版本與模型配對要設好
  • 原生輸出立體聲音頻,適合長片與多段音視頻工作流

GitHub

Categories: 開源, ComfyUI, MiniMax

MiniMax H3 Turbo:4 步加速的影音生成 LoRA

MiniMax H3 的 ComfyUI 加速 LoRA,把 10 秒影片生成壓到固定 4 步。它適合要在速度、畫質和可控性之間取平衡的 T2V 與 I2V 工作流。

Og image

MiniMax H3 Turbo 走的是 ComfyUI 用途的加速路線,核心價值在於把 MiniMax H3 的文本生成影片(Text-to-Video, T2V)和圖像轉影片(Image-to-Video, I2V)流程固定到 4-step Euler 推理。它不是獨立模型,而是要配合 Comfy-Org/MiniMax-H3 的 BF16 base model 使用;頁面未提供更完整的 base model 參數規模或訓練細節,所以不能再往下猜。

這種設計的取捨很直接:步數少,生成時間通常更短,但對動作細節和穩定性的容錯也會更窄。頁面列出的比較都在同一個 BF16 base model、同一輸入與 10 秒、約 0.9MP 解析度條件下做,LoRA strength 固定 1.0;不同場景下,時間大概落在 174 到 190 秒之間,速度提升存在,但不是壓倒性。

重點摘要:
– 支援 T2V 與 I2V,I2V 走第一幀路徑,亦可用最後一幀收尾
– 固定 4-step Euler,重點是縮短推理流程而非擴大模型能力
– 需要配對 Comfy-Org/MiniMax-H3 的 BF16 base model
– 頁面未列出 GGUF、mmproj、上下文長度或量化檔案資訊
– 與 lightx2v LoRA 的比較屬同級加速方案,差距主要體現在時間與輸出取向

從檔案描述看,這個項目是 LoRA,不是完整 diffusion checkpoint,所以它的定位比較像「推理策略補丁」而不是全新模型。頁面也沒有提供 llama.cpp、Ollama 或 LM Studio 的支援資訊,顯示它主要面向 ComfyUI 工作流,而不是通用本地推理框架。

檔案命名上,頁面強調這是 v2 類型的更新版本脈絡;因此可確認的只有它圍繞 H3 的 joint audio-video diffusion path,並以固定 4 步作為加速契約。若要和原始 base model 比,差別不在功能範圍,而在於把生成速度和步數控制收緊,換取更快的工作流回饋。

模型

Categories: 開源, ComfyUI, 數字人, 視覺模型, 視頻模型, Video, Image, Audio, MiniMax

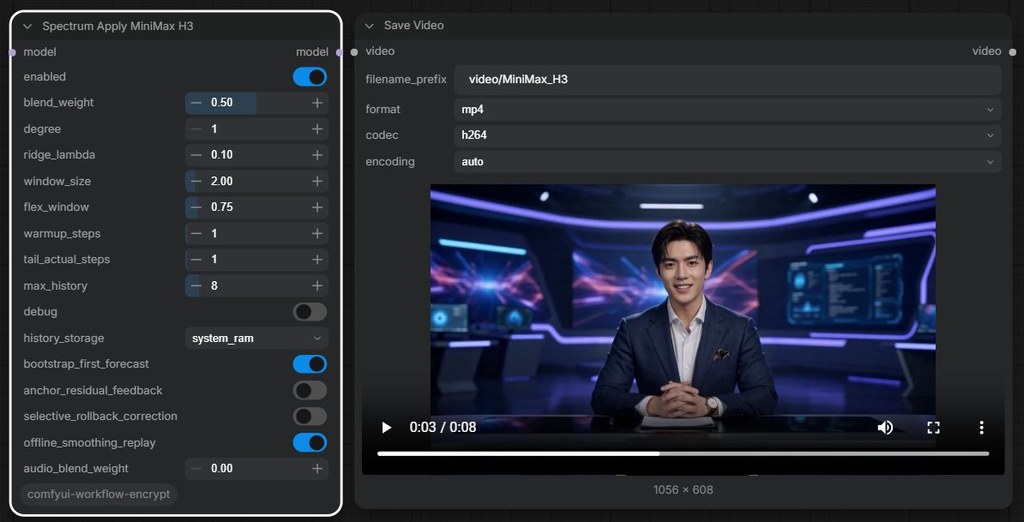
ComfyUI-Spectrum-MiniMax-H3:為 H3 加速 33%

將 1056x608 影片生成由 685 秒縮短至 464 秒,避開昂貴的 transformer 重算。它屬近似加速,但影片細節可能走樣。

Repository image for xmarre/ComfyUI-Spectrum-MiniMax-H3

每次跑 MiniMax H3 都要付出完整 transformer 計算成本,對要反覆試 prompt、鏡頭動作同參考音訊的人來說,等待本身就是工作流瓶頸。xmarre/ComfyUI-Spectrum-MiniMax-H3 針對的正是這一步:它屬於 ComfyUI 自訂節點工具,會在部分 solver steps 直接預測 post-transformer hidden features,減少原生 MiniMax H3 audio-video model 的重計算次數。

實測生成 1056×608 影片由 685 秒縮短至 464 秒。加入這 Node 後可惜仍未能解決「廣東話」問題!

它不是把整個模型 shortcut 掉,而是用 Chebyshev ridge model 去擬合已經算出的 hidden features,再對未來步數作 spectral forecasting;但當前步的 output heads、video reconstruction、audio reconstruction、sigma mapping 同回傳結構仍然照常執行。這個取捨很務實,因為它換到的是抽樣成本下降,不是完全無損加速,所以 README 已經講明輸出不會與原生 MiniMax H3 bit-identical。

作者後來把預設路徑改成 offline_smoothing_replay,核心原因不是追求更高畫質,而是先救回音訊品質。早期單次流程會令語音清晰度、自然度同穩定性下降,甚至出現 doubled syllables 同 stuttering;現時預設把 audio_blend_weight 維持在 0,並以第二次無 transformer 的 replay 處理 video blend,目的就是切斷後段 video-to-audio feedback 對聲音的干擾。不過,畫面軌跡仍可能改變,動作、視線、時間點,甚至眼睛、手指、四肢細節都有機會走樣。

安裝十分簡單,適合願意做 exact-seed A/B 比對的創作者、工作流調校者,或者已經在 ComfyUI 內使用 MiniMax H3 的團隊。README 也提到舊版 workflow 可能要手動開啟 offline_smoothing_replay,而且 broader checkpoints、prompts、samplers 同 reference inputs 仍未完成足夠驗證,現階段更像是一個有方向、有明確修正策略,但仍需按素材類型逐步確認的加速方案。

  • 以 spectral forecasting 預測部分 future solver steps,重點是減少 MiniMax H3 最昂貴的 transformer evaluations。
  • 保留當前步的原生輸出頭與音畫重建流程,因此屬於近似加速,不是無損複製原生結果。
  • 預設改用 offline_smoothing_replay,主要是修正早期版本對語音自然度與穩定性的破壞。
  • 音訊路線暫時較保守,但視覺結果仍可能出現 motion、pose 與細節結構偏移。
  • 較適合已在 ComfyUI 工作流內做反覆測試、願意接受 A/B 驗證成本的使用情境。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Audio, MiniMax

ComfyUI-MiniMaxH3-Easy:幫 H3 補回可用性

把 MiniMax H3 放進 ComfyUI 後,最麻煩的接線、引用同提示編排,被整理成較順手的一套介面。

Mixed media input

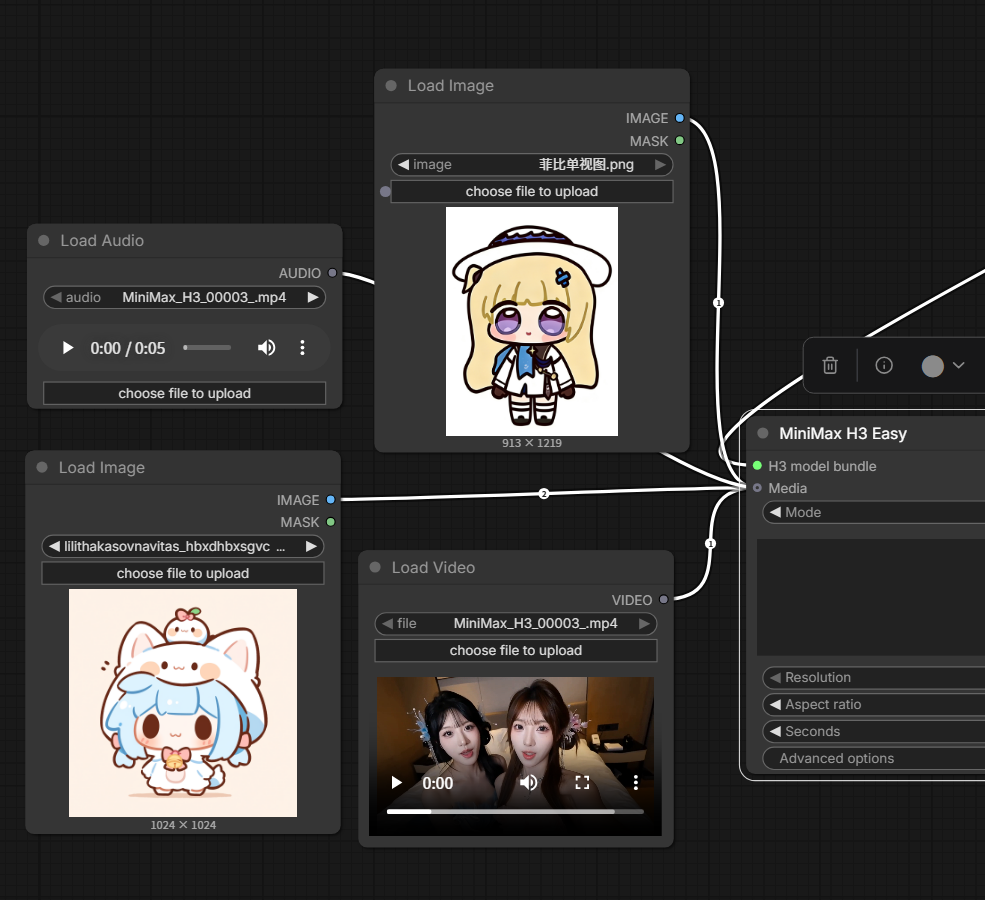
做影片生成時,最阻手往往唔係模型能力,而係節點圖愈接愈亂、參考素材愈加愈難管理。ComfyUI-MiniMaxH3-Easy 屬於 ComfyUI 自訂節點工具,集中處理 MiniMax H3 的 text-to-video、image-to-video 同 reference-to-video 工作流,將原本分散嘅媒體接線、參考標記同提示編輯收埋到同一個操作面。

呢個項目最實際嘅改動,在於保留 ComfyUI 彈性之餘,減少你每次都要手動整理素材順序。主節點用一個 Media 輸入口同時接收圖片、影片同音訊,仲會分開追蹤各自次序;一張圖會走 image-to-video,兩張圖就可用作 first/last-frame generation。做 reference-to-video 時,提示編輯器支援 @ 揀選已連接素材,執行時再自動轉成 MiniMax 建議嘅 <Picture N>、<Video N>、<Audio N> 格式,唔使自己逐個標籤維護。

  • 將多種媒體收進單一 Media 入口,節點圖會乾淨得多
  • @ 參考編輯器有預覽,較適合需要反覆改 prompt 嘅影片生成流程
  • # 對話區塊可直接寫成可編輯 block,送出時自動轉成 <d>...</d>
  • 可接 model-only LoRA、Sage Attention patch,亦可直接連到模型相關節點

同類做法通常要求使用者自己記住引用格式、接線順序同素材對應,ComfyUI-MiniMaxH3-Easy 選擇用較重介面包裝,換來較低出錯率同較高可讀性。代價亦明顯:它改善嘅係 MiniMax H3 在 ComfyUI 入面嘅操作層,不是另起一個新模型,也未見提供生成品質、速度或資源佔用測試數字,因此價值主要落在工作流整理,而唔係模型性能突破。

較受惠嘅會係已經用開 ComfyUI、但又嫌 MiniMax H3 節點圖太碎太亂嘅創作者、影片實驗團隊同需要反覆比對參考素材嘅人。部署方式亦唔複雜,理解上可以當成安裝到 ComfyUI 內嘅一組工作流節點:接好模型或 LoRA、把圖片或影片餵入 Media、再用內建編輯器整理引用同對話內容,就可以直接進入生成流程。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

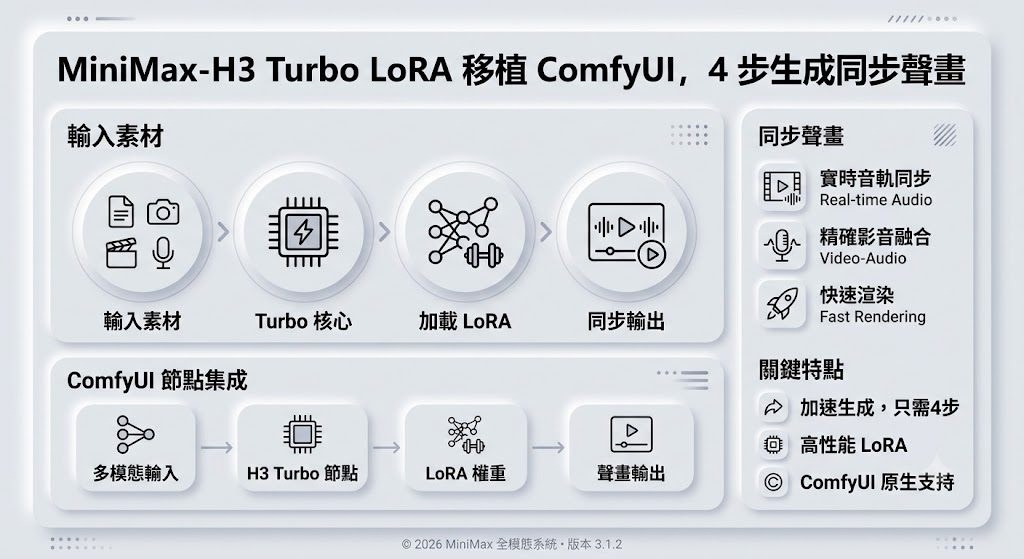
MiniMax-H3 Turbo LoRA 移植 ComfyUI,4 步生成同步聲畫

呢個版本唔係重新訓練主模型,而係把 MiniMax-H3 Turbo LoRA 轉成 ComfyUI 可直接載入的格式。重點在於 4-step 加速生成,同時保留聲畫同步能力。

Og image

想用更少步數生成影片同音訊,呢個頁面最值得留意的地方,是它明確基於 Comfy-Org/MiniMax-H3,而且屬於 adapter 形式的 LoRA,不是完整基礎模型。它針對 ComfyUI 使用的 pruned/curve-form MiniMax-H3 checkpoint 做兼容轉換,目的是讓原本由 larryvrh 發佈的 MiniMax-H3 Turbo LoRA — 4-step audio-video generation preview,可以透過 ComfyUI 內建的 MiniMax-H3 LoRA 載入流程使用。

技術上,核心價值在於把原始 Turbo LoRA 的 four-step distillation 和 dual video/audio sampling 帶入 ComfyUI 工作流。4-step 代表生成步數大幅壓縮,推理延遲有機會下降;頁面同時指出 non-EMA 權重較銳利、較能保持快速動作,EMA 權重則較平滑,但因為當時 EMA 未完全成熟,畫面會較柔。呢種取捨直接影響你想要的觀感:動態表現優先,可先看 non-EMA;畫面過渡想更順,EMA 版本更值得比較。

檔案方面,頁面列出 4 個 .safetensors LoRA 權重,包括初始兼容轉換版,以及兩個 further-trained checkpoint-500 變體:minimax_h3_turbo_4step_pruned_comfyui.safetensors、minimax_h3_turbo_4step_ema_pruned_comfyui.safetensors、minimax_h3_turbo_4step_ckpt500_pruned_comfyui.safetensors,以及對應的 EMA checkpoint-500 版本。

  • 基礎模型已明示為 Comfy-Org/MiniMax-H3,屬於 LoRA adapter 兼容轉換
  • 主要能力是 text-to-video,並帶有 text-to-audio、audio-video、synchronized-audio 標籤
  • 重點方法來自原作者的 four-step distillation,目標是加速推理
  • 頁面提供 ComfyUI workflow 範例下載,定位很明確:直接服務 ComfyUI 用戶

這個 Hugging Face 頁面是第三方整理的 ComfyUI 相容版本,價值在於把原始 MiniMax-H3 Turbo LoRA 接入 ComfyUI 生態,方便直接測試 4-step 聲畫同步生成與 checkpoint-500 變體之間的差異。

項目主頁

Categories: 開源, ComfyUI, 視頻模型, Video, Audio, MiniMax

ComfyTV 把 ComfyUI 拉進完整媒體工作流

想用 ComfyUI 做圖、剪片同整理素材,通常要在多個介面之間跳來跳去。ComfyTV 把這些步驟收進同一個畫布,重點不只生成,仲包括挑選、編修同輸出。

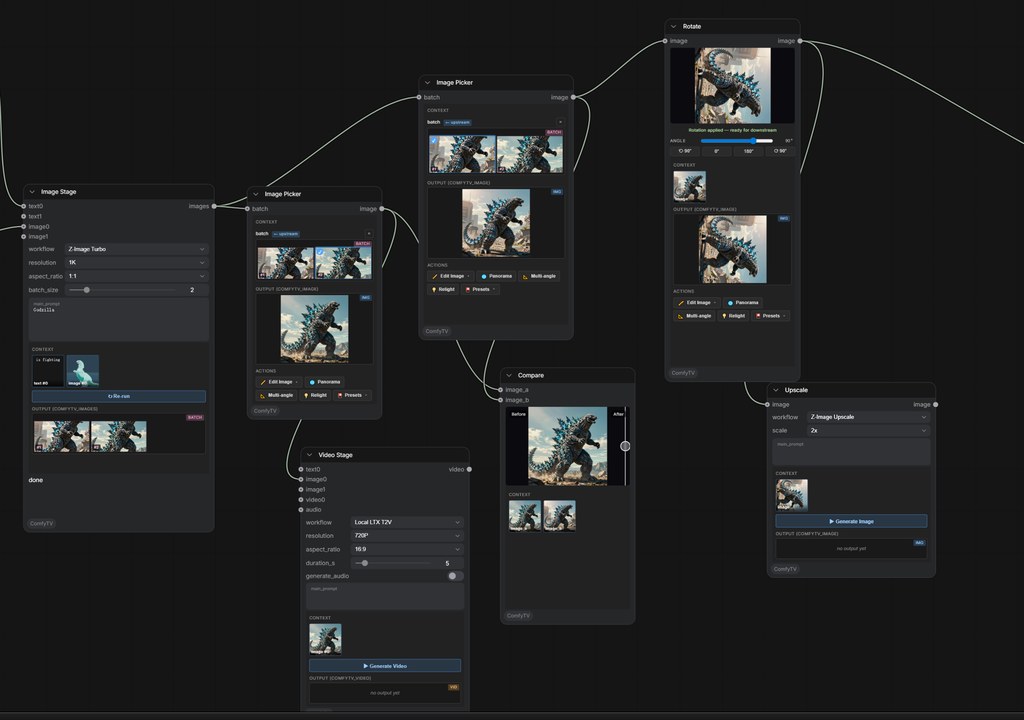
ComfyTV canvas overview

做生成內容唔少人最怕流程一長就難改、難追版本,ComfyTV 針對的正是這個卡位。它屬於建基於 ComfyUI 的畫布式媒體工作台,將生成、挑圖、編輯、合成到輸出串成同一條流程,處理範圍橫跨 image、video、audio、music、panorama、2D layers 同 3D,而唔係停留喺單次出圖。

跟一般要靠 ComfyUI 全域 queue 推整條鏈不同,ComfyTV 採用 per-node run,每個 stage 可以獨立重跑,下游只會接住上游最近一次輸出的 snapshot。這種做法減少反覆測一小步時牽動全流程的等待,代價是你要更清楚每個節點當下吃的是哪個版本輸出,但對長流程調整明顯更順手。

它的另一個重點是以項目為中心管理素材與歷史。每個 stage 都掛在同一個項目內,輸出會連同歷史保留,重新載入後可還原;再加上 asset library、resource library 同 prompt fragments,可直接在提示詞用 @ 引用。README 亦提到可匯入任何 ComfyUI workflow JSON,在側邊欄綁定輸入、保存 stage preset,並透過 Bridge nodes 接第三方插件,甚至登記遠端 ComfyUI 機器做 runner。

內容深度比一般前端殼再走前一步,現時提供約 190 個 stages,而且不少節點內置真正編輯器,例如 layer editor、storyboard workbench、piano rolls、3D viewports 同 scopes,部分 video effects 亦有 live preview。2D 編輯一段還延伸到 PSD import/export、Fountain script import 這類偏製作流程的功能,顯示它瞄準的是需要持續迭代的創作項目,而唔係一次性玩效果。

  • 把 ComfyUI 擴展成完整媒體工作台,覆蓋生成、編修、合成與輸出
  • per-node run 減少重跑整條流程的等待,適合長鏈路反覆微調
  • 以項目保存 stage 歷史、素材與資源,較方便追版本同回復狀態
  • 可匯入 ComfyUI workflow JSON,兼容 subgraphs、第三方 plugins 同遠端 runners
  • 約 190 個 stages,加上節點內編輯器,定位比純工作流編排器更完整

它依賴你現有的 ComfyUI 生態與本地模型,較像建在 ComfyUI 之上的創作界面層,而唔係獨立模型服務。適合已經有一批 workflows、想將 image、video、audio 放入同一項目管理的團隊或創作者;純粹只求最快出一張圖的人,未必需要它這麼重的工作台結構。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, 3D, 庫

用 Hermes Agent 自動跑 ComfyUI 影片流程

打幾句文字指令,就能讓 Hermes Agent 在 Windows 控制 ComfyUI,串起影像、聲音到影片生成流程。

Og image

由文字指令直接帶動整條 AI 內容製作流程,正是這段教學最吸引人的地方。影片示範 Hermes Agent 在 Windows 電腦上接手 ComfyUI 操作,把影像、語音與影片生成串成一套可執行工作流,減少人手逐步點擊介面的時間。

這類做法處理的,是多工具協作時常見的斷層:模型會生成內容,但流程仍要靠人逐格設定、切換節點、整理輸出。Hermes Agent 扮演的角色更接近可執行指令的 Agent,讓使用者用自然語言描述需求,再由它推動 ComfyUI 與相關模型完成步驟。

影片標題提到的 Krea 2、LTX 2.3、Qwen 與 Fish Audio,反映這條工作流並不只限於單一模型,而是把視覺、影片與音訊能力接在一起。重點不在單一模型參數,而在於怎樣把不同項目整合成可重複使用的自動化流程。

  • Hermes Agent 可在 Windows 環境控制 ComfyUI
  • 工作流涵蓋影像、音訊與影片生成
  • 輸入形式以簡單文字指令為主
  • 涉及 Krea 2、LTX 2.3、Qwen、Fish Audio 等模型或服務

對內容創作者、想整理 AI 製作流程的人,這類教學特別有參考價值。它未必代表所有步驟都能完全免調整,但已清楚展示 Agentic 工作流如何把 ComfyUI 由節點工具,進一步變成可自動執行的製作中樞。

項目主頁

Categories: ComfyUI, Agentic, AI productions, 視覺模型, 視頻模型, Qwen, Google, Video, Audio, 教學, 安全, LTX

CrossView 用 3D 數值控制鏡頭:LTX-Video 跨視角生成

同一段影片想換個拍攝角度,通常最難是保住人物一致性與空間感。這個 IC-LoRA 用深度 warp 加原片雙參考,讓跨視角生成更可控。

Og image

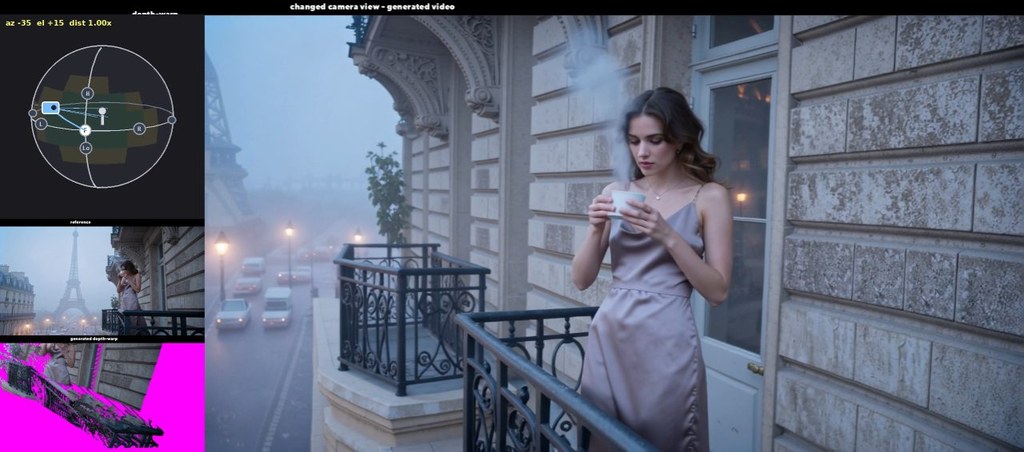
想將一段現成影片改成另一個鏡頭角度,又唔想主體變樣或空間關係散掉,這正是此模型處理的問題。它明確基於 Lightricks/LTX-2.3,屬於 LTX-Video 2.3 22B 的 IC-LoRA 微調,重點不是純文字改鏡頭,而是用輸入影片加相機偏移數值,重建同一場景的新視角。

頁面提供的做法幾清楚:模型同時接收兩段參考影片,一段是由 CrossViewWarp ComfyUI node 產生的 depth-warp 影片,用來保留幾何結構;另一段是原始影片,用來維持主體 identity。這種雙參考分工,反映它優先解決「換角度後仍要似原片」的取捨,比單靠 prompt 描述鏡頭更穩定。

它與同作者的 CrossView Prompt LoRA 差異亦很直接:後者由文字提示選鏡頭角度,這個版本改為輸入 azimuth / elevation / distance 等數值,所以鏡頭控制更精確。頁面亦提到可以在 3D orbit picker 加 keyframes,逐幀插值相機姿態,代表不只可做固定新視角,也可做繞拍式 camera move。

  • 基礎模型已標明為 Lightricks/LTX-2.3,授權為 Apache-2.0。
  • 主要檔案是 LTX2.3-22B_IC-LoRA-CrossView-Warp_v0.9_18000.safetensors。
  • 依賴 ComfyUI-CrossViewWarp 與 Depth Anything V2 節點提供 depth 輸入。
  • 示例包含固定視角偏移與 keyframed 軌道鏡頭,並說明輸出來自真實影片而非合成訓練片段。

這個項目目前仍是 PoC,它較偏向 ComfyUI 工作流驗證,而不是通用本地大語言模型部署。

模型

Categories: 開源, ComfyUI, AI productions, 視覺模型, 視頻模型, Video, 3D, LTX

JoyAI-Image 想做懂空間的影像模型

JoyAI-Image唔只想生圖,仲想令模型真正理解畫面入面物件點擺位、點互相關聯。對要做指令修圖、排版生圖同多視角內容的人,呢個方向幾有參考價值。

Repository image for jd-opensource/JoyAI-Image

改圖最怕模型聽得明文字,卻改壞原本場景結構;生圖亦常見字排得唔準、物件關係走位。JoyAI-Image就係朝住呢個痛點落手,定位屬於多模態基礎模型,把影像理解、text-to-image 生成同指令式編輯放入同一個模型家族,重點處理空間理解不足帶來的失真與失控。

唔係把理解模型同生成模型鬆散拼埋,而係用 8B Multimodal Large Language Model (MLLM) 配 16B Multimodal Diffusion Transformer (MMDiT),強調理解、生成、編輯之間的閉環協作。換句話說,模型唔只讀圖後再畫圖,仲會利用視角變換等生成結果反過來補強空間推理,呢點令它在 grounded generation、關係定位同可控編輯上有更鮮明方向。

現有公開內容顯示,部署路線算完整,已提供 Hugging Face 權重、Diffusers 版本、ComfyUI 原生支援,同埋可直接參考的 workflow;另外亦有 Spatial Edit 同 General Edit 示範空間。對內容製作、電商視覺、設計流程或者研究多模態編輯的人,較值得留意的是它不只處理單次修圖,仲想處理長文字排版、版面忠實度、多視角生成,以及「指定物件移去指定位置」呢類容易出錯的操作。

JoyAI Image Edit Plus in ComfyUI - How Does it Compare?
  • 把理解、生成、編輯整合到同一條多模態流程
  • 核心賣點係較強的 spatial intelligence,而不只是畫面更靚
  • 已有 Diffusers 與 ComfyUI 兩條使用路線,測試門檻較研究原型低
  • 延伸到 OpenSpatial data engine 同 OpenSpatial-3M dataset,反映它連資料與訓練配方都一併公開

效能方面,儲存庫描述集中在能力展示與訓練設計,現階段較適合把它理解成一個方向清晰、工具鏈逐步成熟的開源影像模型項目。最吸引之處唔係單一指標,而係它把空間理解當成生成與編輯的核心能力,對需要更穩定版面、關係同位置控制的工作流,確實比單講畫質更實用。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, 視覺模型, 多模態模型, Qwen, Image, txt2img, Dataset 數據集

Sana 把高解像生成壓到快 100 倍

想做高解像圖片或影片生成,又唔想計算成本高得難以落地,Sana 提供了一條幾實際的路。它把訓練、推理到不同變體放在同一套代碼庫,重點放在速度與畫質之間的平衡。

logo

高解像圖片同影片生成最常見的卡位,不是效果做不到,而是算力、延遲同部署成本太難接受。NVlabs/Sana 屬於生成模型代碼庫,集中處理這個矛盾:在維持高解析輸出的前提下,把訓練與推理做得更省、更快,並且一路延伸到圖片、影片、世界模型等多條分支。

這個項目唔係單一模型,而是一個家族。SANA 主打最高到 4K 的 text-to-image,README 直接給出「比 Flux-12B 細 20 倍、快 100 倍」的定位;SANA-1.5 進一步處理訓練期與推理期的 compute scaling;SANA-Sprint 則把重點放在 one/few-step 生成,官方數字提到 H100 上 1024px 圖片可做到 0.1 秒級。取向很清楚:不是一味追最大模型,而是用效率換取更可部署的生成流程。

影片部分同樣值得留意。SANA-Video 與 SANA-Video 2.0 把焦點放在 720p 長序列生成,做法上用 hybrid linear attention 配合 Attention Residuals,目的是減少 full-softmax attention 的成本,同時盡量保住畫質與長序列表達能力。公開資料提到 SANA-Video 2.0 在單張 H100 上,720p/5 秒影片可做到 13.06 秒,VBench 總分 84.30,也強調比 Wan 2.2 14B 有大幅速度優勢,但這類數字仍要連同硬件、步數與設定一齊理解。

  • 同一庫內含 SANA、SANA-1.5、SANA-Sprint、SANA-Video、SANA-WM、SANA-Streaming、Sol-RL
  • 提供完整 training 與 inference pipeline,唔止展示模型效果
  • 可透過官方 demo、Hugging Face、ComfyUI 整合去理解生成表現與部署方向
  • 重點不是極限參數量,而是高解像生成的速度、成本同可擴展性

部署與測試路線相對清晰:已有官方文件、網頁 demo、Hugging Face 集合,亦見到 ComfyUI、SGLang、Replicate 等接點,代表它較適合研究團隊、影像工作流開發者,以及想把高解像生成放進產品流程的人。 SANA-WM 的 2.6B controllable world model、6-DoF camera control,同 Sol-RL 的加速收斂能力,則顯示這個項目不只做靜態出圖,而是朝更完整的生成系統推進。

項目主頁 · GitHub

Categories: 開源, ComfyUI, AI productions, 世界模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, txt2img

Page 6 of 10
1 … 4 5 6 7 8 … 10