ComfyUI XY Plot 的乾淨做法

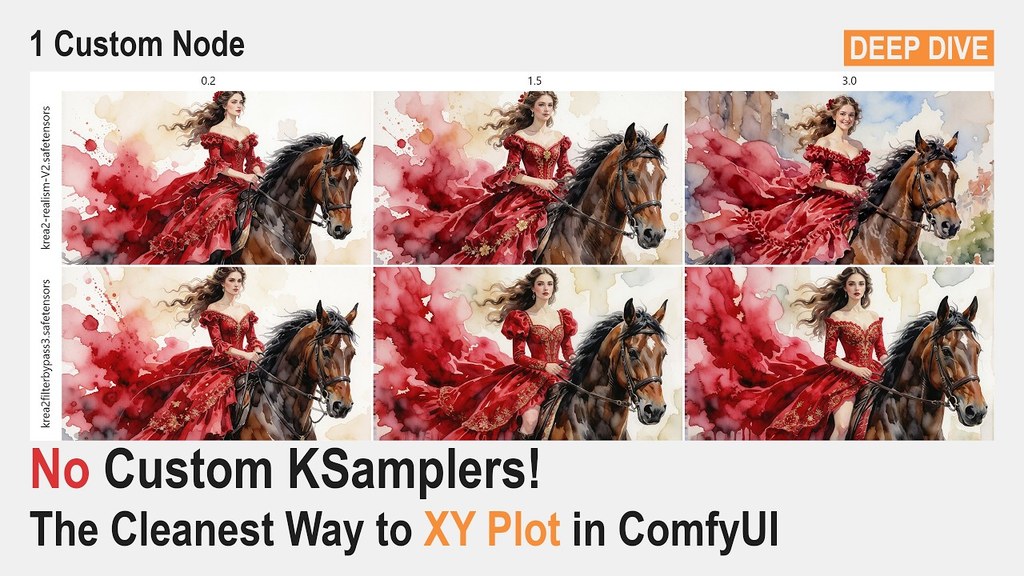
這段教學聚焦喺 ComfyUI 入面做 XY Plot,重點係唔使靠複雜接線同自訂 KSamplers。你可以把它理解成一個更乾淨的測試方式,方便比較不同設定對出圖結果的影響。

Og image

這段內容講的是 ComfyUI 裡的 XY Plot 用法,重點不在花俏效果,而在怎樣保留乾淨流程,同時方便比對不同參數、模型或提示詞的輸出差異。對經常要試圖、做視覺比較、或整理生成結果的人來說,這種做法會比把工作流拆得很碎更順手。

影片想解的問題很直接:不少 XY Plot 教學都會逼人用很重的接線、侵入式的自訂 KSampler,甚至把原本清晰的工作流弄得難以維護。這裡提出的取向是盡量少改動主流程,讓比較測試留在 ComfyUI 的正常操作邏輯裡完成。

它的價值主要在這幾點:
– 保持工作流較乾淨,較易重用
– 減少對自訂節點的依賴
– 方便橫向比較不同設定的效果
– 較適合要反覆調參的圖像生成工作

整體來說,這類做法對常用 ComfyUI 做實驗的人最有用,尤其是需要快速看清楚某個參數改動帶來什麼差別,而唔想每次都重砌一套流程。影片屬於教學內容,沒有提供模型評測數據,但方向很明確,就是用更少干擾的方式做 XY Plot。

項目主頁

Categories: ComfyUI, 教學

Semantic Browsing:用樹狀圖掌控 AI 生圖的多樣性

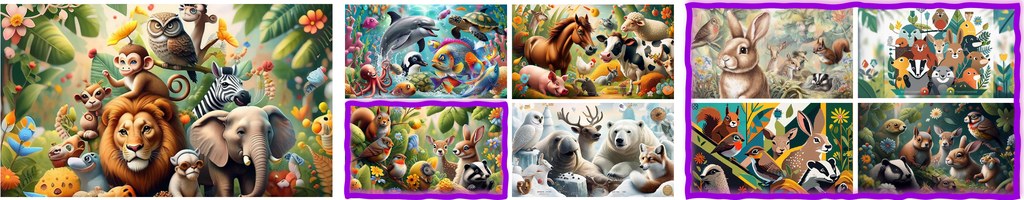
Tel Aviv 大學團隊提出 Semantic Browsing,以多智能體流程把單一文字提示展開成可瀏覽的語意樹,讓圖像生成的多樣性變得可控且可解讀。

Og image

Semantic Browsing 是一篇發表於 ECCV 2026 的學術項目,由 Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or 共同開發。它針對文字生成圖像模型在重複取樣時容易「語意塌縮」、產出過於雷同的問題,提出一套可控多樣性的工作流程。

這套方法的核心做法,是把多樣性從像素層級搬到文字層級。系統會先用多智能體(multi-agent)流程把使用者的提示擴寫成結構化的場景 JSON,記錄物件、屬性、互動與整體場景設定,再從中找出提示中未明確指定、但合理的變化軸心。每一次分支都對應一個明確的語意決定,例如角色、構圖或風格的差異,最終形成一棵可瀏覽的場景樹。

與一般常見做法相比,這個項目最值得留意的差異在於:變化不是來自隨機噪聲,而是來自可解讀的語意約束。樹狀結構讓使用者可以沿著特定分支往下探索,同時保留先前已固定的條件,方便在設計空間中做有意識的導覽。

重點摘要:

  • 開發團隊:Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or。
  • 核心方法:以多智能體流程把提示展開為結構化 JSON 場景樹。
  • 可控多樣性:每個分支對應一個明確的語意決定,而非隨機變化。
  • 適用情境:概念設計、視覺探索、需要比較多個語意詮釋的創作流程。
  • 目前狀態:程式碼尚未公開,僅釋出 arXiv 論文與項目頁。

使用方法詳細教學:

  1. 準備提示:先寫好一段文字提示,例如「A poster featuring animals」,提示中可以刻意留白部分細節,讓系統有空間展開變化。
  2. 進入項目頁:前往 Semantic Browsing 的官方網頁(saradorfman1.github.io/SemanticBrowsing-webpage/),等待互動介面載入。
  3. 送出提示並生成根節點:系統會先推論出一個初始場景詮釋,作為場景樹的根節點。
  4. 瀏覽與選擇變化軸心:介面會列出可變化的語意面向,例如角色、構圖、風格等,每個面向都會顯示目前值與替代選項。
  5. 展開分支:選定一個面向並挑選替代值後,系統會呼叫多智能體流程,在保留先前約束的前提下產生新的子節點與對應圖像。
  6. 沿著分支深入探索:可以重複步驟四與五,沿著感興趣的路徑繼續往下展開,逐步建立一棵專屬的設計樹。
  7. 匯出或記錄結果:若需要保留特定分支,可記下該節點的場景 JSON 或截圖,作為後續迭代或團隊溝通的依據。

由於程式碼尚未釋出,目前只能透過項目頁的示範介面體驗流程;待官方開源後,便能整合進 ComfyUI、Stable Diffusion 等本地生圖工作流。對於從事概念設計、視覺探索,或需要比較多個語意詮釋的創作者與研究人員來說,這套方法提供了一條比隨機抽樣更可控的探索路徑。

項目主頁: https://saradorfman1.github.io/SemanticBrowsing-webpage/

Paper: https://arxiv.org/pdf/2606.23679

Categories: 開源, ComfyUI, Agentic, 模型, 視覺模型, Stable Diffusion, Image, 影像處理, 教學

FreeStyle:用社群 LoRA 做雙參考生圖

FreeStyle 不只放出資料,亦重整了雙參考生圖的訓練與評測方法。它的焦點是減少風格參考偷帶內容,同時保住畫風。

FreeStyle teaser

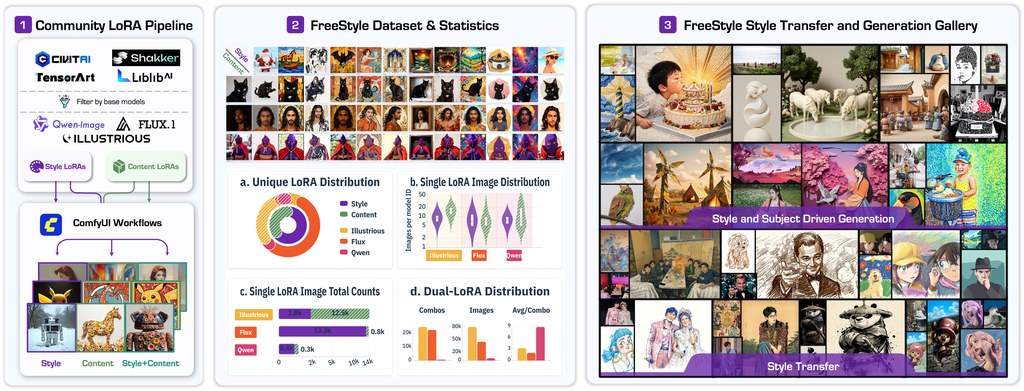
現時不少 style-reference 生成,只處理單一風格參考;至於 content + style dual-reference,常見難位是資料難整、風格長尾不足,兼且 style reference 容易把人物、物件等內容一併「滲」入結果。FreeStyle 把社群 LoRA 視為風格或內容概念的聚類中心,再配合自動生成與過濾流程,重組出可訓練的雙參考資料,連 benchmark 一起補上。

這不是單純模型,而是一個結合資料管線、benchmark 與 DiT-based model 的影像生成項目,目標是解決 SRef 與 CRef+SRef 兩類任務中,內容保持、風格對齊與 leakage suppression 很難同時兼顧的問題。文中提出 attention-level constraint,以及 RoPE low-frequency modulation,核心取向很清楚:寧可多做約束,也要壓住 style-reference content leakage。

資料規模是 FreeStyle 最有份量的部分。CRef+SRef dataset 提供 480K sequences,涵蓋 1,704 種 styles;SRef dataset 則有 619,302 sequences、622 種 styles。評測亦不只看靚唔靚,還加入 CSD、OneIG、DINOv2、CAS、CLIP-T、aesthetic predictors 及 VLM-as-judge,將 style similarity、content preservation、instruction following 同 leakage rejection 分開量度。

想理解怎樣測試這個項目,較合理的做法是分三層看:先用公開 dataset 與 benchmark 檢查資料結構;再看 repo 提供的 LoRA metadata 與 ComfyUI workflows,理解 triplet 怎樣生成與驗證;最後才研究 checkpoint 表現。它較適合研究團隊、做可控生圖的產品組,或者本身已在用 FLUX、Qwen、Illustrious 生態的人。

  • 把 Civitai、TensorArt、Liblib 的社群 LoRA 變成可用訓練訊號
  • 同時覆蓋 SRef 與 CRef+SRef,而非只做單一風格參考
  • 重點不是單純追求風格像,而是壓低內容洩漏
  • 提供 dataset、benchmark、workflow、checkpoint,便於重現整個流程

相關模型與基礎生態包括 DiT-based model、FLUX、Illustrious、Qwen,以及資料生成用的 ComfyUI workflow。若你關心的是商用穩定性,仍要留意它相當依賴社群 LoRA 品質與過濾流程;作者亦有講明,原始 LoRA 權重本身未必會隨項目再分發。

GitHub: https://github.com/Blue2Giant/FreeStyle

項目: https://blue2giant.github.io/FreeStyle/
Categories: 開源, 阿里巴巴, ComfyUI, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Stable Diffusion, Image, 影像模型, 影像處理, 工具, Content Creator, Sora, Meta, Dataset 數據集


Qwen Image Edit 2511 教學

在本機用 ComfyUI 跑 Qwen Image Edit 2511,包含 BF16、FP8 和 GGUF 量化版本,以及 Lightning 4‑step LoRA 的完整實戰示範。

在本機用 ComfyUI 跑 Qwen Image Edit 2511,包含 BF16、FP8 和 GGUF 量化版本,以及 Lightning 4‑step LoRA 的完整實戰示範。

Qwen Image Edit 2511–Local Image Editing in ComfyUI | Multi-Reference Style Transfer & GGUF Workflow
Categories: 開源, 阿里巴巴, ComfyUI, 影像模型, 影像處理

輕鬆製作超逼真 AI 說話頭像影片

InfiniteTalk 完全免費、支援長影片,唇同步自然但需調參避免誇張;HeyGen 更親民但付費,兩者差異不大,InfiniteTalk 性價比高。 適合 IT 顧問用於快速製作教程或演示影片,節省攝影成本。

InfiniteTalk 完全免費、支援長影片,唇同步自然但需調參避免誇張;HeyGen 更親民但付費,兩者差異不大,InfiniteTalk 性價比高。 適合 IT 顧問用於快速製作教程或演示影片,節省攝影成本。

Create Realistic AI AVATARS That Look And Talk EXACTLY Like You! | FREE ComfyUI Tutorial
Categories: ComfyUI, AI productions, 數字人, 影像處理, Python


Page 7 of 10
1 … 5 6 7 8 9 10