h3-motion:沿路徑移動照片主體並重生成影片局部

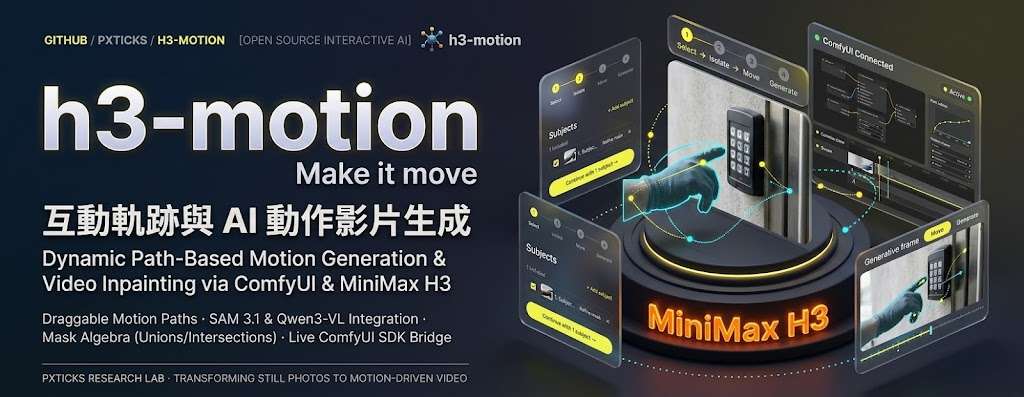
沿路徑移動照片主體,或為影片局部加上遮罩再重新生成;h3-motion 透過自架 ComfyUI 串連影像理解與動畫模型。

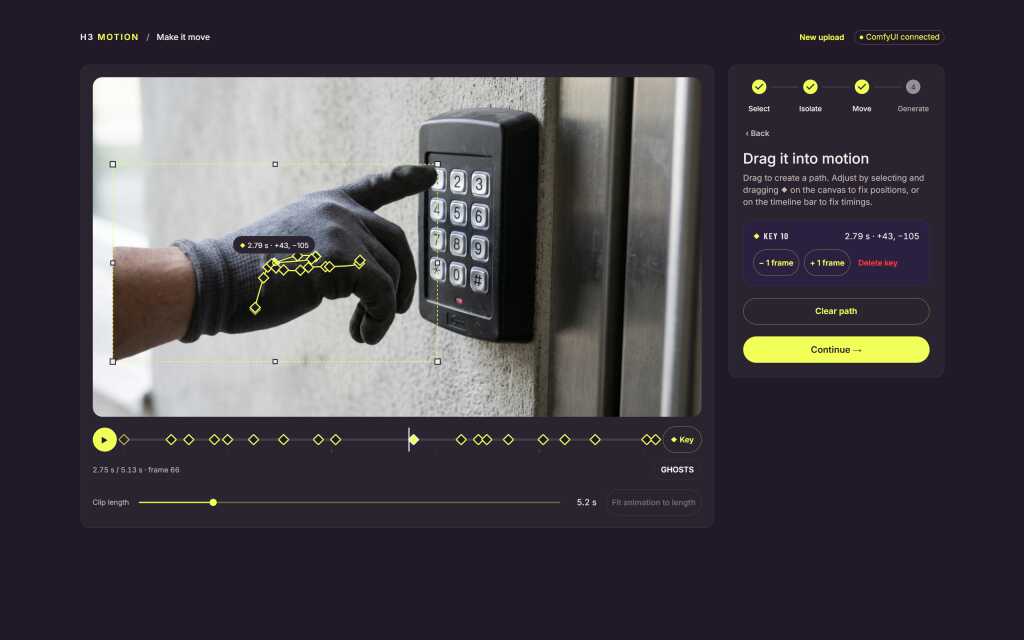
Select step: a gloved hand picked out with SAM 3.1

想沿路徑移動照片主體,或只重做影片局部,h3-motion 把兩種編輯流程整合在獨立 React app,透過 Comfy SDK 操作自架 ComfyUI。流程只用開放權重模型,不依賴 Comfy Router、合作夥伴節點或封閉 API。

照片流程以 SAM 3.1 選取主體,並可用點擊修整遮罩;Qwen3-VL 描述主體,Qwen Image 2.1 清除主體並補回背景。使用者設定路徑、大小或翻轉後,由 MiniMax H3 透過 Time-to-Move 生成動畫與聲音。

影片可用矩形或橢圓標出範圍,設定 keyframe 路徑或讓遮罩跟隨物件,並加入描述及可選參考圖。H3 重生成遮罩區域後,由 app 合成回原片;原有聲音可保留、參照或替換。

  • 照片:主體分割、背景清除,再沿路徑生成動畫。
  • 影片:局部遮罩、路徑或物件跟隨,並合成回來源影片。
  • 模型串連 SAM 3.1、Qwen3-VL、Qwen Image 2.1 與 MiniMax H3。

需要 NVIDIA 或 AMD GPU、近期 ComfyUI、ComfyUI-vlo 0.3.0 或更新版本,以及 Node.js 22.12 或更新版本;原生 Windows 尚未測試。文件未提供速度或畫質評測,較適合熟悉 ComfyUI、需要精細編輯影像局部的創作者。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, NVIDIA, API, Video, Image, Audio, Content Creator, 動畫, MiniMax

Open-H3-Regenerate-2K:把 MiniMax H3 影片提升至原生 2K

[YouTube 影片]NVIDIA 的 Open-H3-Regenerate-2K 可在 ComfyUI 將 480p MiniMax H3 草稿提升至 2K,並提供兩種測試方法。

Og image

將 480p 影片提升至 2K,往往要在畫面細節、運算成本與輸出穩定性之間取捨。NVIDIA Open-H3-Regenerate-2K 把這項流程帶入 ComfyUI,針對 MiniMax H3 產生的影片草稿進行高解像度重建,適合需要改善輸出尺寸而又想保留原有動態內容的影像工作流程。

影片示範以三個步驟完成處理,並測試兩種方法,相關檔案亦附有連結。不過,提供的原始資料沒有列出具體工作流程、模型檔案名稱、安裝方式或硬件要求,使用者仍需按影片內容及項目檔案確認 ComfyUI 節點、顯示卡記憶體和運算時間。

  • 將 480p MiniMax H3 草稿提升至原生 2K 影片
  • 以 ComfyUI 組合 NVIDIA Open-H3-Regenerate-2K 流程
  • 示範三步處理方式及兩種測試方法
  • 適合影片生成後的放大、修復及高解像度輸出
  • 硬件規格與安裝細節未在原始資料中提供

對內容創作者而言,這個項目可用於先以較低解像度製作草稿,再把選定結果交由高解像度流程處理,減少一開始便以 2K 生成所帶來的資源壓力。它較適合已經使用 ComfyUI、MiniMax H3 或 NVIDIA 影片模型工作流的使用者。

YouTube 影片介紹

Categories: ComfyUI, AI productions, 模型, NVIDIA, Video, Image, Content Creator, 安全, MiniMax

ComfyUI Graph Grid:一個比較提示詞、LoRA 與模型設定

ComfyUI Graph Grid 將不同提示詞、LoRA 強度、採樣器或 checkpoint 排成圖表,列隊生成,方便逐格比較結果。

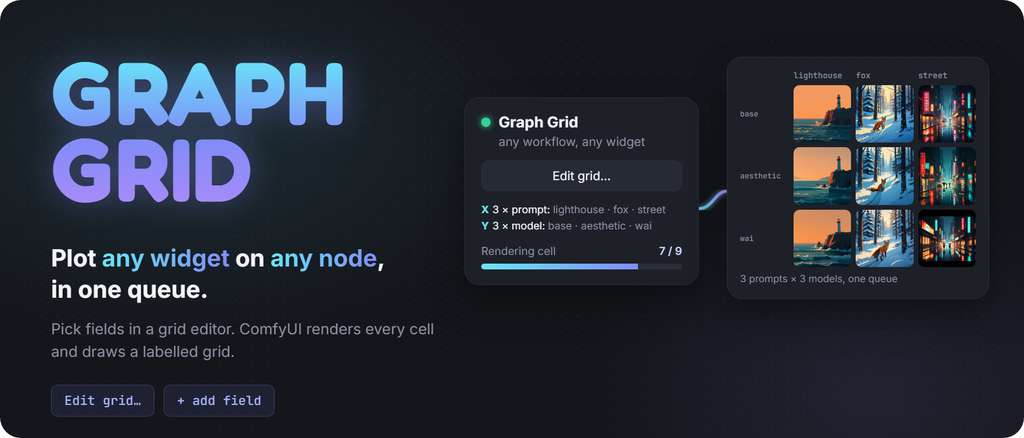
Graph Grid: plot any widget on any node, in one queue

將提示詞、LoRA 強度、CFG、採樣器或 checkpoint 放到行列中比較,ComfyUI Graph Grid 會一次佇列所有組合,再輸出附有標籤的圖像網格。它屬於 ComfyUI 自訂節點,處理的是影像生成工作流中逐組改參數、逐張記錄和肉眼比對過於零散的問題。

安裝可透過 ComfyUI Manager 搜尋 Graph Grid,或放入 ComfyUI/custom_nodes 後重新啟動。使用時把最終影像輸出接到 Graph Grid,再把 grid 輸出接至 Preview Image 或 Save Image;在編輯器中選擇要變動的 widget,填入行列值後佇列生成即可。項目已在 ComfyUI 0.41.0 測試,標籤位置亦取決於 Pillow 10.1 或更新版本。

它不要求特別的 loader 或 sampler,而是複製每格需要改動的上游圖段,讓 ComfyUI 執行各組設定;沒有變動的節點可載入一次,重複內容亦有機會由快取提供。接線中的 widget 不能直接變更,必須改動負責輸入的上游節點,其他未接入 Graph Grid 的輸出節點仍會以原值執行。

• 可同時比較多個欄位,亦能用數值範圍、下拉選單選項或逐行文字填充。
• 空白格會保留原本設定,Cross with existing 可建立完整組合。
• 適合測試 LoRA 權重、提示詞、模型和採樣參數的差異。
• 生成量會隨行列組合增加,顯存、時間和輸出整理成本仍需自行控制。

對需要挑選模型、整理提示詞實驗,或為影像生成流程建立可重現比較表的創作者和研究者,Graph Grid 能補足 ComfyUI 原生流程缺少的批量對照介面;它不會替你判斷哪組設定最好,價值在於把比較過程變得一致、可視化和容易回看。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Image, 提示詞, Content Creator, LoRA

ComfyUI-CharacterCardStudio:Qwen-Image 2.1 角色多視圖自動排版

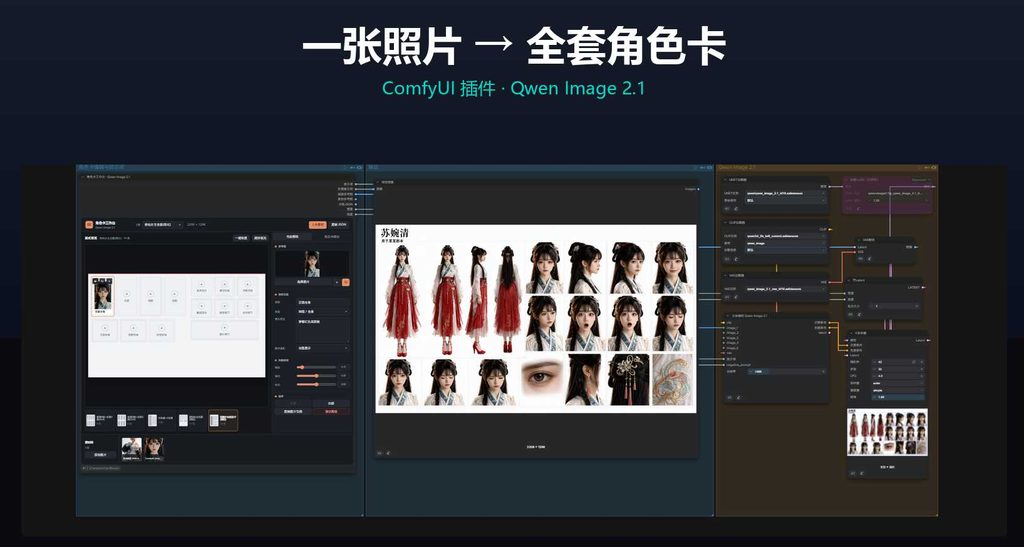
將角色圖、提示詞與場景圖交給 ComfyUI 插件,自動生成多視圖、表情及細節,再精準拼成設定卡。

手工製作角色設定卡最費時的,往往不是生成單張圖,而是補齊正反面、表情、動作,再逐格貼圖兼避免裁走頭腳。JGRFW/ComfyUI-CharacterCardStudio 屬於 ComfyUI 圖像生成插件,針對 Qwen-Image 2.1 將多視圖生成、切片、排序同排版整合成工作流程。

  • 支援角色參考圖及純提示詞兩種生成入口
  • 提供 8 套角色卡版與 1 套 360° 場景卡版
  • 自動切片、重排,並預設完整顯示全身
  • 可分項生成多視圖、動作、表情與細節
  • 右側面自動鏡像,統一由模板決定位置

安裝方式是把儲存庫資料夾放入 ComfyUI 的 custom_nodes 目錄,再重啟 ComfyUI;README 同時提供圖生卡、文生卡、純提示詞及場景補面的工作流。模型選擇方面,插件使用 Qwen-Image 2.1 的 UNET、CLIP 與 VAE,亦為記憶體較緊的環境列出 int8 模型選項,但實際仍需自行準備相應檔案。

插件最實際的價值在排版,而非提升 Qwen-Image 2.1 本身的生成能力。切片節點可讀取模板資料,按 panel_order 將格子重新排列,fit mode 預設保留頭頂至鞋底;場景卡則以一張圖為錨點,補充 0°、90°、180°、270° 環視、360° 全景及環境細節。右側面會自動水平翻轉,減少模型未能準確理解左右方向造成的版面問題。

一次生成整卡仍然受模型隨機性影響,角色姿勢、表情或物件位置未必逐格穩定。對需要固定構圖的團隊,逐格生成及排版流程會較可靠;工作台亦可逐格替換素材及微調裁切。README 未提供量化評測,因此較適合 ComfyUI 創作者、遊戲角色設計師同視覺內容團隊,以工作流方式驗證產出質素。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Image, 提示詞, Content Creator, 庫

MOSS Image Edit:一句指令改圖兼支援四圖參考

把人物改成指定穿搭、表情或場景,MOSS Image Edit 透過 LoRA 串連文字與參考圖,並在 ComfyUI 重用參考資訊。

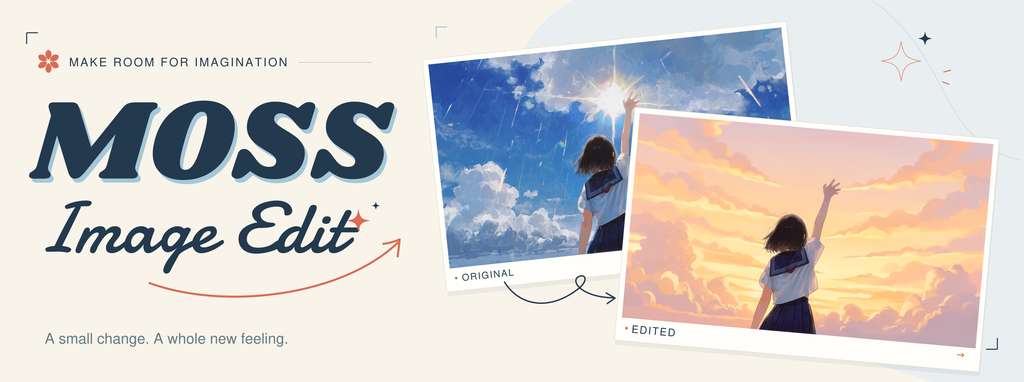
MOSS Image Edit — 用文字编辑图像

要替相片換衫、改正面表情,或將人物移到另一個場景,不一定要由人手逐項遮罩修改。MOSS Image Edit 是一個面向 MOSS-Image 的圖像編輯 LoRA,接收原圖、自然語言指令及最多四張參考圖,負責把服飾、顏色、光照、季節和畫風等要求轉成編輯結果。

發布內容只有 LoRA 權重及配置,必須配搭 MOSS-Image-Base 或 MOSS-Image-SFT,兩者擇一即可。團隊另備獨立 ComfyUI 節點與單圖、多圖工作流;下載底模和 LoRA、按指南擺放模型,再把工作流拖入 ComfyUI 即可測試,亦可調整輸出尺寸、隨機種子和採樣參數。

多圖模式不是單純追加條件:參考圖之間可互相參照,文字與目標圖則可讀取全部資訊,並要在指令內交代每張圖的用途。適合合併人物、服飾及場景參考,但最多四張圖的限制,也意味著複雜構圖仍需反覆測試提示詞與配置。

架構以 text、ref、target 三類 token 組成共享 MOSS Transformer;參考圖固定在無噪聲時間,文字及目標圖則隨去噪時間變化。參考分支只計算一次並快取各層 K/V,之後逐步重用,CFG 的正、負條件亦可共用同一份快取,減少重複運算。

  • 支援單圖指令式編輯
  • 最多連接四張參考圖
  • 可配搭 Base 或 SFT 底模
  • 提供 ComfyUI 單圖及多圖工作流
  • 沒有公開量化評測或推論供應商整合資料

內容團隊、做商品視覺或社交媒體配圖的人,會較容易感受到其價值。它目前更像是 MOSS-Image 生態中的可調編輯模組,而非一開即用的獨立模型;正式採用前仍應以自身相片、指令及輸出尺寸測試一致性、資源需求與授權條件。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, Image, 影像處理, 提示詞, LoRA

Muse-CharacterSheet-H3:MiniMax H3 角色表工作流

生成多角度、背景移除及排版一次完成,減少 ComfyUI 製作角色設定表的繁瑣步驟。

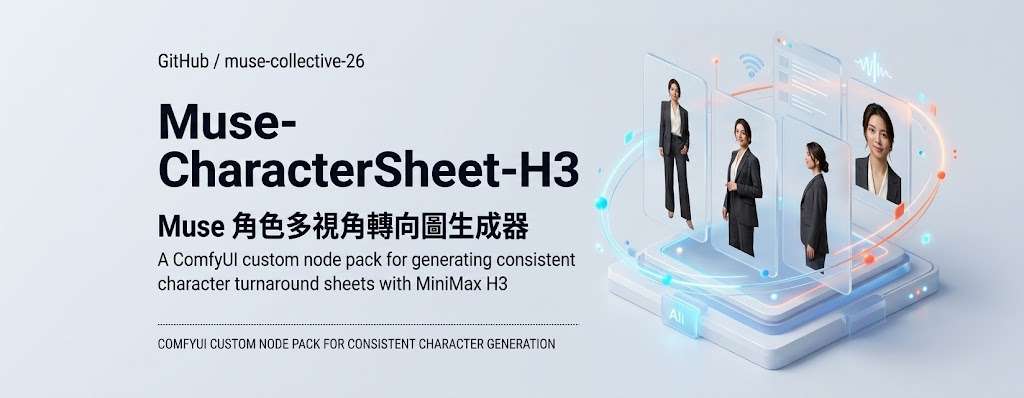
Repository image for muse-collective-26/Muse-CharacterSheet-H3

將五個角度的生成結果自動拼成一張角色設定表,Muse Character Sheet H3 這個 ComfyUI 工具組把 MiniMax H3 的多視角生成、文字儲存、影像轉換及背景處理連成一套工作流。對遊戲美術、角色設計與虛擬內容製作團隊而言,它省去逐格裁切、調整比例及手工排版,但仍需自行準備模型權重與合適的 ComfyUI 環境。

  • 提供 Standard 與 Enhanced 兩套工作流。
  • CHUNK/CUT 介面會把姿勢描述編譯成 H3 六段式 Reference-mode 提示格式。
  • Muse Character Sheet Compositor 可把 Close-up、Front、Left Profile、Right Profile、Back 五格自動並排。
  • Windows 安裝包已整合三個 Muse 工具節點,不需另下載獨立 utility ZIP。

Enhanced 版本在 H3 生成後加入 Qwen image refinement 與 DLSS enhancement;Standard 則以背景移除及選取畫面組成設定表,不依賴 DLSS,適合較簡單或未配置相關環境的流程。標準流程不再要求 WAS Node Suite 或原有 ComfyUI-RMBG 套件,但若其他工作流仍使用,就不應直接刪除。

背景移除輸出 IMAGE、MASK 與 MASK IMAGE;模型權重則另有使用條款。組合設定表支援 16:9、4:3、1:1、3:2 及 21:9,工具會按比例處理裁切,Close-up 佔完整寬度,其餘四個角度排列在側。

Windows 測試可下載完整 ZIP,將資料夾放入 custom_nodes,再執行 Install-Windows.bat;Git 必須在 PATH,模型則按清單另行下載。從前安裝過獨立工具資料夾的環境,應把備份移出 custom_nodes,避免同一節點重複註冊;安裝器不會自動刪除舊資料夾。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Image, 工具, MiniMax

MOSS-Image 支援 JSON 排版的 5B 文字生圖模型

MOSS-Image 推出的 5B 參數文字生圖模型,能夠直接在 prompt 內用 JSON 描述物件位置、標籤與邊界框,毋須額外 ControlNet 也能控制版面。

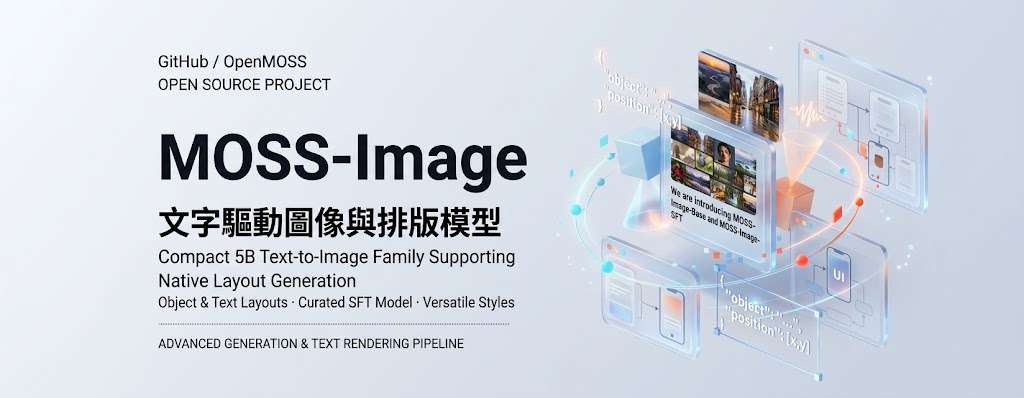
MOSS-Image

用文字生圖最常遇到的卡位,是 prompt 寫得再精準,模型依然把主體放錯位置或把文字渲染得歪七扭八。OpenMOSS 開源的 MOSS-Image 把這個矛盾寫進模型架構本身:除了自然語言 prompt,它同時接受結構化 JSON 輸入,裏面可以逐個列出物件的標籤、描述與 yxyx 格式邊界框,由模型原生處理版面配置,毋須借助外掛 ControlNet 或額外 inpainting 步驟。

對於做海報、漫畫分鏡或產品 mockup 的人來說,這種介面比「再抽幾次卡」來得直接。生成結果可以直接根據 JSON 編輯調整單一物件的位置或文字內容,方便反覆迭代。模型骨幹約 5B 參數,支援長達 4K token 的 prompt,文字渲染能力亦比同類開源模型紮實,並同時覆蓋動漫與寫實風格。

New top local AI image generator is here!

現階段提供 Base 與 SFT(curated-data 微調)兩個版本,權重以 Apache-2.0 釋出,部署上已有 SGLang、vLLM-Omni 與 ComfyUI 的 day-0 支援,配合 Python 及 Gradio 共用的 Diffusers pipeline,本地或雲端皆可即時跑起 demo。

重點摘要:

  • 原生版面控制:JSON prompt 直接描述物件、位置與邊界框,毋須外掛 ControlNet。
  • 5B 緊湊骨幹:兼顧生成效率與微調彈性,prompt 可長達 4K token。
  • 雙版本開源:Base 與 SFT 權重皆公開,Apache-2.0 授權。
  • 多元框架支援:SGLang、vLLM-Omni、ComfyUI 同日適配,並提供 Hugging Face Spaces 線上 demo。
  • 風格覆蓋廣:動漫與寫實風格並重,文字渲染品質為主打賣點之一。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, NVIDIA, Image, 框架, Python, 蘋果

ComfyUI-VoiceWorkbench:本地語音工作台:逐句修正音高與節奏

不用剪碎音檔,便可逐句調整音高、字詞時長、停頓和尾音,並比較不同錄音版本。

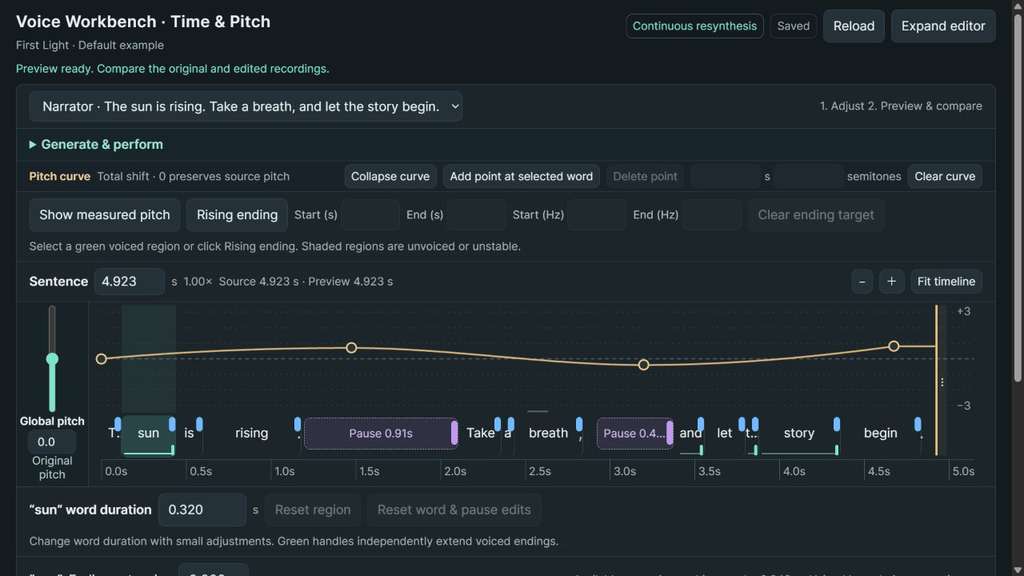
Voice Workbench

想修正一句旁白的語速、音高或句尾拖音時,ComfyUI-VoiceWorkbench 讓你在完整錄音上直接編輯,毋須把每個字剪開再重新拼接。這個項目屬於本地語音編輯工具,實際處理的是生成語音和錄音後期微調之間的卡位;編輯器可作為 ComfyUI 底部面板使用,也能獨立在本機運行。

聲音處理採用一次 Praat resynthesis pass,同時套用整段錄音的時長和音高變化,未修改的預覽則保留原始 WAV bytes。介面可調整 0.75 至 1.25 倍全局速度、全局音高及最多 64 個局部曲線點,亦能處理現有停頓和可靠的 voiced ending;編輯完成後可比較 Original、Edited 與不同生成 take,再回到較早版本。

  • 不用下載模型:內置例子可直接開啟和編輯,Windows 亦可調用已安裝的英文系統語音。
  • 適合本地工作流:支援 Python 3.10 或更新版本,並可接入 ComfyUI custom nodes。
  • 保留人工判斷:字詞邊界只是估算,無聲或不穩定區域不能可靠提供音高目標。
  • 有明確範圍限制:單聲道錄音約 0.15 至 60 秒,AI take 最多 200 字元;服務只綁定 loopback,並非公開共享伺服器。

可選的本地適配器把能力延伸至語音生成和表演編輯:IndexTTS2 支援參考聲線及情緒生成,AuK Base 用於整段錄音的表演編輯,Qwen3 forced aligner 則協助估算字詞邊界。這些元件不是開啟基本編輯器的必要條件,系統語音也不提供聲線複製或情感控制。

適合旁白製作、語音原型和 ComfyUI 使用者處理少量錄音,而不是多人共用的雲端配音平台。尾音延長最多 200 毫秒,目標音高及 voiced 區域亦有上下限;自動對齊不代表每個字都讀得正確,接受修改前仍要逐段聆聽。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Audio, 工具, Python, 語音

Kandinsky 6.0 把同步聲畫生成帶入開源模型

Kandinsky 6.0 可由文字或圖片生成帶同步音效、口形的短片,並提供 3B 與 29B 兩款模型。
promo

由文字或圖片輸入,到畫面、音效和口形同步輸出的流程,Kandinsky 6.0 將短片生成由單純影像延伸至完整 audio-video 內容。這個項目屬於開源多模態視頻模型,實際處理的是聲音與畫面難以同步、創作者需要分開製作素材的問題。

Kandinsky 6.0 Video Lite 有 3B 參數,Kandinsky 6.0 Video Pro 則有 29B 參數,兩者都能生成 5 秒片段、44 kHz 音訊及 lip-sync,支援 text-to-audio-video(T2AV)和 image-to-audio-video(TI2AV)。額外的 super-resolution 模型可把輸出提升至 Full-HD 1920×1080,但這並不代表原生生成階段已經以 Full-HD 運作。

• 同一生成流程處理視頻、音效和口形同步
• Lite 較適合資源有限的測試,Pro 追求更高生成能力
• 支援文字生成及圖片延伸兩種模式
• 可透過 Hugging Face Space、Diffusers、ComfyUI 或 vLLM-omni 接入

測試需要 NVIDIA GPU,以及 Python 3.13 或 3.14;首次執行會下載 Kandinsky-6.0-Pro-distill-5s 權重,輸出會寫入項目指定的 MP4 路徑。對不想自行配置環境的創作者,Hugging Face Space 是較直接的試用入口;需要納入工作流的團隊則可考慮 Diffusers 或 ComfyUI。

在非精簡版顯示卡上處理 5 秒影片片段的工作時間(秒)。不包括負載載入和 MP4 編碼時間。 RTX PRO 6000 (96 GB)、A100 80 GB 和 H100 80 GB 使用模組卸載。消費級顯示卡使用區塊卸載。 RTX 4090、RTX 5060 Ti、RTX 5080、RTX 5090、RTX PRO 6000 和 A100 80 GB 使用 SageAttention2++ 進行視覺自註意力控制。 H100 使用 FlashAttention 3。

RTX 4090RTX 5060 TiRTX 5080RTX 5090RTX PRO 6000A100 80 GBH100
Lite SD4371310577309242532239
Lite HD4221328579296274472203
Lite Full HD5781774770406387664284
Pro SD93630801336754621972356
Pro HD119427161189638561791292
Pro Full HD1247353015468547651106402

Kandinsky 6.0 適合製作概念片、角色對白及需要同步聲畫的短內容,但 5 秒時長、NVIDIA GPU 依賴,以及高解像度要靠額外模型處理,仍限制了它作為長片生產工具的角色。

項目主頁 · GitHub · 模型
Categories: 開源, ComfyUI, 模型, 多模態模型, 視頻模型, NVIDIA, Video, Image, 影像處理, Audio, 工具, Content Creator, Python, Dataset 數據集

AcademiaSD LoRAlab Trainer Studio:訓練影像與影片 LoRA

把多個模型的 LoRA 訓練流程集中到一個介面,支持消費級 NVIDIA 8G 顯卡。

AcademiaSD LoRAlab Trainer Studio

想為角色、物件或畫風訓練 Low-Rank Adaptation(LoRA),不一定要準備高階顯卡;AcademiaSD LoRAlab Trainer Studio 是一套 LoRA 訓練工具,目標是在最低 8 GB VRAM 的消費級 NVIDIA GPU 上處理最新影像及影片模型,並把不同 trainer 收進同一個 Web 介面。

每個模型會以 4-bit NF4 載入,文字編碼器與 VAE 只在 pre-cache 階段執行一次,之後把 GPU 資源集中到訓練。項目支援 Windows 10、Windows 11 及 Linux,使用 Python 3.13、PyTorch 2.14 cu130,以及 Flask + HTML5 介面;同一套安裝環境可加入後續新增的 trainer,毋須為每個模型另建環境。

工作流程包括資料集管理、自動 caption、即時預覽、精確步數續訓及一鍵匯出至 ComfyUI。訓練期間可以修改 steps、儲存及預覽頻率、預覽設定和 learning rate,按下 Save JSON 後,變更會在下一步生效;每個項目亦會分開保存 pre-cache、checkpoint、預覽圖及 LoRA 輸出,刪除快取或訓練內容不會碰到資料集。

  • 匯出的 LoRA 帶有 kohya-style metadata,包含 trigger word、rank、steps 和 resolution
  • CivitAI 及 LoRA managers 可以讀取相關 metadata
  • 一般角色、物件和風格 LoRA 可採用一張圖片配一段 caption
  • 可從同一網絡的其他裝置上載資料集及下載 LoRA

這套工具較適合想在本機反覆試驗、又不想手動管理多個訓練環境的創作者和小型團隊。預覽圖只用來追蹤訓練進度及角色、物件或風格的相似度,不能直接當成最終品質;完成後仍要在 ComfyUI 或 Forge 調整 LoRA 強度及模型品質設定。由於多個模型支援接近同時加入,README 亦明確提醒可能存在錯誤、未完善設定,以及預設訓練參數未必適合每個資料集,使用者需要自行測試並透過 Issues 回報結果。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 工具, Content Creator, Linux, Python, Win, LoRA

Page 1 of 10
1 2 3 … 10