ComfyUI Tutorial Fusion LoRA Easy Compositing


Ovi 使用了專屬預訓練 5B 音頻分支,架構設計類似 WAN 2.2 5B,同時提供了 1B 融合分支,支持純文本或文本+圖片輸入,自動生成視頻、對嘴音頻,以及匹配場景的背景音效和音樂。
Ovi 使用了專屬預訓練 5B 音頻分支,架構設計類似 WAN 2.2 5B,同時提供了 1B 融合分支,支持純文本或文本+圖片輸入,自動生成視頻、對嘴音頻,以及匹配場景的背景音效和音樂。


這個教程介紹如何使用 Flux Kontext 和 VACE 第一幀/最後一幀在 ComfyUI 中創建基於關鍵幀的高級動畫!Kontext 瞭解完整的圖像上下文,而 VACE 允許在起始幀和完全不同的最終姿勢或角色之間無縫移動。無論您是將一個人變形為另一個人,還是為角色的姿勢製作跨時間的動畫,這都是 AI 視頻生成的一個突破。
這個教程介紹如何使用 Flux Kontext 和 VACE 第一幀/最後一幀在 ComfyUI 中創建基於關鍵幀的高級動畫!Kontext 瞭解完整的圖像上下文,而 VACE 允許在起始幀和完全不同的最終姿勢或角色之間無縫移動。無論您是將一個人變形為另一個人,還是為角色的姿勢製作跨時間的動畫,這都是 AI 視頻生成的一個突破。

NVIDIA 與 Black Forest Labs 合作,使用NVIDIA TensorRT軟體開發套件和量化技術針對NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],從而以更低的 VRAM 要求提供更快的推理速度。
NVIDIA 與 Black Forest Labs 合作,使用
NVIDIA TensorRT軟體開發套件和量化技術針對
NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],
從而以更低的 VRAM 要求提供更快的推理速度。
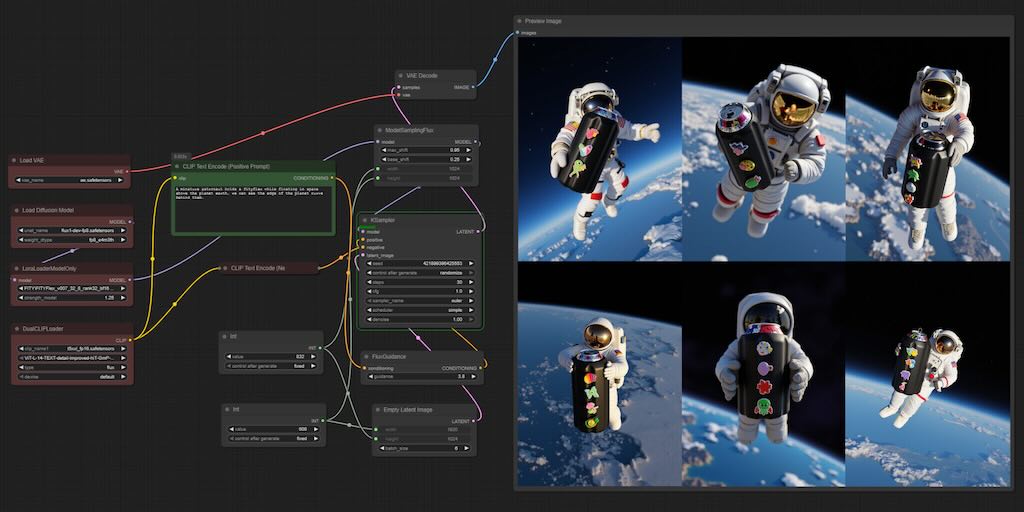
教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。
教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。

1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。 影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)
1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。
影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)

FramePack 是一種新的視頻擴散設計,用壓縮上下文令工作量不會隨著影片的長度而增加,只需一張圖片,就可以令你的 6GB vRAM 的電腦透過 13B 模型生成每秒 30 格影片的 60 秒影片。而用 RTX 4090 的話,最快速度為每格 1.5 秒。 作者 Lvmin Zhang
FramePack 是一種新的視頻擴散設計,用壓縮上下文令工作量不會隨著影片的長度而增加,只需一張圖片,就可以令你的 6GB vRAM 的電腦透過 13B 模型生成每秒 30 格影片的 60 秒影片。而用 RTX 4090 的話,最快速度為每格 1.5 秒。
作者 Lvmin Zhang

