ComfyUI-MiniMaxH3-Easy:幫 H3 補回可用性

把 MiniMax H3 放進 ComfyUI 後,最麻煩的接線、引用同提示編排,被整理成較順手的一套介面。

Mixed media input

做影片生成時,最阻手往往唔係模型能力,而係節點圖愈接愈亂、參考素材愈加愈難管理。ComfyUI-MiniMaxH3-Easy 屬於 ComfyUI 自訂節點工具,集中處理 MiniMax H3 的 text-to-video、image-to-video 同 reference-to-video 工作流,將原本分散嘅媒體接線、參考標記同提示編輯收埋到同一個操作面。

呢個項目最實際嘅改動,在於保留 ComfyUI 彈性之餘,減少你每次都要手動整理素材順序。主節點用一個 Media 輸入口同時接收圖片、影片同音訊,仲會分開追蹤各自次序;一張圖會走 image-to-video,兩張圖就可用作 first/last-frame generation。做 reference-to-video 時,提示編輯器支援 @ 揀選已連接素材,執行時再自動轉成 MiniMax 建議嘅 <Picture N><Video N><Audio N> 格式,唔使自己逐個標籤維護。

  • 將多種媒體收進單一 Media 入口,節點圖會乾淨得多
  • @ 參考編輯器有預覽,較適合需要反覆改 prompt 嘅影片生成流程
  • # 對話區塊可直接寫成可編輯 block,送出時自動轉成 <d>...</d>
  • 可接 model-only LoRASage Attention patch,亦可直接連到模型相關節點

同類做法通常要求使用者自己記住引用格式、接線順序同素材對應,ComfyUI-MiniMaxH3-Easy 選擇用較重介面包裝,換來較低出錯率同較高可讀性。代價亦明顯:它改善嘅係 MiniMax H3 在 ComfyUI 入面嘅操作層,不是另起一個新模型,也未見提供生成品質、速度或資源佔用測試數字,因此價值主要落在工作流整理,而唔係模型性能突破。

較受惠嘅會係已經用開 ComfyUI、但又嫌 MiniMax H3 節點圖太碎太亂嘅創作者、影片實驗團隊同需要反覆比對參考素材嘅人。部署方式亦唔複雜,理解上可以當成安裝到 ComfyUI 內嘅一組工作流節點:接好模型或 LoRA、把圖片或影片餵入 Media、再用內建編輯器整理引用同對話內容,就可以直接進入生成流程。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

MiniMax-H3 Turbo LoRA 移植 ComfyUI,4 步生成同步聲畫

呢個版本唔係重新訓練主模型,而係把 MiniMax-H3 Turbo LoRA 轉成 ComfyUI 可直接載入的格式。重點在於 4-step 加速生成,同時保留聲畫同步能力。

Og image

想用更少步數生成影片同音訊,呢個頁面最值得留意的地方,是它明確基於 Comfy-Org/MiniMax-H3,而且屬於 adapter 形式的 LoRA,不是完整基礎模型。它針對 ComfyUI 使用的 pruned/curve-form MiniMax-H3 checkpoint 做兼容轉換,目的是讓原本由 larryvrh 發佈的 MiniMax-H3 Turbo LoRA — 4-step audio-video generation preview,可以透過 ComfyUI 內建的 MiniMax-H3 LoRA 載入流程使用。

技術上,核心價值在於把原始 Turbo LoRA 的 four-step distillationdual video/audio sampling 帶入 ComfyUI 工作流。4-step 代表生成步數大幅壓縮,推理延遲有機會下降;頁面同時指出 non-EMA 權重較銳利、較能保持快速動作,EMA 權重則較平滑,但因為當時 EMA 未完全成熟,畫面會較柔。呢種取捨直接影響你想要的觀感:動態表現優先,可先看 non-EMA;畫面過渡想更順,EMA 版本更值得比較。

檔案方面,頁面列出 4 個 .safetensors LoRA 權重,包括初始兼容轉換版,以及兩個 further-trained checkpoint-500 變體:minimax_h3_turbo_4step_pruned_comfyui.safetensorsminimax_h3_turbo_4step_ema_pruned_comfyui.safetensorsminimax_h3_turbo_4step_ckpt500_pruned_comfyui.safetensors,以及對應的 EMA checkpoint-500 版本。

  • 基礎模型已明示為 Comfy-Org/MiniMax-H3,屬於 LoRA adapter 兼容轉換
  • 主要能力是 text-to-video,並帶有 text-to-audioaudio-videosynchronized-audio 標籤
  • 重點方法來自原作者的 four-step distillation,目標是加速推理
  • 頁面提供 ComfyUI workflow 範例下載,定位很明確:直接服務 ComfyUI 用戶

這個 Hugging Face 頁面是第三方整理的 ComfyUI 相容版本,價值在於把原始 MiniMax-H3 Turbo LoRA 接入 ComfyUI 生態,方便直接測試 4-step 聲畫同步生成與 checkpoint-500 變體之間的差異。

項目主頁

Categories: 開源, ComfyUI, 視頻模型, Video, Audio, MiniMax

ComfyTV 把 ComfyUI 拉進完整媒體工作流

想用 ComfyUI 做圖、剪片同整理素材,通常要在多個介面之間跳來跳去。ComfyTV 把這些步驟收進同一個畫布,重點不只生成,仲包括挑選、編修同輸出。

ComfyTV canvas overview

做生成內容唔少人最怕流程一長就難改、難追版本,ComfyTV 針對的正是這個卡位。它屬於建基於 ComfyUI 的畫布式媒體工作台,將生成、挑圖、編輯、合成到輸出串成同一條流程,處理範圍橫跨 image、video、audio、music、panorama、2D layers 同 3D,而唔係停留喺單次出圖。

跟一般要靠 ComfyUI 全域 queue 推整條鏈不同,ComfyTV 採用 per-node run,每個 stage 可以獨立重跑,下游只會接住上游最近一次輸出的 snapshot。這種做法減少反覆測一小步時牽動全流程的等待,代價是你要更清楚每個節點當下吃的是哪個版本輸出,但對長流程調整明顯更順手。

它的另一個重點是以項目為中心管理素材與歷史。每個 stage 都掛在同一個項目內,輸出會連同歷史保留,重新載入後可還原;再加上 asset library、resource library 同 prompt fragments,可直接在提示詞用 @ 引用。README 亦提到可匯入任何 ComfyUI workflow JSON,在側邊欄綁定輸入、保存 stage preset,並透過 Bridge nodes 接第三方插件,甚至登記遠端 ComfyUI 機器做 runner。

內容深度比一般前端殼再走前一步,現時提供約 190 個 stages,而且不少節點內置真正編輯器,例如 layer editor、storyboard workbench、piano rolls、3D viewports 同 scopes,部分 video effects 亦有 live preview。2D 編輯一段還延伸到 PSD import/export、Fountain script import 這類偏製作流程的功能,顯示它瞄準的是需要持續迭代的創作項目,而唔係一次性玩效果。

  • 把 ComfyUI 擴展成完整媒體工作台,覆蓋生成、編修、合成與輸出
  • per-node run 減少重跑整條流程的等待,適合長鏈路反覆微調
  • 以項目保存 stage 歷史、素材與資源,較方便追版本同回復狀態
  • 可匯入 ComfyUI workflow JSON,兼容 subgraphs、第三方 plugins 同遠端 runners
  • 約 190 個 stages,加上節點內編輯器,定位比純工作流編排器更完整

它依賴你現有的 ComfyUI 生態與本地模型,較像建在 ComfyUI 之上的創作界面層,而唔係獨立模型服務。適合已經有一批 workflows、想將 image、video、audio 放入同一項目管理的團隊或創作者;純粹只求最快出一張圖的人,未必需要它這麼重的工作台結構。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, 3D,

用 Hermes Agent 自動跑 ComfyUI 影片流程

打幾句文字指令,就能讓 Hermes Agent 在 Windows 控制 ComfyUI,串起影像、聲音到影片生成流程。

Og image

由文字指令直接帶動整條 AI 內容製作流程,正是這段教學最吸引人的地方。影片示範 Hermes Agent 在 Windows 電腦上接手 ComfyUI 操作,把影像、語音與影片生成串成一套可執行工作流,減少人手逐步點擊介面的時間。

這類做法處理的,是多工具協作時常見的斷層:模型會生成內容,但流程仍要靠人逐格設定、切換節點、整理輸出。Hermes Agent 扮演的角色更接近可執行指令的 Agent,讓使用者用自然語言描述需求,再由它推動 ComfyUI 與相關模型完成步驟。

影片標題提到的 Krea 2、LTX 2.3、Qwen 與 Fish Audio,反映這條工作流並不只限於單一模型,而是把視覺、影片與音訊能力接在一起。重點不在單一模型參數,而在於怎樣把不同項目整合成可重複使用的自動化流程。

  • Hermes Agent 可在 Windows 環境控制 ComfyUI
  • 工作流涵蓋影像、音訊與影片生成
  • 輸入形式以簡單文字指令為主
  • 涉及 Krea 2、LTX 2.3、Qwen、Fish Audio 等模型或服務

對內容創作者、想整理 AI 製作流程的人,這類教學特別有參考價值。它未必代表所有步驟都能完全免調整,但已清楚展示 Agentic 工作流如何把 ComfyUI 由節點工具,進一步變成可自動執行的製作中樞。

項目主頁

Categories: ComfyUI, Agentic, AI productions, 視覺模型, 視頻模型, Qwen, Google, Video, Audio, 教學, 安全, LTX

CrossView 用 3D 數值控制鏡頭:LTX-Video 跨視角生成

同一段影片想換個拍攝角度,通常最難是保住人物一致性與空間感。這個 IC-LoRA 用深度 warp 加原片雙參考,讓跨視角生成更可控。

Og image

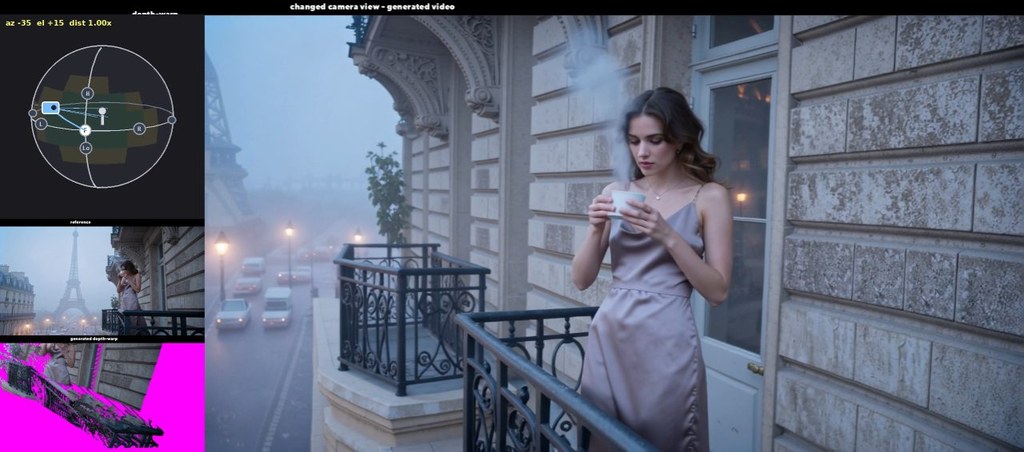
想將一段現成影片改成另一個鏡頭角度,又唔想主體變樣或空間關係散掉,這正是此模型處理的問題。它明確基於 Lightricks/LTX-2.3,屬於 LTX-Video 2.3 22B 的 IC-LoRA 微調,重點不是純文字改鏡頭,而是用輸入影片加相機偏移數值,重建同一場景的新視角。

頁面提供的做法幾清楚:模型同時接收兩段參考影片,一段是由 CrossViewWarp ComfyUI node 產生的 depth-warp 影片,用來保留幾何結構;另一段是原始影片,用來維持主體 identity。這種雙參考分工,反映它優先解決「換角度後仍要似原片」的取捨,比單靠 prompt 描述鏡頭更穩定。

它與同作者的 CrossView Prompt LoRA 差異亦很直接:後者由文字提示選鏡頭角度,這個版本改為輸入 azimuth / elevation / distance 等數值,所以鏡頭控制更精確。頁面亦提到可以在 3D orbit picker 加 keyframes,逐幀插值相機姿態,代表不只可做固定新視角,也可做繞拍式 camera move。

  • 基礎模型已標明為 Lightricks/LTX-2.3,授權為 Apache-2.0
  • 主要檔案是 LTX2.3-22B_IC-LoRA-CrossView-Warp_v0.9_18000.safetensors
  • 依賴 ComfyUI-CrossViewWarpDepth Anything V2 節點提供 depth 輸入。
  • 示例包含固定視角偏移與 keyframed 軌道鏡頭,並說明輸出來自真實影片而非合成訓練片段。

這個項目目前仍是 PoC,它較偏向 ComfyUI 工作流驗證,而不是通用本地大語言模型部署。

模型

Categories: 開源, ComfyUI, AI productions, 視覺模型, 視頻模型, Video, 3D, LTX

JoyAI-Image 想做懂空間的影像模型

JoyAI-Image唔只想生圖,仲想令模型真正理解畫面入面物件點擺位、點互相關聯。對要做指令修圖、排版生圖同多視角內容的人,呢個方向幾有參考價值。

Repository image for jd-opensource/JoyAI-Image

改圖最怕模型聽得明文字,卻改壞原本場景結構;生圖亦常見字排得唔準、物件關係走位。JoyAI-Image就係朝住呢個痛點落手,定位屬於多模態基礎模型,把影像理解、text-to-image 生成同指令式編輯放入同一個模型家族,重點處理空間理解不足帶來的失真與失控。

唔係把理解模型同生成模型鬆散拼埋,而係用 8B Multimodal Large Language Model (MLLM) 配 16B Multimodal Diffusion Transformer (MMDiT),強調理解、生成、編輯之間的閉環協作。換句話說,模型唔只讀圖後再畫圖,仲會利用視角變換等生成結果反過來補強空間推理,呢點令它在 grounded generation、關係定位同可控編輯上有更鮮明方向。

現有公開內容顯示,部署路線算完整,已提供 Hugging Face 權重、Diffusers 版本、ComfyUI 原生支援,同埋可直接參考的 workflow;另外亦有 Spatial Edit 同 General Edit 示範空間。對內容製作、電商視覺、設計流程或者研究多模態編輯的人,較值得留意的是它不只處理單次修圖,仲想處理長文字排版、版面忠實度、多視角生成,以及「指定物件移去指定位置」呢類容易出錯的操作。

JoyAI Image Edit Plus in ComfyUI - How Does it Compare?
  • 把理解、生成、編輯整合到同一條多模態流程
  • 核心賣點係較強的 spatial intelligence,而不只是畫面更靚
  • 已有 Diffusers 與 ComfyUI 兩條使用路線,測試門檻較研究原型低
  • 延伸到 OpenSpatial data engine 同 OpenSpatial-3M dataset,反映它連資料與訓練配方都一併公開

效能方面,儲存庫描述集中在能力展示與訓練設計,現階段較適合把它理解成一個方向清晰、工具鏈逐步成熟的開源影像模型項目。最吸引之處唔係單一指標,而係它把空間理解當成生成與編輯的核心能力,對需要更穩定版面、關係同位置控制的工作流,確實比單講畫質更實用。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, 視覺模型, 多模態模型, Qwen, Image, txt2img, Dataset 數據集

Sana 把高解像生成壓到快 100 倍

想做高解像圖片或影片生成,又唔想計算成本高得難以落地,Sana 提供了一條幾實際的路。它把訓練、推理到不同變體放在同一套代碼庫,重點放在速度與畫質之間的平衡。

logo

高解像圖片同影片生成最常見的卡位,不是效果做不到,而是算力、延遲同部署成本太難接受。NVlabs/Sana 屬於生成模型代碼庫,集中處理這個矛盾:在維持高解析輸出的前提下,把訓練與推理做得更省、更快,並且一路延伸到圖片、影片、世界模型等多條分支。

這個項目唔係單一模型,而是一個家族。SANA 主打最高到 4K 的 text-to-image,README 直接給出「比 Flux-12B 細 20 倍、快 100 倍」的定位;SANA-1.5 進一步處理訓練期與推理期的 compute scaling;SANA-Sprint 則把重點放在 one/few-step 生成,官方數字提到 H100 上 1024px 圖片可做到 0.1 秒級。取向很清楚:不是一味追最大模型,而是用效率換取更可部署的生成流程。

影片部分同樣值得留意。SANA-Video 與 SANA-Video 2.0 把焦點放在 720p 長序列生成,做法上用 hybrid linear attention 配合 Attention Residuals,目的是減少 full-softmax attention 的成本,同時盡量保住畫質與長序列表達能力。公開資料提到 SANA-Video 2.0 在單張 H100 上,720p/5 秒影片可做到 13.06 秒,VBench 總分 84.30,也強調比 Wan 2.2 14B 有大幅速度優勢,但這類數字仍要連同硬件、步數與設定一齊理解。

  • 同一庫內含 SANA、SANA-1.5、SANA-Sprint、SANA-Video、SANA-WM、SANA-Streaming、Sol-RL
  • 提供完整 training 與 inference pipeline,唔止展示模型效果
  • 可透過官方 demo、Hugging Face、ComfyUI 整合去理解生成表現與部署方向
  • 重點不是極限參數量,而是高解像生成的速度、成本同可擴展性

部署與測試路線相對清晰:已有官方文件、網頁 demo、Hugging Face 集合,亦見到 ComfyUI、SGLang、Replicate 等接點,代表它較適合研究團隊、影像工作流開發者,以及想把高解像生成放進產品流程的人。 SANA-WM 的 2.6B controllable world model、6-DoF camera control,同 Sol-RL 的加速收斂能力,則顯示這個項目不只做靜態出圖,而是朝更完整的生成系統推進。

項目主頁 · GitHub

Categories: 開源, ComfyUI, AI productions, 世界模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, txt2img

ComfyUI XY Plot 的乾淨做法

這段教學聚焦喺 ComfyUI 入面做 XY Plot,重點係唔使靠複雜接線同自訂 KSamplers。你可以把它理解成一個更乾淨的測試方式,方便比較不同設定對出圖結果的影響。

Og image

這段內容講的是 ComfyUI 裡的 XY Plot 用法,重點不在花俏效果,而在怎樣保留乾淨流程,同時方便比對不同參數、模型或提示詞的輸出差異。對經常要試圖、做視覺比較、或整理生成結果的人來說,這種做法會比把工作流拆得很碎更順手。

影片想解的問題很直接:不少 XY Plot 教學都會逼人用很重的接線、侵入式的自訂 KSampler,甚至把原本清晰的工作流弄得難以維護。這裡提出的取向是盡量少改動主流程,讓比較測試留在 ComfyUI 的正常操作邏輯裡完成。

它的價值主要在這幾點:
– 保持工作流較乾淨,較易重用
– 減少對自訂節點的依賴
– 方便橫向比較不同設定的效果
– 較適合要反覆調參的圖像生成工作

整體來說,這類做法對常用 ComfyUI 做實驗的人最有用,尤其是需要快速看清楚某個參數改動帶來什麼差別,而唔想每次都重砌一套流程。影片屬於教學內容,沒有提供模型評測數據,但方向很明確,就是用更少干擾的方式做 XY Plot。

項目主頁

Categories: ComfyUI, 教學

Semantic Browsing:用樹狀圖掌控 AI 生圖的多樣性

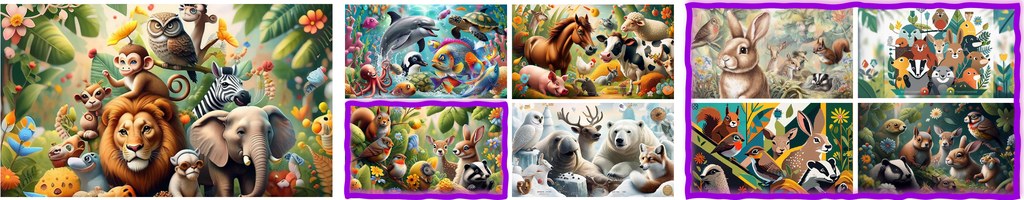
Tel Aviv 大學團隊提出 Semantic Browsing,以多智能體流程把單一文字提示展開成可瀏覽的語意樹,讓圖像生成的多樣性變得可控且可解讀。

Og image

Semantic Browsing 是一篇發表於 ECCV 2026 的學術項目,由 Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or 共同開發。它針對文字生成圖像模型在重複取樣時容易「語意塌縮」、產出過於雷同的問題,提出一套可控多樣性的工作流程。

這套方法的核心做法,是把多樣性從像素層級搬到文字層級。系統會先用多智能體(multi-agent)流程把使用者的提示擴寫成結構化的場景 JSON,記錄物件、屬性、互動與整體場景設定,再從中找出提示中未明確指定、但合理的變化軸心。每一次分支都對應一個明確的語意決定,例如角色、構圖或風格的差異,最終形成一棵可瀏覽的場景樹。

與一般常見做法相比,這個項目最值得留意的差異在於:變化不是來自隨機噪聲,而是來自可解讀的語意約束。樹狀結構讓使用者可以沿著特定分支往下探索,同時保留先前已固定的條件,方便在設計空間中做有意識的導覽。

重點摘要:

  • 開發團隊:Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or。
  • 核心方法:以多智能體流程把提示展開為結構化 JSON 場景樹。
  • 可控多樣性:每個分支對應一個明確的語意決定,而非隨機變化。
  • 適用情境:概念設計、視覺探索、需要比較多個語意詮釋的創作流程。
  • 目前狀態:程式碼尚未公開,僅釋出 arXiv 論文與項目頁。

使用方法詳細教學:

  1. 準備提示:先寫好一段文字提示,例如「A poster featuring animals」,提示中可以刻意留白部分細節,讓系統有空間展開變化。
  2. 進入項目頁:前往 Semantic Browsing 的官方網頁(saradorfman1.github.io/SemanticBrowsing-webpage/),等待互動介面載入。
  3. 送出提示並生成根節點:系統會先推論出一個初始場景詮釋,作為場景樹的根節點。
  4. 瀏覽與選擇變化軸心:介面會列出可變化的語意面向,例如角色、構圖、風格等,每個面向都會顯示目前值與替代選項。
  5. 展開分支:選定一個面向並挑選替代值後,系統會呼叫多智能體流程,在保留先前約束的前提下產生新的子節點與對應圖像。
  6. 沿著分支深入探索:可以重複步驟四與五,沿著感興趣的路徑繼續往下展開,逐步建立一棵專屬的設計樹。
  7. 匯出或記錄結果:若需要保留特定分支,可記下該節點的場景 JSON 或截圖,作為後續迭代或團隊溝通的依據。

由於程式碼尚未釋出,目前只能透過項目頁的示範介面體驗流程;待官方開源後,便能整合進 ComfyUI、Stable Diffusion 等本地生圖工作流。對於從事概念設計、視覺探索,或需要比較多個語意詮釋的創作者與研究人員來說,這套方法提供了一條比隨機抽樣更可控的探索路徑。

項目主頁: https://saradorfman1.github.io/SemanticBrowsing-webpage/

Paper: https://arxiv.org/pdf/2606.23679

Categories: 開源, ComfyUI, Agentic, 模型, 視覺模型, Stable Diffusion, Image, 影像處理, 教學

FreeStyle:用社群 LoRA 做雙參考生圖

FreeStyle 不只放出資料,亦重整了雙參考生圖的訓練與評測方法。它的焦點是減少風格參考偷帶內容,同時保住畫風。

FreeStyle teaser

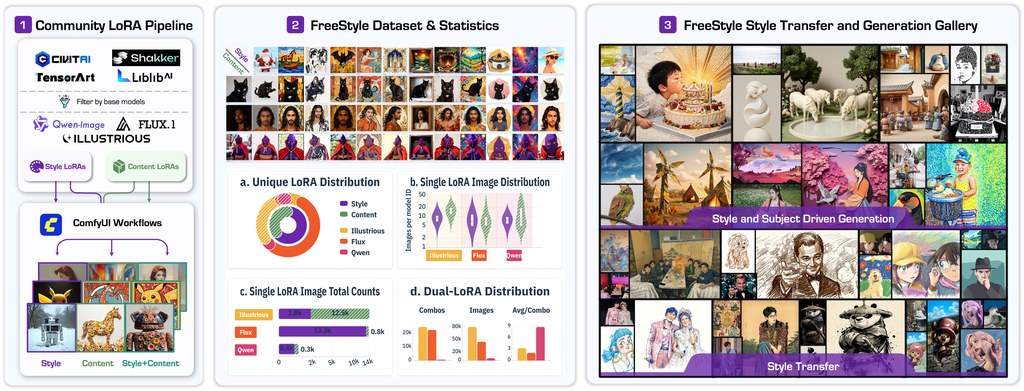
現時不少 style-reference 生成,只處理單一風格參考;至於 content + style dual-reference,常見難位是資料難整、風格長尾不足,兼且 style reference 容易把人物、物件等內容一併「滲」入結果。FreeStyle 把社群 LoRA 視為風格或內容概念的聚類中心,再配合自動生成與過濾流程,重組出可訓練的雙參考資料,連 benchmark 一起補上。

這不是單純模型,而是一個結合資料管線、benchmark 與 DiT-based model 的影像生成項目,目標是解決 SRef 與 CRef+SRef 兩類任務中,內容保持、風格對齊與 leakage suppression 很難同時兼顧的問題。文中提出 attention-level constraint,以及 RoPE low-frequency modulation,核心取向很清楚:寧可多做約束,也要壓住 style-reference content leakage。

資料規模是 FreeStyle 最有份量的部分。CRef+SRef dataset 提供 480K sequences,涵蓋 1,704 種 styles;SRef dataset 則有 619,302 sequences、622 種 styles。評測亦不只看靚唔靚,還加入 CSD、OneIG、DINOv2、CAS、CLIP-T、aesthetic predictors 及 VLM-as-judge,將 style similarity、content preservation、instruction following 同 leakage rejection 分開量度。

想理解怎樣測試這個項目,較合理的做法是分三層看:先用公開 dataset 與 benchmark 檢查資料結構;再看 repo 提供的 LoRA metadata 與 ComfyUI workflows,理解 triplet 怎樣生成與驗證;最後才研究 checkpoint 表現。它較適合研究團隊、做可控生圖的產品組,或者本身已在用 FLUX、Qwen、Illustrious 生態的人。

  • 把 Civitai、TensorArt、Liblib 的社群 LoRA 變成可用訓練訊號
  • 同時覆蓋 SRef 與 CRef+SRef,而非只做單一風格參考
  • 重點不是單純追求風格像,而是壓低內容洩漏
  • 提供 dataset、benchmark、workflow、checkpoint,便於重現整個流程

相關模型與基礎生態包括 DiT-based model、FLUX、Illustrious、Qwen,以及資料生成用的 ComfyUI workflow。若你關心的是商用穩定性,仍要留意它相當依賴社群 LoRA 品質與過濾流程;作者亦有講明,原始 LoRA 權重本身未必會隨項目再分發。

GitHub: https://github.com/Blue2Giant/FreeStyle

項目: https://blue2giant.github.io/FreeStyle/

Categories: 開源, 阿里巴巴, ComfyUI, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Stable Diffusion, Image, 影像模型, 影像處理, 工具, Content Creator, Sora, Meta, Dataset 數據集

Page 4 of 8
1 2 3 4 5 6 8