Qwen3.6 全新的動態 NVFP4 量化器

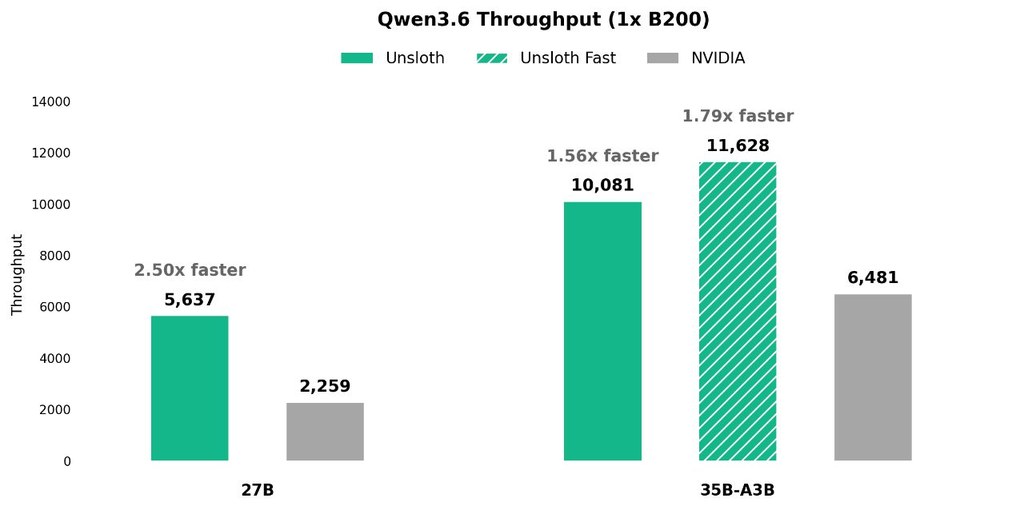
運行速度比其他 NVFP4 量化器快約 2.5 倍,效能更佳,檔案大小也相近。在24GB 記憶體上,Qwen3.6-27B NVFP4 的運行速度提升 2.5 倍;在32GB 顯存上,Qwen3.6-35B-A3B 的運行速度提升 1.7 倍。

Og image

想喺自己電腦上跑到規模較大的多模態模型,最大卡位通常唔係功能,而係記憶體同速度。Qwen3.6 屬於阿里巴巴的新一代多模態 hybrid-thinking 模型系列,重點在於用相對可控的硬件需求,處理 agentic coding、vision 同 chat 等工作。

現有資料提到兩個主力型號:Qwen3.6-27B 同 35B-A3B。前者可在約 18GB 記憶體配置下運行,後者約需 22GB 至 23GB 左右,並支援 256K context 及 201 種語言。對想喺本地做長內容理解、跨語言對話,或者配合工具調用工作流的人來說,這個取向幾實用。

相比只講「可量化、可本地跑」的常見做法,Unsloth 這邊更著重點樣揀到速度與準確度較平衡的版本。Qwen3.6 GGUFs 採用 Unsloth Dynamic 2.0,會按真實使用資料做 calibration,並把重要 layers upcast;另外新推出的 NVFP4 quants 主打在 GPU 上帶來約 2.5 倍更快速度,MTP 則標示可把 inference 再加快 1.4 至 2.2 倍,同時不犧牲準確度。

  • 適合本地部署多模態模型,兼顧編碼、視覺與對話
  • 27B、35B-A3B 記憶體需求相對克制,較易在個人設備起步
  • GGUF 格式配合 Unsloth Dynamic 2.0,重點是量化後仍保持可用表現
  • NVFP4 與 MTP 主要改善推理速度,幫助減少等待時間

使用上仍有幾點要留意:總可用記憶體最好高於下載的量化模型大小,否則雖然可經 llama.cpp 用 SSD/HDD offloading 繼續運行,但推理會慢得多;文件亦明確提醒不要使用 CUDA 13.2,以免輸出異常。整體來看,這不是單純把 Qwen3.6 搬到本地,而是把「跑得動、跑得快、精度仍可接受」這幾個取捨整理得更清楚。

所引用的模型列表:Qwen3.6-27B、Qwen3.6-35B-A3B。
項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, MCP, 模型, 多模態模型, Qwen, NVIDIA, API, 教學, Medical醫學, Python, 編程, OpenClaw, Anthropic

UniClawBench 點樣測主動式代理

要比較主動式 AI agents,單看單輪答題已經唔夠。UniClawBench把工具操作、瀏覽器、檔案同 GUI 流程放入同一個閉環評測。

UniClawBench

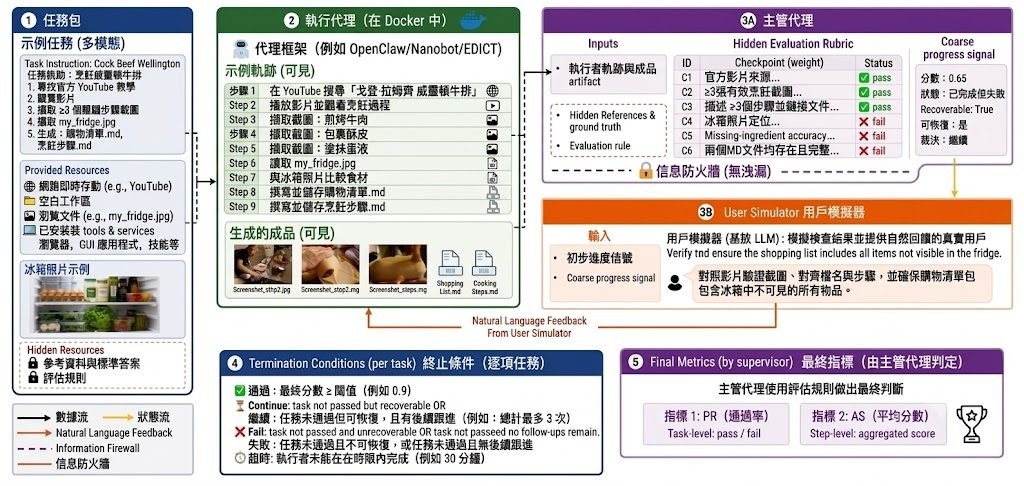
比起只問模型識唔識答,UniClawBench更在意代理能否一路做、一路修正,直到完成整個工作流。它屬於benchmark 項目,針對 proactive AI agents 在真實工具、瀏覽器、檔案處理與桌面 GUI 任務中的完成能力,補足傳統單步評測難以反映連續操作表現的缺口。

現有做法常把 agent evaluation 壓縮成靜態問答、固定軌跡重播,或者只看最後答案;作者明確改用 three-role closed-loop evaluation framework,將 executor、hidden answer supervisor 同 public user simulator 分開。呢個設計的重點,是同時檢查代理點樣行動、途中有冇偏離、收到回饋後能否繼續修正,而唔係只計一次輸出啱唔啱。

公開版本提供 400 個雙語任務,英文與中文各 200 個,覆蓋 Skill Usage、Exploration、Long Context、Multimodal、Cross Platform 五類能力。部署思路亦算清晰:倉庫已放入 packaged task resources、Docker-based runtimes、distributed dispatch scripts,同埋可檢視 leaderboard、trace、artifacts 與 timeline 的 WebUI;要跑測試,核心其實是先填好 executor、Codex provider 同 API keys 相關設定檔,再用它的執行環境批次評估。

  • 用 three-role 閉環評測取代一次性答題
  • 任務同時涉及 browser、files、GUI apps 與其他工具
  • 400 個雙語任務,較易檢查跨語言穩定性
  • WebUI 可回看 traces、artifacts 同示範流程

從補充資料看,作者想指出的取向幾鮮明:framework choice 對能力表現的影響,往往比 model choice 更大,而 long-context 與 multimodal 仍是主要瓶頸。相關模型與組合亦有列出,例如 GPT-5.4、Claude Opus-4.8、Kimi-2.6,並配合 OpenClaw、EDICT、Nanobot 等框架比較;對研究 agent system、企業內部自動化流程,或者想建立較完整評測流水線的團隊,這個項目的參考價值高過單純看排行榜。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, Agentic, 多模態模型, OpenAI, API, 框架, OpenClaw, Anthropic, Dataset 數據集, Skill 技能

IdeasHaveGenomes:用血統追蹤科研點子

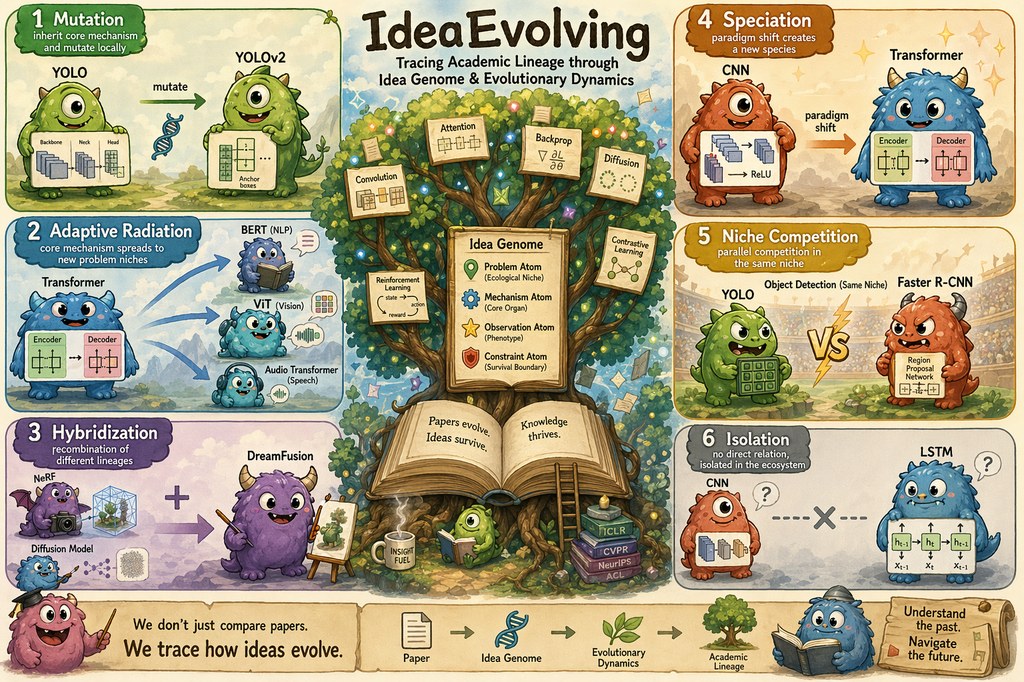
研究提案寫得像樣,未必代表模型真正明白想法點樣演化。IdeasHaveGenomes把重點放在「點子血統」,專門測試 AI 能否追蹤繼承、變化同重組。

Ideas Have Genomes overview

只會搵相似論文,已經唔足夠判斷 AI scientist 是否真係理解研究想法。IdeasHaveGenomes 把科學點子當成有 lineage 的對象去看,屬於 benchmark/數據集類型的項目,針對的正是 Auto Research 入面最難驗證的一環:模型能否講清楚一個 idea 由邊度嚟、點樣修補舊限制,最後點解值得延伸。

現有做法好多時集中在 related paper retrieval、proposal writing,或者用開放式生成結果做人手印象分。作者認為呢種範式捉唔到 inheritance tracing 同 evolutionary reasoning,所以提出 IdeaGene-Bench(IG-Bench),把任務分成封閉式測試 IG-Exam,同埋用 Population-Evolution Score(PES)評分的 IG-Arena,前者問理解是否精準,後者先看生成內容有冇 lineage 根據。

項目的可取之處,在於它唔只問「像不像新點子」,而係追問 Heredity、Variation、Selection 有冇成立。資料規模亦算完整,包括 1,961 條 golden lineage traces、1,085 個 Idea Genome objects、920 筆 GenomeDiff records,覆蓋 10 個 scientific domains;IG-Exam 進一步拆成 42 類 task、1,029 個 closed-form instances,適合做可重覆比較。

  • IG-Exam 主要測 abstraction、inheritance tracing、evolutionary reasoning、lineage verification
  • IG-Arena 針對開放式提案生成,用 PES 檢查血統延續與變化是否合理
  • 項目可用 OpenAI-compatible API 跑 smoke test 或完整評測,不一定綁死單一模型
  • 現有結果反映難度高,最佳 IG-Exam exact accuracy 只有 27.3%,最佳 T4 verification 為 17.4%
  • 榜單涵蓋 GPT、Claude、Qwen、Gemini、DeepSeek,以及 AI Scientist v2、Codex、Claude Code 等系統

部署理解上,這不是拿來直接替代研究助手的成品工具,而是用來測試模型或 agent workflow 是否真的具備「科研點子血統推理」能力。較適合做 AI scientist、research agent、proposal generation pipeline 的團隊評測基準;想比較不同模型、judge 組合,或者檢查生成提案有冇沿住正確 lineage 發展,這個項目比一般文字基準更有辨識度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, 微軟, OpenAI, DeepSeek, Gemini, API, 框架, Anthropic, 中國, Dataset 數據集

AgentCanvas:把 embodied agent 變成可編輯圖譜

想試 embodied agent,最花時間往往不是想法,而是把模擬器、模型與工具串起來。AgentCanvas 把這層 execution stack 圖像化,方便研究團隊直接改結構、跑實驗、比較結果。

AgentCanvas editor: the MapGPT executor loads as a node-and-wire graph, then a live R2R episode runs end-to-end

卡位不在模型夠唔夠新,而在整個 embodied agent 系統太厚:simulator、perception、memory、planning 同 control 全都要接通。AgentCanvas 把這件事收斂成可執行的 typed graph 平台,用單一 JSON 保存一個 agent 結構,讓 VLN、EQA、VLA 一類工作不再每次都由 execution layer 重搭起步。

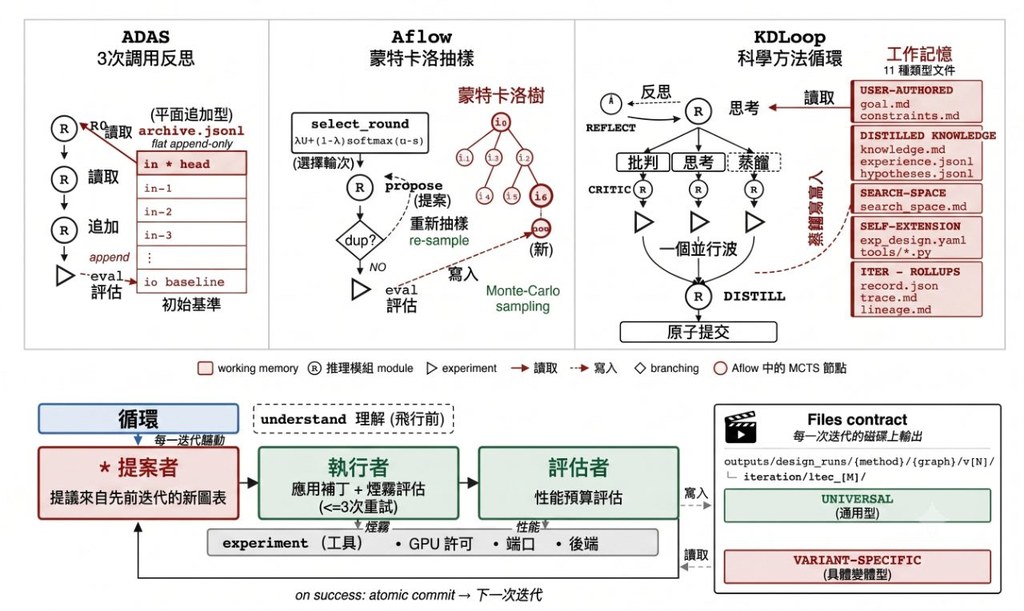
這個項目是把 embodied agent 改寫成可視化、可重播、可修改的圖譜程式。現有做法多數靠手寫 imperative code 逐層綁死 simulator、工具與 foundation models,作者認為這種範式難以比較、難以重現,也不利 architecture search;所以 AgentCanvas 先提供 substrate,再用 KDLoop 與 AAS 讓 coding agent 反覆改圖、驗證、再分析。

AgentCanvas 重點放在把 agent 結構標準化,而不是只交一份論文內部 executor。你可以在 editor 直接載入節點圖,跑真實 R2R episode,也可接 Habitat-Sim、MatterSim、SAPIEN/ManiSkill2、MuJoCo/robosuite 這些 simulator;新加入的 Source tab 還可就選定 node 回看 source slice,改完再 syntax-checked hot-reload,這對反覆試設計特別有用。

  • 支援 hand-built graphs,也支援 AAS 自動搜尋 agent 架構
  • 已接入 29 個 foundation models,包括 Qwen3-VL、InternVL3、Gemma 3、SmolVLM2、SigLIP2、OWLv2、Grounding DINO
  • 可覆蓋 VLN、EQA、VLA 與鄰近 embodied 任務
  • 研究預覽版已開源,環境基礎要求為 Python 3.10+

受益最明顯的,會是做 embodied AI 的研究團隊、要重現論文 executor 的學生,以及想比較不同 graph 設計而不是重寫整個系統的人。現階段它仍是 pre-1.0 research preview,性能數字應結合原論文結果閱讀;但單看定位,AgentCanvas 最有價值的地方,是把「難以維護的 agent 系統工程」變成「可被搜尋與修改的圖譜工作流」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, Qwen, Gemini, VLA, 框架, Vibe Coding, Python, 編程, Anthropic, Dataset 數據集

OmniRoute:免費 AI 路由閘道值唔值得用

想用 Claude Code、Codex 或 Cursor,又唔想被單一供應商限額綁死,OmniRoute 提供咗一條幾務實的路。它把免費模型池、備援切換同壓縮節省 token 放埋一齊。

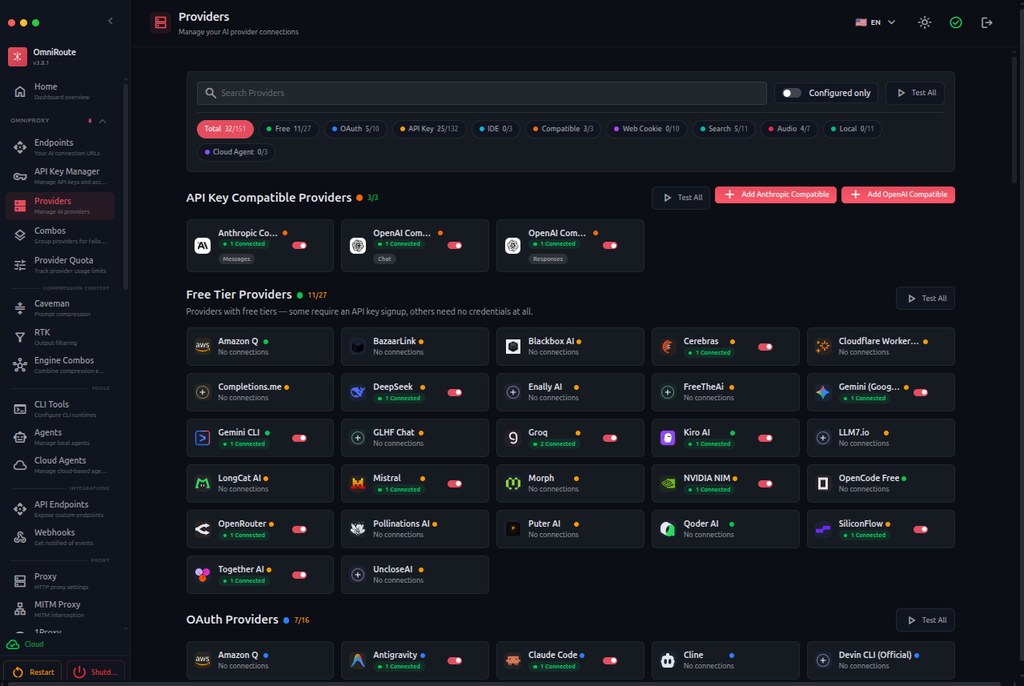
OmniRoute Dashboard

寫程式最怕做到一半先撞到配額上限,或者工具只綁死某一個模型。OmniRoute 把自己放在 AI gateway 呢個位置,直接處理多個 AI coding 工具同多個模型供應商之間的路由問題,重點唔係再造一個聊天介面,而係幫你維持請求可用、控制成本,並用 auto-fallback 減少中斷。

同類做法通常會主打單一 API 聚合,OmniRoute 的取向明顯更偏向「免費額度整合 + 路由策略 + 壓縮節流」。它聲稱可接到 237 個 providers,當中 90+ 提供 free tiers,並以 RTK + Caveman compression 把 token 消耗壓低 15% 至 95%。呢個方向的好處係對長提示、程式碼上下文同重複輸出較有幫助,但壓縮始終係取捨,所以它加咗 inflation guard,遇到壓縮後反而變長,就會送回原文。

OmniRoute + OpenCode: 100% Free AI Coding Setup, Free AI Gateway
New FREE Unlimited AI Coder | OmniRoute

你可以把它理解成放在 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity 後面的中介層。部署後,工具經同一個 endpoint 出請求,再由 OmniRoute 分配到 Claude、GPT、Gemini 及其他供應商;README 也提到每個模型會列出本月已用與剩餘額度,並標示 provider terms,這點對團隊控管比較有用。

幾個值得留意的重點:
– 定位屬於工具 / 閘道型軟件,解決的是多模型切換、免費額度整合同配額中斷
– 支援 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity,適合多工具並行的開發流程
– 以 documented free tokens/month 作招徠,現有資料提到穩定約 1.6B,首月可到 2.1B
– 內建 17 routing strategies,並加入 auto-fallback,減少單一 provider 失效帶來的停頓
– 壓縮模組已針對 German、French、Japanese、Chinese,以及 Gradle、.NET 輸出做過強化

受益最大的一般會係重度依賴 AI 編碼助手的個人開發者、細團隊,同想把成本壓到最低的實驗性項目。要留意的是,免費池本身受各 provider 條款影響,OmniRoute 雖然強調統計方式較透明,但效能與穩定性仍然建基於外部服務;它較像一個把資源調度做得更聰明的控制層,而唔係保證品質一致的模型平台。

GitHub

Categories: 開源, 微軟, Gemini, API, Vibe Coding, 工具, IDE, 編程, Anthropic

MuseBench 用藝術理解考驗 MLLMs

MuseBench唔係測模型見到咩,而係追問點解作品要咁表達。呢套 benchmark 把多模態理解拉到藝術語境,難度明顯高過一般視聽問答。

Repository image for musebench/musebench-code

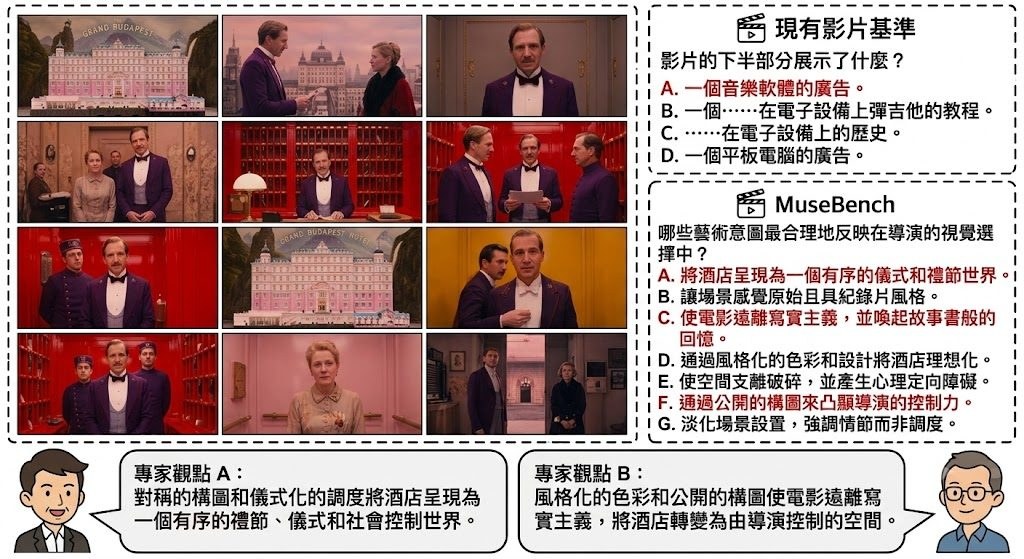
見到畫面、聽到聲音,未必等於真係明白作品想點講。MuseBench 把焦點放到 artistic intent,專門測 multimodal large language models(MLLMs)能否由視聽證據推斷創作選擇背後的意思;它屬於 benchmark/數據集型項目,處理的是現有評測多數只停留在 perceptual recognition,未能反映藝術理解深度的問題。

現有做法常用一般視覺問答或影片理解題,模型只要辨認物件、情節或表面事件就有機會得分;作者認為這種 fixed paradigm 忽略 stylistic vocabulary、cultural priors 同 grounded audiovisual inference,所以改用 narrator-removed video clip,並配合可選 audio transcript,迫使模型直接由鏡頭、聲音、節奏與敘事線索作判斷。題目覆蓋 Cinematic Arts、Static Visual Arts、Stage Performing Arts 同 Game Arts,合共 4,016 條問答。

同類 benchmark 多數著重「睇到乜」,MuseBench 則更在意「點解要咁呈現」。它亦唔只用單一選擇題,仲有 single-select 同 multi-select 兩種格式,並加入 Chance-Adjusted Accuracy(CAA)處理選項數量不同帶來的偏差,令比較 28 個 MLLMs 時較公平。

  • 涵蓋 4 個藝術領域、11 個細分類,題材比一般影片 QA 更闊
  • 評測 28 個 MLLMs,包含 proprietary、open source 同 video-specific 路線
  • 最佳模型準確率 48.29%,明顯低於 human expert 的 87.18%
  • 已整合 VLMEvalKit,方便把新模型接入同一套流程測試

部署同測試理解上,這個 code repository 主要唔係提供訓練模型,而是把 MuseBench 接到 VLMEvalKit 的評測流程,較適合研究團隊、模型評估人員、做 video understanding 或多模態推理的項目直接比較新舊模型。已公開的結果提到 Claude-4.6-Opus、Qwen-3.5-Plus、Doubao-Seed、GPT-5.4、Gemini-3.1-Pro、Grok-4.1 等都測過,分數整體仍與專家有大段距離;換句話說,這個項目最有價值的地方,在於它清楚指出現時 MLLMs 在藝術判讀仍未算接近可靠。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, 字節跳動, 多模態模型, Qwen, OpenAI, Gemini, Video, Audio, 香港, Anthropic, Dataset 數據集

EdgeBench 用 134 個長任務量度智能體成長

模型識幾多,未必等於學得幾快。EdgeBench想回答的,是智能體在真實環境中隨時間互動後,能力會怎樣上升。

ligo gw

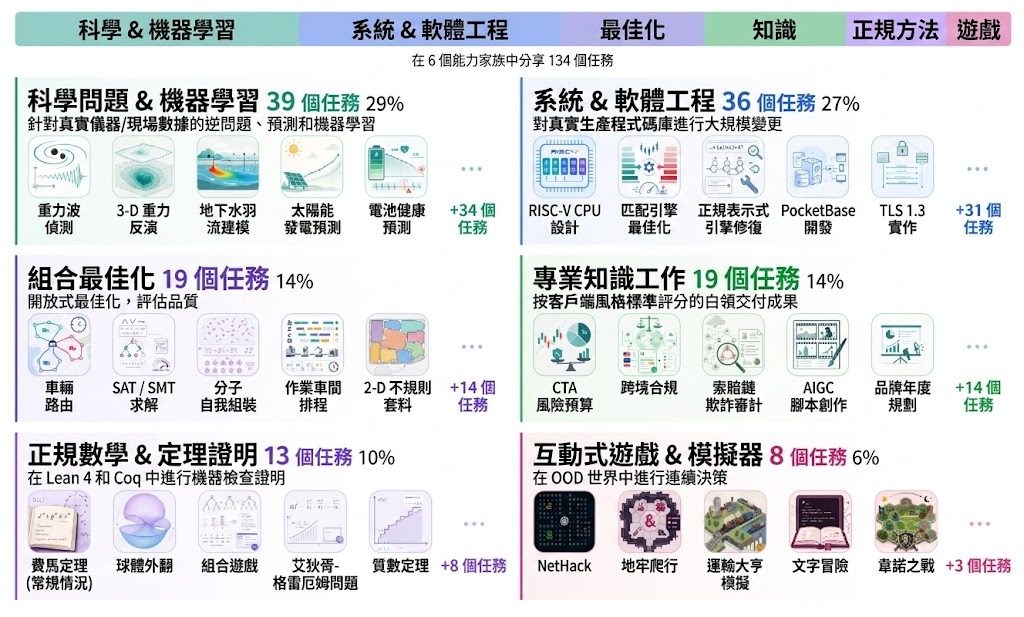
跑一次就評分的基準,通常只能看出模型本身已經識乜;EdgeBench關注的是另一件事:當智能體放進接近真實工作的環境,連續做十幾個鐘、接收回饋再反覆修正,它究竟會唔會愈做愈好。這是一個研究 environment learning 的 benchmark,核心問題不是單次答對率,而是學習曲線能否反映長時間互動後的能力變化。

它把 134 個任務分成六大類,包括科學與機器學習、系統與軟件工程、組合最佳化、知識工作、形式數學同遊戲,而且每個任務最少運行 12 小時,部分延伸到 72 小時以上。這個設計接近真實工作流,因為智能體需要面對 build logs、test failures、objective values、simulator traces、實驗誤差等回饋,而唔係只靠一次生成結果交卷。

同常見 benchmark 相比,EdgeBench的差異在於它量度「隨經驗累積而改善」的能力。研究者指出,多個模型在 134 個任務上的整體表現,都可用 log-sigmoid function 擬合,R²約為 0.997 至 0.999,表示 environment interaction time 與表現提升之間有相當穩定的關係。這令它不只是一張排行榜,也是一個用來觀察 scaling laws of environment learning 的分析工具。

  • 覆蓋 134 個真實世界長時任務,重點放在學習速度與上限
  • 任務橫跨科學、編程、最佳化、知識工作、數學與遊戲
  • 每項任務持續 12 小時以上,部分超過 72 小時
  • 回饋訊號來自接近真實工作的執行環境,而非單次靜態題目
  • 整體學習曲線可用 log-sigmoid function 高精度擬合

這套 benchmark 對做 Agentic 項目、長流程自動化、程式代理與研究型智能體的人最有參考價值,因為它直接呈現模型在長時間任務中的耐力、修正能力與邊做邊學的幅度。現有資料集中在 benchmark 設計、任務結構、資料集與分析結果,未提供具體安裝步驟或完整使用流程;能確定的是,這個項目由 ByteDance Seed 發表,並附有 Paper、GitHub 與 Dataset 入口。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, Agentic, 模型訓練, DeepSeek, 框架, 軟件, 編程, Anthropic, Dataset 數據集

LLM-as-a-Verifier 點樣重寫代理評分

當代理唔只要答得啱,仲要一步步做得穩,粗略打分已經唔夠。LLM-as-a-Verifier把評估拆細,令挑選、追蹤同訓練都更有依據。

LLM-as-a-Verifier

代理系統最常見的瓶頸,唔係生成唔到答案,而係你難以知道它每一步到底做得幾好。LLM-as-a-Verifier屬於開源框架,針對的正是呢個問題:它唔只為最終結果打一次分,而係用更細緻的方式為候選答案、行動步驟同任務準則提供可量化回饋。

現有做法不少仍然依賴單次判斷、粗粒度分數,或者只看最終成敗;作者認為呢種固定範式會忽略不確定性,亦難以支援 progress tracking 同 reinforcement learning。LLM-as-a-Verifier改用三個核心設計重組驗證流程:score granularity、repeated evaluation 同 criteria decomposition,並且直接對 LLM score tokens 的完整 logprob distribution 取期望值,而唔係只取單一輸出。

呢個取向令它同一般 judge-style 評分器有明顯分野。它重點唔在於產生一句評語,而係產生可反覆比較、可分解、可累積的 fine-grained feedback,所以可以用於 Best-of-N selection、pairwise compare,同埋逐步追蹤代理行為變化。README 亦展示了 Python 套件 llm-verifier 的基本用法;安裝方式有提供,但更完整的部署細節主要放在官方文件,而某些流程亦需要 VERTEX_API_KEY 或可回傳 logprobs 的 OpenAI-compatible server。

  • 支援任何 modality 的驗證框架,定位比單一 benchmark judge 更廣
  • 方法核心是細粒度評分、重複驗證、按 criteria 拆解準則
  • 可直接用於 selection、compare、track,同時連到 reinforcement learning
  • 官方列出 Terminal-Bench V2、SWE-Bench Verified、MedAgentBench、RoboRewardBench 等結果
  • 相關模型與服務包括 Qwen/Qwen3.5-9B、Qwen3-8B、Gemini 2.5 Pro,以及 OpenAI-compatible server

表現上,項目聲稱在多個 agentic benchmarks 達到 state-of-the-art,包括 Terminal-Bench V2 86.5%、SWE-Bench Verified 78.2%、RoboRewardBench 87.4%、MedAgentBench 73.3%,亦提到在 LIBERO 配合 SAC 微調 pi 0 policy 時,sample efficiency 約高 1.8 倍。呢類數字反映它較適合研究團隊、代理平台開發者,同埋想將評估訊號接入訓練迴路的人;單純只想要一個最終分數的團隊,未必需要用到它整套驗證尺度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, NVIDIA, OpenAI, Gemini, Medical醫學, Python, Anthropic, Dataset 數據集

TasteGap:量度人類與 LLM 的 Research Taste

這是一套研究構思評測工具,用來比較人類與 LLM 想法分佈有幾唔同。它唔係只看新穎度,而是追蹤研究口味偏向。

Repository image for ziyuuc/TasteGap

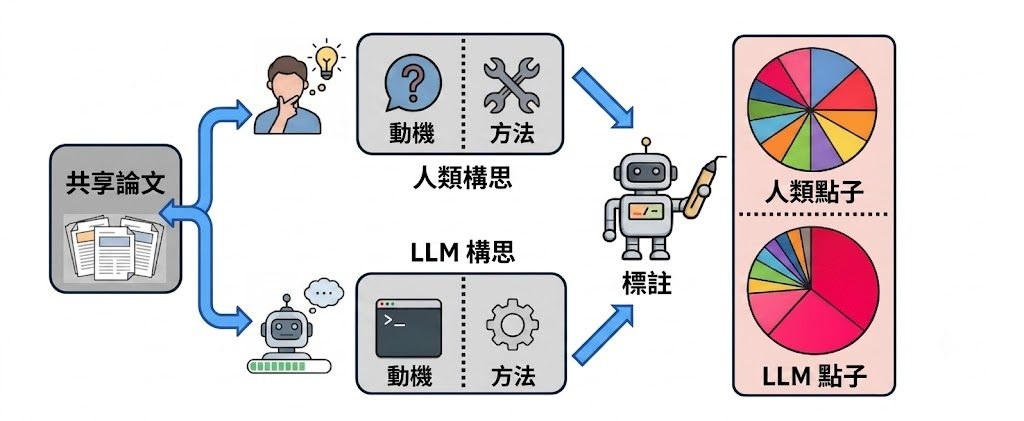
TasteGap 是一個研究評測工具與研究原型,核心工作是比較人類研究者與 Large Language Models(LLMs)生成研究構思之間的差距。它並非處理單篇提案好唔好,而是同一批文獻背景下,人類與模型會傾向提出邊類動機、邊類方法,從而量度所謂 research taste。

現有做法多數用 novelty、feasibility 或專家偏好去評分單個 idea,作者認為呢種固定範式只能判斷「像不像好主意」,但未必見到分佈偏差。TasteGap 改用 shared literature context:先從高質論文反推一組可能啟發該論文的 related works,再要求 LLM 從相同材料生成新 idea,之後用 two-axis research-taste taxonomy,分別標註 motivation 同 method,對比 human ideas 與 LLM ideas 的整體分佈。

GitHub 儲存庫目前提供 evaluation code,而唔係完整訓練框架。安裝理解上相當直接:準備 Python 依賴、設定 config.json 內的 generation 與 labeling 模型、填入 OpenAI 或兼容 API 端點,再用 JSONL 輸入跑 generate_ideas.pylabel_research_taste.py;要重現完整資料,則需另外下載 Hugging Face 上的 IdeaSeed。輸入記錄包含 paper title、URL、domain、related works,以及人類參考 proposal 的 motivation 同 method,代表這個項目設計重點是可重跑比較,而唔係單次展示結果。

作者提出的主要判斷幾清楚:不同 LLM 生成的 idea sets 都出現一致 distributional gap。LLM ideas 較集中在 bridge-like opportunities 同 synthesis methods,人類論文參考分佈就覆蓋更廣,表示模型可以提出合理點子,但研究取向仍然較窄,亦有系統性偏移。

  • 不是一般 brainstorming 工具,而是用來量度 ideation 分佈差異的評測項目
  • 保留 human ideation 與 LLM ideation 在相同文獻脈絡下的可比較性
  • 研究口味以 motivation 與 method 兩條軸線標註,分析角度比單純打分更細
  • GitHub 內容偏向生成與標註流程,完整資料需配合 IdeaSeed dataset
  • 適合做 AI for science、LLM ideation、科研流程研究的團隊作內部基準

TasteGap 沒有綁定相關模型,只要求在 generationlabeling 填入可用模型,並支援 OpenAI-compatible endpoint。這種設計方便團隊橫向比較不同 LLM,但現階段儲存庫未提供完整效能表或基準腳本整理頁,因此不算是交付即用型產品。

GitHub · Paper

Categories: 開源, 模型, OpenAI, Gemini, API, 工具, Python, Anthropic, Dataset 數據集

AgenticDataBench:數據代理基準點樣睇

這是一個評測 data agents 的 benchmark。它用真實任務同技能標註,檢查模型是否真係識做數據工作。

example

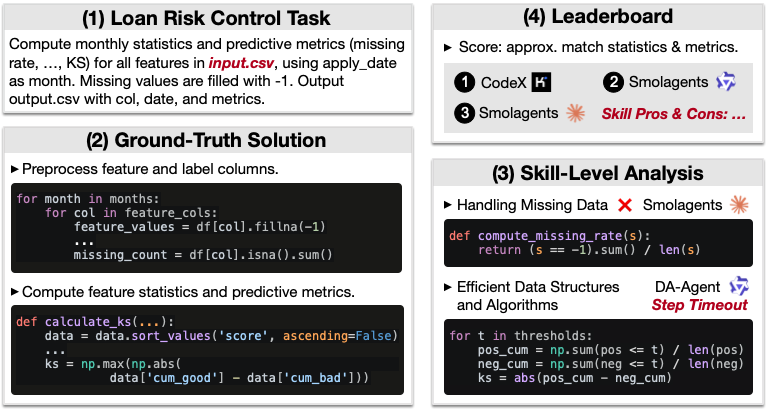
AgenticDataBench 是一個用來評測 data agents 的 benchmark,而唔係直接幫人做分析的模型或應用。它要解決的是:LLM-based data agents 能否穩定完成 data science workflow,並且用可比較、可重現的方式量度表現。

現有做法多數只用零散任務、單一資料集,或者只看最終答案,較難知道代理究竟卡在哪個步驟。這個項目改用 344 個任務、15 個領域,再配合細緻的 skill labels 同 ground-truth,將問題拆成可重用的 data science skills,例如缺失值處理一類操作模式,令評測唔只得總分,仲可以見到技能層面的強弱。

部署同理解方式都幾直接:資料集可由 HuggingFace 下載後放入 testbed/datasets/,任務、gold 標註同結果目錄已經分開,另外保留咗 98 個 private test tasks 維持 leaderboard 的可信度。README 亦提到需要設定 API keys,反映它主要係一個開放測試台,方便用不同 agent harness 跑同一批任務,而唔係單機即開即用的終端工具。

同類 benchmark 相比,它的取向唔係追求最少題目下的快速排行,而係強調真實性、技能覆蓋率同冗餘控制。項目一方面收錄真實 B2B fintech use cases,另一方面用 skill-aligned hierarchical clustering 同系統化生成流程補足缺少真實任務的領域,這種做法的代價是建置與維護較重,但換來更完整的比較基線。

  • 覆蓋 15 個領域,包含真實 B2B fintech 任務
  • 提供 tasks、ground-truth、skills 同 results 結構化內容
  • 支援比較不同 agent harness,如 Smolagents、DA-Agent、Claude Code、CodeX
  • 已列出 Qwen3.5-397B-A17B、Kimi-K2.5、Claude Sonnet 4.6 的初步實驗

這個項目最適合做 data agent 研發、模型選型同內部驗證的團隊,也適合研究人員用來檢查代理在哪類 data skills 失分。性能資訊目前以 leaderboard 結果為主,重點不只是 accuracy,仲包括 skill-level insight;相關模型至少包括 Qwen3.5-397B-A17B、Kimi-K2.5 同 Claude Sonnet 4.6。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, Agentic, Qwen, API, Anthropic, Dataset 數據集, Skill 技能

Page 3 of 5
1 2 3 4 5