video-shotcraft:電影感產品影片工作室

video-shotcraft 把產品頁面、動態分鏡和聲效製作串成一條工作流,協助 Claude Code 或 Codex 產出更完整的宣傳影片。

video-shotcraft logo

由產品頁面出發,video-shotcraft 會交由 Claude Code 或 Codex 組織分鏡、動畫及聲音設計,再以 Remotion 製作宣傳、發布或示範影片。這個項目屬於 AI agent skill,實際處理的是產品影片製作中截取畫面、安排鏡頭、配合節奏剪接和加入聲效等繁複工序。

畫面不只依賴抽象動畫,工作流包括真實頁面擷取、2.5D camera moves、beat-synced cuts,以及電影感 SFX。152 張 shot recipe cards、209 種 style 和 209 個 motion previews,讓創作者可按產品內容挑選鏡頭語法,再由 native Remotion components 組合成片;元件以 normalized progress t 驅動,並可替換 ACCENT 顏色。

適合需要頻繁製作產品發佈片、marketing video 或 demo video 的設計師、創業團隊及內容製作人。它把分鏡規劃和前端式動態設計交給代理處理,換來較完整的自動化流程,但影片質感仍取決於產品頁面素材、提示內容及人工修訂;提供的資料亦未交代具體安裝步驟、所需帳戶或完整輸出流程。

品質控制來自對候選動作進行八輪逐幀檢視,並與參考片段比較後整理成 recipe cards。README 亦列出完成交付後可輸出可編輯的 JianYing(CapCut CN)草稿,方便按 shot 重新剪接、調速、排序、調色及重建字幕軌道,但相關功能的可用條件仍需以項目最新文件為準。

  • 素材處理:支援真實產品頁面擷取,而非只靠預設圖形。
  • 動態語法:涵蓋 2.5D 鏡頭、節拍剪接和 SFX 配搭。
  • 內容庫:提供 152 張 shot recipe cards、209 種 style 及 209 個預覽。
  • 輸出彈性:以 Remotion 元件組成影片,並列出 JianYing 可編輯草稿匯出能力。
  • 使用限制:目前資料不足以確認安裝、模型依賴和完整執行要求。

GitHub

Categories: 開源, Agentic, AI productions, OpenAI, Video, Anthropic, Dataset 數據集, Skill 技能

Mechanist:把整個科研鏈串起來

Mechanist 把模型內部機制研究串成一條自動化流水線,從文獻檢索到實驗驗證都能接手。對做可解釋性、假設檢驗同 GPU 實驗的人,相當有價值。

Mechanist Logo

Mechanist 係一個面向 LLM mechanistic interpretability 的 Autonomous Research Agent,重點唔係幫你寫報告,而係幫你把研究問題拆成可驗證的實驗流程,再逐步產出有證據支撐的結論。它適合需要反覆查文獻、提假設、跑 GPU 實驗、再做 robustness validation 的工作,特別係做模型內部機制分析嘅研究人員同團隊。

使用方式偏向研究工作流而唔係單點工具:先準備 task.md,再喺 Claude Code 入面啟動 /auto,系統會接住做 literature retrieval、hypothesis formulation、experiment implementation 與 execution。項目同時提供 /msearch 同 /mhistory,方便查文獻同追蹤主題脈絡;安裝資料提到要配合 Claude Code、uv,同埋設定 external review model,但 README 亦提到詳細步驟要參考 Quick Start,同時未有完整列出所有命令細節。

它的取捨幾清晰:比起只做文獻整理或者只跑單次實驗,Mechanist 會把整個研究鏈條串起來,仲會喺 GPU budget 內自動縮放實驗規模,唔夠資源時會直接停低並回報。這種做法令佢更像一個可執行的研究夥伴,而唔係純粹的查詢介面。

  • 支援把研究問題轉成可重複驗證的實驗流程
  • 會做文獻檢索、假設生成、實驗執行同穩健性檢查
  • GPU budget 係硬限制,資源不足會明確停機回報
  • 適合做 mechanistic interpretability、模型分析同研究自動化的人
  • 目前以 Claude Code plugin 形式提供,Codex 支援屬於後續方向

項目主頁 · GitHub

Categories: 開源, Agentic, Anthropic, Dataset 數據集

spark-to-paper-skills:14 個 Claude Code 技能把點子直出論文 PDF

由一句想法走到可編譯論文,連引用、圖表同數字來源都一併追蹤。呢個 Claude Code 插件瞄準的,不是寫草稿,而是把研究寫作流程拆成可驗證工序。

spark-to-paper-skills

研究寫作最麻煩的地方,往往不是起草,而是引用會唔會失真、圖表能否修改、數字有冇來源可追。spark-to-paper-skills 把呢件事做成 Claude Code 插件型工具鏈,用 14 個可組合技能,將一句想法推進到可編譯 PDF,處理的是論文生成流程入面最容易出錯的核對與整理工作。

它吸引人的地方,在於唔靠獨立 app 或伺服器,而是直接掛入 Claude Code 會話。安裝前提相對簡單,重點是有 Claude Code,另外部分圖像流程需要 Python 3.10+ 同指定依賴;換句話說,這不是雲端代寫服務,而是偏向本機、插件式、可拆件調用的研究寫作工作流。

  • 14 個技能可分步串接,涵蓋資料整理、成稿到 PDF 編譯
  • 引用強調 verified,數字強調 traced to source,主打可追溯性
  • v1.2.0 加入 PaperBanana+ figure engine,圖可重畫成原生 editable vector figures
  • 新版支援 Claude Code plugin 自動載入,部署方式比早期版本完整

同類做法多數把重點放在生成速度,這個項目則把可信度同後續可編輯性放得更前。PaperBanana+ 的做法幾值得留意:先由官方 PaperBanana 產生候選圖,再用 ts-figure-svg 學習該渲染風格,根據論文事實原生重繪,並以 stdlib-only geometry audit 反覆修正至少 4 輪,換來的是圖像更容易進一步編修,但流程也明顯比單次出圖更講究。

目前公開資訊較多集中在工作流完整度。它已展示 7 篇跨 6 個領域的端到端樣本,並支援 ICML 2025、NeurIPS 2025 風格輸出,足以說明這套技能並非只停留在片段 demo。較適合研究助理、學術團隊、技術內容作者,或者需要快速整理初稿但又唔想放棄引用與圖表可追蹤性的人;最終學術品質,仍然要視乎輸入構想、來源材料同人工審稿力度。

GitHub

Categories: 開源, Python, Anthropic, Skill 技能

free-claude-code:一個代理層打通 Claude Code 與 Codex

想保留原生開發代理體驗,又想自由換模型與供應商,free-claude-code 正正補上這個缺口。它把 Claude Code、Codex 同 Pi 接到同一個可管理入口。

用開 Claude Code 或 Codex 的人,最在意通常唔係再裝多一個聊天介面,而係可否繼續用原生 model picker、串流回應、tool use 同 image input,同時改用自己揀的模型供應商。free-claude-code 就係一個 proxy 工具,把 Claude Code、Codex、Pi 及其 IDE 擴充功能接到自管入口,處理多供應商切換同路由分發。

它的價值在於工作流幾乎唔使重學。你可以照用 fcc-claude、fcc-codex 或 fcc-pi 啟動對應代理,Windows 同 macOS 亦可放在背景執行,再到本地 Admin UI 揀選並驗證供應商。可在 31 個 cloud 與本地 providers 之間切換,亦可把 Fable、Opus、Sonnet、Haiku 同 fallback 流量分別導向不同模型,這點對想控制成本、速度同能力分工的團隊幾實用。

跟直接綁死單一 API 的做法相比,這個項目押注在「保留原生客戶端體驗,再用 proxy 抽換後端」。代價是相容性要靠代理層維持,所以它明確強調只會在兼容模型上保留 streaming、tool use、reasoning 同 image input;換句話說,模型可揀得更自由,但不是每個後端都保證功能完全一致。

  • 支援 Claude Code、Codex、Pi,同時保留各自原生 model picker
  • 透過本地 Admin UI 管理與驗證 31 個 cloud/本地 providers
  • 可把不同流量類型分流到不同模型,方便平衡成本與能力
  • 適合想用本地模型、付費模型或免費模型混搭的開發團隊

安裝與測試方式偏向開發者工具鏈:項目以 Python 3.14、uv、Pytest、Ruff、Ty 組成,部署重點不是雲端託管,而是先在本機跑起 proxy,再讓代理客戶端經它連線。現階段最適合已經在用 Claude Code 或 Codex、又想統一管理模型入口的人;追求零設定即用的讀者,會覺得它比較像一層需要自己維護的基建。

GitHub

Categories: 開源, NVIDIA, API, Image, 工具, IDE, Mac, Python, 編程, Anthropic, UI/UX

Vision-DeepResearch:由靜態圖片走向連續影片的 DeepResearch Agent

Video-DeepResearch 將視覺搜尋延伸至連續影片,要求模型先理解跨畫面的證據,再進行網絡探索。

icon

面對需要翻查影片內容、再結合網絡資料回答的問題,單靠文字搜尋往往會漏掉關鍵畫面。Video-DeepResearch 是一個多模態研究型 Agent 項目,透過 Video-DeepResearch(Video-DR)處理連續影片中的時空資訊,並把視覺理解與網絡探索分開安排。

它修正了兩個常見卡位:模型偏向使用文字工具,較少主動檢視影片;模型亦可能直接依賴內部記憶,未有真正完成工具輔助搜尋。Pipeline 先逐階段解鎖視覺工具,要求模型完成跨畫面 grounding,再進入網絡檢索,取捨是流程較嚴謹,但推理成本和執行時間亦可能增加。

訓練流程先以 Supervised Fine-Tuning(SFT)建立基本能力,再使用 Group Relative Policy Optimization(GRPO)強化自主探索。項目同時提供 30 K 個 video-grounded QA pairs、7 K 條整理後的 trajectories,以及程式碼、資料集和模型權重,研究團隊可按需要測試基準、重現訓練或直接載入模型。

  • Video-DR-35B-A3B 在 Video-DR 達到 68.0% accuracy
  • 比 Claude-4.5-Sonnet 的 63.0% 高 5.0 個百分點
  • GPT-5 和 Gemini 2.5 Pro 分別為 57.0% 和 62.0%
  • Vision-DeepResearch-30B-A3B 延續同一研究方向,另有 SFT-only 的 8B 版本

現有結果反映它在影片證據與網絡資料需要互相驗證的工作較有價值,例如研究、媒體核查和長片段問答;但 68.0% 仍代表部分問題會出錯,較適合作為研究平台和可檢驗的 Agent 架構,而不是無需監督的影片分析服務。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港理工大學, Agentic, 多模態模型, 模型訓練, Qwen, OpenAI, Gemini, Video, 香港, Anthropic, Dataset 數據集

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

Octafuse Gateway:幫 Agent 管好多模型入口

Octafuse 團隊做的不只是轉發層,而係把模型、工具同配額管理收埋到同一個入口。對要同時接多個 AI 服務嘅團隊,呢種集中控制會直接省下不少營運工序。

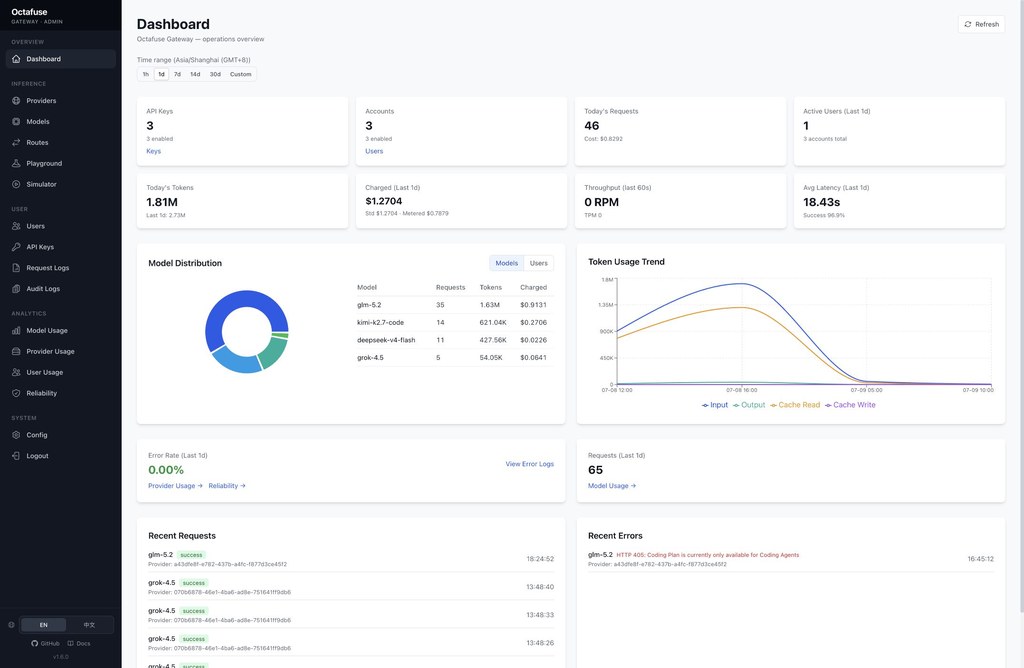
Octafuse Gateway 运营概览

Octafuse 團隊把重點放在 Agent 工作流,而唔係只做一個轉發請求的薄層。Octafuse Gateway 屬於可自託管開源 AI gateway,處理的是多供應商模型、圖像、語音轉寫同 Agent Tools 分散管理的問題,特別適合已經有多組 API Key、不同模型來源,甚至自建服務要一齊協調的團隊。

它最有價值的地方,在於把「接得通」進一步做成「管得住」。同類項目常見重點是模型代理與相容 API,Octafuse Gateway 另外加強了路由、故障轉移、預算、審計、三賬本計費,同埋公開能力目錄,令 Agent 可以透過統一入口發現同調用資源,而管理者亦可以追蹤成本與用量。

部署方向,支援 Cloudflare Workers + D1,以及 Docker 配合 Postgres / MySQL 自託管;Node.js 20+ 亦是明確要求。原始資料未展示完整安裝步驟,但有 operator 文件、Admin 管理界面、Playground 同 Simulator,反映它不是只給開發者讀 API 文件,亦有一套管理與聯調介面可用。

  • 兼容 OpenAI Chat Completions、Anthropic Messages、Gemini、OpenAI Images 與 OpenAI Audio Transcriptions API
  • 可集中管理 Provider API Key、RPM / TPM、並發、熔斷狀態與剩餘容量調度
  • 內置 Provider 與模型導入模板,減少逐個端點手動維護
  • 提供 /v1/tools/* 接入 Agent Tools,現有 web-search、web-fetch、web-deep-search
  • 有 Playground、Simulator、審計與成本觀察能力,方便排查路由與計費設定

它強調的是可靠調度與營運控制,而非單一模型跑分。對需要向內部團隊、客戶或不同項目發放獨立 API Key 的環境,這種以資源治理為核心的取向,比單純聚合模型端點更完整,但相對也代表配置面會更廣,較適合已有多模型、多使用者或多成本中心需求的團隊。

GitHub

Categories: 開源, Agentic, OpenAI, Gemini, API, 框架, Anthropic

Anthropic Opus 提示詞外流反映了什麼

一份放在 GitHub 的提示詞檔案,讓人更具體見到大型模型點樣被「定調」。它未必代表完整系統,但足以幫你理解模型回應背後的設計取向。

Og image

想知道大型語言模型點解會用某種語氣答你、點樣處理敏感內容,最直接的方法之一,就是看它背後的 system prompt。這個 GitHub 項目整理了疑似來自 Anthropic Opus 的提示詞內容,重點不在功能展示,而在於把模型行為規則攤開,讓人看到回應風格、安全邊界與工具使用指令可能如何被設定。

對開發者、提示詞研究者同內容工作者來說,這類資料最有價值的地方,在於它把平時只能靠輸出結果推測的設計思路,變成可以直接閱讀的文字線索。你可以更清楚理解模型點樣被要求保持語氣一致、避開高風險內容,或者在多步驟任務中遵守某些優先次序,但同時要留意這類「leaked prompts」未必完整,也未必反映最新版本。

  • 幫助觀察 Anthropic 對模型人格、語氣與安全規則的安排
  • 適合研究 system prompt、AI alignment 同提示詞工程的人參考
  • 能作為分析模型輸出風格的輔助材料,而唔係正式技術文件
  • 內容真確性、時效性與完整度都需要保留判斷

它和一般產品介紹最大的分別,是你見到的不是功能清單,而是控制模型行為的內部文字結構。這種資料未必能直接提升效果,卻很適合用來拆解 AI 產品點樣把品牌語氣、風險控制同任務規則包進同一套提示詞框架。

從使用角度看,這份內容較適合拿來做觀察、比對同研究,不應視為官方文件或穩定接口。對關心 Anthropic、AI 安全同提示詞設計的人而言,它提供了一個少見的切入口,去理解模型輸出背後不只是能力,仲有大量預先寫好的約束。

項目主頁

Categories: Agentic, 提示詞, 安全, Anthropic, Skill 技能

OpenWorker – Andrew Ng 開發桌面 AI 龍蝦

OpenWorker 係一個開源嘅桌面 AI 同事,由 Andrew Ng 團隊開發,強調本地執行、帶自己嘅模型 API key,並且會產出真正嘅成品而唔止係聊天回覆。

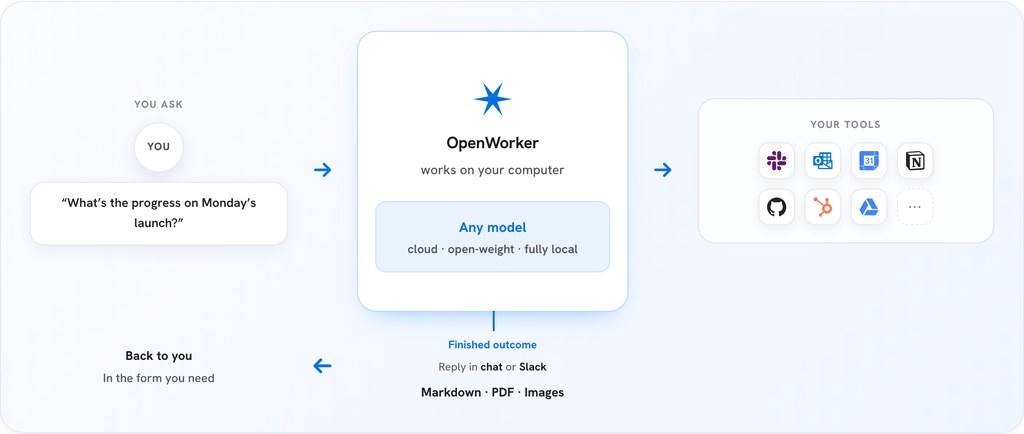
How OpenWorker works

對好多打工仔嚟講,最大嘅困擾唔係 AI 唔夠聰明,而係佢只識得「答問題」而唔識得「做完件事」。OpenWorker 嘅切入點正正喺呢度:佢定位係一個會跑喺你電腦上面嘅 AI 同事,可以幫你整理 calendar、寫 follow-up email、甚至自動出一份 customer brief,最後畀你一份可以直接開嚟用嘅文件,唔係一串對話。

OpenWorker 由 Andrew Ng(吳恩達)相關團隊推出,引擎建基於佢哋自己開發嘅 Python 開源庫 aisuite,呢個庫提供統一嘅 chat-completions API 以及支援工具調用(tool calling)、MCP 等功能。簡單講,OpenWorker 唔係從零寫起嘅 wrapper,而係將 aisuite 包成一個真正面向桌面用戶嘅應用,並且喺原本 aisuite 倉庫入面開發咗一段時間之後,先搬出嚟獨立成 repo。

目前支援 macOS(Apple Silicon)以及 Windows 10/11,用家可以貼上自己嘅 API key 去用 OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral 等模型,亦可以經 Ollama 完全本地跑開源模型。所有嘢都喺本機行,只有用家授權嘅 model call 或者連接工具先會接觸到網絡。對於注重私隱或者公司政策唔畀數據出 cloud 嘅人,呢個係一個幾實際嘅選擇。

OPENWORKER: The Free AI Desktop Agent That Isn't Locked to One Model

佢亦內建 25+ 個整合,包括 GitHub、Slack、Jira、Notion、Linear、HubSpot、Outlook、Gmail、Google Calendar 等,亦支援任何可以經 MCP(Model Context Protocol)接駁到嘅工具。最令筆者欣賞嘅係佢嘅審批機制:寫訊息、發送郵件、執行 shell 指令呢類「對外有影響」嘅動作,全部都要先經你確認先至會執行,唔會自己靜靜雞撳掣。

以下係幾個用家會比較關心嘅重點:

  • 定位係桌面 AI 同事,目標係交到「成品」而唔止係聊天回覆,例如 HTML brief、Markdown 報告、排好嘅 calendar 更新等。
  • 完全開源、MIT 授權,由 Andrew Ng 團隊開發,引擎建基於佢哋嘅 aisuite 開源庫。
  • 模型自選,支援多間主流 cloud provider,亦可以經 Ollama 完全本地執行開源模型。
  • 重視私隱,對話、token、API key 都儲喺本機 secret store,唔需要登入亦可以用。
  • MCP + 審批機制,所有對外動作(發訊息、執行指令)都會先問過你先做,減低「AI 自行撳掣」嘅風險。

如果你係一個人或者小型團隊,想搵一個可以幫你「跑手」而唔係淨係「傾偈」嘅 AI 工具,又唔想將公司敏感資料送去閉源服務,OpenWorker 算係一個值得試嘅選擇。佢而家仲喺 open beta,官方表示會自動更新、不斷執吓啲 bugs,畀用家提交 issue。適合想認真將 AI 融入日常工作流、對私隱同可控性有要求嘅人。

項目主頁 · GitHub

Categories: 開源, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Ollama, Python, Anthropic, 蘋果, Kimi

ActiveVision 點出視覺推理真空帶

望一眼答題的多模態模型,在 ActiveVision 幾乎集體失靈。這個 benchmark 把「要一路觀察先答到」的能力,拆成更貼近人類解題節奏的測試。

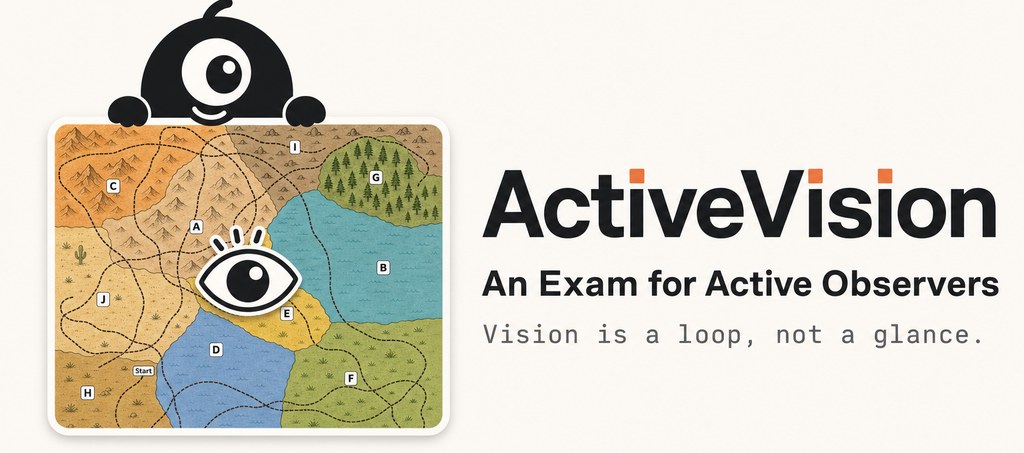
ActiveVision — An Exam for Active Observers. Vision is a loop, not a glance.

不少視覺題目唔係靠一眼辨認,而係要沿住線追、逐區域數、一步步核對先答得到;ActiveVision 正正針對呢種落差而來。作為一個 benchmark,它集中測試 iterative visual reasoning,處理的是模型看得到畫面,但未必能持續整理觀察過程的問題。

現有多模態模型常見做法是對單張圖作一次性判讀,再配合 chain-of-thought 直接作答;作者認為這種 single-glance 範式,對需要反覆掃描、追蹤順序與維持中間狀態的題型特別吃力。ActiveVision 因此設計了 17 個任務,並用 deterministic program 生成場景,再以 photorealistic 方式重繪,令畫面自然之餘仍保留可驗證結構。

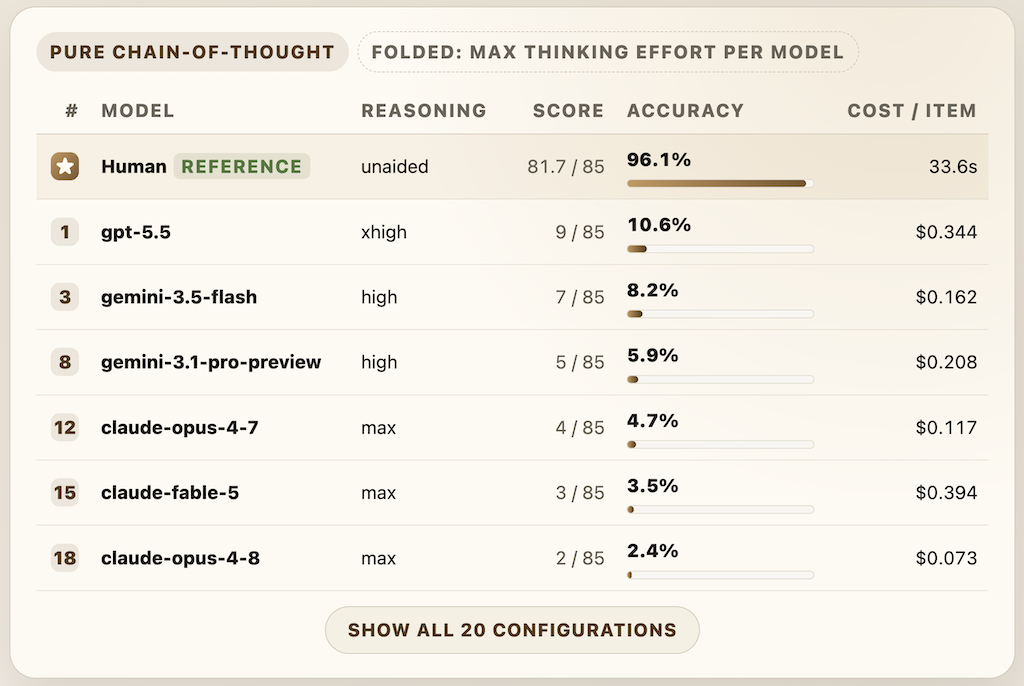
數字相當直接:人類表現為 96.1%,前沿模型在官方無工具評測下最高約 10.6%,差距接近 9 倍。網站亦列出 agent 版本的 tool-use ablation,像 Claude Code 與 Codex 接入工具後,分數明顯高過純 chain-of-thought,表示問題未必只是「看不懂圖」,而是缺少可逐步外化與操作的解題流程。

  • 收錄 17 個任務,重點放在 distributed scanning 與 sequential traversal 一類逐步觀察題
  • 官方評測涵蓋 Claude、GPT、Gemini,亦提供 agent ablation 腳本
  • 數據集可經 Hugging Face 下載,評測程式以 Python 為主
  • 同一靜態圖片也能迫使模型做多步推理,唔靠影片輸入撐起難度

整個 GitHub 項目比較像研究與評測基建,而唔係即用型產品:你需要先下載數據集、配置對應供應商 API,然後用 repo 內的 eval 腳本跑結果。對做多模態模型評測、Agentic 工作流、或者想驗證 Computer-use agents、CUAs 式外部工具協作價值的團隊,它提供了一個很尖銳的檢查點:模型是否真的會「觀察」,還是只會對影像作高階猜測。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, OpenAI, Gemini, API, Python, Anthropic, Dataset 數據集

Page 5 of 8
1 … 3 4 5 6 7 8