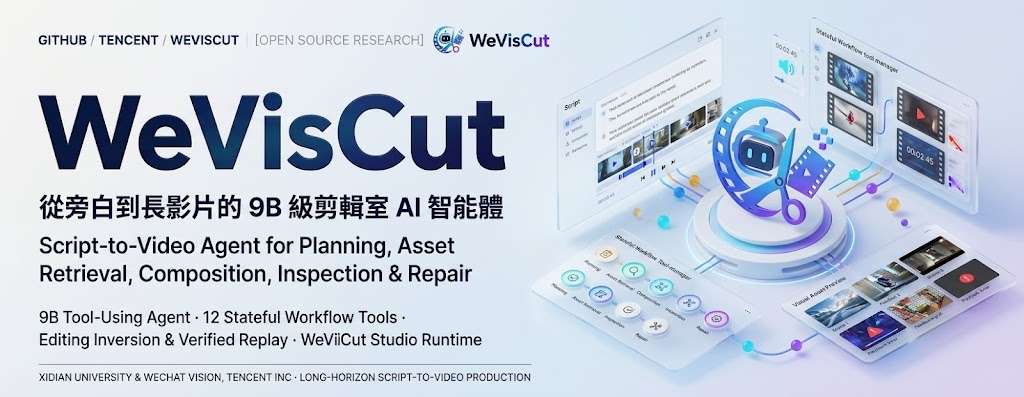
WeVisCut 單一 9B 模型自主剪出多分鐘知識影片

由文章或旁白稿生成多分鐘影片,WeVisCut 讓模型逐步選擇剪輯工具,並可在時間線上修改成片。運行 9B 模型約需 24 GB NVIDIA GPU。

WeVisCut

把知識文章或旁白稿變成多分鐘影片,通常要處理分段、鏡頭、配音、素材、字幕和配樂。WeVisCut 是一個長流程影片剪輯 Agent,由單一 9B 模型讀取剪輯狀態,每次呼叫一項工具,逐步完成製作;它處理的是長篇內容轉成可編輯成片的流程,而非只生成單一畫面或短片段。

模型不依照寫死的階段流程前進,而是按當前狀態決定下一步;防護規則只會拒絕不合法的操作,不會代替模型選擇。每次任務通常約有 12 次工具呼叫,涵蓋文章分段、鏡頭規劃、語音合成、素材檢索、動畫模板、配樂、檢查、修正及合成。檢查與反思本身也是工具,模型可按檢查結果修補未達要求的部分。

Studio 提供八條同步時間軌,成片完成後仍可手動編輯,也支援暫停與續做、聊天修改、單鏡頭重製及版本回退。這讓內容團隊能把它用作長篇解說影片的初剪與修改工作台;成片仍需要人手確認素材、旁白和敘事是否合適。要運行 bf16 9B 模型,項目列出的硬件需求約為 24 GB NVIDIA GPU;只開啟介面、不執行模型則不需 GPU。資料未提供完整安裝及素材服務設定流程,不能只憑這些資訊判定部署所需的全部硬件與外部服務。

評估使用 100 項保留任務,整體分數為 90.5;項目亦報告,每分鐘成功輸出的生成 token 數約比 Claude Opus 5 少 33 倍。這些數字反映項目設定下的測試結果,不足以單獨證明不同影片類型或工作環境都能得到同樣成效。訓練資料則由 3,750 個完成影片項目還原剪輯意圖,再經驗證重播整理出 134,771 個訓練例子;開放的資料建構流程可供研究長流程工具操作的團隊參考。

  • 輸入知識文章或旁白稿,輸出多分鐘剪輯影片。
  • 單一 9B policy 每次呼叫一項工具,按編輯狀態自行規劃後續動作。
  • Studio 保留可編輯時間線,支援逐鏡修改與版本回退。
  • bf16 9B 模型約需 24 GB NVIDIA GPU;純介面模式毋須 GPU。
項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Video, 工具, 語音, Anthropic, 動畫

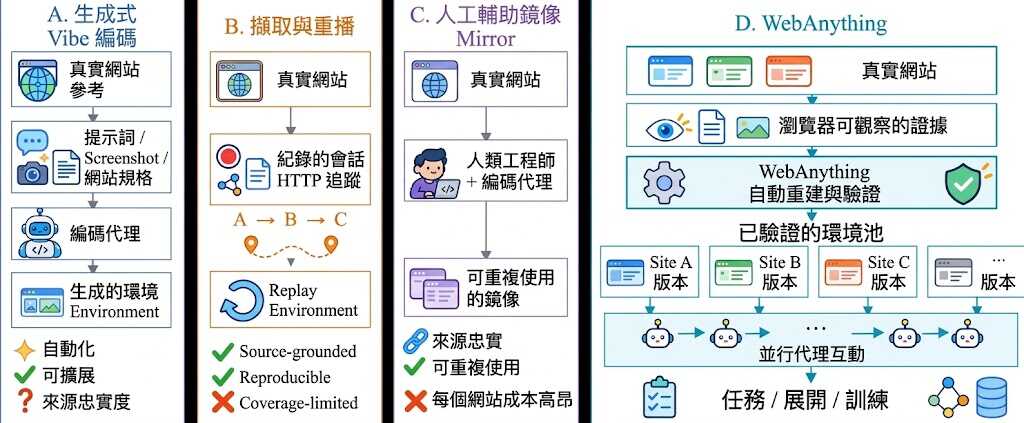
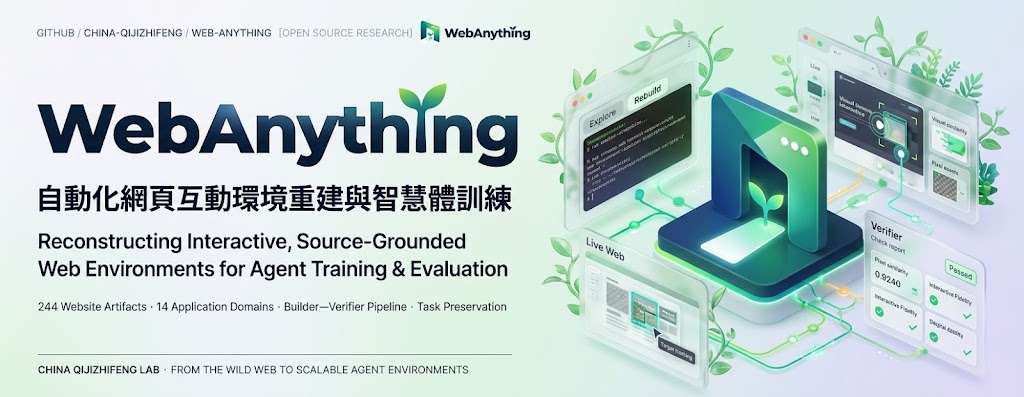
WebAnything 把真實網站重建成可重設的測試環境

從網站獲其內容重建互動網站,能在可重設的環境中完成任務。

WebAnything concept logo

要訓練或評測 Web agent,截取網站畫面並不足夠,代理還要能操作控制項、切換頁面並完成多步任務。WebAnything 是一套研究程式碼,將網站證據轉成可執行、可重設的代理環境,目標是保留任務流程,而不只是重現畫面。

建構流程先由 Builder 透過瀏覽器探索網站,記錄頁面狀態、互動資料、DOM、畫面截圖及網絡資源,再重建環境。候選環境會先凍結,交由 Verifier 獨立檢查;發現實作錯誤或證據不足時,系統會針對問題修正。Full 模式適合追求較廣覆蓋,JIT 則按代理任務需要建構環境,兩者在完整度與建構成本之間作取捨。

項目分析了 6,172 個獲接納的來源任務執行紀錄,平均每個任務使用 10.4 個工具步驟,中位數為 8 步;34.7% 的任務超過 10 步,最長達 89 步。這些數字反映任務包含多步互動,但不能單獨代表重建保真度或代理能力;評估亦分別涵蓋歷史頁面狀態的保真度,以及模型在指定基準測試中的下游效用。

  • 適合研究 Web agent 訓練與評測、需要可重複網站任務環境的團隊。
  • Builder 和 Verifier 使用支援 Responses API 的模型服務;兩者需配置模型 ID、API URL 及 API key。
  • 本機需安裝 Chromium,瀏覽器操作由 Playwright 支援;代理亦需要終端機存取權。README 未列出最低 CPU、記憶體或 GPU 規格,不能據此判定具體硬件門檻。
  • 儲存庫提供建構流程及 244 個歷史網站項目的清單,但網站原始碼與第三方媒體存放在外部 artifact store,並未隨儲存庫附上。

Web agent 提供 Python 套件、命令列工具及設定流程,並可把本機 agent skill 安裝給 Codex 或 Claude Code;這個 skill 不是 MCP server。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 模型訓練, Qwen, API, 工具, Python, 庫, Anthropic, 中國, Dataset 數據集, Skill 技能

VibeGame:把文字變成可試玩的遊戲

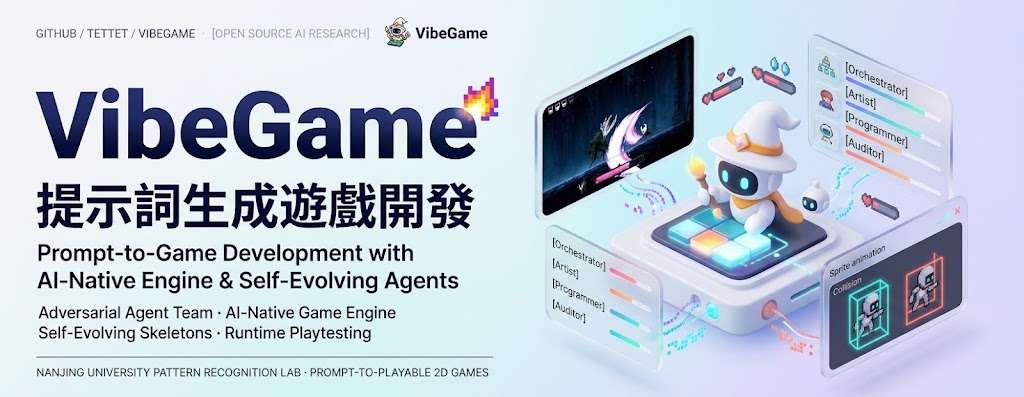
輸入遊戲構想後,VibeGame 會協調代理製作、審查及試玩,亦可按後續要求修改;目前聚焦 2D 網頁遊戲。

VibeGame system teaser

把文字構想變成可玩的 2D 網頁遊戲,再逐步修改玩法,是 VibeGame 這套多代理開發系統的工作。它適合遊戲原型製作,並非獨立模型;已開源的實作以 Phaser 為基礎。

Adversarial Agent Team 由統籌代理協調分工,將生成與審查分開,透過靜態審查及端到端執行驗證檢查成果。AI-native game engine 把項目表示為結構化文字,讓代理直接編輯,並以 frame-synchronous control 按自己的節奏逐幀試玩。

  • 支援 Claude Code 或 Codex,至少需要一款代理命令列介面(Command-Line Interface,CLI)。
  • Python 需要 3.12 或以上;未提供完整安裝流程。
  • 未列出處理器、記憶體、顯示卡或顯示記憶體需求,不能據此判定硬件門檻。

training-free self-evolution 會從成功項目提煉可重用骨架、模組及協作約定,累積開發知識而毋須重新訓練模型。示範涵蓋格鬥與地牢遊戲,但未提供量化成功率或效能比較;端到端 3D 製作仍屬待完成項目。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 模型, 多模態模型, 模型訓練, 3D, Python, Anthropic

oMLX:高效能推論伺服器

當搭配如 Claude Code、OpenClaw、Hermes Agent 這類每輪都發送巨大 Context / Tool Transcript 的 Coding Agent 時,oMLX 能直接命中快取,大幅縮短每輪等待時間。

oMLX

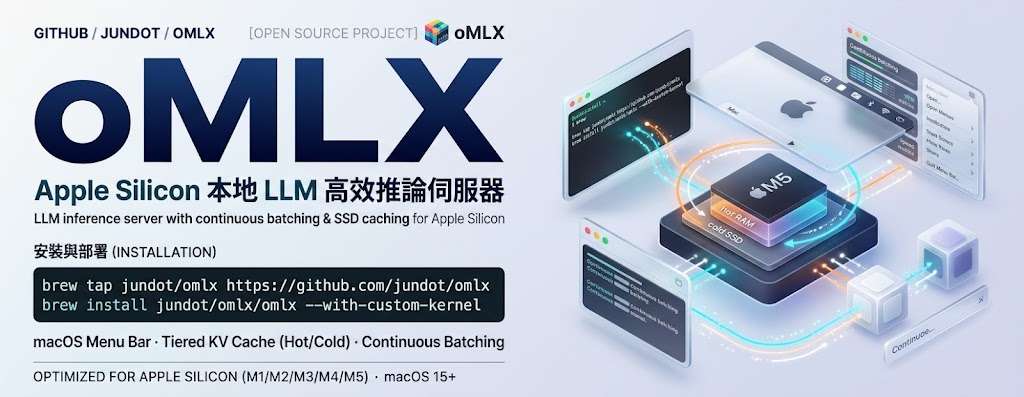
在 Mac 跑編程助手,oMLX 可讓常用模型常駐記憶體,並從選單列管理服務。能使用 Mac 原生 MLX 的吞吐與批次處理。

它以連續批次處理(Continuous batching)配合分層鍵值快取(Key-Value cache,KV cache):常用區塊留在記憶體,冷資料以 safetensors 格式存入固態硬碟(SSD)。後續請求的前綴吻合便可重用,伺服器重啟後亦能恢復,但不代表任意改寫上下文都能免除重算。

  • 可設定上下文長度限制。
  • 記憶體不足時,按最近最少使用(Least Recently Used,LRU)策略移出模型。
  • 管理介面支援手動載入及卸載模型。

硬件需 Apple Silicon Mac,並為模型及快取預留記憶體與 SSD 空間;來源未列最低容量、模型清單或具體測速,不能據此保證大型模型的速度。

安裝可從 Releases 下載 .dmg,拖入 Applications,並支援程式內更新。需要反覆處理相同上下文的編程工作較能受惠;SSD 快取節省重算,卻不能取代模型推理所需的記憶體。

GitHub

Categories: 開源, 模型, 工具, Mac, 編程, Anthropic, 蘋果

magpie:通過本機閘道,把不同 AI 編程代接上同一模型

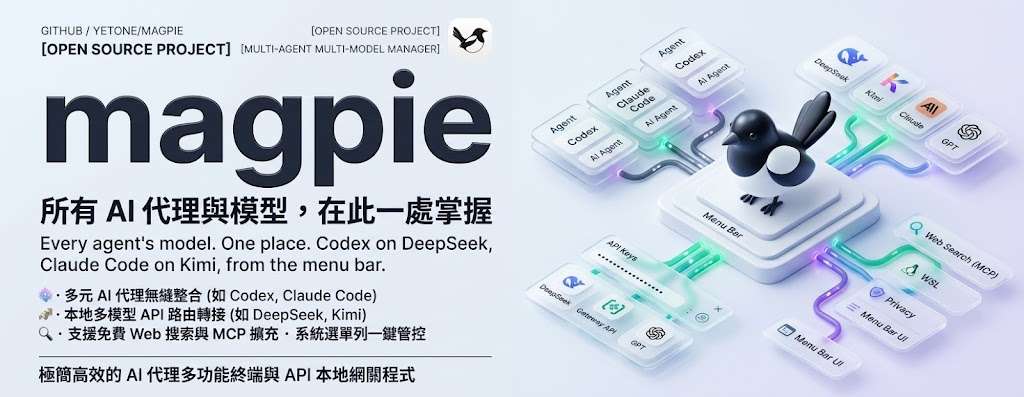
Claude Code、Codex、Gemini CLI 等代理可以各自改用其他模型或訂閱帳戶;配額用完時,Magpie 亦可按設定切換帳戶或路由到其他服務。

magpie

想讓 Claude Code 用 Kimi、Codex 用 DeepSeek,或者讓 OpenCode 使用 ChatGPT 訂閱模型,不必逐個代理手動改一堆設定。Magpie 是一款跨平台工具,透過本機閘道統一管理模型與供應商,並從選單列切換代理設定;它改動的是各代理自己的關鍵設定,並非把不同代理合併成同一個程式。

它支援 API key、本機模型,以及 Claude、ChatGPT、Copilot、Gemini、Grok 等已登入帳戶。Claude 整合會呼叫本機的 Claude CLI,並透過 MCP(Model Context Protocol)橋接代理工具;ChatGPT 訂閱模型則可供其他代理使用。這讓使用者能沿用熟悉的代理工作流程,同時更換背後的模型來源。

配額耗盡時,Magpie 可改用同一供應商的另一個帳戶;若設定了路由群組,也可轉往其他模型或供應商。沒有備用帳戶或路由群組時,錯誤仍會傳回代理,因此不中斷並非無條件保證。隱私遮罩則須在設定中手動開啟,啟用後會在請求離開本機前遮蔽提示中的金鑰、密碼和電郵地址,再把內容還原到回覆。

  • 從同一份清單為不同代理選擇模型,減少逐個修改設定的工作。
  • 可混用雲端 API、本機模型和已登入的訂閱帳戶。
  • 帳戶或路由備援可降低配額用盡造成的中斷,但須先配置可用的後備路徑。
  • 隱私遮罩預設關閉,敏感資料保護需自行啟用。

對同時使用多個 AI 編程代理、需要管理不同供應商帳戶的個人或團隊,Magpie 可集中處理切換與備援;若只用單一帳戶,或不希望工具改寫代理設定,收益會較有限。項目支援 macOS、Windows、Linux、Docker 和 Termux;提供下載與文件,但所給資料未列出效能測試或延遲數據,選用前宜確認所需代理、模型與登入方式均在支援範圍內。

GitHub

Categories: 開源, MCP, 模型, 微軟, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Linux, 編程, Anthropic, Kimi, MiniMax

MoneyPrinterTurbo 整合 AI 影片流程

輸入主題即可生成短片內容與素材,亦可接入不同模型;適合內容團隊快速製作多語言影片。

Kimi 赞助 MoneyPrinterTurbo

給定一個主題,便要自行寫稿、找素材、配音、加字幕再剪輯;MoneyPrinterTurbo 將這套流程整合成 AI 短影片生成工具,涵蓋腳本、配音、素材搜尋、字幕、配樂及剪輯,並提供 AI Agent、WebUI、API 和 CLI 四種介面。

由一句主題到成片:它可自動生成或改寫多語言影片腳本,也允許逐個環節改用自訂內容。支援批量生成、任務紀錄,以及設定和 API Key 的匯入、匯出與恢復,對經常製作大量短內容的編輯、社交媒體營運團隊及小型工作室尤其方便。

  • 輸入主題或關鍵詞,自動完成短片內容與素材配對
  • 以 WebUI、API、CLI 或 AI Agent 接入不同工作流程
  • 可替換腳本、配音、素材、字幕或配樂
  • 支援批量生成、任務歷史及多語言腳本
  • 兼容多種模型服務、統一網關及本地環境

模型選擇相當廣,可連接 Kimi/Moonshot AI、OpenAI、Anthropic Claude、Google Gemini、DeepSeek、阿里云通義千問、Microsoft Azure OpenAI、火山引擎方舟、xAI Grok、MiniMax、小米 MiMo,以及 Ollama、LiteLLM、OpenRouter 等平台。Kimi K3 獲項目採用,負責撰寫文案、提煉素材搜尋關鍵詞及判斷合適畫面;本地模型則適合重視資料控制或降低雲端依賴的團隊,但最終流暢度與準確度仍取決於所選模型、服務配額及素材來源。

這套工具的優勢不是生成單段影片,而是把多個製作步驟串成可重複運作的流程。代價是成品質素仍受文字模型、素材版權、語音及剪輯設定影響,重要影片應保留人工審核,而非直接自動發佈。

GitHub

Categories: 開源, Agentic, AI productions, 模型, Google, 微軟, OpenAI, DeepSeek, Gemini, API, Video, 工具, Ollama, 語音, Anthropic, Kimi, 小米-Xiaomi, MiniMax

video-use:一句指令把素材剪成 final.mp4

video-use 將 Claude Code、FFmpeg 與 AI 動畫工具串成影片剪輯流程,適合需要快速製作短片的創作者與內容團隊。

video-use

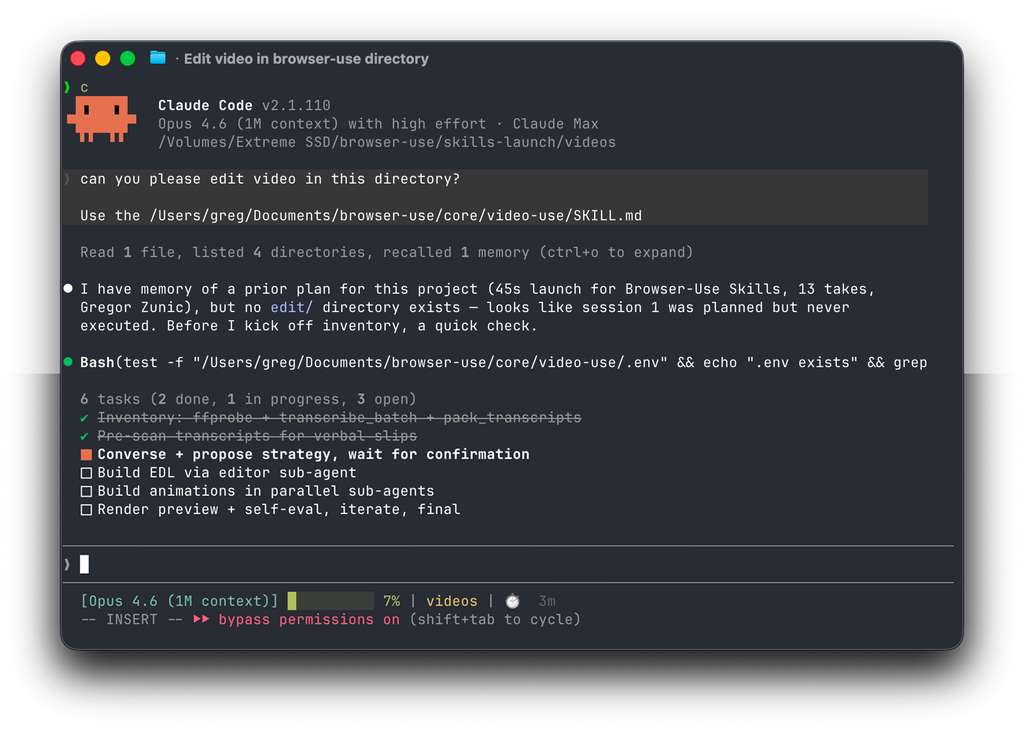
剪片最花時間的往往不是逐格拖拉,而是刪去口誤、停頓、重拍,再處理字幕、調色和動畫。開源項目 video-use 將這些工作整合到 Claude Code 對話中:把原始素材放入資料夾,提出剪輯要求,確認方案後便可取得 final.mp4。

它屬於 Agent 影片剪輯工具,依賴 FFmpeg、ElevenLabs API,以及支援 shell access 的 Agent;Claude Code、Codex、Hermes、Openclaw 等均可按技能方式整合。Agent 會先盤點素材並提出策略,待你確認後才進行剪輯,亦可用 project.md 保存跨次工作的記憶。

  • 自動移除「umm」、「uh」、重試開頭及拍攝間的空白
  • 支援預設或自訂 FFmpeg 調色,並在剪接點加入 30ms 音訊淡出
  • 預設以每兩字一個大寫單元燒錄字幕,樣式可自行調整
  • 可並行呼叫 HyperFrames、Remotion、Manim 或 PIL 製作動畫疊層

這種做法省去大量重複剪輯操作,也毋須在預設項目與選單之間來回切換。代價是成果會受素材品質、Agent 判斷、FFmpeg 設定及 ElevenLabs 服務影響;影片內容、關鍵 API 費用與電腦運算資源仍要由團隊控制。它適合對話式影片、教程、旅遊片段、訪談及社交媒體短片,但複雜敘事和高度精準的專業後期仍需要人工覆核。

影片輸出前,工具會逐個檢查剪接點,協助發現突兀轉場或音訊爆音;然而自我評估並不等同真人審片。採用這個項目時,重點不在追求完全自動,而在讓 Agent 先處理機械而重複的工序,把最後一輪節奏、內容與品牌審校留給創作者。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, Audio, 工具, Content Creator, OpenClaw, Anthropic, 動畫, Skill 技能

video-shotcraft:用一張產品圖製作可編輯的宣傳片

video-shotcraft 將 Claude Code 或 Codex 接到影片製作流程,以 Remotion 排版真實產品截圖,交付可編輯 MP4。

video-shotcraft logo

只要向 Claude Code 或 Codex 提出「替產品製作宣傳片」,video-shotcraft 便會擷取產品真實頁面,選取鏡頭、編排故事線,再以 Remotion 動畫化。最終輸出 MP4、瀏覽器編輯器 Motion Workbench,以及剪映可編輯草稿,方便後續修改。它不是端到端影片生成模型,而是一套整合截圖、動態配方、節拍與音效的 agent skill。

  • 以真實截圖及文案作畫面素材,保留品牌外觀與文字清晰度
  • 提供 124 張 recipe cards,涵蓋 150 種鏡頭及預覽
  • 流程涵蓋 storyboard、Remotion 動畫、節拍同步、聲效及逐格檢查
  • 可交付 MP4、Motion Workbench 與剪映草稿

這種做法與文生影片模型的分別,在於每一幀都由程式碼繪製,而不是生成抽象影像;代價是成品取決於頁面素材、shot recipe 的覆蓋範圍及 Remotion 排版,創意空間主要來自鏡頭選擇和動態組合。36.2 秒的 ready template 可供快速改稿,但較長或講解密集的產品影片仍需要重新編排內容。

產品團隊、獨立開發者及需要反覆製作版本宣傳片的 marketing 部門,都可從「保留可編輯性」中受益。工程師可用現有網站截圖建立視覺稿,內容團隊亦可沿用剪映草稿調整節奏,省去由錄屏再逐段重做動畫的時間。

一行 “幫我安裝這個 skill:https://github.com/Vincentwei1021/video-shotcraft” 便完整安裝。適合希望將影片製作納入 coding agent 工作流、而非直接生成寫實片段的團隊。

項目主頁 · GitHub · 作品展示

Categories: 開源, Agentic, AI productions, Video, Image, Vibe Coding, 編程, Anthropic, 動畫, 聲效, Skill 技能

Kimi K3.1 Pro:開放權重 1M 上下文支援長鏈路代理

完整 model weights 預定於 11 月 4 日釋出。1M-token 上下文支援編程與長鏈路代理,Kimi K3.1 Pro 亦延伸至 3D 創作及金融研究。

Og image

面對超長文件、終端機任務和多步驟研究,Kimi K3.1 Pro 以 1M-token context window 支援長鏈路代理工作,並把 coding、3D creation 與 financial research 放進 3T-class open-weight model。它是 Kimi K3 的 post-trained 版本。

訓練加入更大 post-training compute,在數百個下游領域進行 joint reinforcement learning(joint RL);RL framework、long-context inference、sandbox infrastructure 及 rollout scheduling 亦一併優化,目標是令能力提升更穩定。

  • 長上下文:1M-token context window,適合長文件及多步驟工作。
  • 代理場景:涵蓋 coding、3D creation 及 financial research。
  • 速度選項:Kimi K3.1 Pro Highspeed 標稱快 2 至 3 倍。
  • 權重安排:完整 model weights 預定於 11 月 4 日釋出。

Terminal-Bench 4.0 以資源受限終端機任務和嚴格測試評估 coding agents;K3.1 Pro 得分 65.7%,高於 GPT-6 Astra 的 58.2%,接近 Claude Opus 5.5 的 66.4%,可作為編程代理場景的參考。

模型可於 Kimi Work、Kimi Code 及 Kimi API 使用。

項目主頁

Categories: Agentic, 模型, 模型訓練, API, Image, 框架, Vibe Coding, 3D, Python, 編程, Anthropic, Kimi, 任何模型, 強化學習

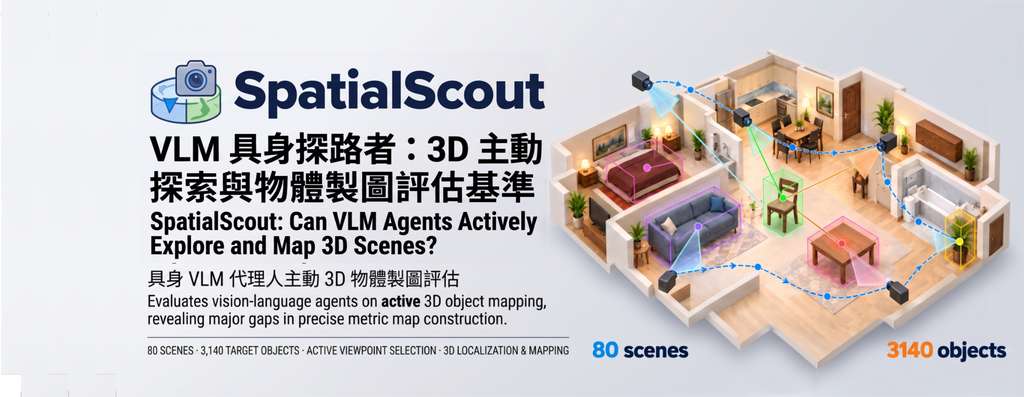
SpatialScout 揭示 3D 定位落差,讓視覺語言模型探索室內空間

視覺語言模型要邊探索室內場景、邊把物件放進共通的 3D 座標,仍難兼顧完整度與精準度。SpatialScout 以 80 個場景測試這種主動建圖能力。

SpatialScout overview

要讓視覺語言模型看過不同角度後,找出物件在房間中的位置,單靠辨認影像並不足夠:模型還要選擇鏡頭視點、累積視覺證據,再把多個畫面中的物件對應起來。SpatialScout 是測試視覺語言模型(Vision-Language Model,VLM)代理主動探索與物件級 3D 建圖能力的基準項目,涵蓋 80 個室內場景及 3,140 個目標物件。

每項任務提供物件清單、RGB 觀察畫面,以及相機校準資料和位置資訊;代理要控制相機,在有限互動回合內探索場景,並估算物件在共通 3D 座標系中的中心位置。這讓測試不只檢查模型能否辨認物件,也衡量它會否選擇有用視點、跨畫面追蹤物件,以及逐步修正位置。

結果反映出由大概布局走向精確地圖仍有明顯距離:表現最佳的受測模型平均 IoU 為 41.71%,只有 3.25%的目標物件達到 IoU 0.9 以上。項目亦提供涵蓋所有物件及已提交物件的八項 IoU 指標,並以成功完成 finish_mapping 的軌跡計算任務平均分;這有助分辨模型是定位不準,還是漏掉了物件。

  • 基準涵蓋 80 個室內場景及 3,140 個目標物件。
  • 每項任務最多 100 回合,模型需主動選擇觀察視點。
  • 評分同時考慮定位準確度與物件完整度。
  • 最佳受測模型平均 IoU 為 41.71%,高精度定位仍有限。

研究團隊可用自己的模型 API 執行全部任務,預設採用 Responses API 模式,亦可切換至 Chat Completions、Anthropic 或 Gemini 端點。項目要求 Linux x86_64 和 Python 3.10,安裝程序會設定 CPU 渲染並透過 apt/sudo 安裝系統套件;場景資源則需另行下載及掛載。它適合研究主動感知、機械人空間理解或多模態代理的團隊作比較測試,但目前提供的是評估基準,不是可直接取代建圖系統的模型。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, 視覺模型, 多模態模型, Gemini, API, Image, 3D, Linux, Python, Anthropic, Dataset 數據集

Page 2 of 8
1 2 3 4 … 8