Building Rome 單張相片重建完整 3D 場景

只用一張相片,Building Rome 便嘗試補全鏡頭外的建築與室內結構,生成可探索的 3D 場景網格。連看不見的空間也能生成。

Og image

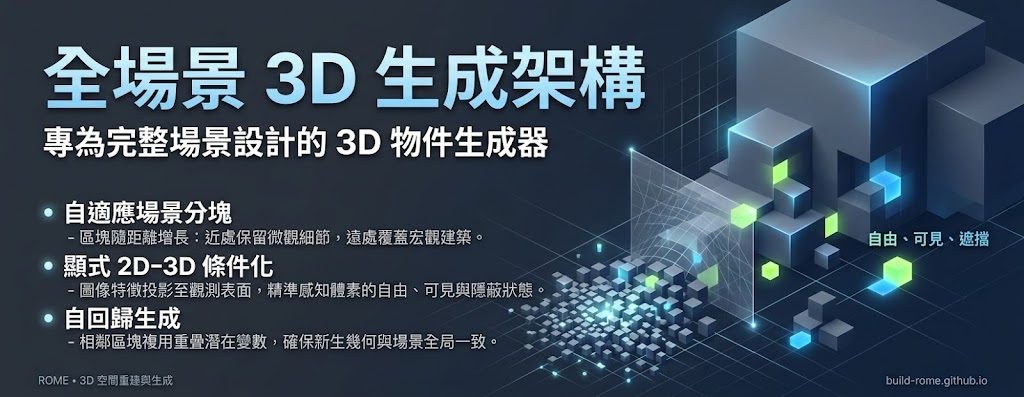
只得一張相片,Building Rome 便嘗試補全鏡頭未拍到的空間,生成室內、戶外及大型環境的完整 3D scene mesh。這個單影像 3D 場景重建項目,處理的是照片只提供單一視角、遠近物件細節不一致,以及隱藏幾何無法直接觀察的問題。

方法把場景切成會隨距離變化的 adaptive chunks:近處使用較細區塊保留細節,遠處則用較大區塊涵蓋建築。影像特徵會投射到已觀察到的表面,而每個 voxel 亦會標示空置、可見或隱藏狀態;生成鄰近區塊時重用重疊 latent,令新加入的幾何結構較能保持連貫。

讀者可以透過互動檢視重建結果,透過拖曳旋轉、滾輪縮放及 WASD、Q、E 移動,亦可選取兩點量度距離。網頁展示用 mesh 為方便瀏覽而簡化至約 1.5M faces,論文圖像及影片則採用完整解析度,因此兩者的視覺細節不應直接視為相同。

  • 單張相片重建室內、戶外及大型場景
  • 以 adaptive chunks 處理不同距離的細節
  • 透過 2D&3D conditioning 推斷可見與隱藏幾何
  • 以 autoregressive generation 延續相鄰區塊的一致性
  • Code 標示為即將提供,現時可先透過互動網頁查看結果

項目由 Applied Intuition 聯同 Purdue University、UIUC 及 UC Berkeley 研究人員完成,並以 World Tracing、GenRecon、VolFill 及 Lyra 2.0 等方法作比較。對需要由照片建立可探索環境、進行空間分析或製作 3D 內容的人,這種由單一視角推算完整場景的做法提供了另一條工作流程,但隱藏區域屬於模型生成,不能當作相片直接觀察所得的精確測量。
項目主頁 · 項目

Categories: 開源, AI productions, 模型, 視覺模型, Video, Image, 3D, Anthropic

VeriHarness 長流程 AI 任務的修訂

長時間 AI 任務不再只靠一次輸出或投票,VeriHarness 讓模型查證分歧與共識,再交付有證據支援的成果。結果同一模型也能做驗證!

VeriHarness

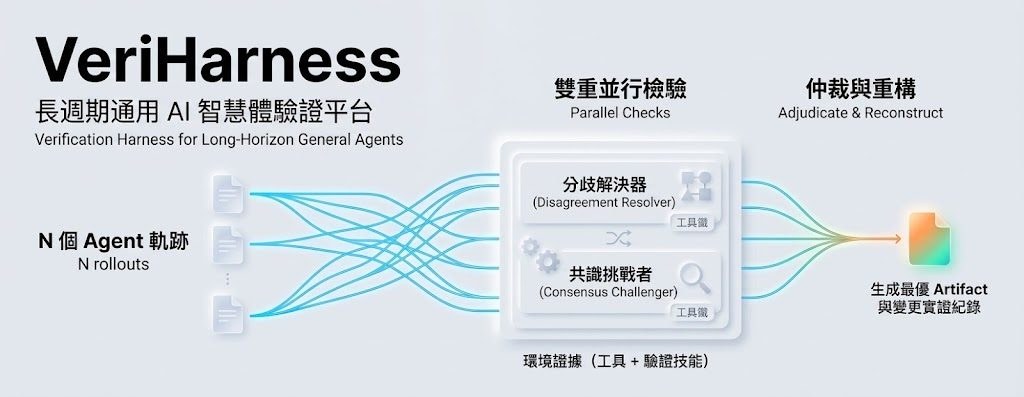
長時間 AI 任務容易在細節中累積錯誤,單靠一次 rollout 或多數票未必能找出共同誤判。VeriHarness 是一個面向 long-horizon general agents 的 verification harness,讓產生答案的同一個模型檢查環境證據、修訂成果,並記錄每項改動的原因。

它會把 N 次獨立 rollout 交給兩條調查流程:disagreement resolver 核對不同嘗試提出的主張,consensus challenger 則專門反查所有嘗試都同意的內容。兩邊取得文件、資料或可重新計算數值後,再由 adjudication 選取或重建 artifact,處理了「分歧不等於錯誤、共識也可能共同出錯」的取捨。

透過 Gemini on Vertex AI 或 Claude on Vertex AI 執行驗證;wb 與 wsb 評分器則在網絡容器中處理文件、試算表、程式碼及多檔案工作區任務。項目同時公開約 26,000 次 rollout,方便研究團隊重現流程或比較自己的 verifier。

結果顯示,Gemini 3.5 Flash 作為 generator 和 verifier 時,證據支援的修訂比單次 rollout 平均高 6.2 分;Claude Opus 4.8 則高 6.4 分,五個 benchmark 的十個 model–benchmark settings 均取得最高 primary selection score。這些數字反映選擇與修訂能力,不能直接等同完整 artifact 必然正確。

  • 適合長流程工作:文件、試算表、程式碼及多檔案任務均可納入檢查。
  • 核心差異:同一模型負責產生與驗證,優勢來自 rollout pool 結構及環境證據,而非更強的 judge。
  • 研究價值:分開測試 disagreement 與 consensus,能定位模型反覆犯下的共同錯誤。
  • 使用限制:需要模型服務、評分容器及可檢查的任務環境,配置成本高於單次生成。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, Google, Gemini, Anthropic, Dataset 數據集

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bash 同 frames,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, 庫, Anthropic, 動畫, Dataset 數據集

anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, 庫, 語音, Anthropic, 動畫, Skill 技能

Dr. Claw 把 AI 研究流程收進一個可審核工作台

一款開源 AI 研究助理,把文獻回顧、實驗、寫作整合在同一介面,讓人類決策與 AI 執行之間留下可追蹤的紀錄。

Dr. Claw

跑過 AI 研究的團隊都遇過同樣的痛:Claude Code、Gemini CLI 等命令行編碼代理(coding agents)能讀寫檔案、撐住長對話,但文獻回顧、構思、實驗、寫論文、投期刊這些步驟散落在聊天工具、IDE、終端機、寫作軟件之間,中間決策也難以回頭追溯。Dr. Claw(GitHub: OpenLAIR/dr-claw)針對的正正是這個碎片化問題——它不是另起爐灶造一個新代理,而是把現有命令行編碼代理(Claude Code、Gemini CLI、Codex,以及透過 OpenRouter 接入的數百個模型)包進一個可控、可審核、人在回路(human-in-the-loop)的工作流。

項目覆蓋 survey → ideation → experiments → paper writing → slides & promotion 整條研究生命週期,與只懂執行程式碼的 CLI 代理相比,差異在於「全流程編排層」。底層靠三個關鍵設計撐起這層:持久化狀態物件(persistent state objects)、可重用技能庫(reusable skill library),以及多執行器協調(multi-executor coordination),把計劃、執行、寫作綁成一條可恢復的循環。論文亦明確指出,比起只共享同一後端執行器的裸 CLI 代理,Dr. Claw 在研究完整性上得分更高,同時保留可審計、可回溯的過程痕跡。

對獨立研究者、AI 實驗室團隊、需要把研究流程制度化的單位而言,這套架構的價值在於把人類決策(目標、約束、驗收)與 AI 執行清楚分開,並透過 checkpoint 反饋(Verify / Revise / Retry / Handoff)保留介入點。它支援本地部署(自家機器、自家 GPU、自家資料),亦提供桌面版(.dmg / .exe)或 npx dr-claw 零安裝啟動,甚至能在終端機直接 dr-claw chat 跑 agentic 對話。

項目已被 EMNLP 2026 System Demonstrations track 收錄(arXiv: 2609.00365),並採用 AGPL-3.0 搭配上游 GPL-3.0 元件授權,免費、無訂閱。需要留意的是,它自定位為 Anthropic Claude Science 的開源、模型中立替代方案,主打全生命週期而非單純計算分析。

GitHub · Paper

Categories: 開源, Agentic, 模型, OpenAI, Gemini, 軟件, 工具, IDE, 庫, 編程, Anthropic, Skill 技能

AREX-Skill 把 GitHub 知識變成可執行技能

AREX-Skill 將熱門 GitHub 儲存庫整理成可驗證、可執行的技能,讓 Coding Agent 在複雜機器學習研究任務中少走彎路。

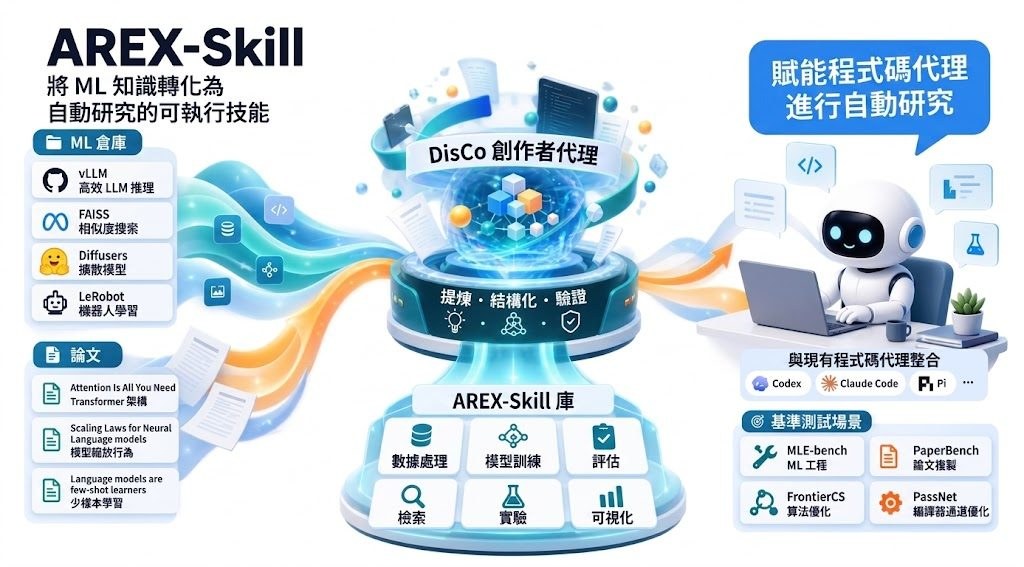
AREX-Skill turns repository and paper knowledge into executable skills for coding agents and autonomous ML research

面對需要查閱多個儲存庫、重現研究流程和逐步驗證結果的工作,AREX-Skill 將分散在 GitHub 的操作知識整理成可重用程序、檢查方法和技能圖譜。它屬於面向 Coding Agent 的開源技能庫與工作流工具,實際處理的是代理有模型能力卻欠缺項目脈絡和操作經驗的問題。

AREX-Skill 已從 1,000 多個熱門機器學習儲存庫提煉超過 5,000 個經驗證、可執行的 skills,並可整合 Codex、Claude Code、Pi 等 Coding Agent。使用時可按任務由 router 從技能庫收窄至相關分支,再由代理執行;DisCo 則負責將儲存庫知識建立、驗證和匯出成技能。

  • 技能包含程序與檢查,而不只是文字說明
  • 技能圖譜協助代理處理跨學科機器學習研究
  • DisCo Meta Skills 支援挑選及使用 Creator meta skills
  • Refreshing Repo Skills 提供維護和更新清單

相較於每次由代理重新閱讀 README、程式碼和論文,技能化做法可把重複的操作步驟預先整理,並將預算集中到較困難的推理工作;代價是技能需要隨儲存庫更新而刷新,覆蓋範圍和驗證品質亦會直接影響結果。儲存庫目前提供 Demo、技能目錄、repository catalog 及 DisCo CLI 文件,適合研究團隊、Coding Agent 使用者,以及需要重現多個 ML 項目的開發者。

GitHub

Categories: 開源, Agentic, Vibe Coding, 編程, Anthropic, Dataset 數據集, Skill 技能

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

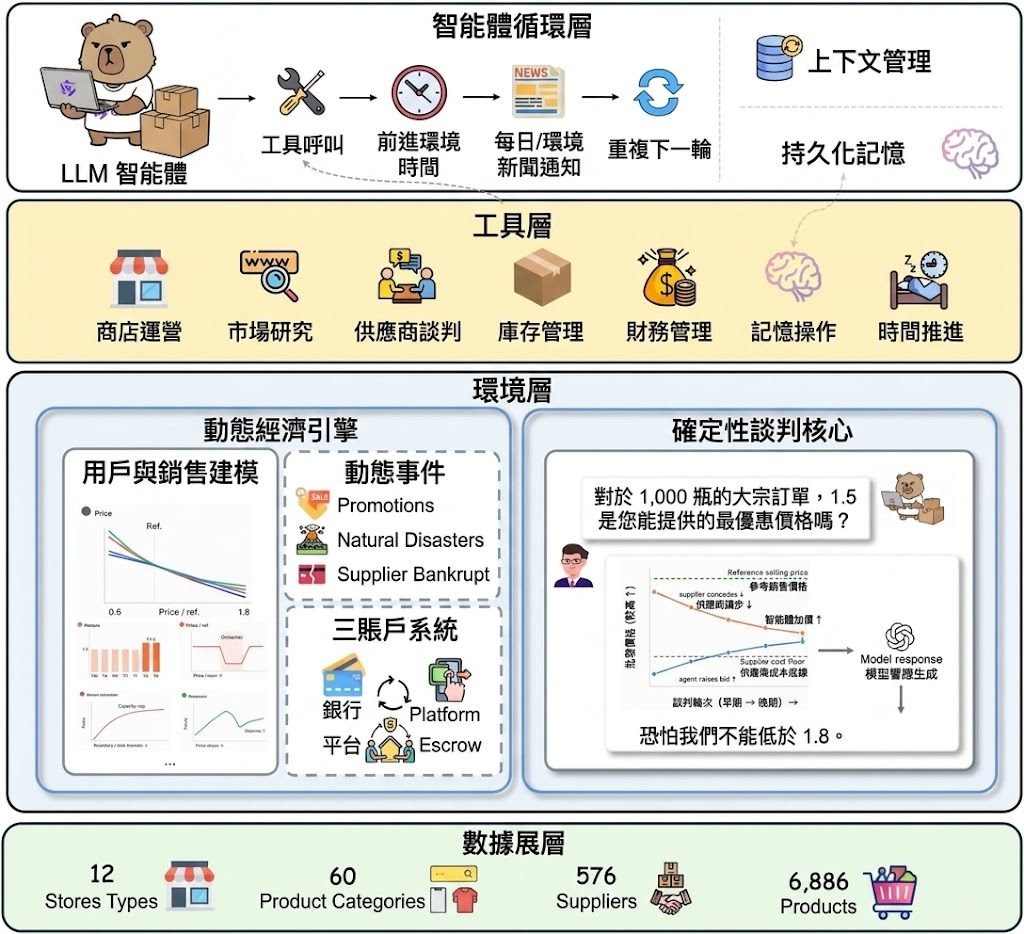
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, Google, OpenAI, DeepSeek, Gemini, Python, Anthropic, Dataset 數據集

H3 分鏡技能:分鏡及表情提示

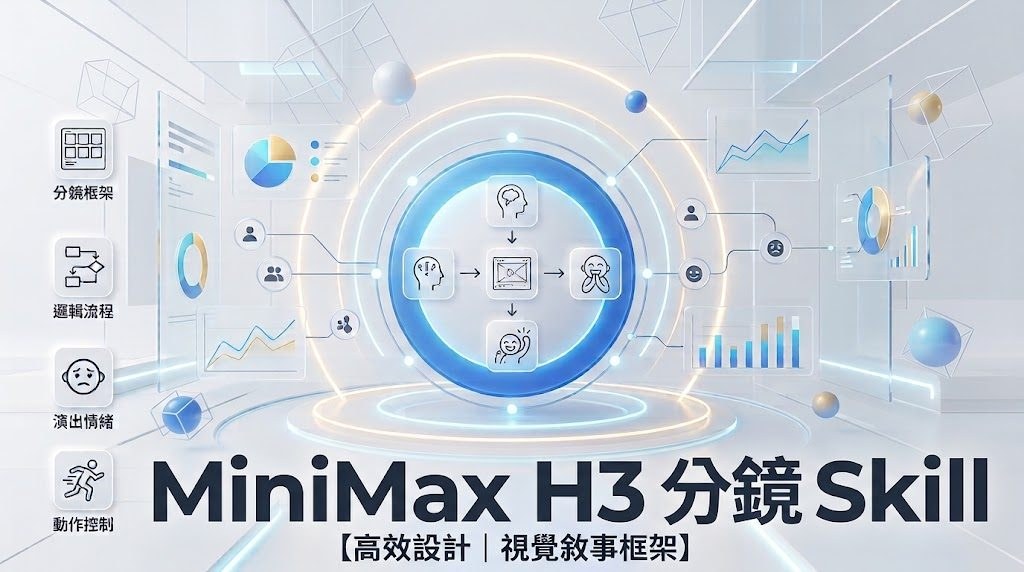
這個 Claude Code 技能把腳本拆成 MiniMax H3 可渲染嘅分鏡,主打情緒表演真正落到畫面。佢直接指出:同一格塞太多表情指令,H3 會靜靜丟棄。

Repository image for phileiny/h3-storyboard-skill

用 H3 做有情緒起伏嘅影片,最容易撞牆嘅位通常唔係 prompt 寫得唔夠仔細,而係你貪心將太多表情塞落同一格。呢個 Claude Code 技能就係針對呢個盲點:佢唔止幫你格式化 H3 嘅 prompt schema,仲會教你點樣拆鏡頭、每格留幾多 beat、點樣導演一張臉。

核心發現來自一個對照實驗。同一個 shock beat、三次跑、同一粒 seed、同一批 reference 圖,只改動鏡頭結構:A 方案係一格 7 秒 close-up 塞 9 個表情指令,結果臉完全唔郁,PSNR 高達 37–42 dB,即係畫面接近凍結;B 方案拆成三格 2–3 秒、每格一個 beat,PSNR 跌到 22–23 dB,所有 beat 都落到;C 方案喺 B 基礎加返 <d> 對白標記,PSNR 再降到 19 dB,但代價係鏡頭時間被 H3 重新分配,背景角色連門一齊被裁走。結論好直接:開工前先數 beat,超過兩三個就要拆鏡頭。

另一個值得留意嘅細節係「唔好寫乜都唔變」。H3 對靜態描述容易洩漏到成個鏡頭,想表達 pause 就交俾剪接手。尺寸同距離方面,佢建議用相對關係(畫面三分二高、離底部一手寬)而唔係絕對數字,否則渲染出嚟會走樣。形狀就靠 reference 圖頂住,純文字三次都搞唔掂一個 1.75:1 嘅窗框。

需要用 H3 拍敘事短片、廣告 storyboard、或者任何要精準控制表情嘅創作者。比起坊間只做翻譯嘅 H3 技能,呢個項目多走一步:佢承認有啲規則只係推論(effect 係真實嘅,cause 仍未隔離),全部齊齊整整列喺 SOURCES.md 分做 verified、partly verified、inferred。

  • 屬於工具類 Claude Code 技能,解決 H3 prompt 表情指令被靜默丟棄嘅問題
  • 對照實驗證明分鏡頭係恢復情緒表現嘅關鍵機制
  • 對白標記唔會令臉郁,只會改變 H3 對鏡頭時間嘅分配
  • 距離用相對關係、形狀靠 reference 圖,純文字描述容易失效
  • SOURCES.md 將規則分三級誠實標註,邊個有控制實驗支持一目了然

GitHub

Categories: 開源, ComfyUI, Anthropic, MiniMax, Skill 技能

OpenClaw 2.0 重建介面與記憶連續性

OpenClaw 2.0把入門流程、對話延續同穩定性一併重做。對長時間使用 AI agent 的人,差別會先體現在找回上下文同減少中斷。

用得久嘅 AI agent,最怕唔係功能少,而係中途斷線、記唔住之前做過乜,或者想翻查舊對話時搵唔返內容。OpenClaw 2.0 針對呢類問題重做咗網頁體驗,亦加強咗 memory 同 session continuity,令長流程互動唔使成日由頭開始。

今次版本另一個直接影響體驗嘅改動,係 onboarding 變得更簡單。新手由安裝到開始使用嘅門檻降低,而舊用戶就會更在意 reliability pass 帶來嘅穩定性提升;更新說明同時提醒先備份 configuration 同 state,亦提到自動更新失敗時,可以用本地 coding harness 幫手完成更新、排錯同確認 Gateway 正常啟動。

文件列出咗一個幾實用嘅新能力:可以用完整字詞或片語搜尋可見對話內容,之後直接打開相符結果附近嘅訊息。對要追查工作脈絡、整理多輪討論,或者長時間同 agent 協作嘅人,呢個改動比單純加模型選項更有感。

  • 重做 web 體驗,介面與流程更貼近持續使用情境
  • 強化 memory 同 session continuity,減少對話中途斷層
  • 新增對話文字搜尋,可由結果跳回相關訊息位置
  • 做咗大規模 reliability pass,重點放在穩定運行
  • 更新時仍有 migration 要求,Plugin SDK compatibility 亦有保留與修補

OpenClaw 2.0 今次唔係靠單一新模型吸引注意,而係集中修補 AI agent 項目最常見嘅摩擦位:入門、延續性、搜尋同可靠度。對已經把 OpenClaw 放入日常工作流嘅團隊或個人,呢次更新代表系統更接近可長時間依賴嘅狀態;不過升級前後仍要留意 migration 與相容性檢查。

項目主頁

Categories: 開源, Agentic, OpenAI, API, OpenClaw, Anthropic

Page 4 of 8
1 2 3 4 5 6 … 8