CASE 讓 8B 模型主動尋找長期病歷證據

CASE 訓練視覺語言模型自行翻查跨時段 MRI 與臨床資料,將醫療問答由讀答案推進至主動取證。

Repository image for VinyehShaw/CASE

面對需要比較多次就診、器官變化與 MRI 切片的臨床問題,CASE 讓模型先決定應該查哪次訪視、哪個器官及哪種工具,再整理證據作答。這個項目屬於醫療多模態模型與 Agentic learning 實作,處理的是長期臨床推理中「證據未預先整理」的難題。

核心模型採用 Qwen3-VL-8B-Instruct,透過兩階段訓練建立工具使用能力:先以 RSFT 學習經篩選的教師軌跡,再以 Agentic RL 和 GRPO 讓模型根據自身操作結果修正策略。RLAIF rubric judge 負責評分,OPSD 則利用 privileged self-distillation,改善由證據走向結論的推理,而不硬性規定工具次序。

同一個 checkpoint 會按三種臨床角色工作:Anatomist 處理器官分割和體積變化,Radiologist 比較跨訪視 MRI,Consultant 則綜合影像、體積、MedGemma 報告和 skill memory。工具預算由 4 至 12 次不等,反映不同任務在查證深度與成本之間的取捨。

  • 以 UK Biobank 4,739 名參與者建立 50,401 條縱向臨床問題
  • 訓練資料包含 147,434 條 frontier-model 互動軌跡
  • 在匹配條件下,Qwen3-VL-8B agent 的答案準確率較 GPT-5.4 高逾 16%,較 Claude Opus 4.8 高逾 10%
  • 適合研究醫療 agent、MRI 分析及跨訪視證據整合的團隊

項目提供 Docker 環境,但執行預設需要 8 張 GPU、運行時可用的 gcc、另行下載 Qwen3-VL-8B-Instruct 權重,以及供 RL rubric judge 使用的 OpenAI-compatible API key。資料須透過 UK Biobank Showcase 或已獲批的 UKB-RAP 申請取得;適合作為研究型項目測試,未宜直接視為可即時投入臨床的產品。
項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 多模態模型, 模型訓練, Qwen, API, Image, 工具, Medical醫學, Dataset 數據集, Skill 技能, 強化學習

InstantFusion 讓不同影像模型接力生成

InstantFusion 把不同 diffusion models 接到共同 latent space,令模型可以中途交接、加速生成,亦能混合不同偏好。

InstantFusion — A Shared Latent Interface for Image Generators

當一張圖的生成工作需要在 Qwen-Image、FLUX.1 或 SD3 之間切換,InstantFusion 讓去噪軌跡可以在中途交接。這個開源研究項目屬於影像模型工具,處理的是不同 diffusion models latent space 不相容,難以直接接續生成的問題。

核心是 Latent Alignment Encoder(LAE):模型專屬的 encoder 和 decoder 先把各自 latent 映射到 shared latent space,再以重建、cross-reconstruction、latent alignment 及 denoising-velocity alignment loss 保留圖像資訊和去噪動態。模型本身維持 frozen,LAE 負責建立彼此之間的轉換接口。

完成對齊後,生成軌跡可以交由另一個模型繼續處理,帶來三種用途:
– 不同步數預算的模型接力,嘗試縮短生成時間
– 結合針對不同偏好優化的模型
– 在 shared latent space 進行 cross-model OPD,以模型 A 的 velocity field v 蒸餾模型 B

LAE 重建測試涵蓋 Qwen-Image、FLUX.1 和 SD3,並以 100 張圖片計算 mean SSIM;介面驗證亦顯示,單次 latent round trip 能保留較高 fidelity,但反覆轉換會累積 reconstruction error。這意味着模型接力有實用價值,但不適合無限制地來回切換。

儲存庫包括 LAE training、OPD training 和 LAE-based model handoff inference,適合研究 heterogeneous image generators、模型融合或生成加速的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 上海人工智慧實驗室, 模型, 模型訓練, Qwen, Stable Diffusion, Image, 影像模型, 香港, 工具, 庫

Representation Guidance(RG):以低維引導 Pixel Diffusion Transformer 生成影像

Representation Guidance 把生成所需資訊壓縮到低維表示,再直接引導像素生成,為大型 pixel diffusion Transformer 提供更有效率的改良方向。

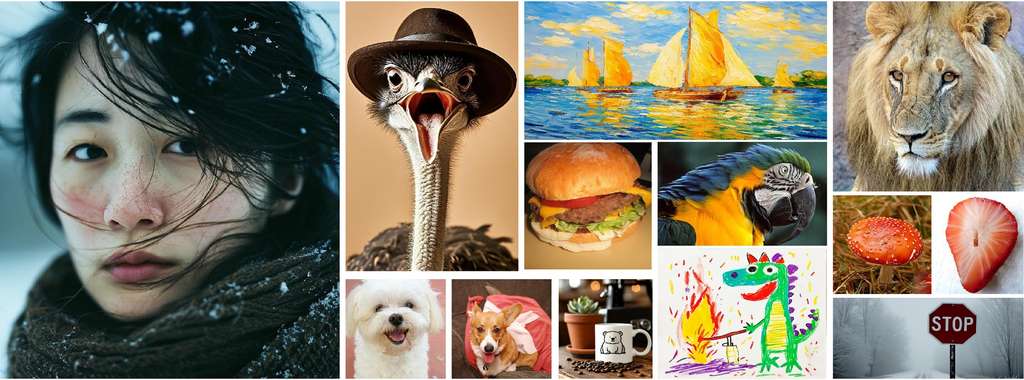
Samples generated by RG

由像素直接生成高質素影像,往往要在語義理解、空間細節與模型計算量之間取捨。Representation Guidance (RG) 屬於影像生成模型方法,針對 pixel diffusion transformers 加入可被生成流程主動利用的內部表示,同時保留 plain Transformer 架構,處理表示學習與像素合成未能有效銜接的問題。

RG 先用 low-dimensional bottleneck 將與生成相關的資訊集中到緊湊表示,再按照該表示帶來的 prediction offset,修改 flow-matching target,直接引導 decoder 生成。它沒有依賴外部 autoencoder 預先建立 representation space,而是由 raw pixels 端到端學習;相較加入專用 pixel decoder 的架構,RG 嘗試避免只重新分配語義及空間建模工作,並以較簡單的 Transformer 結構擴展。

在 ImageNet 256×256 測試中,RG-L/16 使用 459M 參數,在 600 epochs 達到 1.79 FID;RG-XL/16 以 724.9M 參數取得 1.55 FID、293.8 IS。項目亦報告 512×512 的 1.74 FID,並延伸至 text-to-image,在 GenEval 取得 0.89、DPG-Bench 取得 87.1;這些結果顯示方法適合研究高解析度像素生成及文字生圖,但較大型模型仍需要相當計算資源。

你可從以下幾點理解它的實際價值:
– 低維 bottleneck 將生成相關資訊集中,減少表示與生成流程各自學習的落差。
– RG-L/16 以較少參數超越更大型的 pixel diffusion transformers。
– plain Transformer 方便研究內部表示如何形成及影響像素合成。
– 項目資料提供結果與模型規模,但未交代完整安裝、下載或推理流程,測試前仍需查看 Project Page 或後續程式碼。

較適合研究 pixel diffusion、生成式表示學習,以及希望比較 flow matching 架構的團隊。它的價值不在於提供即時可用的生圖工具,而在於把「學到表示」與「利用表示生成」放入同一個訓練機制;模型參數和 GFLOPs 仍然偏高,未必適合資源有限的個人電腦。

項目主頁 · GitHub

Categories: 開源, 香港大學, 阿里巴巴, 模型, 模型訓練, Image, World-Action Model, txt2img, 香港, 工具

Google Foresight:會議筆記與個人資料留在 Mac

Foresight 在 Mac 本地聆聽會議、整理筆記,亦能按你的檔案即時回答問題。

開會時只需記下零碎提示,Google AI Edge Foresight 便可配合本機轉錄內容整理成較完整的會議筆記。工具支援 Google Meet、Zoom,以及面對面或離線對話,音訊和文字都在 Mac 處理,不必上傳雲端。

Foresight 亦能連接本地項目資料夾、Google Drive、參考文件、圖表、網頁連結和日曆,建立與工作相關的背景資料。對話期間,它可透過聊天檢索內容;Live Assistance 更會聆聽問題,在相關資料出現時主動顯示附有引用來源的 context cards,減少會議前準備和反覆確認資料的時間。

技術核心包括 740M 參數的 EmbeddingGemma 2。這個 on-device multimodal embedding model 會把文字、圖片、影片和音訊映射到同一向量空間,支援跨模態語意檢索;配合 Gemma 4,可在裝置上建立即時的 Retrieval-Augmented Generation(RAG)流程,避免網絡延遲。

  • 會議轉錄、音訊與檔案留在 Mac
  • 支援影片會議、面對面及離線對話
  • 可把速記提示整理成完整筆記
  • 支援跨文字、圖片、影片和音訊檢索
  • 具備聊天及 Live Assistance 兩種取用資料方式

頁面提供 macOS 下載入口。需要高度重視資料私隱、又經常在多個本地檔案之間切換的人,較容易感受到這種本機 AI 工作流的便利。

項目主頁

Categories: AI productions, RAG, Embedding, 多模態模型, Google, Gemini, Video, Image, Audio, 工具, Mac

REA:讓 AI 逆向拆解 App 功能至二進制層面

想複製別人 App 的功能,REA 讓 AI 代理在沒有原始碼下調查行為、保留證據,並協助重建。

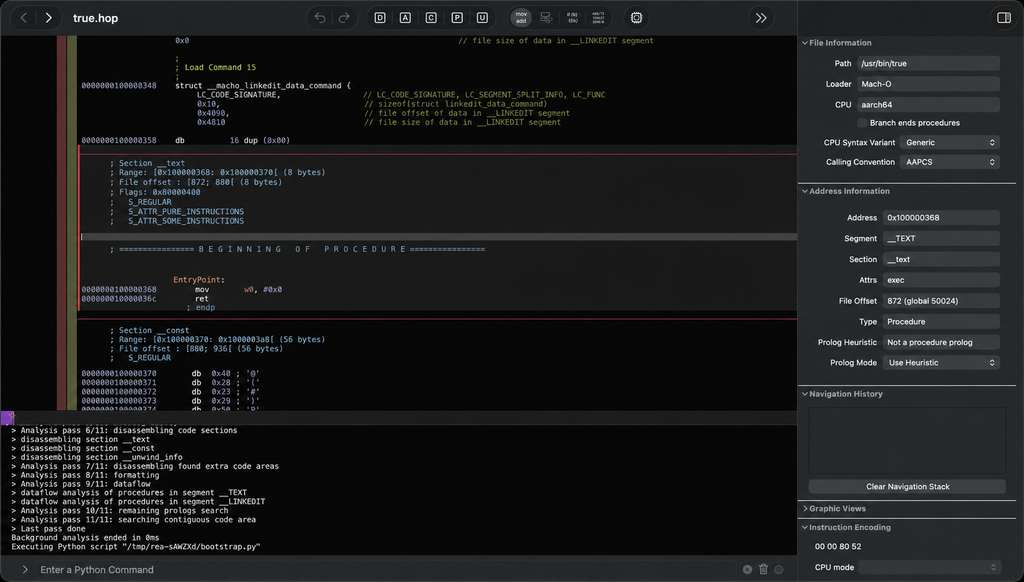
REA launching its analysis bridge inside Hopper while inspecting a native binary

想知道一個 App 的功能點樣運作,卻拿不到原始碼,REA 讓 AI 代理直接檢查應用程式、原生二進制檔案及執行時行為,再用證據解釋結果。它屬於開源逆向工程工具,實際處理的是由功能觀察、底層分析到重建實作的工作流程。

REA 以 Model Context Protocol(MCP)把分析工具接入代理,代理可按步驟展開調查,讀取工具結果、管理 sessions,並將 snapshots 匯出或匯入。對產品團隊而言,價值不只是找出某個功能的表面行為,而是把調查所得轉化為自己項目的實作參考;不過分析結果仍取決於可取得的執行環境、工具支援及代理判斷,不能視為自動產生的完整原始碼。

How To Use REA To Clone Any Software In Minutes

使用時可先透過 Node.js 設定 agent registration 和 provider,再檢查單一 agent 或 analysis engine 的 readiness。CLI 提供 provider 選擇、證據管理、退出狀態及診斷功能,MCP contracts 和 agent prompts 則用來固定工具回傳格式及引導調查流程。

EP424 - 一句話逆向任何 App?AI 逆向工程 REA,這代表什麼

可留意的重點包括:
– 支援 native binaries、應用程式及 runtime behavior 的逆向分析
– 在沒有 source code 的情況下展示調查證據
– 透過 MCP 連接代理、工具、providers 和 sessions
– 提供 snapshots、import/export、readiness troubleshooting 及 CLI catalog
– 適合產品仿製研究、相容性分析及安全研究,但不保證每次都能還原完整功能

REA 比單次檢查工具更接近一套可重複的代理工作流,適合需要比較競品功能、研究封閉軟件或建立相容版本的工程團隊。項目仍在按 roadmap 擴展能力,採用前應先確認目標平台、分析工具及 provider 是否獲支援。

GitHub

Categories: 開源, Agentic, MCP, 軟件, 工具, 編程, 安全

[技術文章] HARNESSSQL 讓 SQL 代理在真實資料庫中學習

SQL 代理不再只需一次生成查詢,而是在可執行資料庫內探索、修正錯誤並完成任務。

Hero image preview

面對陌生資料庫,SQL 代理往往要先查看 schema、檢查欄位和值,再執行試探查詢、分析錯誤,最後修訂並提交 SQL。HARNESSSQL(Harness-Native Training for SQL Agents in Realistic Database Environments)是一套面向這類互動流程的後訓練框架,針對模型訓練只學習「問題直接對應查詢」、但推理時才加入執行工具的落差作出修正。

傳統 Text-to-SQL 通常把資料庫視為靜態提示內容,難以涵蓋長時間、多回合的探索。HARNESSSQL 建立隔離且可執行的資料庫環境,配合隱藏的 execution oracles,讓教師模型直接在目標 SQL harness 內完成互動,並只保留經驗證的操作軌跡進行 full-sequence SFT,之後再以 execution reward 進行 RL。

項目的核心做法包括:
• 將 schema 檢查、工具呼叫、查詢執行及錯誤修正納入訓練流程
• 以 sandbox 控制資料庫狀態,保存結果與錯誤回饋
• 只使用可驗證的成功軌跡,減少錯誤示範干擾
• 讓模型適應 Spider 2.0-SQLite 的互動式任務

在 Spider 2.0-SQLite 上,Qwen3-8B 的 execution accuracy 由 15.5% 升至 45.2%,Qwen3-14B 則由 22.2% 升至 54.8%;訓練所得能力亦能轉移至 BIRD-Interact 和 LiveSQLBench。結果反映,資料庫代理要處理複雜工作流,訓練階段同步保留執行 harness,比只在推理階段補上工具更能縮小訓練與使用環境的差距。

Paper

Categories: 開源, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, Qwen, 微軟, 框架, 香港, 工具, 庫, 強化學習

ComfyUI-VoiceWorkbench:本地語音工作台:逐句修正音高與節奏

不用剪碎音檔,便可逐句調整音高、字詞時長、停頓和尾音,並比較不同錄音版本。

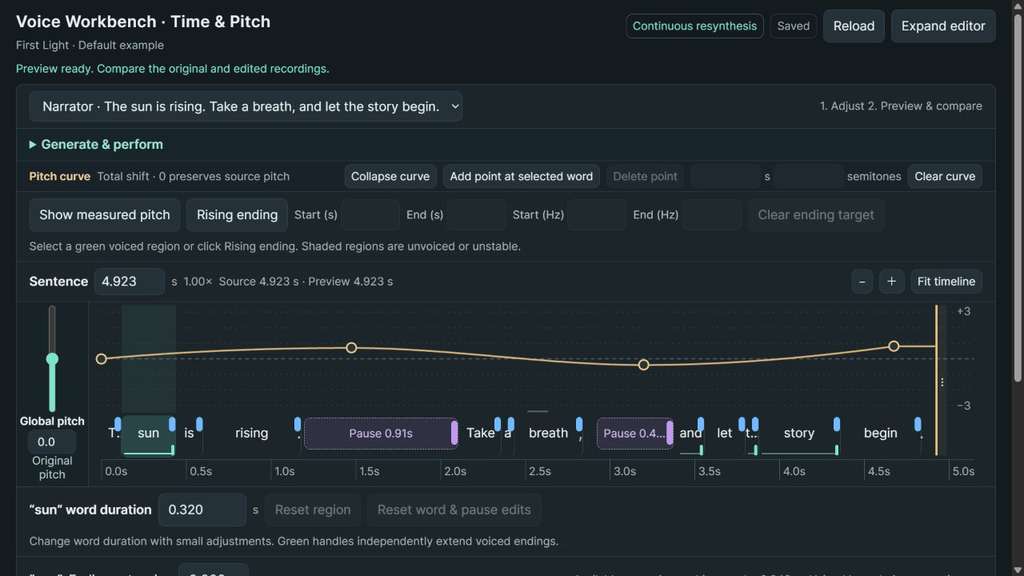
Voice Workbench

想修正一句旁白的語速、音高或句尾拖音時,ComfyUI-VoiceWorkbench 讓你在完整錄音上直接編輯,毋須把每個字剪開再重新拼接。這個項目屬於本地語音編輯工具,實際處理的是生成語音和錄音後期微調之間的卡位;編輯器可作為 ComfyUI 底部面板使用,也能獨立在本機運行。

聲音處理採用一次 Praat resynthesis pass,同時套用整段錄音的時長和音高變化,未修改的預覽則保留原始 WAV bytes。介面可調整 0.75 至 1.25 倍全局速度、全局音高及最多 64 個局部曲線點,亦能處理現有停頓和可靠的 voiced ending;編輯完成後可比較 Original、Edited 與不同生成 take,再回到較早版本。

  • 不用下載模型:內置例子可直接開啟和編輯,Windows 亦可調用已安裝的英文系統語音。
  • 適合本地工作流:支援 Python 3.10 或更新版本,並可接入 ComfyUI custom nodes。
  • 保留人工判斷:字詞邊界只是估算,無聲或不穩定區域不能可靠提供音高目標。
  • 有明確範圍限制:單聲道錄音約 0.15 至 60 秒,AI take 最多 200 字元;服務只綁定 loopback,並非公開共享伺服器。

可選的本地適配器把能力延伸至語音生成和表演編輯:IndexTTS2 支援參考聲線及情緒生成,AuK Base 用於整段錄音的表演編輯,Qwen3 forced aligner 則協助估算字詞邊界。這些元件不是開啟基本編輯器的必要條件,系統語音也不提供聲線複製或情感控制。

適合旁白製作、語音原型和 ComfyUI 使用者處理少量錄音,而不是多人共用的雲端配音平台。尾音延長最多 200 毫秒,目標音高及 voiced 區域亦有上下限;自動對齊不代表每個字都讀得正確,接受修改前仍要逐段聆聽。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Audio, 工具, Python, 語音

OneSearch-VL:多模體視覺 deep research agent

由單張相片到影片片段,OneSearch-VL 會找出視覺線索、搜尋外部資料,再把證據串成可核對的答案。

OneSearch-VL

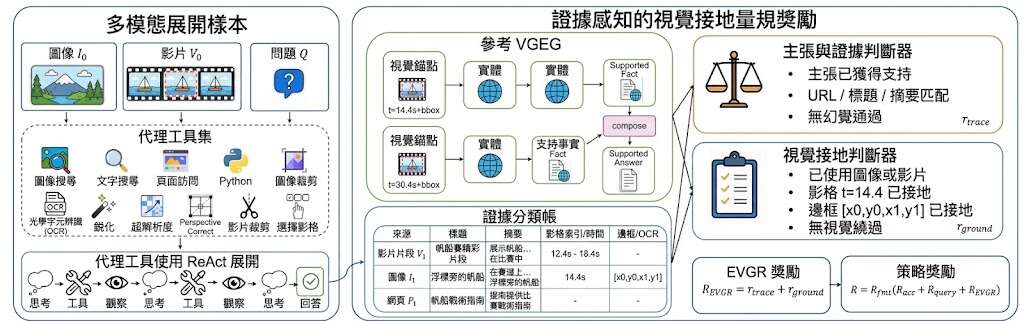
由一張相片、相片集合到影片片段,OneSearch-VL 會先定位視覺線索,再檢索外部知識,將相關證據組合成答案。它屬於多模態 deep research agent,處理的是影像內容理解與資料查證之間難以銜接的工作。

核心是 Visually Grounded Evidence Graph(VGEG),把視覺錨點、來源支持的事實和產生答案所需的操作連在一起。VGEG 亦支援資料建立及驗證;Evidence-aware Visual-Grounded Rubric reward(EVGR)則在強化學習中監督證據是否可追溯,以及答案有沒有真正對應影像內容。

項目提供 OneSearch-MI-Bench 和 OneSearch-Video-Bench,分別面向多圖及影片研究能力。輸入資料未列出具體分數或模型名稱,因此不能把它描述成已全面勝過其他視覺研究方案;它較適合用作研究原型、訓練資料管線和 agentic workflow 的基礎。

OneSearch-VL 包含 Agentic SFT、Agentic RL、推理及評估相關目錄,並標示 Python 3.11+;先準備模型、資料集和外部工具,再執行訓練或評估流程。對需要查核圖片來源、比較多張圖片,或從影片整理證據的研究團隊,這種統一處理方式較容易整合到既有工作流,但部署成本和工具依賴仍要自行確認。

• 同時支援單圖、多圖集合及影片
• 以 VGEG 統一視覺線索與外部證據
• EVGR 強調證據可追溯及視覺對齊
• 提供多圖與影片專用 benchmark
• 支援 SFT、RL、推理和評估流程

GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Video, Image, 工具, Python, 庫, Dataset 數據集, 強化學習

Compo:以 Spatial Canvas 編排海報中的文字、人物與圖像

Compo 讓你用畫布安排文字、人物與圖像位置,再交由模型生成海報,減少只靠文字描述構圖的反覆試錯。

Compo Teaser

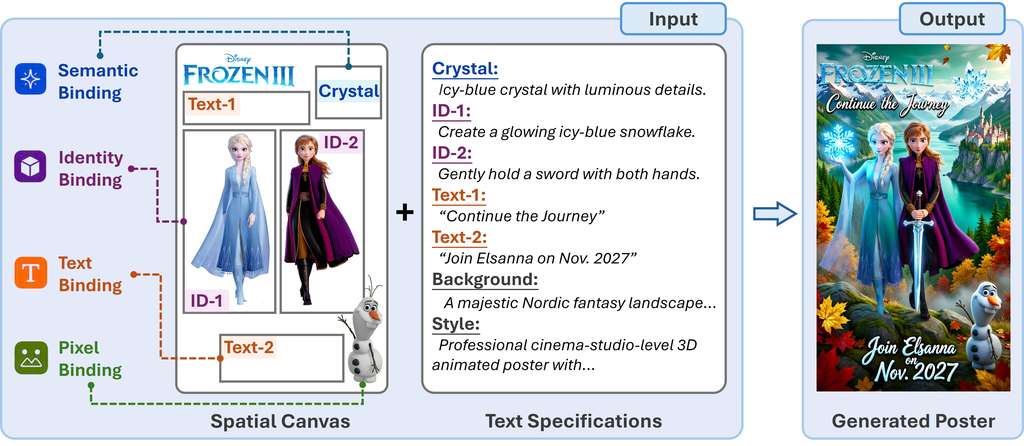
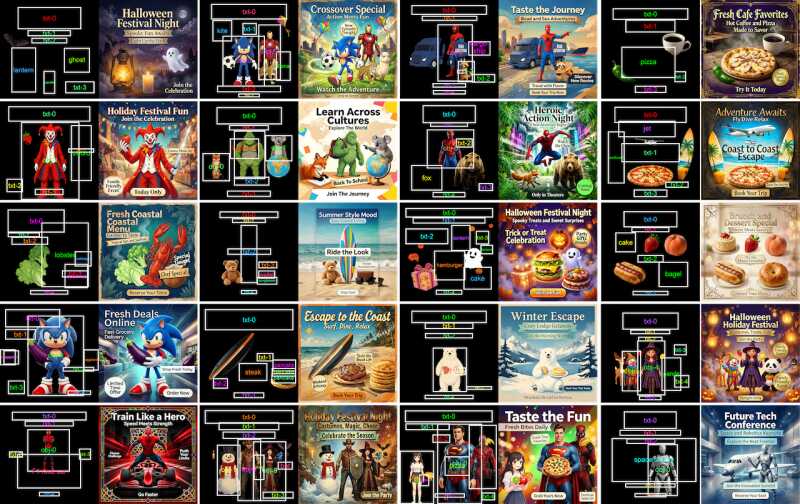
海報生成最難控制的往往不是主題,而是文字、人物和裝飾元素應該放在哪裏。Compo 屬於海報生成模型及介面項目,將 Spatial Canvas Interface 與 Text Specifications 結合,讓使用者直接在畫面中表達二維構圖意圖。

Spatial Canvas 支援四種綁定方式:Semantic Binding 指定文字概念及目標區域,Identity Binding 以參考圖保留視覺身份,Text Binding 同時交代準確字句與位置,Pixel Binding 則放入需要保留的像素內容。Bounding boxes、參考圖片和文字識別資料會一併渲染到畫布,形成模型接收的統一影像輸入。

  • 以畫布補足單靠文字提示難以交代的空間關係
  • Compo 由預訓練 image editing model 改編而成,毋須另建 task-specific architecture
  • 支援 direct inference,也支援 agentic mode 自動規劃畫布
  • 可用於海報、宣傳圖及需要精確排版的視覺內容

Compo 的模型改編重點,是令現有 image editing model 理解不同綁定方式及其組合,而不是從零訓練專用 poster generator。項目亦建立自動產生監督數據的流程,協助模型學習各類 Spatial Canvas 輸入;這比純文字提示更容易控制位置,但使用者仍要準備畫布內容,agentic mode 的自動規劃亦未必取代人工微調。

適合研究人員、設計工具開發者和需要批量製作宣傳海報的內容團隊作為試驗起點,而非直接視作成熟的製作平台。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, 視覺模型, 模型訓練, 微軟, Image, 影像處理, 香港, 工具, 中國, Dataset 數據集

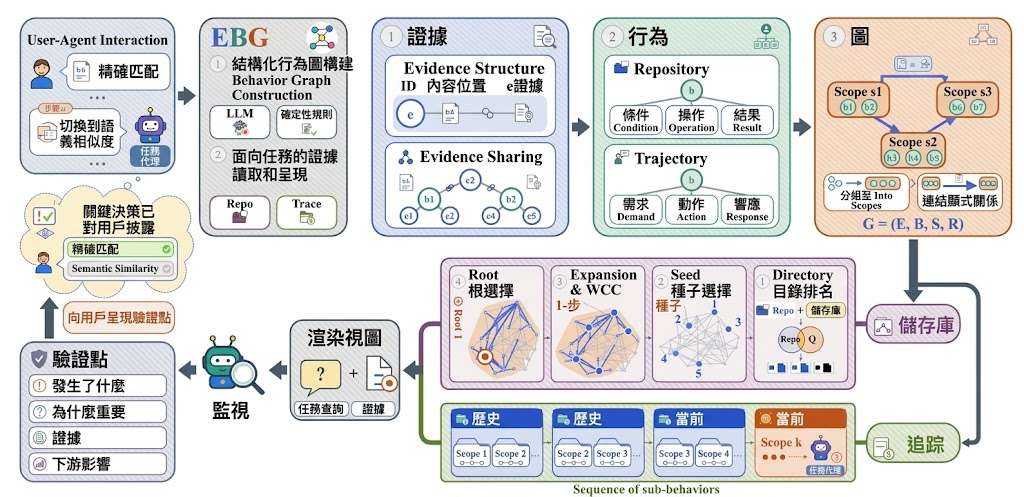
EBG 紀錄長流程 AI 代理的決策

代理做得越多,監察越難。EBG 將分散在訊息、程式及工具結果中的證據,整理成可核查的行為關係圖。

Overview of the EBG method

長流程 AI 代理執行軟件工程工作時,使用者往往難以判斷哪些決定會影響結果。Evidence-Grounded Behavior Graph(EBG)是一套 training-free 監察方法,將來源連結證據整理成行為、範圍與關係,協助監察者追查代理做過甚麼,以及相關證據藏在哪裏。

EBG 不只記錄操作次序,而是以 task-oriented views 把要求、觀察到的行為和可能後果連起來,讓人集中核實具影響力的決定。這比逐段翻查訊息、程式碼、工具輸出及中間產物更適合長流程工作,但它仍需要可靠的來源證據和監察模型作判斷,並不會自動保證結論正確。

項目同時提供 AgentMonBench,涵蓋 SpecGAP、SilentSwap 和 FeedbackTrace 三個子集,各有 100 個例子;主要實驗使用 FeedbackTrace Long 的 100 個樣本。基準從兩個方向測試代理監察能力:要求與行為是否一致,以及能否找出需要使用者核實的重大自主決定;網站亦展示八個模型的結果,但儲存庫沒有在摘要中列出完整分數。

  • Python 3.11 或以上可執行 EBG,FeedbackTrace 建構需要 Python 3.12,SilentSwap 另需 Docker。
  • scripts.demo 可離線建立合成圖,不需憑證或基準資料,測試結果會儲存至 outputs/demo/。
  • 公開資料包括完整評估輸入、Gold annotations 和樣本清單;預測及 judging 則需自行提供 endpoint、模型 ID 和憑證。

對研究AI 安全監察及軟件工程團隊來說,EBG 的把「代理做了甚麼」轉化成可追溯的證據結構。它目前仍是 under review at ICLR 2027 的研究項目,較適合作為可重現的研究基礎及監察流程原型,而非即插即用的生產系統。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, API, 軟件, 工具, Python, 庫, 安全, 中國, Dataset 數據集

Page 8 of 28
1 … 6 7 8 9 10 … 28