S2L-PO 用小模型帶動大模型推理訓練

清華與港校團隊提出 S2L-PO,改用小模型提供多樣推理路徑,補足 GRPO 易收斂過快的問題。

S2L-PO method overview

這個項目來自跨校團隊,作者包括 Yiming Ren、Yiran Xu、Zicheng Lin 等人,通訊作者是 Yu Qiao 與 Ruihang Chu;所屬機構包括清華大學、上海人工智慧實驗室、香港中文大學及香港城市大學。以研究背景看,團隊明顯集中在大型語言模型訓練、推理強化學習與數學評測。

這是一個針對 Group Relative Policy Optimization(GRPO)訓練流程的研究型框架,目的是提升大型語言模型在推理任務上的 rollout diversity。現有做法多數靠提高 temperature,從 token-level randomness 增加變化,但論文指出這種固定範式容易在長推理鏈累積噪音,令軌跡變得不連貫。

S2L-PO(Small-to-Large Policy Optimization)換了一個角度:不用同一個大模型不停抽樣,而是找同家族的較小模型做 explorer,先產生一部分 qualitatively different reasoning trajectories,再讓大模型用混合 rollout 依照標準 GRPO 訓練。之後再用 progressive annealing,逐步由 small-model exploration 過渡到 fully on-policy learning,避免中途被小模型能力上限拖慢。

論文提供的結果頗有說服力。以 Qwen3-8B learner 配 1.7B explorer 為例,AIME24 Pass@1 由 15.0 提升到 23.8,AIME25 Pass@1 由 12.1 提升到 22.5;Qwen3-14B learner 配 4B explorer 亦比基線 GRPO 高。作者同時聲稱 rollout compute 還可降低,這點對訓練成本敏感的團隊尤其有吸引力。

如果你想測試這個項目,較合理的方式不是當作即裝即用工具,而是把它視為一個訓練策略參考:先看論文與公開模型設定,再比較自己手上的 GRPO 流程是否同樣受 rollout 同質化影響。硬件門檻不算低,資料列出 8B 模型約需 20 GB GPU 記憶體、14B 模型約需 32 GB,較適合研究人員、模型訓練工程師,或正在做數學推理微調的團隊。

  • 核心判斷:這是模型訓練框架,不是一般聊天應用,重點在改善 GRPO 的探索品質
  • 方法差異:由 token-level randomness 轉向 policy-level diversity,減少長鏈推理失真
  • 主要創新:用較小同家族模型充當 natural explorers,再以 progressive annealing 收回大模型主導權
  • 已列相關模型:Qwen3-1.7B、Qwen3-4B、Qwen3-8B、Qwen3-14B
  • 適合場景:數學推理、可驗證獎勵訓練、想提升 RLVR 與 GRPO 收斂效率的項目
GitHub: https://github.com/qishisuren123/S2L-PO

Paper: https://arxiv.org/pdf/2605.30789

Categories: 開源, 香港中文大學, 香港城市大學, 清華大學, 上海人工智慧實驗室, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 香港, 工具, Python, 深度學習

MBench 專看長影片世界模型記憶力

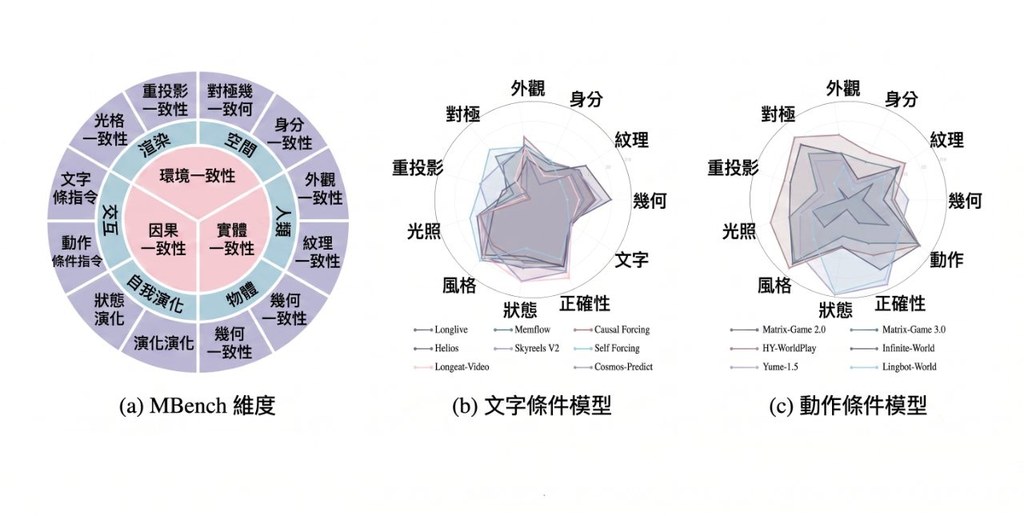
MBench不是看單幀靚唔靚,而是追問模型能否記住離鏡後再出現的人與場景。它把長影片記憶拆成三條能力軸,令評測更貼近生成連續影片的難題。

Teaser

現時不少長影片評測,仍偏向單幀畫質或短距離 prompt following;畫面一旦切走、角色離鏡,很多模型便容易在回到同一情境時「失憶」。MBench 這個benchmark正是針對這個盲點而設,聚焦 long-video world models 的 memory capability,檢查模型能否在時間拉長後維持一致的世界狀態。

作者把問題拆成三個互相獨立但又彼此關連的方向:Entity Consistency、Environment Consistency、Causal Consistency。這種設計比籠統地給一個總分更有分析價值,因為你能看清模型究竟是忘記角色外觀、搞亂場景空間,還是未能延續畫面外仍在發生的物理過程;同時它再分成 MBench-A 與 MBench-T,分別對應 action-conditioned world models 與 text-segment-conditioned 長影片續寫模型。

如果你本身有影片生成或世界模型項目,這個儲存庫的用途很明確:先準備模型輸出,再用 mbench 這套 contract-driven、plugin-based CLI 跑完整評測流程。儲存庫已提供 12 個官方 metric implementation,亦整合 VLM trigger judge,代表它不只是論文概念,而是一套可落地比較不同模型表現的評測工具鏈。

  • 項目類型:這是一個 benchmark/評測工具鏈,用來量度長影片世界模型是否具備穩定記憶與時序一致性。
  • 創新位置:不是只看畫面質素,而是把「長時間記住世界」正式定義成三條 capability axes。
  • 適合場景:長影片生成、world model 研究、模型比較、內部驗證新版本退步與否。
  • 可讀性高:MBench-A 與 MBench-T 將不同條件設定分開,較容易知道模型失分原因。

從評論角度看,MBench 的價值在於它批評了舊有固定範式:只獎勵 single-frame quality 或 short-horizon prompt following,卻未有檢驗跨鏡頭、跨時間的持續記憶。若你關心的模型包括各類 long-video world models、action-conditioned world models,以及 text continuation 類影片模型,這個項目很值得納入測試流程;不過目前提供的資料以 benchmark 與評測框架為主,是否能全面代表所有真實創作場景,仍要配合你自己的生成任務一併觀察。

GitHub: https://github.com/study-overflow/MBench

Paper: https://arxiv.org/pdf/2606.00793

Categories: 開源, 清華大學, 模型, 視頻模型, 世界模型, Video, 框架, 工具, , Win

OmniVideo-100K:增強影音推理訓練數據集

這是一個面向音訊與影片聯合理解的數據集項目,重點不在片段標註,而在較完整的跨模態推理。它更像是幫模型補課的訓練材料庫。

Framework Overview

現時不少影音問答資料建立流程,普遍沿用「video-caption-QA」範式:先把影片切成短片段,再分開寫視覺與音訊描述,最後生成 QA。論文作者認為這種做法容易出現 modality bias、temporal misalignment,同一角色在不同片段亦可能描述不一致,令問題多數只圍繞局部事件,難以考驗長時間跨度的 audio-visual reasoning。

OmniVideo-100K 是一個 Dataset 數據集,目標是為 Multimodal Large Language Models (MLLMs) 提供較完整的影音推理訓練材料。它提出兩個核心機制:Entity-Anchored Video Scripting 先把原始影片整理成結構化 script,包括摘要、主要實體清單,以及帶時間戳的分段音畫描述;Clue-Guided QA Generation 則先抽取跨片段、跨模態線索,再生成較複雜的問答。

這種設計的關鍵,不在於題目數量大,而在於先整理證據鏈再出題。對比舊方法把長文本理解和 QA 合併成一步,OmniVideo-100K 把線索挖掘獨立出來,較有機會產生涉及因果、未來預測與假設推理的題目,而不只是問畫面中「見到乜」。

如果你想測試這個項目,可以先留意 Hugging Face 上的 OmniVideo-100K 與人手驗證的 OmniVideo-Test,看看資料結構是否適合自己的訓練流程;做研究的人則可直接比較模型在外部 benchmark 的變化。論文提到,VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B 經此資料集微調後,在 OmniVideo-Test 最多提升 20.59%,在 Daily-Omni、JointAVBench 也有最多 12.64% 增幅,同時盡量保留在 Video-MME 這類一般影片 benchmark 的能力。

  • 針對舊式「video-caption-QA」流程的三個痛點:modality bias、temporal misalignment、敘事不連貫
  • 用 structured scripts 加 entity list,補回跨片段指代一致性與聲音來源對應
  • 任務覆蓋 10 類,包括 FGP、STD、CU、CP、SA、ESO、SM、CR、FP、HR
  • 適合做影音理解、跨模態推理、指令微調資料研究的人參考
  • 相關模型包括 VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B

整體來看,這個項目的價值在於它不只新增一批資料,而是重寫影音 QA 資料的組織方法。若你關心的不是單張畫面問答,而是影片內角色、聲音、事件先後與推論之間的連結,OmniVideo-100K 會比一般自動合成資料集更有研究參考價值。

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Qwen, Video, Audio, 工具, , 語音, Dataset 數據集

Video-Spec-Builder:將你的構想轉為影片腳本

這個項目像一位不停追問細節的導演助手,把含糊影片想法整理成可執行腳本。適合要做短片、產品片或公司介紹的人。

Spec Mono preview

video-spec-builder 不是剪片工具,也不是影像生成器,而是先幫你把想法講清楚的項目。你向 AI 說想做一條片,它會像導演開會一樣一路追問,將原本模糊的方向整理成逐鏡腳本,最後輸出 video-spec.md

這個項目處理的痛點很明確:很多人不是沒有概念,而是不知道怎樣把感覺變成畫面。像是「要高級感」、「要有衝擊力」這類抽象字眼,它不會照單全收,而是要求你交代鏡頭內容、動作、長度,以及前後段落怎樣接起來。

使用時可以分兩類情境。第一類是從零開始,讓它一步步問出影片目的、受眾、節奏與重點畫面;第二類是你已經有部分腳本或素材,它會協助重組順序,補回中段缺口,甚至提醒字幕、節奏點和音樂配合這些容易忽略的位置。

  • 能把含糊構想拆成具體鏡頭與秒數
  • 適合整理產品片、社交媒體短片、公司介紹片
  • 重點在追問與釐清,不是直接幫你生成成品
  • 可輸出 video-spec.md,方便後續交給 HyperFrames

這個項目的創新不在影像生成,而在「提問式規格整理」。它強迫使用者停止依賴空泛形容詞,改為描述真正會出現在畫面上的內容,對沒有製作經驗的人尤其有幫助。

要留意的是,它的能力邊界寫得很清楚:不能畫插畫、不能生成 live-action footage,也不能產生 photorealistic images。換句話說,這個項目更像前期策劃工具,適合內容團隊、營銷人員、創業者,或者任何手上已有想法和素材、但未整理成可拍腳本的人。

GitHub: https://github.com/feicaiclub/video-spec-builder

Categories: 開源, 框架, 工具

Knowledge Graph RAG 知識圖譜問答系統

Knowledge Graph RAG 是個現代、響應迅速,基於 Web 的知識圖譜 RAG 應用程序,可以回答有關您上傳的文檔的問題、可視化知識圖譜並管理專用的關鍵字。

Knowledge Graph RAG 是個現代、響應迅速,基於 Web 的知識圖譜 RAG 應用程序,可以回答有關您上傳的文檔的問題、可視化知識圖譜並管理專用的關鍵字。

Categories: 開源, 工具

Ollama-Web-UI-RAG 離線推理 AI Chatbot

Ollama-Web-UI-RAG 是一個功能豐富的現代化 Web 介面,用於與 Ollama 模型進行互動。這款企業級 Web UI 提供全面的聊天體驗,並具備先進的 RAG(檢索增強生成)功能、基於專案的向量資料庫儲存、強大的會話管理以及豐富的文件處理功能。

Ollama-Web-UI-RAG 是一個功能豐富的現代化 Web 介面,用於與 Ollama 模型進行互動。這款企業級 Web UI 提供全面的聊天體驗,並具備先進的 RAG(檢索增強生成)功能、基於專案的向量資料庫儲存、強大的會話管理以及豐富的文件處理功能。

Categories: 開源, 工具, Ollama

Kiro v0.1.0 – Vibe Coder

透過 Kiro,我們徹底革新了開發者與 AI 代理商的合作方式。我們率先推出了規範驅動開發 (spec-driven development),Kiro 將您的需求轉化為結構化的需求、設計和任務,然後由代理商執行。 Kiro 的代理鉤子 (agent hooks) 透過將任務委託給在背景執行的代理程式(例如更新文件、產生單元測試或最佳化程式碼以提高效能)來幫助您擴展工作。我們將 Kiro 視為真正的協作者,目標是讓 Kiro 幫助您交付強大的工程成果,同時助您成為更優秀的工程師。

透過 Kiro,我們徹底革新了開發者與 AI 代理商的合作方式。我們率先推出了規範驅動開發 (spec-driven development),Kiro 將您的需求轉化為結構化的需求、設計和任務,然後由代理商執行。 Kiro 的代理鉤子 (agent hooks) 透過將任務委託給在背景執行的代理程式(例如更新文件、產生單元測試或最佳化程式碼以提高效能)來幫助您擴展工作。我們將 Kiro 視為真正的協作者,目標是讓 Kiro 幫助您交付強大的工程成果,同時助您成為更優秀的工程師。

Categories: 工具, 編程

NVIDIA RTX AI 加速 FLUX.1 Kontext [dev]

NVIDIA 與 Black Forest Labs 合作,使用NVIDIA TensorRT軟體開發套件和量化技術針對NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],從而以更低的 VRAM 要求提供更快的推理速度。

NVIDIA 與 Black Forest Labs 合作,使用
NVIDIA TensorRT軟體開發套件和量化技術針對
NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],
從而以更低的 VRAM 要求提供更快的推理速度。

Categories: 開源, ComfyUI, 視頻模型, 影像模型, 工具, 推理引擎

Gemini CLI:您的開源 AI 代理

Google 推出了 Gemini CLI,一個免費的開源項目。它允許開發者透過自然語言指令在 Terminal 使用 Google 的 Gemini 2.5 Pro 模型。它可以編寫程式碼,亦能夠處理內容的生成、或者解決問題、甚至深入研究和任務管理等的多種任務。這個工具的設計目標是提升開發者在終端機中的工作效率,令 AI 成為日常工作流程的一部分。

Google 推出了 Gemini CLI,一個免費的開源項目。它允許開發者透過自然語言指令在 Terminal 使用 Google 的 Gemini 2.5 Pro 模型。它可以編寫程式碼,亦能夠處理內容的生成、或者解決問題、甚至深入研究和任務管理等的多種任務。這個工具的設計目標是提升開發者在終端機中的工作效率,令 AI 成為日常工作流程的一部分。

Categories: 開源, 工具, 編程

Python UV 取代 pip

Python UV 是一個以 Rust,編寫的高效能 Python 套件管理器和安裝程式。它能夠簡化 Python 的開發,同時負責管理標準函式庫(Standard Library),或者安裝虛擬環境等等。影片詳細講解了點樣利用 UV 進行完整的開發流程,並且強調 UV 在簡化和統一開發環境方面的優勢。

Python UV 是一個以 Rust,編寫的高效能 Python 套件管理器和安裝程式。它能夠簡化 Python 的開發,同時負責管理標準函式庫(Standard Library),或者安裝虛擬環境等等。影片詳細講解了點樣利用 UV 進行完整的開發流程,並且強調 UV 在簡化和統一開發環境方面的優勢。

用uv管理Python的一切!
Categories: 工具, Python

Page 9 of 16
1 7 8 9 10 11 16