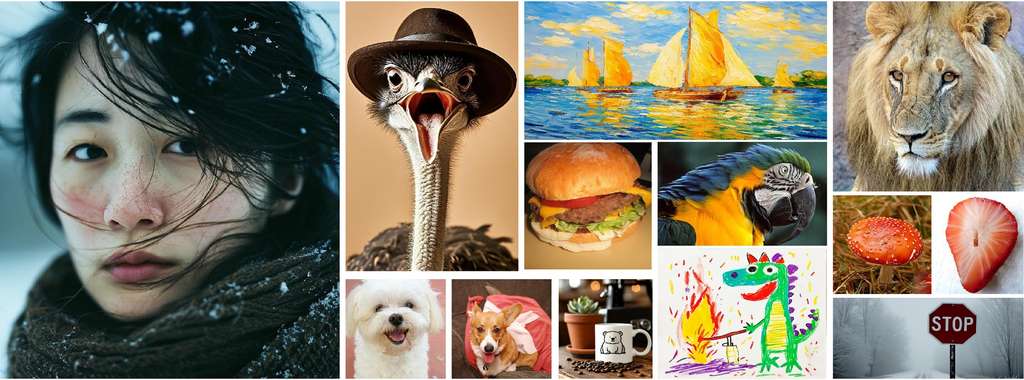
由像素直接生成高質素影像,往往要在語義理解、空間細節與模型計算量之間取捨。Representation Guidance (RG) 屬於影像生成模型方法,針對 pixel diffusion transformers 加入可被生成流程主動利用的內部表示,同時保留 plain Transformer 架構,處理表示學習與像素合成未能有效銜接的問題。
RG 先用 low-dimensional bottleneck 將與生成相關的資訊集中到緊湊表示,再按照該表示帶來的 prediction offset,修改 flow-matching target,直接引導 decoder 生成。它沒有依賴外部 autoencoder 預先建立 representation space,而是由 raw pixels 端到端學習;相較加入專用 pixel decoder 的架構,RG 嘗試避免只重新分配語義及空間建模工作,並以較簡單的 Transformer 結構擴展。
在 ImageNet 256×256 測試中,RG-L/16 使用 459M 參數,在 600 epochs 達到 1.79 FID;RG-XL/16 以 724.9M 參數取得 1.55 FID、293.8 IS。項目亦報告 512×512 的 1.74 FID,並延伸至 text-to-image,在 GenEval 取得 0.89、DPG-Bench 取得 87.1;這些結果顯示方法適合研究高解析度像素生成及文字生圖,但較大型模型仍需要相當計算資源。
你可從以下幾點理解它的實際價值:
– 低維 bottleneck 將生成相關資訊集中,減少表示與生成流程各自學習的落差。
– RG-L/16 以較少參數超越更大型的 pixel diffusion transformers。
– plain Transformer 方便研究內部表示如何形成及影響像素合成。
– 項目資料提供結果與模型規模,但未交代完整安裝、下載或推理流程,測試前仍需查看 Project Page 或後續程式碼。
較適合研究 pixel diffusion、生成式表示學習,以及希望比較 flow matching 架構的團隊。它的價值不在於提供即時可用的生圖工具,而在於把「學到表示」與「利用表示生成」放入同一個訓練機制;模型參數和 GFLOPs 仍然偏高,未必適合資源有限的個人電腦。