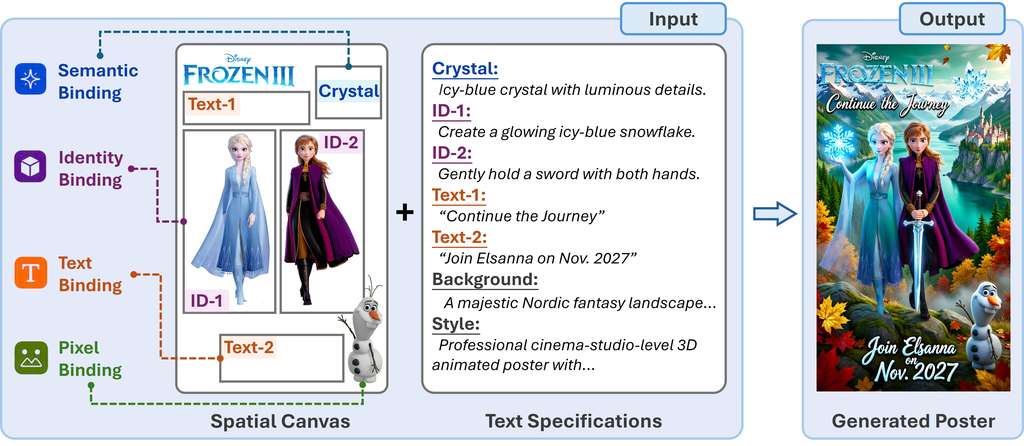
海報生成最難控制的往往不是主題,而是文字、人物和裝飾元素應該放在哪裏。Compo 屬於海報生成模型及介面項目,將 Spatial Canvas Interface 與 Text Specifications 結合,讓使用者直接在畫面中表達二維構圖意圖。
Spatial Canvas 支援四種綁定方式:Semantic Binding 指定文字概念及目標區域,Identity Binding 以參考圖保留視覺身份,Text Binding 同時交代準確字句與位置,Pixel Binding 則放入需要保留的像素內容。Bounding boxes、參考圖片和文字識別資料會一併渲染到畫布,形成模型接收的統一影像輸入。
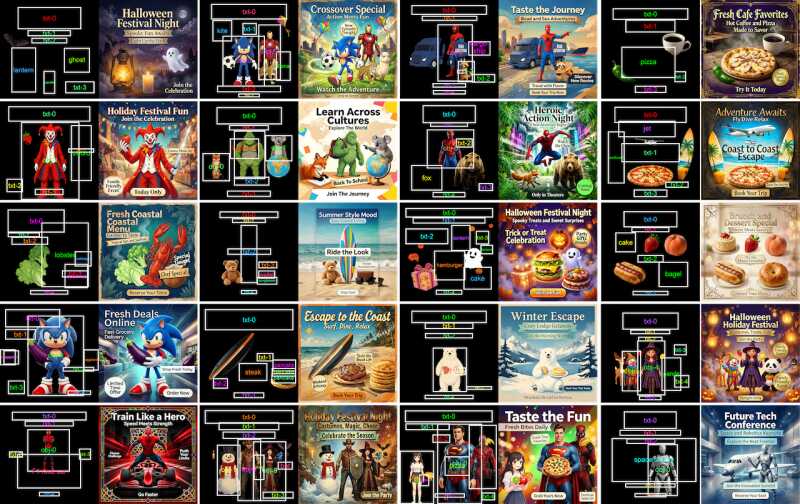
- 以畫布補足單靠文字提示難以交代的空間關係
- Compo 由預訓練 image editing model 改編而成,毋須另建 task-specific architecture
- 支援 direct inference,也支援 agentic mode 自動規劃畫布
- 可用於海報、宣傳圖及需要精確排版的視覺內容
Compo 的模型改編重點,是令現有 image editing model 理解不同綁定方式及其組合,而不是從零訓練專用 poster generator。項目亦建立自動產生監督數據的流程,協助模型學習各類 Spatial Canvas 輸入;這比純文字提示更容易控制位置,但使用者仍要準備畫布內容,agentic mode 的自動規劃亦未必取代人工微調。
適合研究人員、設計工具開發者和需要批量製作宣傳海報的內容團隊作為試驗起點,而非直接視作成熟的製作平台。