ATAS 以持續世界記憶改善長片生成一致性

ATAS 讓每個鏡頭共享可回訪的世界狀態,減少長片生成中人物、場景與事件難以保持連貫的問題。

ATAS: Any Time, Any Space

長片生成最難處理的不是單一鏡頭是否漂亮,而是角色重返同一地點、事件在不同時間再次出現時,畫面能否維持一致。ATAS(Any Time, Any Space)屬於 agentic video generation 框架,將劇本拆成包含場景、鏡頭、時間及事件的 shot request,再以持續更新的世界狀態支援後續生成。

ATAS 沒有只把上一個鏡頭或提示詞傳給下一次生成,而是分開保存兩類記憶:Scene Memory 記錄已註冊的靜態幾何,Event Memory 則按場景、事件和時間索引動態觀察。新片段生成後會被重建、註冊及檢查,只有通過審核和狀態驗證的內容才會更新記憶;影片交付則不受記憶是否接納影響,減少錯誤觀察污染後續鏡頭的風險。

• 將劇本編譯成具體的場景、相機和事件時間要求
• 支援從不同視角回訪同一場景
• 可重現較早時間點發生過的事件
• 生成後進行註冊、審核及世界狀態檢查

項目展示的差異,在於把跨鏡頭一致性視為世界狀態管理問題,而不是單純延長上下文或串接最近畫面。這會增加記憶建立、片段重建和驗證所需的計算與流程複雜度,但更適合長片、分段製作及需要角色與場景持續連貫的內容工作流。

研究結果涵蓋四個影片生成器;ATAS 在報告的跨鏡頭一致性指標均有改善,並在每個 backbone 取得最高綜合 benchmark 分數。它亦在目標影像空間回訪、三項事件重現指標及六項人工評分準則中領先比較的 agents 和 3D-guided methods。儲存庫目前主要提供研究程式碼、技術資料及示範,使用者需要按項目頁面的環境與模型依賴自行重現流程。
項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 視頻模型, Video, Image, World-Action Model, 提示詞, 框架, 3D, 庫, Dataset 數據集

DeepMind Sierra AI 原生即時語音

Google DeepMind 與 Sierra AI 討論原生音訊模型,聚焦即時語音互動的速度、自然度與工程限制。

Og image

語音助手要做到自然對話,關鍵不只是把文字轉成聲音,而是要在用戶說話期間理解內容、掌握語氣,並快速作出回應。Google DeepMind 的 Valeria Wu 與 Sierra AI 的 Soham Ray 透過對談,介紹原生音訊模型如何處理這類即時語音 AI 的核心問題。

討論內容集中於 native audio models,以及建立更流暢即時語音系統時遇到的挑戰。相較於把語音先轉成文字、再交由文字模型處理的流程,原生音訊模型直接處理音訊訊號,有機會保留更多語調、停頓和對話節奏;但系統仍要兼顧理解準確度、回應延遲和運算成本。

內容涵蓋的重點包括:
– 原生音訊模型如何支援更自然的語音互動
– 即時對話中延遲與回應流暢度的取捨
– 建立高質素 voice AI 所面對的工程挑戰
– Google DeepMind 與 Sierra AI 對下一代語音體驗的觀察

這段內容適合關注語音介面、客服自動化、AI agent 和多模態模型的讀者。影片沒有提供完整技術規格或獨立效能測試,因此較適合作為理解發展方向與產品設計難題的入門材料,而不是部署指南。

影片介紹

Categories: Agentic, AI productions, 模型, 多模態模型, Google, Gemini, Video, Audio, 語音, 安全

ManimGX 高速 3D 動畫渲染

面向 AI agents 的 Manim 相容動畫引擎,以 Rust 和 wgpu 大幅縮短 2D、3D 教學動畫的製作等待時間。

ManimGX

製作數學教學片時,渲染速度往往比寫動畫程式更容易拖慢流程。ManimGX 屬於開源 3D 動畫引擎,兼容 Manim CE API,讓 Python 使用者可用熟悉的文字、方程式、曲面和鏡頭,處理 2D 與 3D 動畫生成。

它以 Rust 和 wgpu 重寫渲染核心,並加入完整靜態類型、關鍵字參數及 .animate 鏈式寫法;LaTeX 或 Typst 不需另行安裝。項目亦支援瀏覽器執行,透過 Pyodide 讓示範、教學或 AI agents 生成的動畫毋須先配置完整本地環境。

• M4 Pro、1080p60、五個場景合計 36.2 秒影片,渲染需時 3.08 秒
• 同一測試中,比 Manim CE 快 90.6 倍、ManimGL 快 11.5 倍、Blender Workbench 快 18.7 倍
• manimgx inspect 可檢查 storyboard、2D 版面,以及指定時間或播放結束時的畫面
• 支援語音同步,方便按旁白內容安排動畫節奏

安裝可選 prompt、PyPI 或 npm,適合數學教育、技術內容製作,以及需要反覆生成和檢查畫面的 agent 工作流。速度數字來自 Apple M4 Pro 的固定場景測試,不能直接代表所有硬件、動畫複雜度或互動需求;對已深度依賴 Manim CE 生態的團隊,API 相容性可降低遷移成本,但仍應先驗證現有場景和第三方功能。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, 教學, 3D, Python, 語音, 動畫, 蘋果

VideoJev 加速影片理解,問答推理快逾百倍

VideoJev 把時間定位與選擇題影片問答放進同一個評分介面,減少生成式回答的延遲。

VideoJev

處理長片段、重複提問或需要找出事件時間的工作時,VideoJev 不必逐字生成答案,而是直接比較候選時間區間和答案選項。這個項目屬於影片理解模型,實際處理 temporal grounding 與 multiple-choice video QA,並將兩項任務放進同一個決策介面。

它以共享影片計算配合 Cached inference 和 Joint inference:前者保留已處理的視覺資訊,方便後續查詢;後者讓多條問題在一次 forward pass 中完成。相較依靠 autoregressive decoding 的 video multimodal large language models,直接候選評分較適合大量、結構清晰的判斷,但不負責自由生成長篇答案。

  • VideoJev-4B 建基於 Qwen3.5-4B,VideoJev-35B-A3B 建基於 Qwen3.6-35B-A3B
  • 兩個模型均提供 BF16、Safetensors 權重及 Hugging Face checkpoint
  • 三個 temporal grounding benchmark 的 mIoU,較各自 backbone 分別提升 6.7 和 10.8 分
  • 四個影片問答 benchmark 在 Thinking mode 維持相近表現,推理速度提升超過 100 倍

研究結果亦量得 temporal grounding 約 2.8 至 3.1 倍加速,顯示它較適合影片搜尋、內容索引、監控片段定位,以及需要連續提出多條問題的視覺代理工作流。試用可按儲存庫提供的環境設定,透過 Transformers 的 AutoModel、AutoProcessor 載入 Hugging Face 權重,再以示範影片測試;不過儲存庫資料未交代硬件門檻,BF16 模型的記憶體需求仍需按部署環境自行確認。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, AI productions, 模型, 多模態模型, Qwen, Video, 庫, Dataset 數據集

CineRecon 以 Blender 重建實景影片

CineRecon 將影片重建變成可檢驗的 Agent 任務,要求模型由參考影片建立可編輯、可動畫化的 Blender 場景。

CineRecon logo

由完整參考影片出發,Coding Agent 透過 Blender MCP 撰寫及修改 Python,反覆比對渲染畫面,再建立包含幾何、材質、角色動作與鏡頭動畫的可編輯場景。CineRecon 屬於影片重建 benchmark,處理的是模型能否將時間連續的影像內容還原成可修改的 3D 工作成果,而不只是產生相似畫面。

項目以三個重建層級拆開能力差異:Proxy 只要求位置、互動及鏡頭運動,Simplified 再保留可辨認形狀和主要外觀,Detailed 則加入特色形狀、材質和細節。三個層級都要求相同的主體動作、事件及攝影機行為,方便分辨模型是只掌握構圖,還是能重建完整視覺內容。

  • 50 段參考影片,切分成 360 個評估片段
  • 35,836 筆獨立 checklist 記錄,按層級擴展至 49,668 項檢查
  • 評估 Camera、Static、Dynamic 三類一致性
  • 支援畫面選取、時間戳對齊、並行評分、續跑及分數彙總

評分由獨立 VLM judge 對齊參考與渲染影片,按片段 checklist 檢查 11 個類別,並以 Camera、Static、Dynamic 三個同等權重維度計算結果。這比單一影像相似度更能揭示鏡頭是否跟足、物件是否保持穩定,以及動作和事件有沒有在正確時間發生。

測試需要 Python 3.10 或以上,支援 Linux 及 macOS;項目提供資料、提示詞、驗證工具和離線 smoke test,但不包含 Agent launchers。團隊可先用離線流程確認資料與評分管線,再接駁 Blender MCP 和隔離 worker 執行重建;研究模型能力時,CineRecon 的價值在於把「看似相似」拆成可追蹤的鏡頭、靜態內容和動態內容,而不是只比較最後一段影片。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, 模型, 視覺模型, Video, Image, 提示詞, Vibe Coding, 工具, Mac, 3D, Linux, Python, 編程, Anthropic, 動畫, Dataset 數據集

WOVEN:把視覺世界模型放入多模態 LLM 的新訓練範式

WOVEN 提出視覺轉換推理(visual transition reasoning)框架,用約 2,000 條受控樣本就能讓多模態 LLM 在 22 個外部基準上進步最多 27.3 個百分點。

WOVEN

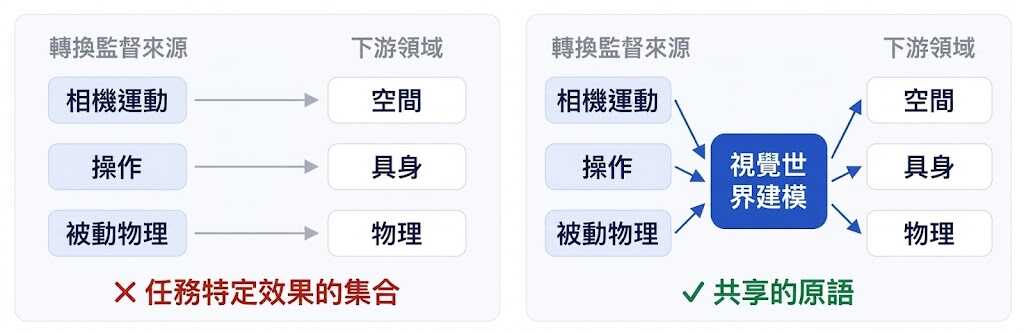
Multimodal LLMs 在空間推理、具身操作、物理常識、時間理解等多個範疇長期被當作獨立問題處理。WOVEN 把這些差距收斂到同一個原語:視覺轉換推理(visual transition reasoning),也就是在狀態—動作—新狀態 (s, a, s′) 中,根據已觀察部分推斷未觀察部分。這個框架既是訓練素材,也是一個評測基準。

WOVEN 內含 36,076 條四選題,覆蓋 20 種場景、5 種動作、8 種推理類型,並用影片生成模型嘅 rollout 構建。研究團隊在 Qwen2.5-VL-3B-Instruct 上以監督微調(SFT)加上 GRPO 訓練,11 個約 2,000 條嘅受控子集分別針對一類動作同推理家族,最終令 26 個外部基準中嘅 22 個出現提升,幅度最高達 27.3 個百分點,呢個幅度令人意外。

WOVEN 嘅分類包含前向動力學、逆向動力學、反事實移除、反事實替換、結果預測、線索預測、時間排序同時間相鄰性八種,並設計咗單因子受控變化、反事實 rollout、錯誤類型誘餌同三類測試集以排除偏差。研究者亦喺不同模型規模同模型家族上做咗複現。WOVEN 將視覺世界建模定義為可重用嘅原語,並非單一任務嘅效果集合。對做視覺推理、具身智能同多模態基準建設嘅團隊,呢套資料同訓練食譜提供咗一個統一切入點。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, 框架

VIS-Ground 讓互動影片真正記住前文與要求

觀眾暫停影片後提出要求,VIS-Ground 會把來源、已播內容與指令整理成可驗證的生成約束。

VIS-Ground teaser

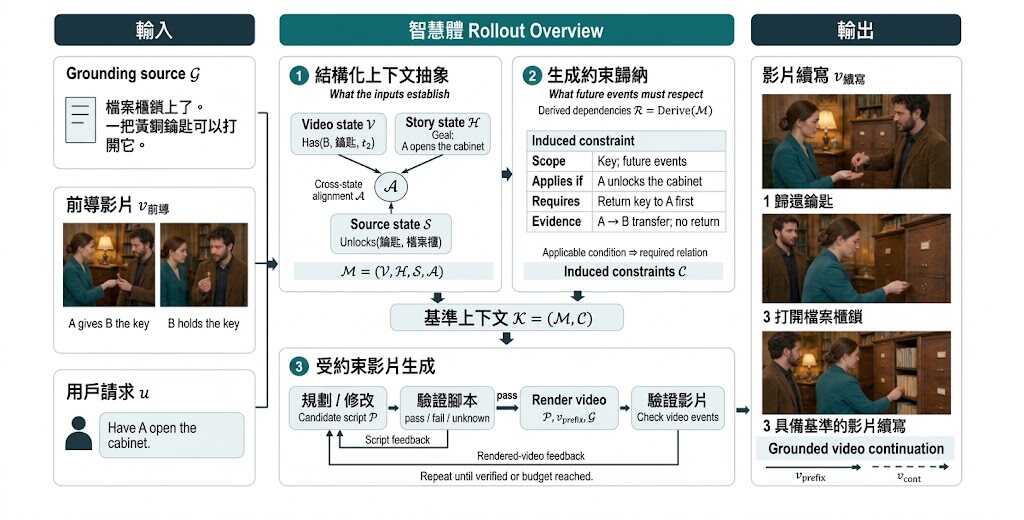
觀眾要求「用船運藥,而且不要弄濕」時,系統不能只理解一句新指令,還要記得橋已斷、目的地是祖母家,以及故事原本交代的背景。VIS-Ground 屬於互動影片生成研究框架,處理的正是來源資料、影片前段與觀眾介入之間容易互相牴觸的依賴關係。

它先以 Structured Context Abstraction 對齊 grounding source、已渲染的 video prefix 和 viewer request,再以 Generation Constraints Induction 抽取對下一段影片真正有關的條件,最後經過 plan、verify、revise、render 循環,檢查成片是否同時符合劇情連貫、知識來源和觀眾要求。這比單純把新提示詞交給影片生成器更重視前文約束,但代價是流程更複雜,也需要額外驗證。

  • 以可執行 constraint model 連接文字來源、影片內容與互動指令
  • VIS-Bench 包含 250 個 sources、1,004 個 viewer interventions 和 2,008 個 instances
  • 評估涵蓋 source faithfulness、story continuity、interaction fulfillment 及 joint score
  • 在 Omni-1.1-Flash、Veo 3.1 和 MiniMax-H3 三個 video backbones 均取得最高 composite score

Composite score 為 Omni-1.1-Flash 84.2、Veo 3.1 84.6、MiniMax-H3 78.8,較各自最強 baseline 高 12.3、15.3 和 3.4 分;提升主要集中在 story continuity。這些結果反映方法能跨越不同影片生成 backbone 工作,但資料只涵蓋 1,004 個互動介入,未足以代表所有敘事類型。

適合研究互動敘事、可控影片生成和多模態代理的團隊,用來測試「觀眾改變故事後,生成結果能否守住既有事實與新限制」。GitHub 目前只列出代碼、VIS-Bench 資料和評估腳本預告在 2026 年 12 月 15 日前釋出,因此暫時缺乏可按步驟安裝及本地測試的完整資訊。

項目主頁 · GitHub

Categories: 開源, AI productions, 多模態模型, Video, 提示詞, 框架, Dataset 數據集, MiniMax

T3lescope 把多視角影像變成高質 3D 場景

由單一物件到城市級戶外場景,T3lescope 嘗試以生成模型兼顧整體幾何、細節,以及玻璃和鏡面表面重建。

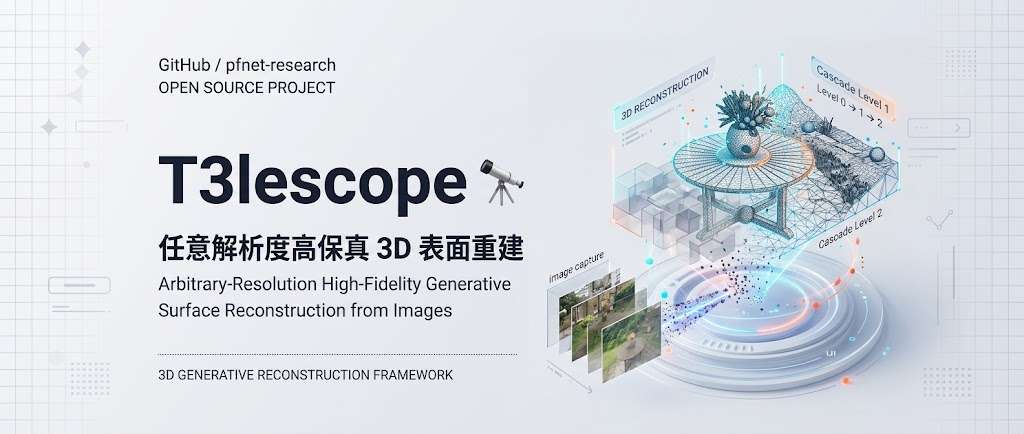
T3lescope teaser

面對影像稀疏、表面反光或透明等情況,T3lescope 仍嘗試由已標定相機姿態的多視角影像重建高保真 3D scene mesh。它屬於生成式 3D 重建模型,處理的是大型場景難以同時維持覆蓋範圍與局部細節的問題。

模型以 mesh flow models 直接生成高解析度網格,並在推理階段採用 coarse-to-fine cascade:先用較粗層級建立全局布局,再於更細的 spatial cells 內擾動、去噪和補回幾何細節。各層共用同一個 fixed-resolution generator,訓練時以不同尺度的 cells 學習,因此層級數量、cell 尺度和位置都可於推理時調整。

這做法減少把大型場景切成多個獨立重建區域後出現的接縫和全局不一致風險,也不需要逐個場景進行 per-scene optimization。代價是重建品質仍取決於輸入影像數量、視角覆蓋和模型推理配置,而 README 未提供硬件要求、速度或完整操作流程。

T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
  • 支援由單一物件、室內環境延伸至戶外和城市級場景
  • 可在推理階段選擇 cascade 層級與網格細緻程度
  • 針對稀疏觀測、細小結構、glossy 及 transparent surfaces 提供生成式補全
  • 在室內、戶外及城市場景測試中勝過 feed-forward 和生成式基線,並達到或超越部分 per-scene optimization 方法

適合需要多視角影像轉 3D 資產的視覺研究、數碼孖生、機械人感知和場景製作團隊,較容易受惠於這種跨尺度重建能力。不過 GitHub 項目目前只標示 Code is coming soon,尚未提供可安裝程式碼;現階段可參考 arXiv、項目網站和示範影片理解結果,未能按儲存庫直接測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 3D, 庫

Motion2MixamoRig:把真人動作搬入 Mixamo 角色的開源工具

Motion2MixamoRig 將單人影片或照片姿勢轉成 Mixamo 角色動作,直接輸出可供 Blender、Unity 使用的 3D 檔案。

Motion2MixamoRig

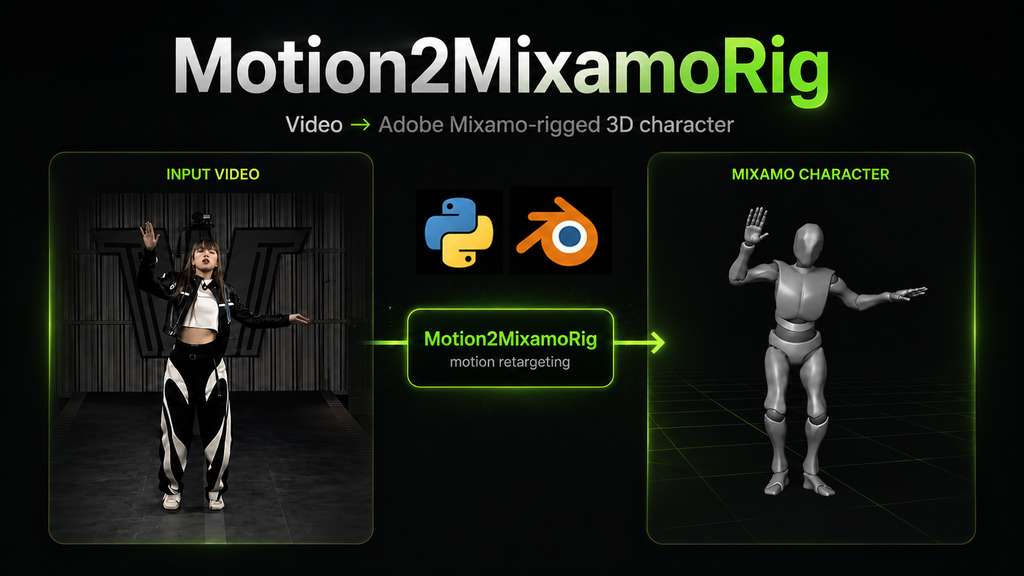
把單人動作影片或一張姿勢照片套到 Mixamo 角色上,Motion2MixamoRig 便可輸出預覽影片及帶蒙皮的 .glb 角色檔,減少遊戲開發者重新製作基礎動作的工序。它屬於 3D 動作轉移工具,處理的是真人影像與已綁定骨架角色之間的動作銜接問題。

流程以 SMPL-X、GVHMR 等模型先從影像估計人體動作,再將結果映射到 Adobe Mixamo rig;模型不負責生成全新動作,而是把影片或照片中的姿勢重建後套用到指定角色。輸出可放入 Blender 或 Unity,仍要留意單人畫面、遮擋、鏡頭角度及原角色骨架會影響結果。

模型權重首次執行時約需下載 5 GB;原始資料沒有提供正式性能基準或準確率數字。項目目前仍屬 experimental,0.1.0 提供 command-line pipeline,亦附有 Blender 4.2+ Extension,並在外部 Python 環境執行同一套流程。

  • 支援影片動作及單張照片姿勢
  • 輸出預覽影片與 .glb 檔案
  • 兼容 Blender、Unity 工作流程
  • 需要單人素材及外部模型權重

遊戲原型、角色動畫測試及需要快速重用真人動作的團隊較適合採用。ffmpeg 並非流程必需,但缺少它會令輸出影片沒有聲音,並可能無法在瀏覽器播放;對需要穩定製作級動畫的人員而言,仍要自行檢查骨架映射、腳部滑動和遮擋造成的誤差。

GitHub

Categories: 開源, AI productions, 數字人, 模型, Video, Image, Audio, 工具, 3D, Python, 庫, 動畫

Work2Skill 把人手 GUI 操作變成可重用 Agent 技能

Work2Skill 將人手操作錄成多模態證據,再整理成 Computer-use agents 可重用的工作技能。

Work2Skill overview: human GUI demonstrations, multimodal recording, action-linked evidence, agentic skill induction, an

面對陌生桌面軟件,單靠任務描述往往不足以交代按鈕位置、操作次序及完成後應有的狀態。Work2Skill 屬於 GUI 操作記錄、數據集與 Agentic skill induction 項目,處理的是如何把人手示範轉成可供 Computer-use agents 重用的程序指引,而不是另一個獨立基礎模型。

WorkRecorder 將螢幕影片、關鍵影格、滑鼠鍵盤事件及可用的無障礙資訊放在同一條時間線,讓每個動作同時保留畫面背景和介面狀態。WorkDemo-350 收錄 350 個桌面示範、約 8.48 小時錄製內容,包括 64 個 MyPCBench 任務及選出的 286 個 OSWorld 任務;AgenticSkillInduction 則提供基於 NexAU 的技能歸納範例,將流程整理成可執行時參考的技能。

它和只保存點擊座標或純文字步驟的做法不同,保留了操作前後的多模態證據,較適合處理介面改變、控制項含義不明或需要驗證結果的工作。不過,項目目前仍有清晰限制:macOS 錄製器及 Linux X11 AT-SPI 服務已提供,跨平台現場驗收仍待完成;下游評估整合亦尚未完成。

網站列出的結果以 0 至 100 分的 MyPCBench 平均分計算,四個執行模型在加入技能後最高提升 10.54 分。對需要累積桌面工作流程、研究 Computer-use agents,或希望以共同示範數據比較技能歸納方法的團隊,這套資源較有參考價值;資料集與錄製資料放在 Hugging Face,完整錄製及技能流程則要按各子目錄指南處理,原始資料未提供單一即用安裝流程。

  • 核心價值: 把人手 GUI 經驗連同畫面、輸入及介面證據保存。
  • 資料規模: 350 個示範,涵蓋 MyPCBench 與 OSWorld 任務。
  • 技術組成: WorkRecorder、WorkDemo-350 及 NexAU 技能歸納範例。
  • 主要取捨: 證據更完整,但跨平台驗收和評估整合仍未完成。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, Video, 軟件, Mac, Linux, 中國, Dataset 數據集, Skill 技能

Page 7 of 22
1 … 5 6 7 8 9 … 22