Comfy-mcp:讓 AI 直接操控本地工作流

Comfy MCP 把本地 GPU、模型與自訂節點交給 AI 管理,令 ComfyUI 工作流可以用自然語言建立、執行及修改。

Comfy

由 MiniMac Code、Claude、Cursor、Codex 等 AI agent 用自然語言建立並執行本地 ComfyUI 工作流,正是 Comfy MCP 提供的核心能力。它屬於 Model Context Protocol(MCP)伺服器,透過 comfy-cli 連接使用者自己的 ComfyUI,處理模型、節點、工作流與輸出圖片之間原本較繁複的操作。

使用者需要先有本地 ComfyUI 及 Python ≥3.10,再把 Comfy MCP 設定到支援 MCP 的客戶端。連接後,AI 可以讀取目前安裝的節點、自訂節點、模型及 GPU,搜尋可用模板,驗證工作流圖表,修改模板欄位,提交非同步工作,監察、取消工作,以及收集輸出的 PNG 檔案。

它和只依賴固定模型目錄或靜態工作流範例的做法不同,會按本機真正載入的內容作判斷,亦能在下載模型前檢查硬件是否有足夠能力。這減少了模型版本、節點依賴和顯存不相容帶來的失敗,但生成速度、可用模型和成功率仍然取決於 GPU、ComfyUI 安裝狀態、自訂節點及工作流本身;項目資料未提供統一基準測試數據。

較適合經常製作影像或影片工作流、需要反覆試驗模型的創作者,以及想把本地 GPU 納入 AI agent 流程的開發團隊。Comfy Cloud 與本地連線可以同時使用,代理可按硬件和任務需要選擇位置,形成雲端彈性與本地模型控制之間的折衷。

  • 自然語言操作:建立、編輯、驗證及執行 ComfyUI 工作流。
  • 讀取本機環境:辨識 GPU、模型、模板及包括自訂節點在內的已載入節點。
  • 完整工作管理:支援提交、等待、監察、取消及讀取失敗結果。
  • 本地與雲端並用:同一個 MCP 連線可按任務需要配合兩種環境。

項目主頁 · GitHub · Skills

Categories: 開源, ComfyUI, Agentic, AI productions, MCP, IDE, Python, Skill 技能

video-shotcraft:電影感產品影片工作室

video-shotcraft 把產品頁面、動態分鏡和聲效製作串成一條工作流,協助 Claude Code 或 Codex 產出更完整的宣傳影片。

video-shotcraft logo

由產品頁面出發,video-shotcraft 會交由 Claude Code 或 Codex 組織分鏡、動畫及聲音設計,再以 Remotion 製作宣傳、發布或示範影片。這個項目屬於 AI agent skill,實際處理的是產品影片製作中截取畫面、安排鏡頭、配合節奏剪接和加入聲效等繁複工序。

畫面不只依賴抽象動畫,工作流包括真實頁面擷取、2.5D camera moves、beat-synced cuts,以及電影感 SFX。152 張 shot recipe cards、209 種 style 和 209 個 motion previews,讓創作者可按產品內容挑選鏡頭語法,再由 native Remotion components 組合成片;元件以 normalized progress t 驅動,並可替換 ACCENT 顏色。

適合需要頻繁製作產品發佈片、marketing video 或 demo video 的設計師、創業團隊及內容製作人。它把分鏡規劃和前端式動態設計交給代理處理,換來較完整的自動化流程,但影片質感仍取決於產品頁面素材、提示內容及人工修訂;提供的資料亦未交代具體安裝步驟、所需帳戶或完整輸出流程。

品質控制來自對候選動作進行八輪逐幀檢視,並與參考片段比較後整理成 recipe cards。README 亦列出完成交付後可輸出可編輯的 JianYing(CapCut CN)草稿,方便按 shot 重新剪接、調速、排序、調色及重建字幕軌道,但相關功能的可用條件仍需以項目最新文件為準。

  • 素材處理:支援真實產品頁面擷取,而非只靠預設圖形。
  • 動態語法:涵蓋 2.5D 鏡頭、節拍剪接和 SFX 配搭。
  • 內容庫:提供 152 張 shot recipe cards、209 種 style 及 209 個預覽。
  • 輸出彈性:以 Remotion 元件組成影片,並列出 JianYing 可編輯草稿匯出能力。
  • 使用限制:目前資料不足以確認安裝、模型依賴和完整執行要求。

GitHub

Categories: 開源, Agentic, AI productions, OpenAI, Video, Anthropic, Dataset 數據集, Skill 技能

4DAnyone 把單鏡頭影片重建 4D 多視角

由一段普通單鏡頭人物影片開始,4DAnyone 生成具一致性的多視角影片,再交由 4DGS 重建可動人物。

4DAnyone

由未校準的 monocular video 出發,4DAnyone 可以為同一個人物生成多個目標視角,接着交給 4D Gaussian Splatting(4DGS)建立可渲染的 4D 人物。這個 GitHub 項目屬於 4D 人物重建工具,處理的是拍攝時沒有多部相機、相機內參或姿態資料,卻想取得多視角動態素材的問題。

它不只把畫面轉成另一個角度,而是嘗試維持不同視角之間的時間和外觀一致性,讓後續 4DGS 重建不必直接面對單鏡頭資料的視角缺口。相較於需要 rig、校準相機或固定三腳架的流程,這個方法換來的是對輸入影片質素和人物動作的依賴。

使用 inference.py 讀取影片,再以 views_per_layerlayer_pitchesstart_yawyaw_span 控制相機層數、上下角度及水平覆蓋範圍。儲存庫提供 Python 3.11、requirements 和第三方 GVHMR 元件的安裝安排,缺少的模型及例子會在首次使用時自動取得;原始資料沒有交代硬件需求、推理時間或量化性能,因此不能把速度表現視為已被驗證。

  • 支援全身或上半身、畫面只包含一人的影片
  • 可生成 6、24、48 個或自訂數量的目標視角
  • 兼容輕微鏡頭移動,以及未知相機內參和姿態的素材
  • 可選 FlashAttention-3 或 SageAttention 加快推理

研究展示內容集中於不同人物影片、動作和場景的泛化能力。需要製作 4D 人物、研究自由視角影片,或建立動態人像資料的團隊;只想快速套用濾鏡或要求即時輸出的使用者,仍要先確認硬件、模型取得方式和影片條件是否符合要求。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 數字人, 視頻模型, Video, Python, 語音

Evoke 把世界模型推向可互動長片段

Evoke 讓生成世界記住鏡頭走過的地方,並可在畫面持續生成時改變指令,突破短片段與固定提示詞的限制。

logo light

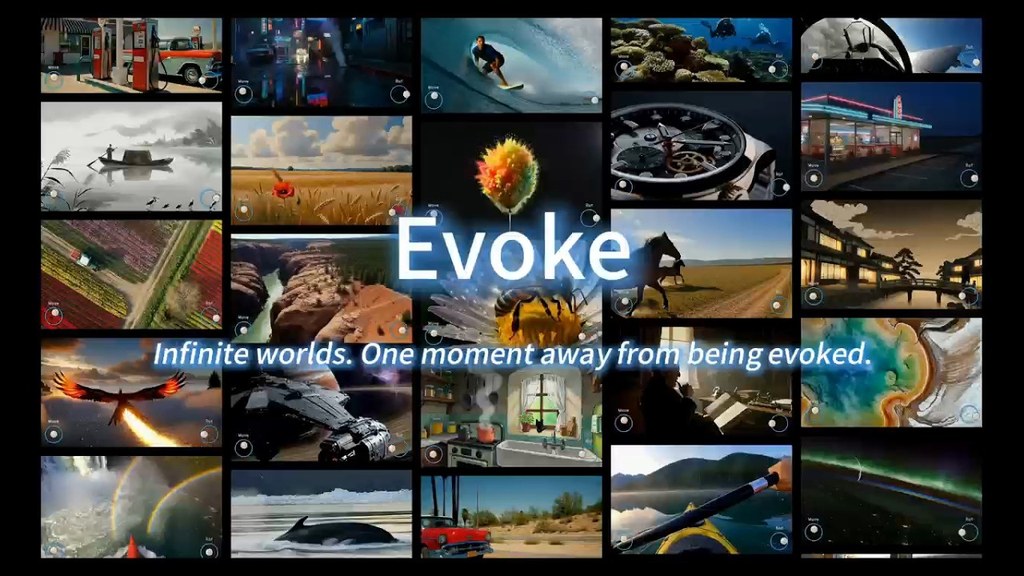
鏡頭由使用者操控時,畫面不必每隔幾秒重新開始;Evoke 會保留場景幾何,按鏡頭位置取回需要的資訊,讓探索可以延續更長時間。它屬於開源的自回歸世界模型,實際處理的是互動影片生成中的空間記憶、持續生成與中途改變指令三個問題。

模型採用 14B 參數、三步採樣及 classifier-free guidance(CFG)免費的生成流程,在單張 H200 上以 2.11 秒生成 1.5 秒、384×640 影片。外部 camera-indexed world state bank 將世界狀態與 denoiser 分開保存,配合按需檢索令每一步的上下文維持有界;代價是推理需要依賴鏡頭姿態與狀態管理,並非單純輸入文字便可獨立生成長片。

Evoke 以 per-chunk conditioning 支援生成途中重新提示,例如在原有場景加入風暴、物件或事件,而不需要剪接或重啟。訓練端亦為長時段 self-forced supervision 重建 teacher,加入 chunk-wise grouping、distant-frame retrieval 和 linear-attention global state,讓記憶及計算量按長度線性增加;README 同時提醒,訓練與推理必須使用一致的 warp / attention 配方,否則可能出現不易察覺的失配。

WBench 上,Evoke 以三步世界模型取得目前最佳成績,並在 VBench-Long 及 VBench-2.0 維持競爭力,但項目資料未提供完整硬件需求、互動控制介面或不同 GPU 的速度比較。研究團隊、遊戲原型製作者及需要長時間可操控影片的開發者,可從 Hugging Face 權重、GitHub launcher 和 examples 開始測試;使用前應先確認 H200 級硬件、模型下載容量,以及本地環境是否符合程式依賴。

• 三步、CFG-free,單張 H200 每 2.11 秒生成 1.5 秒影片
• 以 camera-indexed world state bank 保存跨片段場景記憶
• 生成途中可重新提示,改變接下來的事件或環境
• WBench 領先,VBench-Long 與 VBench-2.0 保持競爭力
• 開源權重與程式可供研究及互動影片原型測試

項目主頁 · GitHub

Categories: 開源, AI productions, 視頻模型, 世界模型, Video

TRACE-Bench 拆解多參考生圖失誤來源

多張參考圖生成得似,未必代表每個要求都做對。TRACE-Bench把失誤拆成可追蹤能力,方便看清模型真正卡在哪裏。

Og image

生成圖片時同時引用多張參考圖,最難的地方往往唔係畫面夠唔夠完整,而係模型有冇準確保留指定主體、抽出正確屬性,再綁到啱嘅目標上。TRACE-Bench屬於 Multi-Reference Image Generation Benchmark,處理的正是這類「成品看似合理,但細節要求逐項出錯」的評估問題。它不再只用一個總分判斷好壞,而是把每條提示拆成可追蹤的能力步驟,讓研究者知道錯誤發生在身份保留、屬性抽離、屬性綁定,還是多元素構圖。

這個基準最核心的做法,是用四個原子操作統一資料建構、評分與診斷流程:Anchor負責鎖定並保留參考主體的身份特徵,Disentangle負責把某個屬性從原本載體抽離,Apply負責把抽出的屬性自然地套到指定目標,Compose則負責在空間、關係或整體場景限制下安排多個內容。TRACE-Bench把每個 prompt 表達成 compositional formula,令多參考生成不再只按「風格轉移」或「主體組合」這類粗分類來看,而是按能力需求逐層拆解。

它和常見 benchmark 的差異,在於評估單位由任務類型改成能力組合。原有做法容易出現覆蓋不足、案例難度難比較、失敗原因不透明等問題;TRACE-Bench則把同一套公式結構用於案例生成與對齊評分,並要求參考資訊有精準 grounding。資料規模方面,這個 benchmark 約有1,600個 evaluation cases、631個公式模板、約4,000張 reference images,覆蓋1至8個 operator slots,並評估了9個領先模型。現有結果顯示,真正的瓶頸主要落在 attribute disentanglement 同 binding,不是單純的場景級 composition。

對模型研究、影像生成工作流設計,甚至要挑選評測方法的團隊來說,TRACE-Bench的價值在於它能把「生成得唔錯」這種籠統印象拆成具體能力地圖。當案例失敗時,它還會用遞迴簡化方式做 diagnosis,逐步定位干擾來自哪一個參考需求。對於想改進多圖條件生成、測試 reference-following 能力,或者分析模型為何經常把屬性套錯對象的人,這種可追溯結構比單一總分更有用。

  • 用四個操作符描述多參考生成:Anchor、Disentangle、Apply、Compose。
  • 每個 prompt 都可寫成 compositional formula,方便控制複雜度與對齊評分。
  • 約1,600個案例涵蓋1至8個 operator slots,資料來自約4,000張參考圖。
  • 九個模型的評估結果指出,屬性抽離與屬性綁定比場景構圖更常成為瓶頸。
  • 原始資料聚焦 benchmark 設計與診斷方法,未提供一般讀者可直接下載或部署的完整使用流程。

整體來看,TRACE-Bench不是再增加一批「看圖感覺差不多」的測試題,而是把多參考生圖最難處理的依賴關係寫成可分析、可比較、可回溯的結構。當模型要同時記住誰是誰、哪個屬性要抽出、又要套到哪個實體上時,這套方法更能反映能力上限與失誤模式,也讓後續改進有更清晰的落點。

項目主頁

Categories: AI productions, Image, 框架, Dataset 數據集

VoxWeave:Windows 本機 RVC 變聲工作站

把音頻、影片、麥克風同批次任務收在同一個桌面工作站,VoxWeave 走的是本機離線處理路線。它重點解決變聲流程分散、結果難追蹤,同時保留即時變聲與批量轉換。

VoxWeave

VoxWeave 是一套面向 Windows 的 RVC(Retrieval-based Voice Conversion)變聲工作站,定位很清楚:把離線轉換、即時麥克風變聲、批量處理和結果追蹤放進同一個桌面流程。它適合要穩定處理音頻、歌曲或影片音軌的人,也適合需要交付產物、查看失敗原因和保存位置的工作場景。

使用方式偏向本機部署而不是雲端服務。EXE 不內置大體積環境或模型,首次使用可在介面內按需下載經哈希校驗的運行組件與推薦模型;來源倉庫也保留 Linux 和 macOS 的邊界,但目前真機驗收集中在 Windows 11 與 NVIDIA CUDA。

它和常見變聲工具最大的分別,在於把狀態、任務、批量規則、即時會話、產物與歸檔都收進 SQLite 作為單一真源,連診斷匯出都會帶上運行時、模型和日誌清單。這種做法讓問題排查和重試更直接,但代價是它明確不提供虛擬聲卡、模型訓練或 GPT-SoVITS,定位比完整聲音工坊收得更窄。

  • 支援音頻、影片、資料夾和麥克風輸入,流程集中。
  • 可做離線轉換、即時變聲與批量處理,結果可追蹤。
  • 模型按原路徑登記,會計算權重和索引的 SHA-256,不會複製或改名。
  • URL 模型需要提供來源、最終大小和 SHA-256,授權不明時會明確標示。
  • 目標較適合 Windows 本機使用者、內容製作流程,和需要留存產物與錯誤記錄的團隊。

GitHub

Categories: 開源, AI productions, NVIDIA, Mac, Linux, 語音, Win

Ex-Omni-2D 直接對話生成同步發聲與表情的數字人影片

Ex-Omni-2D 讓對話模型同時輸出文字、個人化語音與表情同步的頭像影片,以多碼本語音單元串接語音與畫面,並提供 Teacher 與 Prefix-Streaming Student 兩種部署模式。

Ex-Omni-2D framework

想讓 AI 數字人不只是「會打字」,而是真的「邊說邊演」?香港中文大學(深圳)與 LIGHTSPEED 合作開源的 Ex-Omni-2D,正是針對這個目標設計。它是一個開源對話框架,接受多模態查詢、參考圖像與參考音訊後,先由語言模型輸出一份結構化的 Visual Thought Plan(VTP),再依此生成文字回應、個人化語音,並產出嘴形與動作同步的頭像影片。

傳統做法通常把語音合成與人物影片視為兩條獨立管線,需要額外對齊文字、聲音與嘴形,容易出現時間錯位。Ex-Omni-2D 的差異在於採用 16 個 codebook 構成的原生多碼本語音單元,作為語音與影片共享的聲學與時序介面:同一組語音單元既驅動 TTS,也作為影片生成器的緊緻條件,從而降低跨模態錯位的風險。

影片生成路徑提供兩種互補模式:Full-sequence Teacher 採雙向注意力,追求最高畫質;Prefix-Streaming Student 則是蒸餾而來的少步數 block-causal 版本,支援 2、4、8 步串流推論,方便在工作站、GPU 伺服器甚至 Hugging Face Spaces 上做漸進式部署。

這個項目的重點:

  • 對話原生影片:視覺行為直接從多模態對話上下文規劃,不必再手動撰寫影片提示詞。
  • 結構化 VTP:明確定義首幀、場景、情緒、動作風格與動作細節,方便後續控制與除錯。
  • 共享語音介面:16 個 codebook 同步驅動語音合成與人物動作。
  • 品質與效率取捨:Teacher 負責最高畫質,Student 支援 2/4/8 步串流。
  • 彈性部署:同一套代碼可在個人工作站、GPU 伺服器或 HF Spaces 執行,並提供線上 Demo 試玩。

在串流場景中,作者指出 Prefix Streaming 從第 9 至 16 chunk 的一致性明顯較強,將 last-to-first consistency error 降低 21.4%,這對需要長時間維持角色身份一致的應用相當關鍵。論文亦提到 Prefix Streaming 能減少長序列累積形變,同時保留參考圖像的人物外觀。

較適合的對象包括需要快速打造可對話 AI 助手、虛擬主播、客服分身或教學數字人的團隊;對研究多模態對話、語音驅動動畫的人來說,這份開源代碼、模型權重與 arXiv 論文也是一個方便的起點。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 騰訊, 文字轉語音, AI productions, 數字人, 多模態模型, 視頻模型, Qwen, 香港, 語音

LTX-2.5 原生多鏡頭、4K HDR,一次看懂升級重點

LTX 最新開源基礎模型 LTX-2.5,主打原生多鏡頭銜接、4K HDR,並降低重試與算力成本,繼續走開放權重路線。

LTX-2.3 Examples Video

如果你是用開源模型做影片生成的開發者,LTX-2.5 這次更新解決的卡位頗明確:人物、環境、光線與聲音在多鏡頭之間斷裂的問題。它把多鏡頭生成變成原生能力,並加入自動時長預測,模型會按指令動作自行決定片段長度,省下人手剪接的麻煩。

對比起多數只能透過後製拼接的同類方案,LTX-2.5 在 prompt 跟隨度上也有明顯進步,能夠處理更複雜的創作指示,而且只需要更短的提示詞就能產生穩定結果。配合新的擴散影片解碼器,動態假影更少,畫面在高解析度與 HDR 下仍能逐格保持質感。

本地部署與微調是這次版本延續的核心承諾:開源權重可直接下載,預訓練基礎模型可在自家做 LoRA 微調,產出與後製則支援原生 RAW workflow,貼近專業調色與剪接流程。

從官方比較表來看,目前維持開放權重且不受地區限制的開源視頻生成選擇仍然有限,這也是 LTX-2.5 在定位上最值得留意的差異化。不過實際表現仍需視本地硬件配置與工作流整合程度而定。

重點摘要

  • 原生多鏡頭生成:人物、環境、光線與聲音在不同鏡頭間保持一致。
  • 自動時長預測:依據動作需要自動決定片段長度。
  • 4K HDR 與原生 RAW:支援專業調色與後製 pipeline。
  • Gemma 4 12B 文字編碼器:搭配自研提示詞增強器,提升 prompt 跟隨度。
  • 開源權重可下載:可在本地硬件運行,並支援 LoRA 微調。

項目主頁

Categories: 開源, AI productions, 數字人, 多模態模型, 視頻模型, 模型訓練, Video, Image, LTX

MiniMax H3 人像寫實 LoRA,強化近鏡表情與電影感

基於 MiniMax H3 的人像寫實 LoRA,重點唔係加花巧風格,而係令面部、皮膚同鏡頭動態更自然可信。

Og image

近鏡人像、多人同框對話、手部動作呢類鏡頭,最容易暴露影片生成模型嘅細節破綻。呢個 Hugging Face 項目明確係基於 MiniMaxAI/MiniMax-H3 嘅 LoRA adapter,針對真人角色畫面再微調,重點放喺面部穩定度、皮膚質感、微表情同帶少少手持感嘅電影式運鏡,亦保留 MiniMax H3 原生同步音訊能力。

頁面提供嘅核心資訊相當集中:它屬於 text-to-video,授權採用 minimax-h3-community-license,主要檔案是 h3-realism-people-t2v.safetensors。使用方法唔複雜,要先喺 prompt 開頭加入 trigger word r34l1sm,再透過 fal 的 MiniMax H3 LoRA 端點掛載,範例 scale 係 1.0;想保留多啲 base model 原本味道,可以降到 0.6 至 0.8。

同類 LoRA 最大分別,往往唔係畫面變得幾誇張,而係同一個 prompt、同一個 seed 之下,能否穩定改善人物可信度。呢個項目用 before/after 方式展示 19 組對照,強調唯一變數係 adapter 本身,連 trigger word 兩邊都有加,目的係證明提升主要來自微調權重,而唔係提示詞技巧。頁面亦講明它係前作 MiniMax-H3-Realism-LoRA 嘅後繼版本,並且改用更大、更加聚焦人物題材嘅資料集重新訓練。

  • 基礎模型:MiniMaxAI/MiniMax-H3,關係標記為 adapter
  • 主要用途:強化寫實人物、近鏡面部、群眾、手部與紀錄片感鏡頭
  • 主要檔案:h3-realism-people-t2v.safetensors
  • 推薦控制:trigger word r34l1sm,LoRA scale 以 1.0 為預設,可降至 0.6-0.8

要留意,項目本質上係影片生成用嘅 LoRA,唔係可直接本地量化部署嘅通用文字模型。換句話講,它嘅價值更接近一個針對 MiniMax H3 補強人物鏡頭表現嘅專用適配器,而唔係完整獨立模型;使用場景亦明顯偏向 fal 平台上的 text-to-video 工作流。

模型

Categories: 開源, AI productions, 視頻模型, Video, Audio, MiniMax

MBM:跨類別動作轉移突破

你可以把它理解成一套跨類別影片動作轉移框架,重點是外形差很多時仍保住動作與身份。

Framework

想把一段動作搬到另一個角色或畫面,最怕形態差太遠時連身份都一併扭曲。MBM 走的是一套 motion transfer 研究框架,重點是把跨類別動作轉移做得更穩,讓 reference video 的動作可以連同 text,必要時再加一張 reference image,一起驅動生成。

它分兩段處理:Stage I 先學 heterogeneous abstract motion conditions,再 bootstrap cross-category motion pairs;Stage II 再用 raw reference videos 把這套監督內化。推理時直接靠 reference video、text 和 optional reference image,不需要 explicit motion extraction 或 test-time optimization。

它和只在相近外形之間搬動作的做法不同,目標是連 same-category、near-category 到 far-category 都盡量維持 motion fidelity 與 target preservation。資料同時提到 OpenVMT-Dataset 和 OpenVMT-Bench,前者是 instance-level motion-equivalent cross-content pairs,後者則用逐步拉大的 category gap 去測。

  • 兩階段框架先學抽象動作,再把監督內化到生成流程
  • 推理端直接吃 reference video、text、optional reference image,流程較短
  • 主打跨類別動作轉移,適合影片生成、角色動作遷移、動畫合成
  • 在大形態差距下仍可維持較好的動作保真與目標保留

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, Video, Image, 框架

Page 5 of 10
1 3 4 5 6 7 10