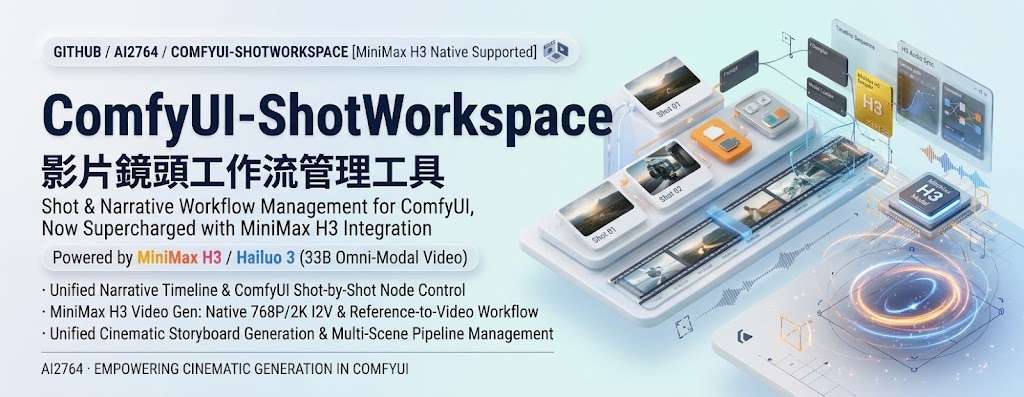
ComfyUI-ShotWorkspace:把分鏡素材整理與影片提示詞寫作納入 ComfyUI

準備角色、道具和場景參考圖,再整理分鏡描述、撰寫 MiniMax H3 影片提示詞,並接上原有的 ComfyUI 生成流程。模型、取樣與解碼仍由接收工作流程負責。

Shot Workspace inside the ComfyUI canvas

整理分鏡時,參考圖、描述和生成提示詞往往分散在不同步驟;ComfyUI-ShotWorkspace 把這些創作工作放進 ComfyUI 畫布,讓創作者準備素材、修訂鏡頭描述,再撰寫 H3 影片提示詞。這是個實驗階段的自訂節點,負責生成前的整理與寫作,不取代影片生成工作流程。

創作者可分別上載角色、道具和場景圖片,使用影像分析產生可編輯描述,再挑選當前鏡頭的參考圖並按次序送往接收工作流程。文字生成和圖片分析透過 API 連接 LLM 伺服器呼叫;影片模型權重、取樣及解碼則由原有工作流程處理,兩者需要分開安裝和測試。
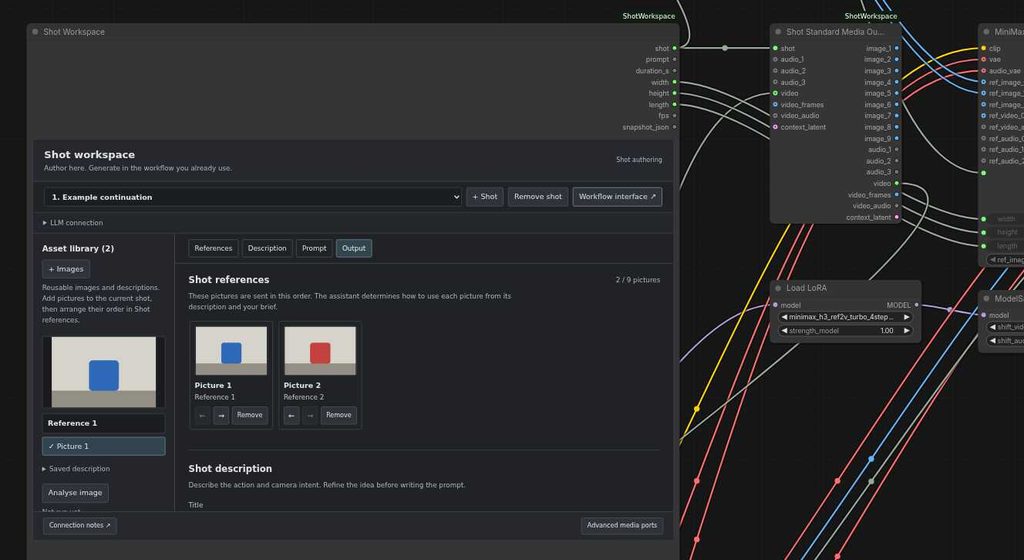
每次佇列只處理一個鏡頭,項目不負責編排完整影片序列。前一鏡頭的輸出不會自動成為下一鏡頭的輸入,使用者須自行選擇前置鏡頭;工作流程之間傳遞的 LATENT 格式亦必須相容。音訊、影片和 LATENT 接口可傳遞媒體,但不會自動把這些內容加入大型語言模型提示詞。

  • 需要 ComfyUI、Python 3.10 或以上版本,以及符合要求的 aiohttp 和 Pillow,依賴項須安裝到執行 ComfyUI 的 Python 環境。
  • 項目不附帶模型權重;LLM 伺服器、接收工作流程所需節點及 H3 權重都要另行準備。
  • H3 輸入影格按 24 fps 的 17k+5 網格安排;取樣時長在上下文裁切前設定,交付影片可能短於指定時長。
  • 工作流程會保存創作資料、檔名和伺服器網址;圖片本身留在 ComfyUI 的輸入目錄,分享前宜檢查保存內容。

這套工具較適合已經使用 ComfyUI、希望把分鏡準備和提示詞撰寫納入既有流程的創作者或小型製作團隊。它減少素材與文字在工作流程間來回整理的需要,但不提供完整序列編排,也不能單靠 LLM 連線測試確認影片生成正常。
GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Video, Image, Audio, 提示詞, 工具, Content Creator, MiniMax

TaoMate-FVSR:用音訊與稀疏參考修復人臉影片

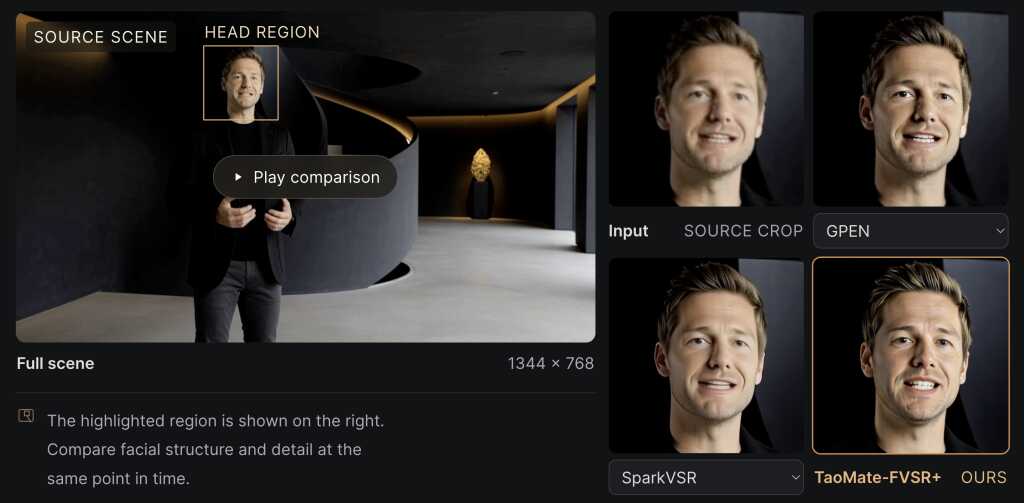
小臉在影片中容易失去細節,換上新配音時口形也可能對不上。TaoMate-FVSR 把音訊、參考畫面與生成歷史一併用於人臉修復,亦支援視覺配音。

favicon

影片中的人臉太小或細節模糊,單純放大未必能還原自然的面貌;換上新語音後,嘴形亦要配合音訊。TaoMate-FVSR 是一套人臉影片修復推理工具,利用音訊、稀疏的視覺參考和生成畫面歷史重建臉部,支援保留原聲修復,以及配合替換語音進行視覺配音。

它把臉部細節與口部動作放在同一個重建流程處理,並以來源影片保留場景結構,再由高質素參考提供外觀線索、目標音訊引導嘴部動態。相比先做超解像、再交給另一個配音模型的分段流程,這種聯合處理方式有機會減少修復結果與口形之間的不一致。

畫面可用 GPEN 處理首幀作參考,也可以提供自行編輯的首幀或完成的參考圖。推理流程會先以 DWPose 裁切人臉,再做修復、色彩與遮罩融合,最後貼回原影片;模型可按 1× 或 2× 尺寸運算,合成前會縮回 512×512,因此輸出場景維持原有尺寸。全場景比較也有助檢查修復臉部與原本畫面是否協調,但身體和背景不會一併提升解像度。

  • 支援原始音訊修復及替換語音配音。
  • 可用 GPEN、外部編輯首幀或完成的參考圖提供外觀線索。
  • 1× 與 2× 推理分別使用 512×512 與 1024×1024 處理尺寸。
  • 執行需要支援 BF16 的 NVIDIA CUDA GPU,以及 CUDA 版本相容的 PyTorch 2.6 或更新版本和 torchvision 0.21 或更新版本。

這套工具較適合需要修復 AI 生成影片人臉、製作配音版本,或比較局部臉部細節與完整場景效果的創作者及研究團隊。參考畫面質素和場景合成效果都會影響最後成果,正式製作前宜用自己的素材測試。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, NVIDIA, Video, Audio, 工具, Content Creator, 線上服務, 語音

Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

Garden Skills:讓 AI coding agents 承接影片、設計與寫作流程

從程式生成短片、網頁設計到整理知識庫,Garden Skills 把多種工作流程包成可供 AI coding agents 使用的技能。創作型工作尤其著重分階段確認與一致的輸出控制。

Motion Showreel Skill

想用 AI coding agent 製作短片、網頁簡報或整理本地知識庫,Garden Skills 提供一組可加入工作流程的 Agent Skills,適用於 Claude Code、Cursor、Codex 等工具。它不是單一模型,而是涵蓋影片製作、前端設計、影像提示、文章生成與知識檢索的技能集合;各技能如何安裝可按 項目文件提供的方式處理,但這份資料未列出完整操作步驟。

影片相關技能的重點,是把畫面與聲音放進同一條時間軸,並由同一個頁面產生不同階段的輸出,包括靜態畫面、聯絡表、預覽代理檔及成品。創作者可以選擇多種視覺風格,調整動態、鏡頭語法和聲音方向;配樂可由內置合成器或 Tone.js 產生,也可以配合自備音軌及節拍、段落變化剪輯。

創作流程設有兩個確認點:先確認需求,再確認風格畫面;若未指定風格,會提供三個方向供選擇,之後才進入自主製作。長片支援分章製作,最長可達 20 分鐘;Gemini 或 MiniMax TTS 只會朗讀使用者提供的稿件,錄音則以實際時間戳記對齊,音樂與音效亦會為旁白讓位。這些安排適合需要反覆檢視視覺方向、又希望聲畫時間一致的內容團隊,但資料沒有提供效能測試或品質評分,成品仍需自行檢查。

其他技能分別處理網頁影片簡報、前端設計、GPT Image 2 提示與影像生成、美化文章,以及本地知識檢索。對需要把重複創作步驟交由 AI coding agent 執行的設計師、影片製作者及內容團隊,這種技能集合比只提供單一功能的工具涵蓋更廣;取捨是各項工作的品質和適用程度,仍取決於所選技能、模型與輸入內容。

【经验开源】AI 做动画视频完全指南:原理、技巧、Skill 一次给全
  • 六種技能涵蓋影片、網頁、影像、文章及本地知識檢索。
  • 影片輸出由同一頁面生成,畫面與聲音共用時間軸。
  • 風格確認後才開始自主製作,未指定時可先比較三個方向。
  • 長片支援分章製作至 20 分鐘,旁白須使用者提供稿件。
  • 項目文件列出多種安裝途徑,但目前提供的資料未包含完整安裝流程或評測結果。

GitHub

Categories: 開源, Agentic, AI productions, Gemini, Video, Image, Audio, Vibe Coding, Content Creator, IDE, 庫, 編程, 音樂, MiniMax, Skill 技能

Microsoft Mage-VL-Cowork:以 4B 模型兼顧影片理解與電腦操作

Mage-VL-Cowork 是一個 4B 多模態模型家族涵蓋影片理解、影像生成和 GUI 電腦操作,並以較少視覺 token 處理長影片。當中 Mage-VL-Cowork 在 OSWorld-Verified 取得 66.0%。

gallery

要分析長影片、生成或編輯影像,甚至操作桌面程式,通常需要不同模型和工作流程。Microsoft Mage 把這些能力放進 4B 參數的多模態模型家族,供研究團隊進行受控實驗、後訓練研究及垂直領域應用;它屬於模型系列。

三個模型各有分工:Mage-VL 處理圖像與影片理解,Mage-Flow 負責影像生成和編輯,Mage-VL-Cowork 則在同一個策略模型內結合圖形介面、程式碼和終端機操作。這種混合式電腦操作讓模型可按任務選擇點擊畫面或執行程式碼,而不是交由外部協調器切換不同代理。

影片處理的主要取捨,是減少冗餘影格資訊,同時保留時間與動作線索。Mage-VL 從零訓練視覺堆疊,採用 16×16 的 I/P 預測式 patch 機制,將視覺 token 用量降至密集影格取樣的八分之一或更少;項目報告稱,這令影片訓練時間可延長至 8 倍,推理速度最高提升 3.5 倍。以固定的 4B Qwen3 骨幹比較,Mage-ViT 在所有已報告的影片及時間定位基準測試中勝過 Qwen3-VL-4B,但靜態圖像表現則大致相若。

OSWorld-Verified 的測試中,Mage-VL-Cowork 在 50 步預算下取得 66.0%;強化學習訓練帶來 10.16 個百分點提升,並令模型呼叫減少 13%、輸出 token 減少 25.4%。另一項實驗結果指出,Mage-VL 在 VSI-Bench 領先 11.0 分,顯示其優勢較集中於影片理解和空間智能。

研究人員可按任務選用相應模型與程式碼,測試影片理解、生成編輯或混合式電腦操作;Mage-VL-Cowork 的訓練流程亦涵蓋資料合成、監督微調與強化學習。適合有能力配置模型環境的研究團隊,以及探索有限算力多模態應用的開發者。

  • 三個 4B 模型分別涵蓋圖像與影片理解、影像生成編輯、混合式電腦操作。
  • 預測式 patch 機制減少影片視覺 token,換取更長訓練影片與較快推理。
  • Mage-VL-Cowork 在 OSWorld-Verified 以 50 步預算取得 66.0%,同時減少模型呼叫與輸出 token。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, 微軟, Video, Image, 庫, 強化學習

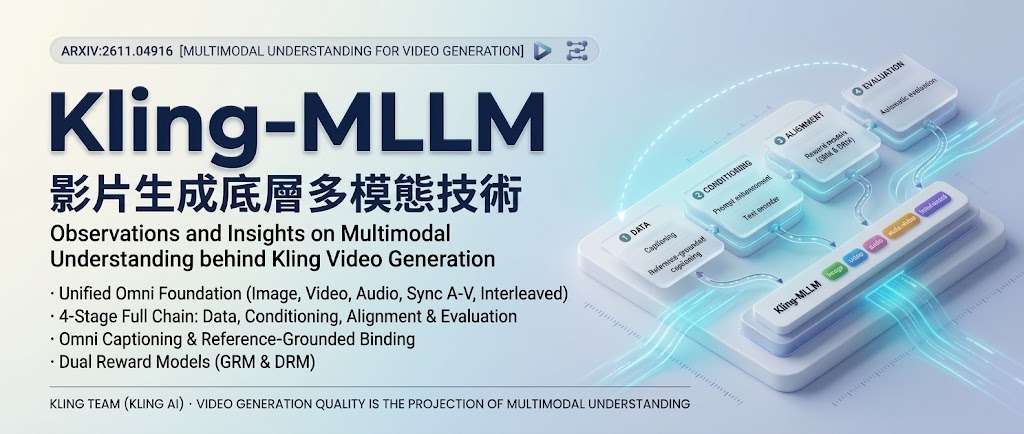
[技術文章] 影片生成的背後故事:Kling 的多模態理解觀察與見解

影片生成的瓶頸正由畫面渲染轉向語意控制。Kling 團隊拆解資料、提示、對齊與評估環節,說明如何令生成結果更貼合使用者意圖。

Hero image preview

當影片生成要跟從複雜描述、維持人物與物件一致,單靠提升畫面品質並不足夠。Kling 團隊的技術報告聚焦多模態理解,分析資料、條件輸入、對齊和評估如何共同影響生成結果,適合關注可控影片生成的研究者與產品團隊參考。

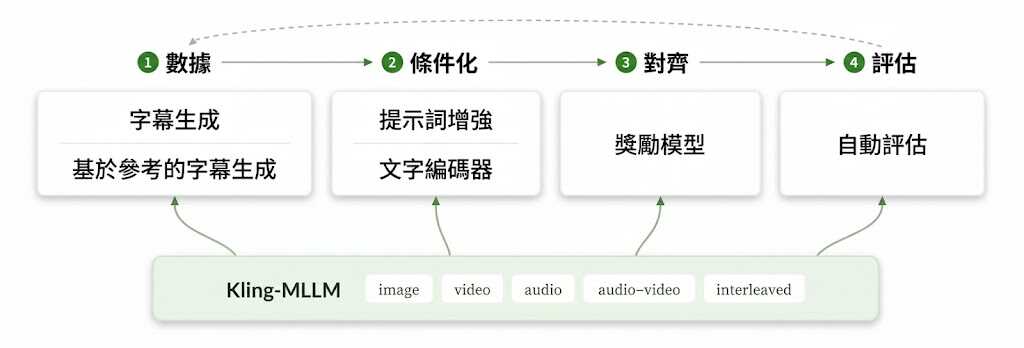
研究以 Kling-MLLM 為共用基礎模型,處理圖片、影片、音訊、同步影音及交錯輸入,再按不同下游任務作專門調整。團隊指出,DiT 的訓練樣本遠少於語言模型,因此字幕不能只求流暢,而要作為高密度的語意契約;延伸出的 reference-grounded captioning,亦會明確標示描述與參考內容的對應關係。

提示詞增強負責把使用者意圖轉成生成模型較能處理的描述分佈。基本方法由優質影片字幕整理而成,再配合文字層面的強化學習及生成器迴圈微調;agentic prompt enhancement 則會進一步整理故事,並檢索具參考價值的例子。報告亦指出,可靠的 text encoder 需要感知訓練,單純提升語言能力並不足夠。

報告涵蓋的技術重點包括:
– 以共享多模態模型支援不同輸入形式及下游模組。
– 用高密度字幕和明確參考綁定,補足訓練語意與素材之間的連結。
– 以可解釋、能定位問題的通用 reward model,配合快速多維評分的 decision reward model。
– 設計任務專用自動評估,揭露評分捷徑,並協助追查上游失誤。

這套思路適合用於影片生成系統的資料整理、提示處理、模型對齊和品質診斷;團隊也強調,感知能力、描述品質與評估協定需要一併設計。內容屬於 Kling 團隊對其多代系統經驗的整理;提供的資料亦未列出可供外部讀者直接重現的完整流程。

Paper

Categories: Agentic, AI productions, 多模態模型, 視頻模型, 模型訓練, Video, Image, Audio, 提示詞, 強化學習

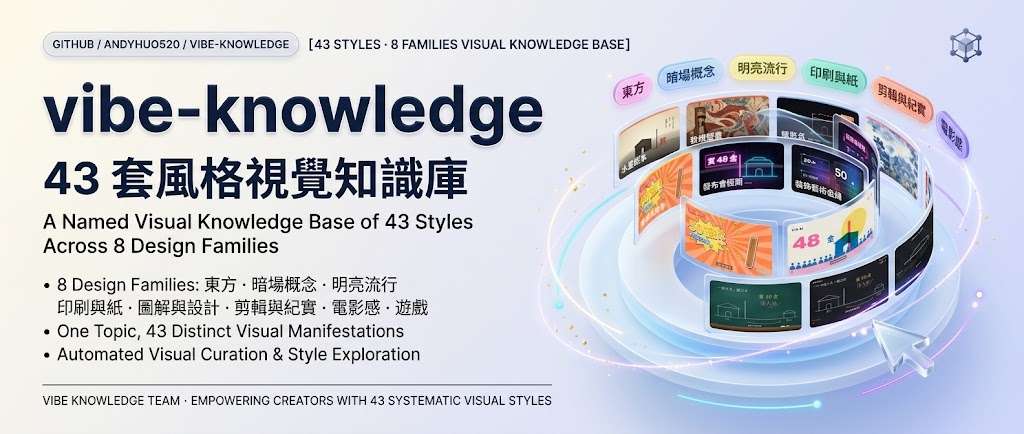
vibe-knowledge:把知識點做成可查證短片

vibe-knowledge 將查證、旁白、逐幀渲染和質檢串成一套對話式短片製作流程,亦把生成成本攤開給你核准。

风格快闪片

把一個知識點變成有旁白、逐句附來源的 1080p60 短片,vibe-knowledge 以 Claude Code skill 串起選題、查證、寫稿、配音、程式渲染、OCR 質檢和發布包;它屬於 AI 內容製作工作流項目,處理的是知識內容由文字走到可觀看影片時的流程分散問題。

vibe-knowledge 需與 ai-teardown 一併安裝,後者提供 cine 渲染引擎、工作區及配音腳本。渲染環境需要 Python、NumPy、SciPy、Pillow、Playwright、Chromium headless shell 和 ffmpeg;macOS 的 OCR 質檢則依賴 Vision 及 swiftc。

每次提交生成前,流程會列出鏡頭、模型、提示詞和 estimate cost,等使用者在對話中明確同意才繼續。基礎檔可用 0 積分完成程式插畫版;增強檔加入 Renoise 生成的配圖與 Wan 動態鏡頭,示例《商鞅立木》使用 246 積分,常見檔次約為 25–40、250–300 及 600–700 積分。

  • Claude Opus 負責編排,畫面由程式逐幀渲染
  • 早期提供古風、星空、像素、字幕新聞等多套風格
  • 基礎檔與增強檔可保留同一旁白及腳本作比較
  • Release v1.0.0 已提供多段樣片,但未有獨立準確率或品質基準

適合需要持續製作歷史、科普或解釋型短片的內容團隊,尤其重視來源標註、成本審批和可重複流程的工作情境。Renoise 增強檔能擴充視覺效果,代價是積分及外部模型依賴增加;片中亦會標示「AI 示意」,不能當作史實畫面或紀錄片素材直接使用。

GitHub

Categories: 開源, AI productions, 模型, Video, 提示詞, Mac, Python, 新聞, Anthropic, Skill 技能

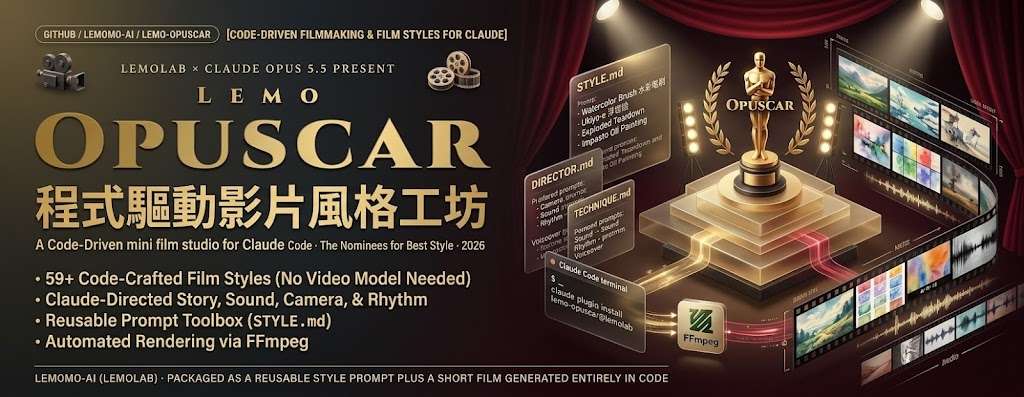
Lemo-Opuscar:讓 coding agent 用 66 種程式影像風格拍片

想把故事變成風格鮮明的短片,可以從 66 種程式製作的影片風格選擇,再交由 coding agent 協助導演。

OPUSCAR 98 — 98 Years of Best Picture

想把文字故事變成短片,又希望畫面不只停留在一般生成影像的風格,Lemo-Opuscar 提供 66 種可直接選用的程式影像風格,並支援自行修改或從空白開始創作。它是一套以程式碼製作影片的風格工具箱,讓 coding agent 按所選風格處理故事呈現;每種風格亦附有短片示例,方便先看效果再決定方向。

畫面由 canvas 和 WebGL 網頁逐格繪製,音樂採用免費取樣音源製作原創配樂,旁白則使用文字轉語音。這種做法把視覺風格、配樂和旁白組合成一條影片製作流程,適合想快速嘗試不同美術呈現的創作者,也可用於資料敘事、紀錄片及短片概念驗證。

使用者可以先到線上風格展示頁瀏覽範例,再挑選風格、提供故事,或修改既有風格及自行建立新風格。

風格針對 Claude Opus 5.5 調校,作者提醒其他模型未必能重現相同效果;這是選用工具時需要納入考慮的限制。項目亦展示每部作品配合相應風格呈現,說明這套方法可用於較長篇幅的主題作品。

  • 提供 66 種可用影片風格,並可修改或自行創作。
  • 以 canvas、WebGL 逐格繪製畫面,並結合配樂與文字轉語音旁白。
  • 可先瀏覽線上展示頁和短片範例,再決定風格與故事方向。
  • 風格主要針對 Claude Opus 5.5 調校,其他模型的重現效果未有保證。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, 模型, Video, Image, Vibe Coding, 工具, Content Creator, 編程, 語音, Anthropic, 音樂

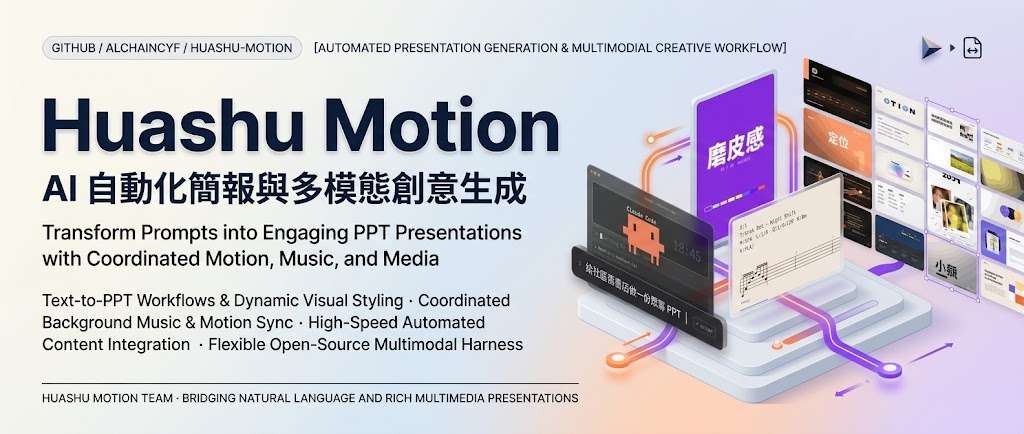
huashu-motion:AI Agent 按節奏製作產品宣傳片

由 Claude Code 或 Codex 讀取產品內容、編排動畫和配樂,再讓你在瀏覽器畫面上指定位置修改。製作流程可在本機完成,配樂亦毋須呼叫付費接口。

huashu-motion发布片开场:一整面墙的片子,说一句,出一支片

想把產品介紹變成一支短片,可以直接向 Claude Code 或 Codex 提出需求;huashu-motion 會先閱讀產品內容,提供三個創作方向,再編寫動畫與配樂,並在瀏覽器開啟編輯器。它是一套供 AI Agent 使用的動畫製作 skill,處理從產品內容到宣傳片、再到局部修改的工作流程。

修改方式著重畫面定位:在預覽中按 C,再點選要調整的位置並留下意見。評論會附上時間點、場景、所選元素及其原始碼位置,Agent 可針對該處修改;版本會保留,亦可撤回。標題、數字、顏色和停留時長等項目則可直接在編輯器輸入框調整。

配樂不是完成影片後才補上的背景音。Agent 會先按節奏單寫 ABC 記譜法樂譜,並以樂譜標記配合場景切換;樂器音色可選本機採樣或合成音色,音效則配合畫面元素落地的時刻。本機生成配樂不需付費接口;使用三腳鋼琴、弦樂和鼓組等真實樂器音色,需另行下載約 55MB 採樣。口播亦屬可選功能,Kokoro 中文語音和逐字對齊各有額外安裝需求。

項目列出以 Chrome、Chromium 或 Edge 執行截帧、檢查及匯出,不需另外下載渲染器;也展示 Claude Code、Codex 和 DeepSeek V4.1 Flash 等案例。當中一支 22 秒動效片以 DeepSeek V4.1 Flash 製作,經三輪修改,不到半小時完成;文中記錄當時費用為 1.95 元,不能視為固定成本或其他模型的效能保證。安裝方式雖有列出,但資料沒有完整說明各平台的操作流程,首次使用仍要按所選音色和口播功能處理相應依賴。

  • 先閱讀產品內容,再提供三個方向並生成完整短片。
  • 在預覽指定畫面位置,讓 Agent 針對局部修改;版本可保留和撤回。
  • 配樂以 ABC 樂譜和場景標記同步,音樂及音效可在本機生成。
  • 可透過瀏覽器截帧、檢查和匯出;真實樂器採樣與中文口播需額外依賴。

這套流程適合需要快速製作產品發布片、又希望保留逐處審核和修改能力的產品及設計團隊。它把創作交給 Agent,但仍讓人透過畫面評論調整細節;採樣下載、語音工具安裝及各平台實際操作方式,則是導入前需要確認的成本。

GitHub

Categories: 開源, Agentic, AI productions, 模型, DeepSeek, Video, 工具, 語音, Anthropic, 動畫, 音樂, Skill 技能

teardown:把機器原理變成可拆解的 3D 模擬器

想了解引擎、手錶或挖掘機怎樣運作,可以讓 Claude Code 生成一頁式模擬器,邊看機器運轉,邊拆開部件追蹤數值。

Mellis HB-7 robotic bee simulator

想弄清楚四衝程引擎如何運作,單看文字或靜態圖解未必容易掌握部件之間的關係。teardown 是一項 Claude Code skill,會按自然語言指示生成離線 HTML 3D 模擬器,讓機器在畫面中央運轉,周邊面板同步顯示數值,亦可按鈕打開正在工作的部件。

使用者可在 Claude Code 以日常語句描述想了解的機械,例如機械手錶或液壓挖掘機臂,再要求生成模擬器;項目亦附有 V8 引擎、Cessna 飛機和 Strandbeest 機械生物三個例子,可用 Node.js 建成單一 HTML 頁面。安裝需要 Node.js 20 或更新版本,以及 Playwright 的 Chromium;影片輸出另需 ffmpeg,聲效製作則需 Python。主要使用方式是透過 Claude Code 提出描述。

生成的頁面會把 three.js 和字體內嵌,方便離線開啟;模擬器閒置時會自動巡覽,亦可把畫面逐格輸出成 60 fps MP4,並配上時間軸聲效。相較只提供動畫的展示頁,它把機械運作、即時數值與可拆解部件放在同一介面。

較適合製作互動式教學素材、概念展示或機械原理解說的教育工作者、設計師和工程團隊。要留意,生成品質會受描述與 Claude Code 產出影響;若內容用於工程驗證或安全判斷,仍需另行核實模型設定與數據。

  • 以自然語言要求 Claude Code 建立機械 3D 模擬器。
  • 單一離線 HTML 頁面包含機器動畫、數值面板和部件拆解互動。
  • 可將模擬器畫面輸出為 60 fps MP4,並加入程序化聲效。
  • 內附 V8 引擎、Cessna 飛機及 Strandbeest 三個示例。
  • 文件未提供物理準確度評測,生成結果不宜直接當作工程驗證。

GitHub

Categories: 開源, AI productions, 模型, Video, 教學, 3D, Python, 安全, Anthropic, 動畫, 聲效, Skill 技能

Page 1 of 22
1 2 3 … 22