MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。
模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

ComfyUI-Omnichar:用 .char 讓角色跨模型保持一致

ComfyUI-Omnichar 把角色參考圖、描述和 LoRA 收進同一個 .char,方便在圖像與影片模型之間保持人物連貫。

Omnichar nodes in a ComfyUI graph

同一角色要跨圖像與影片模型維持相同面孔、服裝和身形,ComfyUI-Omnichar 以可攜式 .char 檔案處理這個問題。它屬於 ComfyUI 自訂節點工具,讓角色資料不必隨每個工作流程重新整理。

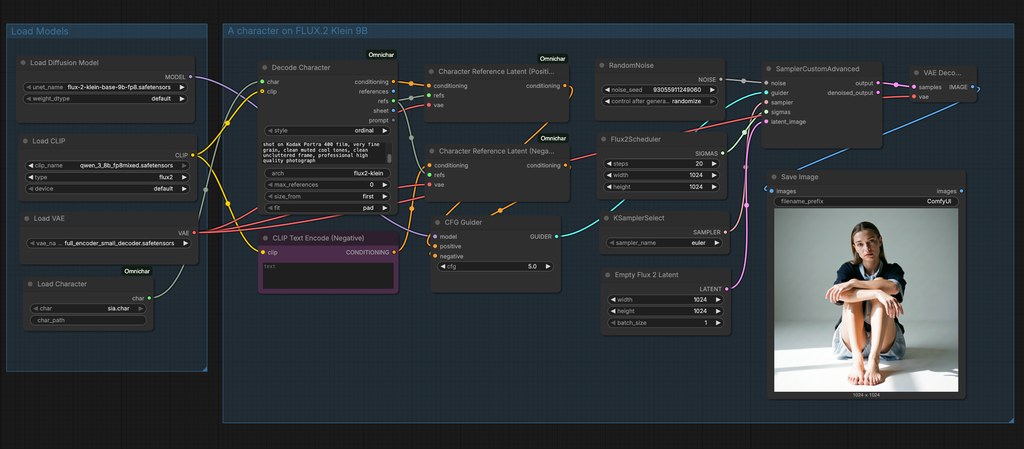
.char 可保存參考圖、鎖定描述,以及可選的訓練 LoRA;檔案可以由 Omnichar Studio、Omnichar Cloud 或 Encode Character 建立,再交給 FLUX.2、MiniMax H3、Krea2、klein9B 及 klein4B 使用。相較於每次手動接入參考圖,這種方式把角色資料、圖片順序和提示詞編號固定下來,代價是工作流程需要配合支援 references 的模型。

  • 透過 Load Character 讀取 .char 檔案
  • Encode Character 可分別加入 face、body 和 cloths 參考圖
  • Decode Character 可輸出 conditioning、references 和 prompt
  • 角色附有 LoRA 時,可同時套用至 MODEL 和 CLIP

安裝需要 ComfyUI、Python 3.10+ 和 omnichar-sdk;.char 檔案放入 ComfyUI/models/characters/ 後,便可由載入節點選取。需要共用 Omnichar Studio 資料夾時,也可設定 INLINE_CHARACTERS_DIR,讓兩邊讀取同一批角色檔案。

生成結果仍會受所選模型、參考圖質素和 GPU 資源影響。對需要製作連續角色插畫、分鏡、短片或多模型內容的創作者,.char 的集中管理會比散落在不同 workflow 的參考圖更容易維護;偏好完全手動控制的人,則未必需要加入這層封裝。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, Stable Diffusion, API, Video, Image, 提示詞, 工具, Content Creator, Python, MiniMax, LoRA

Awesome-Video-Generation-Post-Training:影片生成後訓練研究,一個持續更新的索引

影片生成模型的競爭已延伸到後訓練與對齊,這項目把論文、數據集及評測基準集中整理。

timeline

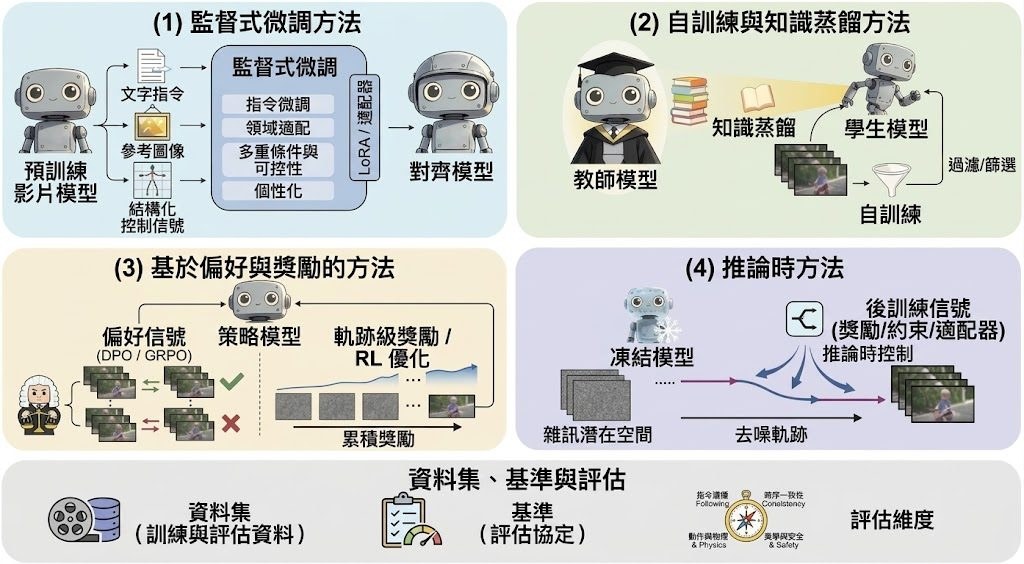
當影片生成模型由「能夠生成」走向「更符合指令、更穩定、更易評估」,研究者需要追蹤的不只是預訓練架構。Awesome-Video-Generation-Post-Training 是一個研究資料整理項目,集中收錄影片生成的 post-training、alignment、相關數據集及 evaluation benchmarks,亦配套一篇 Video Generation Models: A Survey of Post-Training and Alignment 綜述論文。

它不提供可直接執行的生成模型,主要在於縮短研究資料搜尋時間。你可按分類閱讀近期論文、對照不同後訓練方法,再沿着數據集與評測基準追查研究如何衡量影片品質、指令遵從及對齊效果;項目內容會持續更新,亦接受透過 pull request 補充論文、修正資料或建議分類。

  • 資料範圍:聚焦影片生成的 post-training 與 alignment 研究
  • 配套資源:整理相關 datasets 及 evaluation benchmarks
  • 閱讀方式:適合由綜述論文入門,再按分類深入原始研究
  • 參與方式:可提交 pull request,補充或修訂索引內容

對研究生、影片模型開發團隊及需要整理文獻的工程師而言,這項目比零散搜尋更方便建立研究地圖。它的限制亦很清楚:索引本身沒有統一跑分、推理介面或安裝後即可測試的模型,性能判斷仍要返回各篇論文查看實驗設定與指標。

GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 模型訓練, Video, World-Action Model, Dataset 數據集

Vlo 把 ComfyUI 帶進本地影片剪輯時間線

Vlo 將生成式 AI、ComfyUI 和傳統剪輯工具放在同一條時間線,適合想在本地處理影片的創作者。

landing

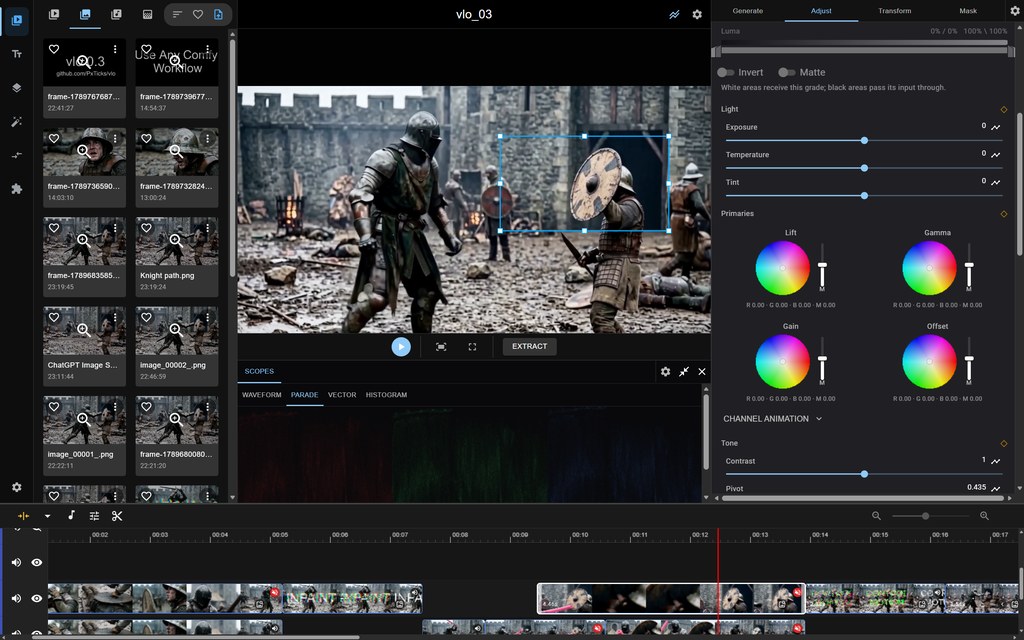
想在影片時間線內直接交給 AI 做遮罩、修補或畫面變換,Vlo 提供了一條較完整的工作流程。它屬於免費、開源的本地影片編輯器,處理的是生成式 AI 與逐格剪輯之間難以銜接的問題,亦支援在本機或遠端 GPU 上編輯同一批本地項目檔案。

Vlo 把 ComfyUI bridge 接入編輯器,圖片、影片和時間線選取內容都可以送入 ComfyUI 工作流;SAM2 points editor 則用於遮罩,並配合自動裁剪與拼接處理 video inpainting。自動調整 aspect ratio 讓不同影片模型處理素材時毋須先裁走畫面,色彩校正、音訊、版面、濾鏡、keyframes、spline editor、beat detection 和可吸附 markers,則補上傳統剪輯所需的控制。

測試時需要 Chromium-based browser,官方已測試 Chrome 和 Edge;Firefox 由於 WebCodecs 實作差異,早期測試曾出現明顯延遲。媒體渲染由 mediabunny 包裝 WebCodecs,配合 File System Access API 直接管理磁碟檔案,但清除瀏覽器資料後可能遺失項目資料夾位置。

  • ComfyUI 工作流可直接套用到時間線選取內容
  • SAM2 遮罩支援影片修補流程的自動裁剪與拼接
  • 本地項目可配合本機或遠端 GPU 編輯
  • 具備逐格影片編輯所需的 keyframes 和 spline 控制
  • 目前依賴 Chromium,瀏覽器兼容性是主要限制

Vlo 較適合需要把 AI 影片生成、inpainting 和傳統後期剪輯放在同一個工作區的創作者或小型團隊。項目沒有提供可直接比較的性能指標,現階段較能確認的是它以 WebCodecs 支撐 frame-accurate nonlinear video editing,並以可擴展的 ComfyUI 工作流延伸功能;瀏覽器限制和本地檔案管理方式,仍會影響團隊採用前的測試安排。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, API, Video, Image, 影像處理, Audio, 工具, Content Creator

OneStreamer 讓串流影片懂得記憶與適時回應

影片畫面離開視窗後,OneStreamer 仍可保留具時間線索的證據,並自行判斷何時已有足夠資訊回應問題。

OneStreamer

直播影片一閃即逝,畫面離開模型的視覺視窗後,之後的提問仍可能需要引用那些細節。OneStreamer 屬於串流影片大型語言模型,處理的正是記錄證據、理解新畫面,以及在資料足夠時主動回應之間的取捨。

它以 Qwen3-VL-4B-Instruct 為基礎,OneStreamer-4B 透過 Proactive Hierarchical Caption Memory(PHCM)保存局部細節和已完成事件摘要,再配合近期畫面作答,減少重看歷史影片特徵的需要。Proactive State Transition Learning(PSTL)則保留輸出錨點,挑選具代表性的狀態變化與持續狀態,只有 27.5% 標註狀態 tokens 需要監督。

你可從 Hugging Face 取得 OneStreamer-4B 模型及 OneStreamer-1M 數據集,配合串流影片、問答或字幕資料測試;儲存庫目前提供模型、數據集和示範頁面,但完整推理指令未在提供內容中列出,因此部署前仍需確認執行框架、硬件需求和輸入格式。OneStreamer-1M 合併串流字幕、串流 QA 及整理後的開源資料,共有 1.16M 筆互動記錄。

八項涵蓋線上感知、記憶和主動回應的基準測試中,OneStreamer-4B 在比較方法中取得最高的整體結果;這對需要持續觀看教學、監控或家庭影片的團隊較有參考價值,但生成式記憶仍可能受字幕品質、延遲和錯誤累積影響。

  • PHCM 同時保留局部細節與完成事件摘要
  • PSTL 針對回應時機和重複等待狀態作訓練
  • 模型、數據集及示範頁面均已公開
  • 八項基準測試涵蓋感知、記憶與主動回應
  • 適合研究串流影片理解及長時間上下文的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 南京大學, AI productions, 模型, 視覺模型, 模型訓練, Qwen, Video, 框架, 教學, 庫, Dataset 數據集

4Director:3D 幾何精準控制影片世界模型

4Director 將鏡頭、物件與新加入的物件放進同一個 3D 空間,改善影片生成中動作失控和視角不一致的問題。

4Director

想令影片中的鏡頭、原有物件和新加入的物件按指定路徑移動,4Director 提供了一個較接近 3D 動畫製作的控制方式。它屬於影片世界模型,處理的是生成影片時深度、旋轉和跨視角一致性難以同時維持的問題。

系統會先為每件物件重建一個 canonical mesh,再以每幀一組 rigid transformation 推動物件,並把整個場景渲染成深度影片。Motion Adapter 之後將這份幾何骨架轉換成具備外觀、光照和非剛性動態的影片;新物件則可透過參考影像插入場景,並與鏡頭及原有物件共同控制。

相較只控制鏡頭、依賴 image-plane cues,或使用 3D tracks、blobs 的方法,完整網格能保留物件未被鏡頭看見的幾何,減少物件離開畫面後再出現時形狀和身份改變的情況。影片生成研究、視覺特效預演,以及需要精確安排物件運動的製作團隊較容易受益,但重建網格和建立剛性軌跡亦增加了準備工作。

  • RealCOD-Rigid 提供 20,774 段附有剛性 3D 場景標註的影片片段。
  • Identity-Gated IoU(IG-IoU)同時衡量物件動作是否跟隨指令,以及物件身份能否保持。
  • 實驗報告指 4Director 在畫質、鏡頭控制和物件控制方面優於多種先前方法。

4Director 目前更適合作為研究原型和可控影片生成的實驗基礎,而非即裝即用的剪片工具。理解其效果時,應同時檢查生成畫面的外觀品質、指定軌跡的遵循程度,以及物件離開後重新出現時的身份一致性。

項目主頁 · GitHub

Categories: 開源, AI productions, 世界模型, Video, 工具, 3D, 動畫

SoL-Refiner 高解像度影片生成加速 27 倍

先完成低解像度草稿,再用一次去噪提升至高解像度,SoL-Refiner 大幅縮短影片生成時間。

Og image

高解像度影片生成往往受限於大量時空 tokens,SoL-Refiner 以影片精修模型處理這個瓶頸:先由不同基礎生成器製作較低解像度草稿,再用一次目標解像度去噪輸出最高 4K 影片,毋須進行多步精修。

NVIDIA Research 的訓練流程結合高解像度持續訓練、frame-based RL post-training,以及 one-step distribution-matching distillation,並支援 bidirectional 和 streaming inference。方案可接駁 MiniMax H3、SANA-Video、Cosmos-Nano 和 WAN 等不同生成器,令精修模組毋須綁定單一模型。

  • 一次高解像度去噪,減少第二階段採樣成本
  • 支援多個影片生成器,改善跨模型工作流程
  • 在 2K 保持具競爭力,4K 指標優於 LTX-2.3
  • WAN 和 Cosmos-Nano 測試中,平均質素亦有所提升

以五秒、1344×768、24 fps 影片測試,MiniMax H3 直接生成高解像度版本需 152.3 秒;低解像度生成加 SoL-Refiner 的兩階段流程只需 5.6354 秒,量得 27.03 倍牆鐘速度提升。測試使用 NVIDIA GB200,每個階段各佔用一張 GPU,實際速度仍會受硬件、基礎生成器和影片設定影響。

SoL-Refiner 適合需要大量高解像度影片、但又要控制推理延遲的內容製作流程。它以額外的低解像度生成階段換取更快的高解像度輸出,質素和速度之間的取捨仍取決於輸入草稿及所選生成器。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Image, 教學, Python, LTX, MiniMax

MiniMax H3 的雙用途 X2 Detail VAE 實驗

一個 VAE 同時處理影片 2 倍解碼與參考圖細節增強,但仍依賴指定 ComfyUI 節點。

Og image

由 MiniMaxAI/MiniMax-H3 作為 base model,呢個實驗型 video VAE 將兩條工作流程放入同一個模型:一條負責生成影片 latent 的 2 倍解碼,另一條則提升 image-reference 的空間細節,適合 ComfyUI 影片生成項目使用。

影片模式會以 MiniMax-H3-X2-Detail-v1.safetensors 解碼,再將 packed 12-channel 輸出交給 PixelShuffle ×2,產生 2 倍 RGB 影片幀。參考圖模式則透過 MiniMax H3 VAE 2X (Detailed Upscale) 節點,從 encoder 的 down.1.block.1 抽取額外 B32 空間細節;因此必須有現成 RGB 參考圖,並非只處理 latent。

檔案附有 ComfyUI 節點、workflow 及研究報告。影片解碼需要 ComfyUI-MiniMaxH3_LatentUpscaler 的 MiniMax H3 VAE Decode (fast),示範設定包括 tiling=true、tile_size=256、tile_overlap=64、output_device=cpu,以及 temporal_tiling=false;節點依賴令流程不能直接用標準 VAE Decode 取代。

  • 模型檔案:MiniMax-H3-X2-Detail-v1.safetensors
  • 定位:2X VAE Decode 加參考圖 Detail Enhancement
  • 已知取捨:B32 細節路徑只適用於 RGB 參考圖
  • 頁面未提供參數規模、上下文長度、GGUF、量化版本或 mmproj 檔案

項目作者將成果描述為一次未達預期的 HQ-VAE 實驗,但保留了可工作的 2-in-1 發布版本。適合作為實驗性 ComfyUI 工具,而非已完成全面效能驗證的通用 VAE。

模型

Categories: 開源, ComfyUI, AI productions, 模型, Video, MiniMax

ThinkV2V 讓影片編輯先思考再生成

ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

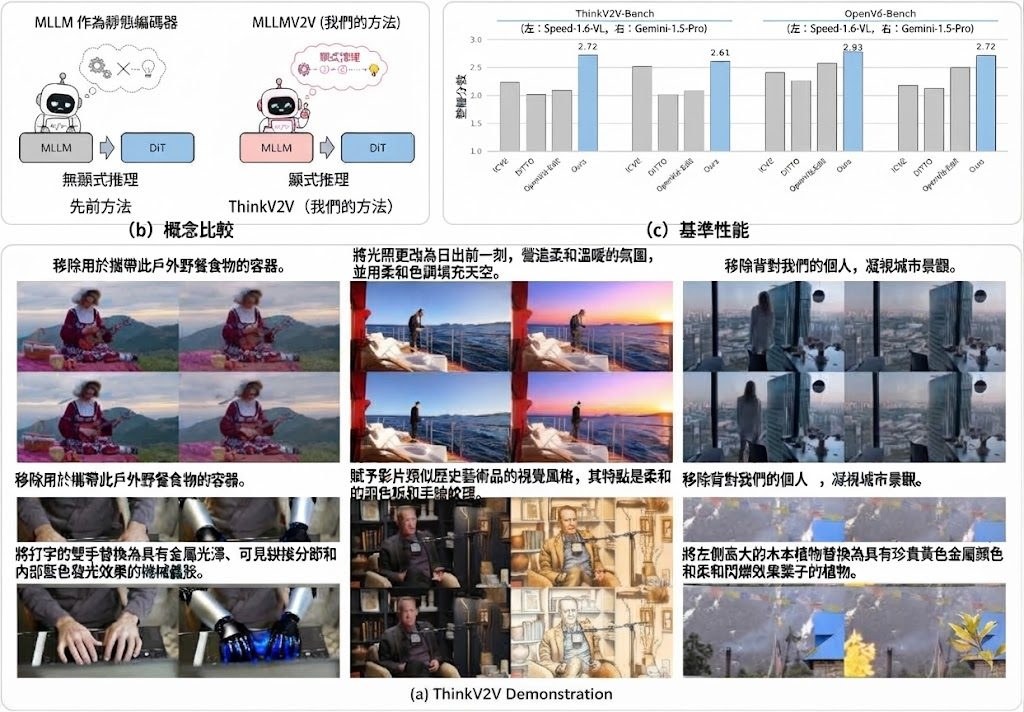
面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

NVIDIA LongLive 把長片生成推向即時互動

NVIDIA 將三階段長片生成研究整合到同一個項目,涵蓋即時互動、量化推理及可重用蒸餾能力。

LongLive logo

NVIDIA 開發團隊把長片生成帶入即時互動、低精度推理和跨模型重用場景。LongLive 屬於開源影片生成研究項目,處理長時間生成容易變慢、下游模型需要重複蒸餾,以及互動控制成本偏高等問題。

項目分成三代,並各自放在獨立目錄,附有程式碼、文件和模型權重。LongLive 1.0 聚焦即時互動長片生成;LongLive 2.0 以 NVFP4 量化和 sequence parallelism 加速訓練及服務;LongLive-Plug 則把 few-step、CFG 和 long-context 能力蒸餾成可重用 LoRA,讓同一模型家族的下游模型減少重新訓練。

LongLive 2.0 支援 T2V/I2V AR training、multi-shot 或 single-shot videos,以及 NVFP4 inference、NVFP4 KV Cache 和 TorchAO FP8 PTQ inference,取捨是需要配合量化及平行化基礎設施。

  • LongLive-Plug:一次蒸餾能力,再在同一 backbone family 的下游模型重用
  • LongLive 2.0:以 NVFP4、BF16 和 sequence parallelism 支援長片訓練及推理
  • LongLive 1.0:讓使用者輸入提示詞後即時觀看並逐步控制長片生成
  • DreamForge-World 0.1:加入 residual action pathway,面向低算力、即時可控 world modeling

研究展示包括互動示範、長片 rollout 和不同 backbone family 的配對例子,但提供資料未載有可直接比較的統一 benchmark 分數。具備 NVIDIA GPU、需要研究影片生成系統,或希望在 Wan2.1、Wan2.2、MiniMax-H3 等模型家族上重用蒸餾能力的團隊,較容易找到合適切入點;一般使用者則要先接受它偏研究項目,操作細節仍取決於所選目錄。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, 提示詞, 語音, Dataset 數據集, MiniMax, LoRA

Page 10 of 22
1 … 8 9 10 11 12 … 22