H3 分鏡技能:分鏡及表情提示

這個 Claude Code 技能把腳本拆成 MiniMax H3 可渲染嘅分鏡,主打情緒表演真正落到畫面。佢直接指出:同一格塞太多表情指令,H3 會靜靜丟棄。

Repository image for phileiny/h3-storyboard-skill

用 H3 做有情緒起伏嘅影片,最容易撞牆嘅位通常唔係 prompt 寫得唔夠仔細,而係你貪心將太多表情塞落同一格。呢個 Claude Code 技能就係針對呢個盲點:佢唔止幫你格式化 H3 嘅 prompt schema,仲會教你點樣拆鏡頭、每格留幾多 beat、點樣導演一張臉。

核心發現來自一個對照實驗。同一個 shock beat、三次跑、同一粒 seed、同一批 reference 圖,只改動鏡頭結構:A 方案係一格 7 秒 close-up 塞 9 個表情指令,結果臉完全唔郁,PSNR 高達 37–42 dB,即係畫面接近凍結;B 方案拆成三格 2–3 秒、每格一個 beat,PSNR 跌到 22–23 dB,所有 beat 都落到;C 方案喺 B 基礎加返 <d> 對白標記,PSNR 再降到 19 dB,但代價係鏡頭時間被 H3 重新分配,背景角色連門一齊被裁走。結論好直接:開工前先數 beat,超過兩三個就要拆鏡頭。

另一個值得留意嘅細節係「唔好寫乜都唔變」。H3 對靜態描述容易洩漏到成個鏡頭,想表達 pause 就交俾剪接手。尺寸同距離方面,佢建議用相對關係(畫面三分二高、離底部一手寬)而唔係絕對數字,否則渲染出嚟會走樣。形狀就靠 reference 圖頂住,純文字三次都搞唔掂一個 1.75:1 嘅窗框。

需要用 H3 拍敘事短片、廣告 storyboard、或者任何要精準控制表情嘅創作者。比起坊間只做翻譯嘅 H3 技能,呢個項目多走一步:佢承認有啲規則只係推論(effect 係真實嘅,cause 仍未隔離),全部齊齊整整列喺 SOURCES.md 分做 verified、partly verified、inferred。

  • 屬於工具類 Claude Code 技能,解決 H3 prompt 表情指令被靜默丟棄嘅問題
  • 對照實驗證明分鏡頭係恢復情緒表現嘅關鍵機制
  • 對白標記唔會令臉郁,只會改變 H3 對鏡頭時間嘅分配
  • 距離用相對關係、形狀靠 reference 圖,純文字描述容易失效
  • SOURCES.md 將規則分三級誠實標註,邊個有控制實驗支持一目了然
GitHub

Categories: 開源, ComfyUI, Anthropic, MiniMax, Skill 技能

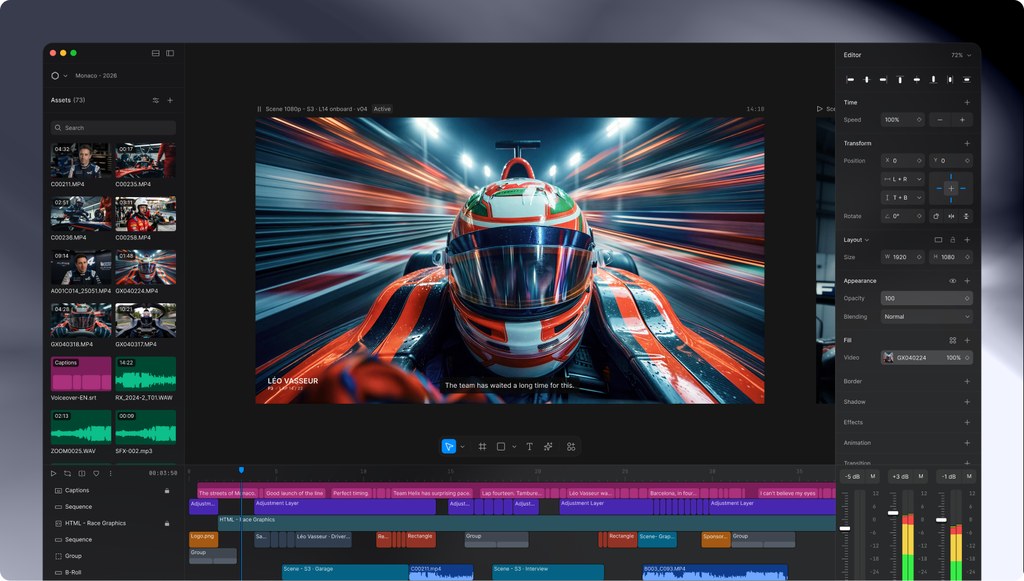
Diffusion Studio:智能影片剪輯工作流

Diffusion Studio 將時間軸剪輯與 SolidJS 程式碼互相同步,讓 AI agents 可以直接協助製作影片。

Diffusion Studio

想用自然語言叫 AI 整理素材、剪出精華片段,甚至加入動態圖像和旁白,Diffusion Studio 提供了一條由命令列控制影片編輯器的工作流。它屬於開源影片編輯工具,核心是以 SolidJS modules 作為文件來源,處理由原始片段到成片的剪輯、合成和影片理解。

畫布與程式碼可以雙向修改:在畫布調整內容,變更會寫回程式碼;直接編輯程式碼,影片畫布亦會重新繪製。配合 dapi CLI,Claude Code、Codex、Cursor、Copilot 或 Gemini CLI 等 agents 能以文字指令操作時間軸,亦可要求系統摘要影片、搜尋場景,或找出附有時間戳的引述。

  • 影片剪輯、Motion graphics、社交平台短片重製
  • 以程式碼宣告圖片、影片和 voiceover,再合成到時間軸
  • 由命令列觀看及聆聽素材,交由 agents 協助處理
  • 可在 macOS Apple Silicon 使用桌面版本,並透過 skills 接入工作流

相比只在時間軸介面操作的編輯器,程式碼成為可保存、修改和交給 agents 處理的文件來源,較適合需要重複產出、批量改版或以生成式資產組成影片的團隊。代價是使用者要同時理解畫布、SolidJS modules 和 CLI 的關係;項目資料亦未提供獨立性能指標或完整平台支援範圍,不能單憑介紹判斷長片剪輯效率。

Diffusion Studio 連接 AI agents 之後可透過程式碼與影片時間軸進行編輯。內容創作者可先下載 macOS Apple Silicon 版本,再安裝官方 skills,透過自然語言要求建立影片,並在畫布中檢查結果;熟悉編程的團隊則可直接維護可重用的影片程式碼。

GitHub

Categories: 開源, Agentic, AI productions, IDE, Mac, 蘋果, Skill 技能

[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

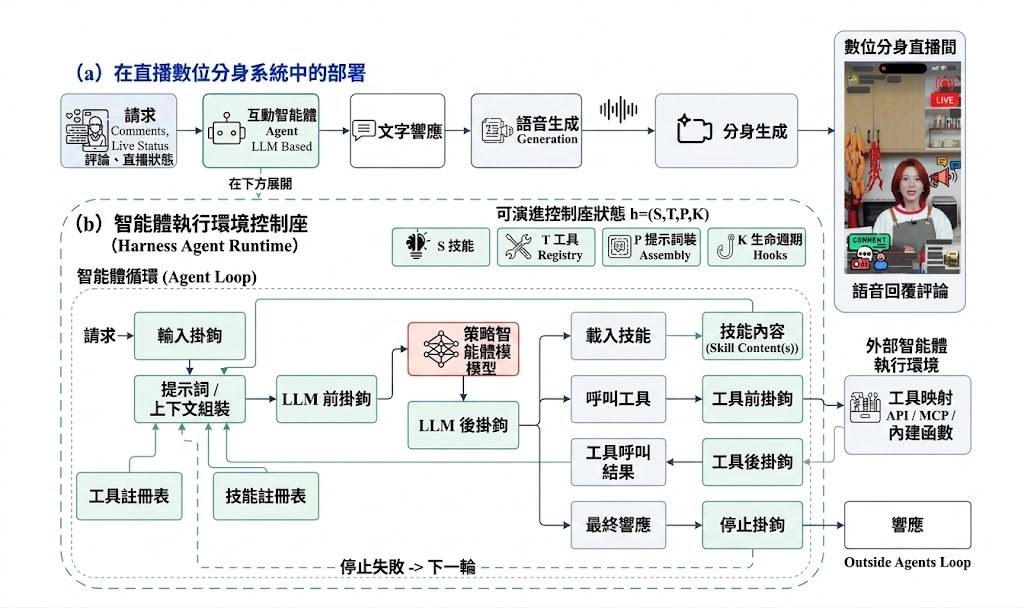
淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升

Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

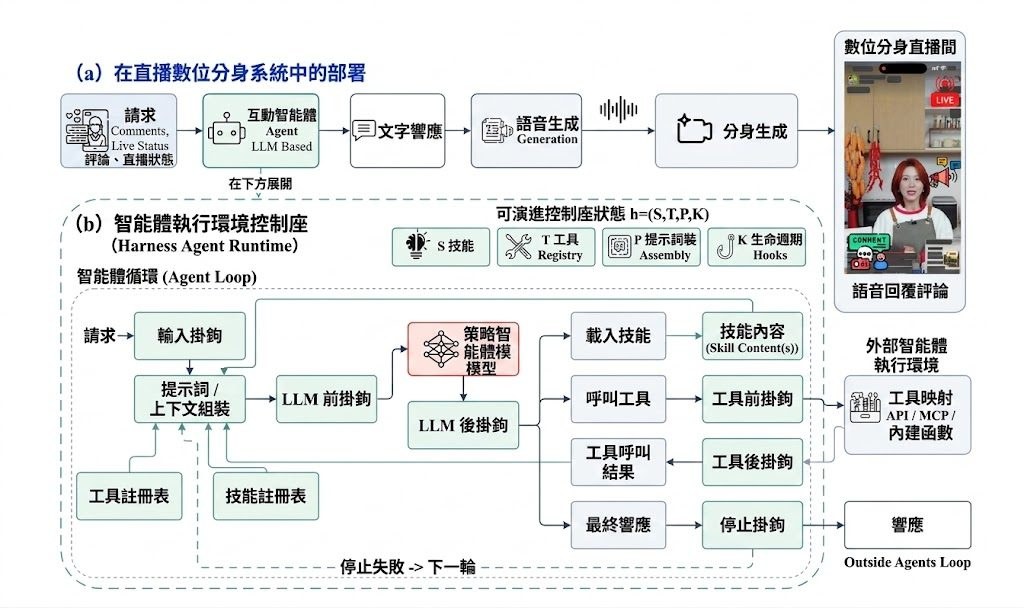
淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升

Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

VGI-Bench 揭示影片模型推理仍未可靠

影片生成模型不只要畫面合理,還要令事件按正確過程演變。VGI-Bench以27項任務測試這種能力,最高分只有51%。

Repository image for hexuan21/VGI-Bench

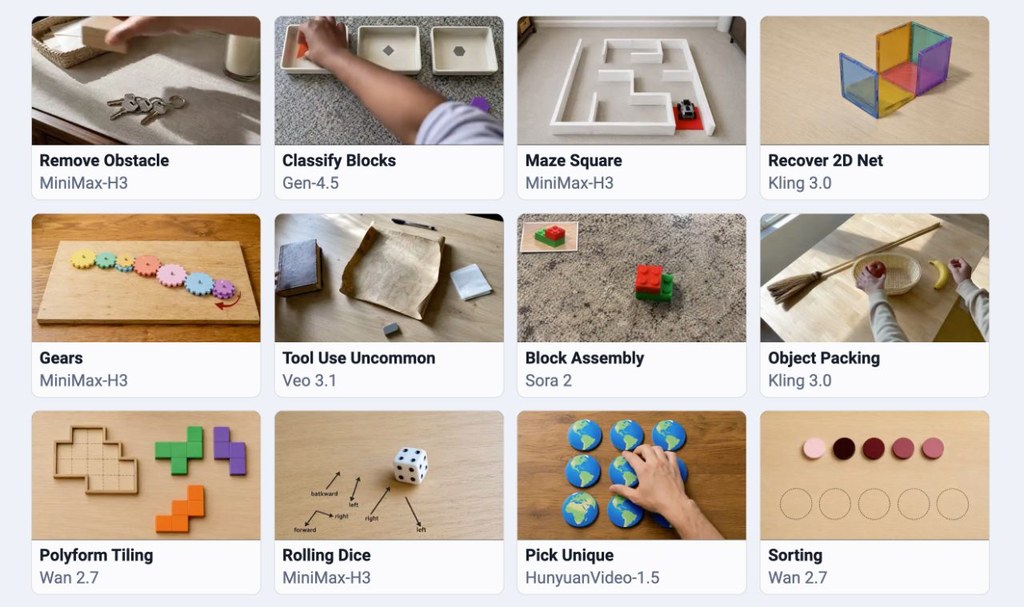
當影片生成模型要處理空間關係、時間變化、物理操作或結構謎題時,畫面好看並不代表推理正確。VGI-Bench屬於影片模型視覺推理評測基準,實際處理的是如何檢查模型能否生成符合條件、而且過程連貫的影片,而非只交出一個合理的最後畫面。

VGI-Bench包含27項任務及810個測試實例,按任務領域和 skill tags 分成兩層分類,並設有 easy、mid、hard 三個難度級別。測試輸入盡量貼近現時影片模型熟悉的視覺先驗,同時要求輸出反映有效的 evolving process;評分採用 rubric score × completeness score,兼顧答案是否正確及是否完成要求。

結果反映模型能力仍有明顯缺口:Seedance 2.0以51.0%取得最高總分,在 Visual Organization、Spatiotemporal 和 Physical Manipulation 領域領先;MiniMax-H3則以50.6%在 Structured Puzzles 領先。Sora 2、Gen-4.5、Wan 2.7及Veo 3.1等模型亦被納入比較,方便分辨影片品質與視覺推理能力之間的差距。

  • 生成畫面合理,不等於推理過程正確
  • 覆蓋視覺組織、時空推理、結構謎題及物理操作
  • 最高總分只有51.0%,可靠性仍不足
  • 分析涵蓋輸出失敗模式及輸入條件敏感度
  • 去噪後期主要修整早期假設,未必能修正推理錯誤

研究團隊亦檢查 synthetic fine-tuning 的性能轉移邊界,並從 internal denoising 角度分析模型如何修正答案。結果指向有限的 self-correction:後續步驟多數是在完善早期假設,而不是重新推翻錯誤推理。這個基準較適合影片模型研究團隊、模型供應商及需要比較生成式視覺推理能力的評測項目;GitHub資料提供 project page 及 Hugging Face Data & Res 連結,但所給資料沒有列出安裝步驟或完整測試流程,不能直接假定可下載後即時重現。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型訓練, Robotic, Dataset 數據集, MiniMax, Skill 技能

Comfy-mcp:讓 AI 直接操控本地工作流

Comfy MCP 把本地 GPU、模型與自訂節點交給 AI 管理,令 ComfyUI 工作流可以用自然語言建立、執行及修改。

Comfy

由 MiniMac Code、Claude、Cursor、Codex 等 AI agent 用自然語言建立並執行本地 ComfyUI 工作流,正是 Comfy MCP 提供的核心能力。它屬於 Model Context Protocol(MCP)伺服器,透過 comfy-cli 連接使用者自己的 ComfyUI,處理模型、節點、工作流與輸出圖片之間原本較繁複的操作。

使用者需要先有本地 ComfyUI 及 Python ≥3.10,再把 Comfy MCP 設定到支援 MCP 的客戶端。連接後,AI 可以讀取目前安裝的節點、自訂節點、模型及 GPU,搜尋可用模板,驗證工作流圖表,修改模板欄位,提交非同步工作,監察、取消工作,以及收集輸出的 PNG 檔案。

它和只依賴固定模型目錄或靜態工作流範例的做法不同,會按本機真正載入的內容作判斷,亦能在下載模型前檢查硬件是否有足夠能力。這減少了模型版本、節點依賴和顯存不相容帶來的失敗,但生成速度、可用模型和成功率仍然取決於 GPU、ComfyUI 安裝狀態、自訂節點及工作流本身;項目資料未提供統一基準測試數據。

較適合經常製作影像或影片工作流、需要反覆試驗模型的創作者,以及想把本地 GPU 納入 AI agent 流程的開發團隊。Comfy Cloud 與本地連線可以同時使用,代理可按硬件和任務需要選擇位置,形成雲端彈性與本地模型控制之間的折衷。

  • 自然語言操作:建立、編輯、驗證及執行 ComfyUI 工作流。
  • 讀取本機環境:辨識 GPU、模型、模板及包括自訂節點在內的已載入節點。
  • 完整工作管理:支援提交、等待、監察、取消及讀取失敗結果。
  • 本地與雲端並用:同一個 MCP 連線可按任務需要配合兩種環境。

項目主頁 · GitHub · Skills

Categories: 開源, ComfyUI, Agentic, AI productions, MCP, IDE, Python, Skill 技能

video-shotcraft:電影感產品影片工作室

video-shotcraft 把產品頁面、動態分鏡和聲效製作串成一條工作流,協助 Claude Code 或 Codex 產出更完整的宣傳影片。

video-shotcraft logo

由產品頁面出發,video-shotcraft 會交由 Claude Code 或 Codex 組織分鏡、動畫及聲音設計,再以 Remotion 製作宣傳、發布或示範影片。這個項目屬於 AI agent skill,實際處理的是產品影片製作中截取畫面、安排鏡頭、配合節奏剪接和加入聲效等繁複工序。

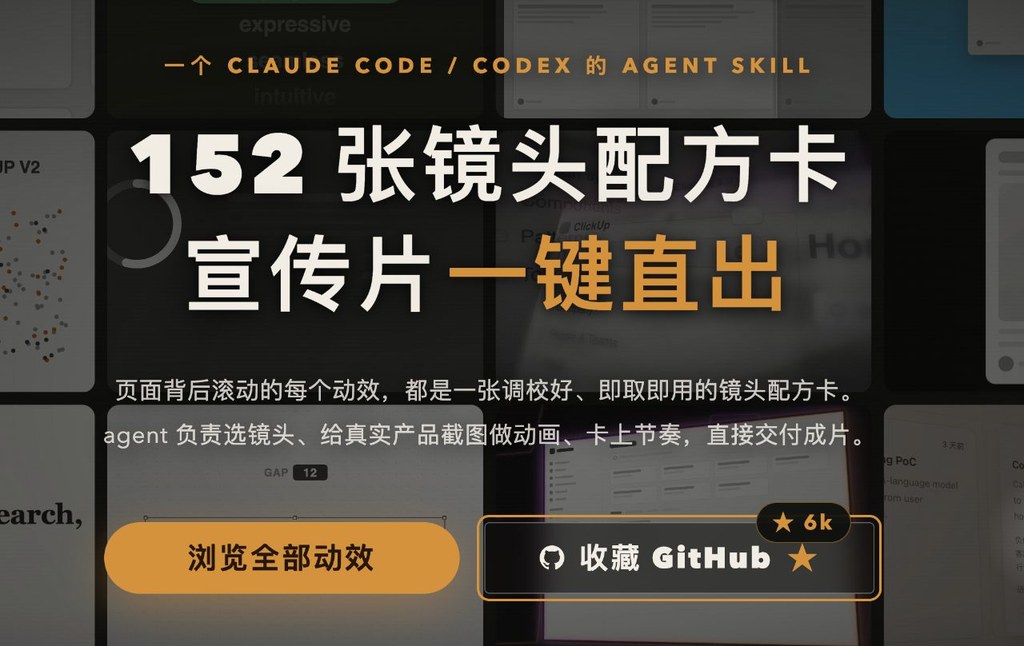
畫面不只依賴抽象動畫,工作流包括真實頁面擷取、2.5D camera moves、beat-synced cuts,以及電影感 SFX。152 張 shot recipe cards、209 種 style 和 209 個 motion previews,讓創作者可按產品內容挑選鏡頭語法,再由 native Remotion components 組合成片;元件以 normalized progress t 驅動,並可替換 ACCENT 顏色。

適合需要頻繁製作產品發佈片、marketing video 或 demo video 的設計師、創業團隊及內容製作人。它把分鏡規劃和前端式動態設計交給代理處理,換來較完整的自動化流程,但影片質感仍取決於產品頁面素材、提示內容及人工修訂;提供的資料亦未交代具體安裝步驟、所需帳戶或完整輸出流程。

品質控制來自對候選動作進行八輪逐幀檢視,並與參考片段比較後整理成 recipe cards。README 亦列出完成交付後可輸出可編輯的 JianYing(CapCut CN)草稿,方便按 shot 重新剪接、調速、排序、調色及重建字幕軌道,但相關功能的可用條件仍需以項目最新文件為準。

  • 素材處理:支援真實產品頁面擷取,而非只靠預設圖形。
  • 動態語法:涵蓋 2.5D 鏡頭、節拍剪接和 SFX 配搭。
  • 內容庫:提供 152 張 shot recipe cards、209 種 style 及 209 個預覽。
  • 輸出彈性:以 Remotion 元件組成影片,並列出 JianYing 可編輯草稿匯出能力。
  • 使用限制:目前資料不足以確認安裝、模型依賴和完整執行要求。

GitHub

Categories: 開源, Agentic, AI productions, OpenAI, Video, Anthropic, Dataset 數據集, Skill 技能

demystify-agent-skills:Agent Skills 點樣幫到代理,又會喺邊度失手

呢個研究項目唔係再做一個新 agent,而係拆解 Agent Skills 真正幫緊乜、又會喺邊一步開始失靈。這項目讓你會更易判斷技能封裝值唔值得放入自己嘅自動化流程。

Offline retrieval precision

當你想將一段成功經驗整理成可重用指引,最麻煩唔係有冇記錄,而係代理之後會唔會真係拎啱、用得啱。demystify-agent-skills 係一個研究型程式碼項目,圍繞 Agent Skills、Workflow Memory 同 raw trajectories 做受控比較,集中處理代理經驗應該點樣封裝,先至更有機會幫到後續任務。

佢吸引嘅地方不只是話「技能有用」,而係拆開幾層去驗證。相同來源經驗同相同目標任務之下,Skill 成功率有 61.9%,高過 Workflow Memory 嘅 55.9%,差距係 6.06 個百分點;但增益主要來自 procedural anchoring,佔 65.7%,唔係靠明示成功或失敗標籤去灌輸知識。

  • 同一批 agent trajectories 會被整理成 raw、Workflow Memory 同標準化 SKILL.md,再放返去同一類 target tasks 測試
  • retrieval、agent selection 同 real execution 係分開檢查,唔當成單一路徑
  • skill pool 由 5 增加到 100 時,embedding top-1 precision 由 88.3% 跌到 76.9%
  • parsed actual-use precision 會由 29.6% 進一步跌到 3.3%,但 downstream success 仍大致維持喺 36% 至 39%

「識得檢索」同「真係用對技能」原來係兩回事。項目指出 invocation 本身會帶來新失敗邊界:Skill 案例入面,有 10.0% 係誤用或者忽略技能指引,明顯高過 Raw 嘅 0.8% 同 Workflow Memory 嘅 0.4%。換句話講,技能格式改善咗執行穩定度,卻同時引入另一個決策風險。

呢個項目較適合研究 Agentic workflow、做 AI agent 評測,或者想建立可重用 skill library 嘅團隊重現。並非安裝一個即用產品,而係沿住 raw traces、matched artifacts、retrieval diagnostics 同 target task evaluation 去重跑實驗;對正在設計 Computer-use agents、CUAs 或其他多步代理流程嘅人,呢份分析比單看總成功率更有參考價值。

項目主頁 · GitHub

Categories: 開源, Agentic, Embedding, 庫, Skill 技能

HarnessEval-W 讓世界模型評測留下可核查推理鏈

世界模型評測不再只給一個分數,HarnessEval-W把每次判斷拆成可追溯的證據樹,讓物理與因果錯誤更容易核對。

HarnessEval logo

當世界模型生成一段互動場景,真正難判斷的往往不是畫面是否漂亮,而是物理、因果和世界狀態有沒有隨行動正確演變。HarnessEval-W 屬於開源的 agentified benchmark,實際處理的是如何把這些需要理解上下文的評測工作,轉化成可檢查、可重現的判斷流程。

它借用 Large Language Model(LLM)生態常見的 harness 思路,先按每個 evaluation case 的初始世界、action 和 probe intent 分解問題,再由具備不同工具與上下文的 specialized sub-agents 分工判斷,最後由 parent agent 驗證證據並整合 verdict。每次評測都會留下 evidence tree,記錄測試內容、視覺依據和完整推理鏈,研究團隊可以追查分數由何而來,而不是只接受一個難以解釋的 scalar score。

  • 支援 330 個 evaluation cases、5,940 次 scored rollouts
  • 以 11 個 specialized evaluation skills 覆蓋品質、轉換與持續性
  • 涵蓋 18 個 world models,並提供 leaderboard 與可執行評測程式
  • 包含 harnesseval-metrics,以及 physical-plausibility backend harnesseval-pavrm

HarnessEval-W 在 intentional transition 上與人類 Bradley–Terry ranking 的 Spearman correlation 為 0.93;physical transition 的 pairwise accuracy 達 71.7%,高於 WBench 的 31.9%。重複評測的結果範圍亦較 WBench 窄 4.9 倍,但這些數字仍取決於案例設計、技能路由和代理判斷品質,不能直接視為所有世界模型任務的通用排名。

項目提供固定 plans、benchmark 資源、metric backends 和可延伸的 skill library;團隊可以先重現既有 cases,再提交新世界、新 action、新 probe family 或新 skill。它較適合研究世界模型、建立可審計評測流程,或需要比較物理合理性與狀態持續性的團隊;對只想快速取得單一分數的測試流程而言,完整證據樹會增加運算與整合成本,但換來更清楚的錯誤定位能力。

項目主頁 · GitHub

Categories: 開源, 北京大學, Agentic, 世界模型, 庫, Dataset 數據集, Skill 技能

ClawGym:為 Claw 類代理搭建可訓練環境

ClawGym 讓本地、帶狀態的工作空間可用來合成資料、訓練代理同評估表現。你可以把它理解成一套面向 Claw-style personal agents 的研究與實驗框架。

Og image

ClawGym 把原本分散的代理開發流程收攏到同一個工作框架內,重點是處理本地、帶狀態工作空間中的任務生成、訓練同評測。對做 agent 研究或想驗證 Claw-style personal agents 的人來講,佢解決嘅唔係單一模型能力,而係點樣有系統咁建立可重複的實驗流程。

它嘅做法唔係只提供一個執行環境,而係同時涵蓋資料合成、agent 訓練同 benchmark 評估。令研究者可以用同一套基礎去跑不同任務,再睇代理喺有狀態工作空間入面表現有幾穩定。

幾個重點值得留意:
– 針對 local、stateful workspace,適合需要保留上下文同操作痕跡的任務
– 同時涵蓋 synthesized data、training 同 evaluation,減少流程分散
– 聚焦 Claw-style personal agents,而唔係泛用式聊天代理
– 已釋出 ClawGym-Bench 同 ClawGym-SynData,方便做對照測試同資料實驗

從公開資訊睇,ClawGym 亦一路延伸到更大範圍的 RL on general agent tasks,甚至可以透過 OpenClaw、Claude Code 呢類較複雜的 black-box agent harness 去做統一訓練。對想比較不同 agent 工作流、或者研究黑箱代理強化學習的人,佢提供咗一個較完整的基座。

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, 軟件, Medical醫學, 安全, OpenClaw, 中國, Dataset 數據集, Skill 技能

Page 5 of 9
1 … 3 4 5 6 7 … 9