yomado:給 Agent一個虛擬螢幕

yomado 讓 Agent 在虛擬螢幕操作 Blender、Marvelous Designer 等桌面程式,毋須為每款應用另接 MCP。實體屏幕可以保留給自己的工作。

yomado night-window icon

需要代理透過截圖、滑鼠和鍵盤操作 Blender 或 Marvelous Designer 時,桌面程式仍要有圖形桌面和顯示畫面。yomado 是一款 Mac 虛擬顯示器工具,讓代理使用獨立工作屏幕,毋須為每款應用另接 MCP;代理負責觀察和操作,yomado 則提供顯示空間。

它會按桌面排列顯示實體與虛擬屏幕,並在屏幕示意圖中標出應用程式。你可以拖曳圖示移動視窗,也可以手動移動;功能表按顯示器分組,並支援個別關閉視窗。隨附的 yomado skill 可引導 Codex 建立工作屏幕、移入指定視窗、確認畫面可見,並在任務完成後移回視窗。

  • 可為不同代理建立各自的虛擬屏幕,將工作視窗分開管理。
  • 可從 Finder 將正在執行的 .app 拖入,移動該應用的一般視窗。
  • 虛擬屏幕存在期間,程式會要求系統和圖形桌面保持喚醒。
  • 目前版本為實驗版,使用 macOS 14 或以上的 Apple Silicon Mac,並使用 macOS 私有 API。

這做法補足顯示空間,而非代理本身的視覺理解或操作能力;截圖、判斷和輸入仍由 Codex 或其他代理工具處理。對需要代理操作可視化介面、又想讓自己的實體屏幕保持原有工作的 Mac 使用者,分屏管理有實用價值。
項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, Google, API, Video, 工具, Mac, 蘋果, Skill 技能

Work2Skill 把人手 GUI 操作變成可重用 Agent 技能

Work2Skill 將人手操作錄成多模態證據,再整理成 Computer-use agents 可重用的工作技能。

Work2Skill overview: human GUI demonstrations, multimodal recording, action-linked evidence, agentic skill induction, an

面對陌生桌面軟件,單靠任務描述往往不足以交代按鈕位置、操作次序及完成後應有的狀態。Work2Skill 屬於 GUI 操作記錄、數據集與 Agentic skill induction 項目,處理的是如何把人手示範轉成可供 Computer-use agents 重用的程序指引,而不是另一個獨立基礎模型。

WorkRecorder 將螢幕影片、關鍵影格、滑鼠鍵盤事件及可用的無障礙資訊放在同一條時間線,讓每個動作同時保留畫面背景和介面狀態。WorkDemo-350 收錄 350 個桌面示範、約 8.48 小時錄製內容,包括 64 個 MyPCBench 任務及選出的 286 個 OSWorld 任務;AgenticSkillInduction 則提供基於 NexAU 的技能歸納範例,將流程整理成可執行時參考的技能。

它和只保存點擊座標或純文字步驟的做法不同,保留了操作前後的多模態證據,較適合處理介面改變、控制項含義不明或需要驗證結果的工作。不過,項目目前仍有清晰限制:macOS 錄製器及 Linux X11 AT-SPI 服務已提供,跨平台現場驗收仍待完成;下游評估整合亦尚未完成。

網站列出的結果以 0 至 100 分的 MyPCBench 平均分計算,四個執行模型在加入技能後最高提升 10.54 分。對需要累積桌面工作流程、研究 Computer-use agents,或希望以共同示範數據比較技能歸納方法的團隊,這套資源較有參考價值;資料集與錄製資料放在 Hugging Face,完整錄製及技能流程則要按各子目錄指南處理,原始資料未提供單一即用安裝流程。

  • 核心價值: 把人手 GUI 經驗連同畫面、輸入及介面證據保存。
  • 資料規模: 350 個示範,涵蓋 MyPCBench 與 OSWorld 任務。
  • 技術組成: WorkRecorder、WorkDemo-350 及 NexAU 技能歸納範例。
  • 主要取捨: 證據更完整,但跨平台驗收和評估整合仍未完成。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, Video, 軟件, Mac, Linux, 中國, Dataset 數據集, Skill 技能

CASE 讓 8B 模型主動尋找長期病歷證據

CASE 訓練視覺語言模型自行翻查跨時段 MRI 與臨床資料,將醫療問答由讀答案推進至主動取證。

Repository image for VinyehShaw/CASE

面對需要比較多次就診、器官變化與 MRI 切片的臨床問題,CASE 讓模型先決定應該查哪次訪視、哪個器官及哪種工具,再整理證據作答。這個項目屬於醫療多模態模型與 Agentic learning 實作,處理的是長期臨床推理中「證據未預先整理」的難題。

核心模型採用 Qwen3-VL-8B-Instruct,透過兩階段訓練建立工具使用能力:先以 RSFT 學習經篩選的教師軌跡,再以 Agentic RL 和 GRPO 讓模型根據自身操作結果修正策略。RLAIF rubric judge 負責評分,OPSD 則利用 privileged self-distillation,改善由證據走向結論的推理,而不硬性規定工具次序。

同一個 checkpoint 會按三種臨床角色工作:Anatomist 處理器官分割和體積變化,Radiologist 比較跨訪視 MRI,Consultant 則綜合影像、體積、MedGemma 報告和 skill memory。工具預算由 4 至 12 次不等,反映不同任務在查證深度與成本之間的取捨。

  • 以 UK Biobank 4,739 名參與者建立 50,401 條縱向臨床問題
  • 訓練資料包含 147,434 條 frontier-model 互動軌跡
  • 在匹配條件下,Qwen3-VL-8B agent 的答案準確率較 GPT-5.4 高逾 16%,較 Claude Opus 4.8 高逾 10%
  • 適合研究醫療 agent、MRI 分析及跨訪視證據整合的團隊

項目提供 Docker 環境,但執行預設需要 8 張 GPU、運行時可用的 gcc、另行下載 Qwen3-VL-8B-Instruct 權重,以及供 RL rubric judge 使用的 OpenAI-compatible API key。資料須透過 UK Biobank Showcase 或已獲批的 UKB-RAP 申請取得;適合作為研究型項目測試,未宜直接視為可即時投入臨床的產品。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 多模態模型, 模型訓練, Qwen, API, Image, 工具, Medical醫學, Dataset 數據集, Skill 技能, 強化學習

WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

SuperNav 讓多模態模型指揮機械狗導航

由多模態模型處理找物件、按次序到訪及高層次指令,SuperNav 把導航變成可觀察、可評估的代理工作流。

SuperNav

當指令由「找出籃球」延伸至「先找打印機,再找垃圾桶」,SuperNav 以 Agentic Navigation System 的形式處理場景理解、路線行動與任務進度。項目實際解決的是機械人面對不同場景和非固定指令時,難以只靠預設導航流程完成工作的問題。

系統由預訓練多模態模型 (multimodal model) 作決策,再透過工具、task-progress tracking 和 context management 將決定轉成移動行動,不需要為導航專門微調模型。Codex、OpenCode 或 Kimi 都可作為代理執行端,任務、工具與 Skills 則透過實驗設定組合,彈性高於寫死單一路線,但結果仍會受模型判斷及工具能力影響。

作者提供 agent runtime、導航工具、Skills、實驗配方及評估工具,支援 Habitat-GS 和 AI2-THOR。測試時可先在模擬環境執行單物件、多物件和 demand-driven navigation,再查看 RGB 觀察、軌跡、tool calls、提示詞、工具結果及原生記錄;儲存庫目前沒有真實機械人驅動程式,Unitree Go2 的示範主要來自研究項目展示。

研究結果指出,SuperNav 在單物件、多物件及需求導向導航的成功率高於所比較的基線,並展示 Unitree Go2 實體部署。可留意的限制是,資料只交代高於評估基線,未提供足夠細節讓讀者單靠儲存庫重現所有真實機械人測試。

  • 適合場景: 室內找物件、依次到訪多個目標,以及較高層次的整理要求
  • 可觀察性: 即時查看 RGB 影像、軌跡和工具呼叫,完成後再檢查記錄
  • 模型關係: 多模態模型負責決策,SuperNav 負責工具協調、進度追蹤與導航執行
  • 測試範圍: Habitat-GS、AI2-THOR,並有 Unitree Go2 示範

研究團隊、具身 AI 開發者和需要比較導航代理的人,會較容易從這個開源項目受益;一般使用者則要先準備相應模型服務、模擬環境和實驗設定,不能把儲存庫直接當成已包裝完成的機械人應用。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 多模態模型, 模型訓練, Image, 提示詞, 工具, 庫, Kimi, Skill 技能

nanoMuse:跨裝置、會先徵求同意的開源個人代理

nanoMuse 將手機、電腦與網頁連成同一個個人代理,能代辦事情,也會在刪除、傳送或付款前停下來確認。

nanoMuse: an open-source personal agent for every device you own

你可以在手機交代工作,讓 nanoMuse 轉到電腦執行,完成確認時再把要求送回手上的裝置。它屬於開源個人代理項目,處理的是跨裝置協作、持續執行與高風險操作控管。nanoMuse 是獨立的社區項目,與 Meta Platforms, Inc. 無關

手機 App、桌面 App、網頁控制台和串連各裝置的 relay 放在同一個 GitHub 儲存庫,支援 Android、iPhone、iPad、macOS、Windows、Linux 和網頁。Shell、瀏覽器、MCP servers、skills,以及可透過畫面操作手機 App 和電腦視窗的 Hands,全部經 Sentinel 轉接;刪除、傳送或付款前會要求批准,代理本身不會直接執行工具。

  • Markdown 檔案可讀寫,用來描述代理身份、記憶和喚醒時機
  • App 關閉後仍可繼續工作,裝置共用同一個帳戶和對話
  • 可使用社群 relay 的免費模型額度,亦可改用自己的 key
  • relay 能在自家伺服器運行,減少資料離開住所的需要

和 Muse、OpenMinis 的比較:nanoMuse 明確沿用 Meta Muse 式的個人代理方向,但把手機、桌面、網頁、relay 和安全批准機制一併開源。Android、Windows、macOS 和 Linux 有下載版本,iPhone、iPad 則透過 TestFlight beta。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 框架, 工具, Mac, Linux, 庫, 安全, Meta, 免費試用, 中國, 蘋果, Skill 技能

RealtimeWAM 讓世界動作模型走向即時生成

LightX2V 的 RealtimeWAM 以單步生成降低延遲,嘗試保留多步模型的表現,讓機械人動作反應更接近即時。

Og image

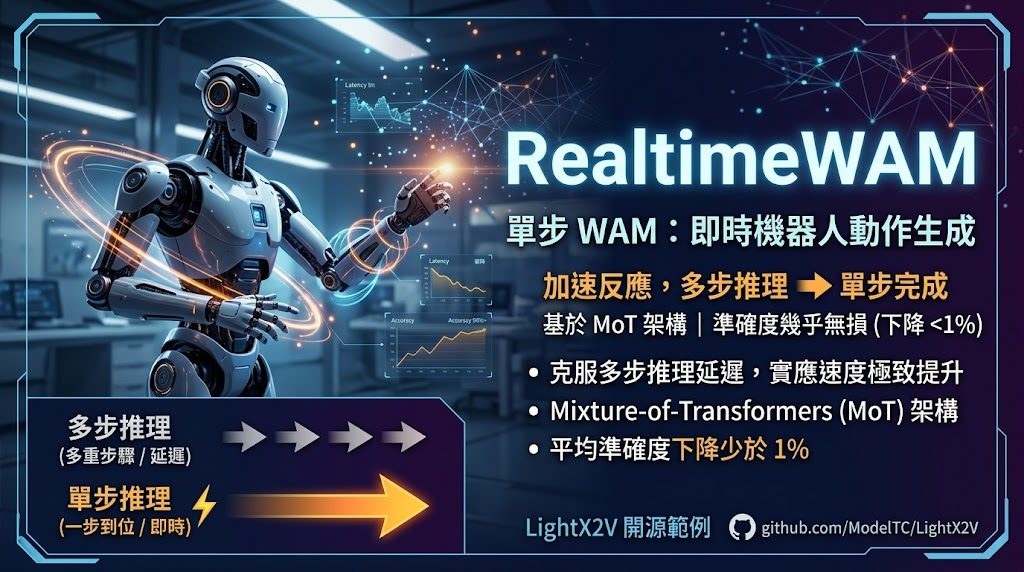
機械人需要根據畫面快速產生下一個動作時,多步推理帶來的延遲會直接影響反應速度。LightX2V 的 RealtimeWAM 範例針對這個取捨,提供面向即時推理的 World Action Models (WAM) 方法,將動作生成壓縮至單步完成。

RealtimeWAM 建立在 Mixture-of-Transformers (MoT) 架構的 WAM 之上,主張在減少推理步驟的同時,盡量維持原有模型的準確度。項目 README 將它描述為首個單步 WAM,並指出相較多步版本,跨多個基準測試的平均準確度下降少於 1%。

項目列出的測試包括 RoboTwin 2.0 和 LIBERO,涵蓋機械人操作相關場景。這代表它較適合需要低延遲動作決策的研究者、機械人控制工作流,以及希望在既有 MoT-based WAM 架構上探索即時生成的開發者;不過,實際效果仍會受模型、硬件和測試任務影響。

  • 單步生成,降低多步推理造成的延遲
  • 兼容以 Mixture-of-Transformers 為基礎的 WAM 架構
  • README 聲稱平均準確度下降少於 1%
  • 提供 RoboTwin 2.0 和 LIBERO 等評估參考
  • 以 LightX2V 框架形式呈現即時 WAM 範例

項目主頁

Categories: 開源, Agentic, MCP, 模型, 世界模型, World-Action Model, Robotic, 框架, 安全, Skill 技能

MotorMind-Code:通用視覺語言模型零樣本操控機械人

MotorMind 讓通用視覺語言模型透過中階動作控制機械人,並用即時回饋檢查進度、修正失誤。它在模擬環境和真實機械人上測試,毋須針對任務訓練策略。

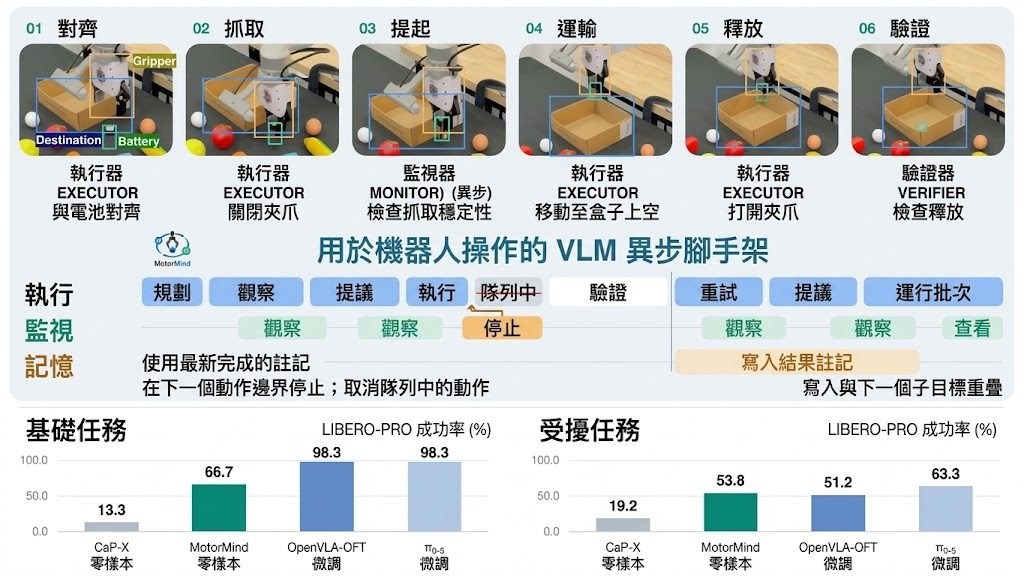
MotorMind overview: robot execution frames, asynchronous monitoring, and manipulation results

要令機械人按指示完成操作,模型不只要看懂畫面,還要判斷下一步、確認動作有否奏效。MotorMind 是一個機械人操控研究項目,讓凍結的通用視覺語言模型(Vision-Language Model,VLM)提出中階動作,再由執行框架把決策交給機械人,並以量度到的回饋檢查結果;過程不需針對特定任務訓練策略。

模型不會一次過決定整個操作流程。MotorMind 會並行監察機械人執行情況,確認子目標是否完成;若觀察到的結果不符預期,便可修正動作、恢復執行或重新規劃。這種做法把 VLM 的推理與機械人控制接起來,但不依賴專用動作專家、技能 API 或動作規劃工具。

項目在 LIBERO-PRO 模擬環境及 xArm6 真實機械人上測試,亦以 240 條視覺問題評估模型選擇動作、判斷進度和確認子目標完成的能力。評估結果指出,動作選擇是各模型較難處理的部分;因此,即使加入持續監察與結果核實,也不能視為每次都能正確控制機械人。

現時 GitHub 儲存庫尚未提供程式碼或執行指引,項目預告會在 10 月 15 日前發布程式碼。目前可先參考研究介紹及其模擬、真機測試結果,待程式碼和設定方法公開後,才適合自行重現或接駁機械人。

  • 不需為特定操作訓練專用策略,改以通用 VLM 提出中階動作。
  • 執行期間持續核對觀察結果,支援修正、恢復及重新規劃。
  • 測試涵蓋 LIBERO-PRO 模擬環境與 xArm6 真實機械人。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, Robotic, 框架, 工具, 庫, Skill 技能

lanshu-create-ai-presenter-video:數字人影片 Skill:一張圖+文案自動生成完整講解影片

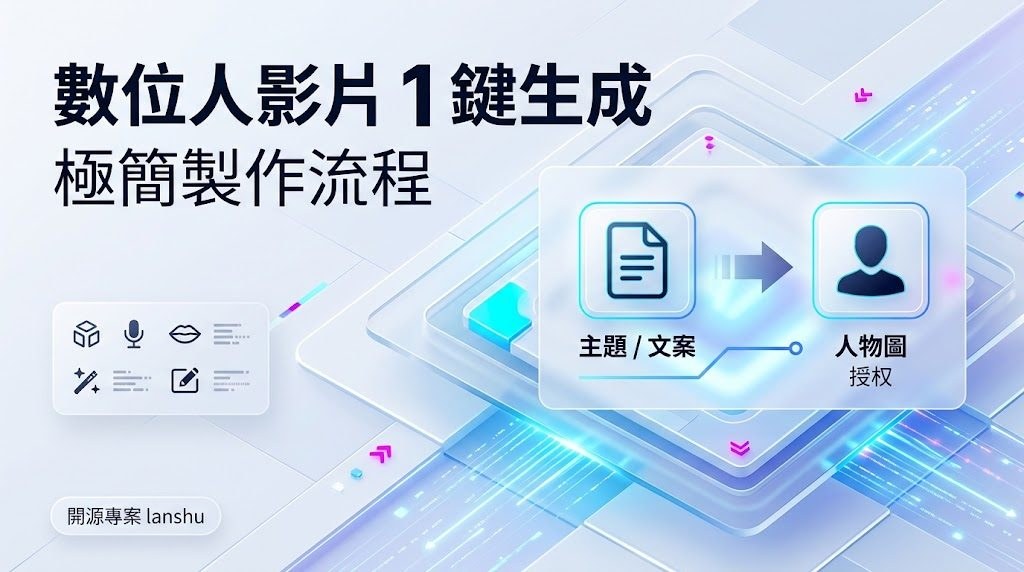
一個針對通用數字人影片製作 Skill。你輸入主題或文案,再加一張授權人物圖,它就會按完整配音時間軸組織生成、剪輯同驗收,輸出一條可發佈嘅講解片。

Repository image for cclank/lanshu-create-ai-presenter-video

做數字人講解片最麻煩嘅地方,往往唔係生成人物,而係口型、文字同聲音對唔齊,最後剪埋一齊就甩拍。lanshu-create-ai-presenter-video 嘅切入點正正喺呢度:佢將「完整配音」鎖定為全片時間基準,人物主素材、字幕、關鍵詞動效同鏡頭轉場都跟住呢條音頻排,從而減少口型漂移同片段接駁嘅問題。整個項目屬於 Agent Skill 工具,由 Codex 或其他兼容本地 Skill 嘅 Agent 環境直接調用,源碼本身唔綁定任何特定服務商、模型或私有接口,可以按當前環境可調用嘅能力動態選擇配音、人物生成同口型同步工具。

最低門檻只需要一份主題或文案,再加一張已授權、包含清晰成年人物嘅參考圖。聲音樣本、屏幕錄影、B-roll、品牌素材、目標平台、時長、橫豎屏同風格等都係可選輸入,畀進階用戶調整。Skill 目錄會隨階段讀取對應參考文檔:generation.md 處理文案、聲音、能力選型同人物提示詞;editing.md 負責時間軸、字幕預設、封面同導出;qa-recovery.md 處理技術驗收、人工驗收同常見故障修復,避免一次過佔用過多上下文。

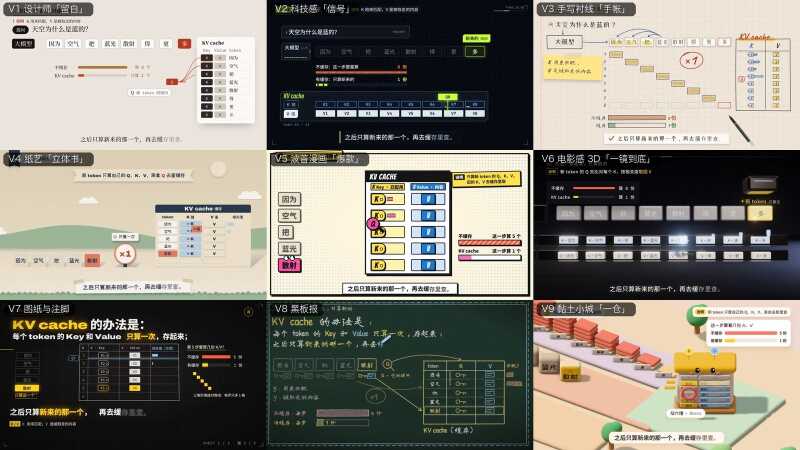
key名称the look · 画面best for · 适合3D
v1-editorialV1 设计师「留白」warm paper, ink, one vermilion accent, data blocks, page turns · 暖白纸、墨色、一抹朱红,大留白serious, premium explainers; business and product topics · 严肃、高级感、商业与产品no
v2-signalV2 科技感「信号」dark HUD, acid-lime accent, labels decode in, packets on wires, glitch cuts · 暗色仪表盘、荧光绿、数据包流动AI / infra / networking, anything “system-like” · AI、基础设施、网络、系统类no
v3-notebookV3 手写衬线「手帐」grid paper, a live pen writes every word, sticky notes, eraser · 方格纸上真笔书写、便利贴、橡皮擦teaching step by step, derivations, study notes · 一步步推导、学习笔记、教学no
v4-paperV4 纸艺「立体书」kraft pop-up book, pieces fold up with soft shadows, parallax · 牛皮纸立体书、折起的纸片、视差warm stories, processes, consumer topics · 有温度的故事、流程、大众话题no
v5-comicV5 波普漫画「爆款」halftone comic page, stickers slam on, bursts and sound words · 半调网点漫画、贴纸拍入、爆炸字punchy short videos, hot takes, myth vs fact · 节奏快的短视频、观点、辟谣no
v6-cinematicV6 电影感 3D「一镜到底」Three.js one-take in a graphite studio, porcelain props, bloom · 一镜到底的 3D 影棚、瓷质道具、辉光flagship pieces, launches, big-picture concepts · 旗舰内容、发布、宏观概念yes
v7-draftingV7 图纸与注脚one black drawing sheet, leader lines, ghost-letter karaoke, true footnotes · 黑色图纸、引线、注脚、卡拉OK式大字technical deep dives for practitioners · 面向从业者的技术深挖no
v8-chalkboardV8 黑板报a wooden blackboard written live in chalk, felt eraser, chalk mind map · 木框黑板、粉笔现写、板擦、粉笔脑图复习classroom feel, beginners, memory-friendly recaps · 课堂感、入门、便于记忆no
v9-clayV9 黏土小城「一仓」an isometric plasticine town, every analogy labelled with its real term · 等距黏土小城,比喻 + 真实术语标签analogies for non-experts, cute and friendly · 用比喻讲给外行、可爱亲和yes

預設輸出係 9:16、1080×1920、30fps 豎屏,時長 45 至 75 秒,發佈響度目標約 -16 LUFS。初始化可透過 init_job.py 自動建立標準任務目錄同 job.json,preflight.py 會做前期檢查,最後由 finalize_delivery.sh 收尾輸出,同時產出 QA 報告。環境要求 Python 3.9+、FFmpeg/ffprobe、Bash、jq、awk、sed,以及至少一種可調用嘅影片生成、語音生成同口型同步能力。

佢唔係一個獨立嘅模型,而係一套組織數字人影片工序嘅 Skill 框架,價值在於把配音、人物、字幕、剪輯、驗收等步驟統一在同一條音頻時間軸上,避免最常見嘅口型錯位同片段斷裂。內容創作者、行銷團隊、課程錄製同需要快速產出講解影片嘅場景會較受惠,特別係想喺不同 AI 服務商之間靈活切換、又唔想被單一平台鎖死嘅人。

  • 以完整配音為全片時間基準,減少口型漂移同片段接駁問題
  • 源碼不綁定服務商或模型,可按環境動態選擇配音、人物、口型工具
  • 三份參考文檔按階段讀取,控制上下文用量
  • 預設 9:16 豎屏、1080×1920、30fps、主題片長 45–75 秒
  • 支援聲音樣本、B-roll、品牌素材、平台、橫豎屏等可選參數

GitHub

Categories: 開源, Agentic, AI productions, 數字人, Video, Audio, 提示詞, 框架, Content Creator, Python, 語音, Skill 技能

XGEN-JING 世界模型開源:邊走邊生成影片與音效

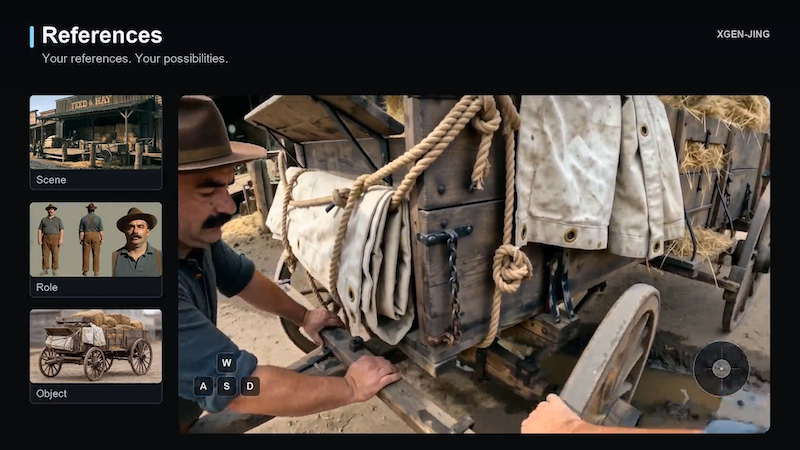
XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

Page 3 of 9
1 2 3 4 5 … 9