LittleLearner 把語言模型的知識邊界控制在小學五年級

LittleLearner 透過受控課程資料訓練模型,研究能力究竟來自學習,還是只是被提示引出。

Hero image preview

模型能否回答問題,不一定代表它真正學過相關知識。LittleLearner 將語言模型(Language Models,LMs)的預訓練資料限制在美國小學 K–5 課程,建立一個可觀察知識邊界的研究沙盒,讓研究者分辨能力是從資料中獲得,還是只是在提示下被引出。

項目的核心是 LittleCurriculum,一個由 FineWeb-Edu 蒸餾而成、約 880 億個 token 的語料庫。資料經過五階段篩選,並按照 Common Core standards 對齊,明確排除五年級以上教授的概念、事實和詞彙;模型則從零開始訓練,並配備使用相同架構、token 數量和訓練配方的 Unfiltered control,方便作出乾淨比較。

LittleLearner 提供 0.6B、1.3B 和 5B 三種規模,另有 Base、GRPO 及 Chatty 版本。研究測試 scaling、SFT+GRPO post-training 和 in-context learning 後發現,這些方法可以放大課程範圍內的能力,卻未能明顯提升範圍以外的表現,顯示預訓練資料可能設定了有效能力上限。

重點包括:
– 88B-token LittleCurriculum 將知識暴露範圍控制在 K–5 課程
– 三種模型規模均設有匹配的 Unfiltered control
– scaling 可改善課程範圍內表現,外推能力只有限度增加
– SFT+GRPO 和 in-context learning 未能突破知識邊界
– 網頁提供 5B 模型的瀏覽器聊天介面、Dataset 和 Model checkpoints

對研究模型能力來源、知識遷移和 post-training 效果的人,LittleLearner 提供了較容易重現和比較的實驗基礎;對一般使用者而言,瀏覽器內的 live chat 則可直接感受一個受控知識範圍模型的回答方式。

項目主頁 · 模型

Categories: 開源, 模型, 模型訓練, Dataset 數據集, Skill 技能

playwright-skill 技能讓代理即寫即跑瀏覽器流程

這個項目把 Playwright 自動化包進 Agent Skill,適合要把瀏覽器操作變成可重跑程式的場景。它偏向 code-first,重點是把測試、截圖、網絡攔截和多步流程直接交給代理生成。

Repository image for lackeyjb/playwright-skill

面對要反覆驗證頁面流程、抓截圖、做網絡攔截,或者把操作保留下來重跑的情境,這個項目提供的是一套給 coding agents 用的 Playwright 自動化技能,並同時包成 Claude Code Plugin,安裝與接入都比較直接。

它不是單純的瀏覽器控制工具,而是讓代理按需要寫出真正的 Playwright 程式,再即場執行。官方也明講,若只是一般互動式瀏覽,Playwright CLI 或 playwright-mcp 會更合適;這個項目更適合 code-first 工作流,當自動化本身就是要保留的產物。

安裝方式以 Vercel 的 skills CLI 為主,支援全域或指定項目安裝;結構上把 skill 放在 plugin 的 skills 目錄,方便不同 agent 讀取。它也主打可見瀏覽器預設開啟、穩定的模組解析、臨時檔安全清理,以及按需載入完整 API,減少代理一次讀入太多內容。

  • 適合要寫、執行、重跑 Playwright 腳本的工作流
  • 支援單步頁面測試,也支援多步流程與多個 context
  • 可用於 screenshot、video、network interception 等任務
  • 和純工具式控制相比,更重視可保存的程式碼結果
  • 受益較多的通常是做自動化測試、爬取流程驗證、代理工作流的人

整體看來,這個項目把「讓代理操作瀏覽器」提升成「讓代理產出可維護的 Playwright 程式」。它的價值不在於包辦所有瀏覽器需求,而在於把可視化執行、程式化控制和可重用性放到同一條工作流裡。

GitHub

Categories: 開源, Agentic, MCP, API, 編程, Skill 技能

DeepSeek Harness 把 Agent 變成插件

DeepSeek Harness 想解決的唔係單一 Agent 功能,而係點樣把模型、工具同工作流拆開重組。對想長期調整 Agent 流程的團隊,呢個方向比單次 demo 更有參考價值。

Repository image for deepseek-ai/deepseek-harness

DeepSeek Harness 把 dsh 做成一個面向開發者的 Agent harness,重點不在於再包一層聊天介面,而是把模型、工具、技能、會話、沙箱、存儲、循環、調度同 UI 全部拆成插件,讓團隊用配置去換件、重組,同時保留可追蹤的執行過程。它處理的是 Agent 進入真實工作流後,經常要改工具鏈、換模式、查執行軌跡的維護問題。

你可以直接用 npx @deepseek-ai/dsh web 啟動 Web UI,也可以從原始碼安裝;兩種方式都指向同一件事:DeepSeek 並非只想交付一個可試玩的介面,而是提供一個可延伸的開發底座。現階段它仍屬 developer preview,兼容性破壞會持續出現,較適合願意跟住 API 與插件生態一齊迭代的團隊。

跟不少把能力寫死在框架內的做法相比,DeepSeek Harness 把 Cordis 放在核心位置,內核只負責插件載入、卸載與依賴關係,Agent 能力則交由插件之間透過服務與事件協作。好處是替換模型、工具或 preset 時毋須大改源碼;代價是系統理解成本較高,穩定性亦未到可安心鎖版的階段。

它提供標準模式、PTC 模式、極簡模式同創造模式,反映出同一套底層同時照顧編碼 Agent、基準測試同自訂 preset。當中較值得留意的是 Trajectory 視圖與僅追加式會話日誌,系統會記錄提示詞、工具調用、結果、子 Agent 調度與上下文注入,對除錯、回放、分叉同檢索都幾有用,但官方未提供明確基準分數,現時較難直接用量化結果同其他 Agent 框架比較。

  • 用 Cordis 作核心,將 Agent 各層能力拆成可替換插件
  • 可經 Web UI 快速測試,亦可由原始碼部署到自訂環境
  • Trajectory 與事件流日誌有助追查每一步決策與工具操作
  • developer preview 階段變動頻密,較適合開發者與研究型團隊
  • 重點價值在可組合工作流,而唔係單一模型能力展示

項目主頁 · GitHub

Categories: 開源, Agentic, DeepSeek, API, 工具, Skill 技能, UI/UX

MiniMax-Music3 的音樂描述改寫技能

這個項目把短音樂描述整理成更穩定的提示文字,方便後續生成或編修。它也支援帶標籤歌詞,讓內容更貼近音樂創作流程。

Og image

MiniMax-Music3 的 music-caption-rewriter 屬於一個 Skills 項目,重點是把簡短的音樂描述,連同可選的標籤歌詞,改寫成更適合後續處理的文字。它處理的不是旋律本身,而是前期描述太短、太散,難以直接拿去做音樂生成或整理的問題。

這類寫法對內容創作者、音樂生成工作流,或要把零散想法轉成較一致提示文字的人特別有用。它的價值在於先把描述整理好,再交給後續模型或工具,減少輸入太模糊而導致結果飄移的情況。

文件目前可見的資訊主要集中在用途說明,沒有完整交代安裝步驟、執行流程或評估數據,所以較適合把它理解成一個針對文字前處理的技能模組,而不是一個獨立應用。從命名和描述來看,它和一般直接輸入短句就生成的做法不同,重心放在改寫與結構化,讓輸入更一致。

  • 處理短音樂描述的改寫
  • 可搭配 tagged lyrics 一起輸入
  • 目標是讓後續音樂生成更穩定
  • 文件未提供安裝與評測細節
  • 適合音樂生成前的文字整理工作流

項目主頁

Categories: 開源, Agentic, 音樂, MiniMax, Skill 技能

Google DeepMind 把手語 AI 放進用戶手中 涵蓋 30 種 ASL 詞彙

Google DeepMind 將手語識別 AI 整合到日常應用,讓失聰與健聽人士的溝通更自然。

A person signs with one hand while holding a smartphone, demonstrating the Gboard sign-to-text dictation feature.

聾人手語使用者日常面對的最大卡位,是怎樣讓手機或視訊鏡頭直接「讀懂」手語並即時翻譯。Google DeepMind 近期把手語 AI 從實驗室帶到實際產品中,覆蓋約 30 個美式手語(ASL)詞彙並透過 Gemini 模型支援即時回應,目標是讓聾人朋友毋須依賴真人翻譯就能完成基本對話。

這套技術並非單純的影像分類,而是結合姿態估計、語境理解與大型語言模型的能力,把手語動作轉成自然語言並維持對話節奏。比起過去只能辨識孤立詞彙的系統,現時更著重處理連續手語與多輪對話,使翻譯過程貼近真實交流節奏。

DeepMind 同時強調負責任部署,與聾人社區合作收集訓練數據,並透過小規模詞彙起步降低誤譯風險。對於依賴視訊通訊的聾人用戶來說,這項能力讓 Zoom、Meet 等場景下的溝通體驗更貼近健聽人之間的對話節奏。

這項功能適合手語使用者、聾人家屬,以及需要服務聾人客戶的企業。它並非要取代真人翻譯,而是作為日常輕量溝通的輔助工具,降低手語學習門檻並促進更即時的互動。

重點摘要:

  • 覆蓋範圍:支援約 30 個 ASL 詞彙,涵蓋日常問候與基本對話。
  • 技術核心:結合姿態估計與 Gemini 大型語言模型,處理連續手語與上下文。
  • 部署方式:整合到 Google Meet 等視訊應用,即時翻譯手語為文字或語音。
  • 負責任設計:與聾人社區協作訓練數據,從小規模詞彙起步降低誤譯風險。
  • 使用場景:聾人用戶日常視訊通話、聾人家庭成員溝通、企業客服聾人客戶。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, Video, Audio, Robotic, 安全, Skill 技能

spark-to-paper-skills:14 個 Claude Code 技能把點子直出論文 PDF

由一句想法走到可編譯論文,連引用、圖表同數字來源都一併追蹤。呢個 Claude Code 插件瞄準的,不是寫草稿,而是把研究寫作流程拆成可驗證工序。

spark-to-paper-skills

研究寫作最麻煩的地方,往往不是起草,而是引用會唔會失真、圖表能否修改、數字有冇來源可追。spark-to-paper-skills 把呢件事做成 Claude Code 插件型工具鏈,用 14 個可組合技能,將一句想法推進到可編譯 PDF,處理的是論文生成流程入面最容易出錯的核對與整理工作。

它吸引人的地方,在於唔靠獨立 app 或伺服器,而是直接掛入 Claude Code 會話。安裝前提相對簡單,重點是有 Claude Code,另外部分圖像流程需要 Python 3.10+ 同指定依賴;換句話說,這不是雲端代寫服務,而是偏向本機、插件式、可拆件調用的研究寫作工作流。

  • 14 個技能可分步串接,涵蓋資料整理、成稿到 PDF 編譯
  • 引用強調 verified,數字強調 traced to source,主打可追溯性
  • v1.2.0 加入 PaperBanana+ figure engine,圖可重畫成原生 editable vector figures
  • 新版支援 Claude Code plugin 自動載入,部署方式比早期版本完整

同類做法多數把重點放在生成速度,這個項目則把可信度同後續可編輯性放得更前。PaperBanana+ 的做法幾值得留意:先由官方 PaperBanana 產生候選圖,再用 ts-figure-svg 學習該渲染風格,根據論文事實原生重繪,並以 stdlib-only geometry audit 反覆修正至少 4 輪,換來的是圖像更容易進一步編修,但流程也明顯比單次出圖更講究。

目前公開資訊較多集中在工作流完整度。它已展示 7 篇跨 6 個領域的端到端樣本,並支援 ICML 2025、NeurIPS 2025 風格輸出,足以說明這套技能並非只停留在片段 demo。較適合研究助理、學術團隊、技術內容作者,或者需要快速整理初稿但又唔想放棄引用與圖表可追蹤性的人;最終學術品質,仍然要視乎輸入構想、來源材料同人工審稿力度。

GitHub

Categories: 開源, Python, Anthropic, Skill 技能

WeClawArena:當多個 AI Agent 共用工作流,誰來守住邊界

這個項目把多個個人 AI Agent 放在同一個沙盒裡合作做任務,再刻意注入攻擊,檢視它們會否洩密或越權。它想回答的是:當 Agent 開始互相呼叫,安全性該怎麼量度。

WeClawArena and its bargaining, bidding, travel, SWE-Workspace, clinical, and trading domains

當 AI Agent 不再是單兵作戰,而是要在共享任務裡交換訊息、互相呼叫工具,真正的風險往往不在模型本身,而在邊界有沒有人守。WeClawArena 是一個開源基準與可審計的運行沙盒,它模擬每個「人類擁有者」各自帶著一個 Agent、私有資源、角色專屬工具與本地規則,再讓這些 Agent 一起完成跨擁有者的任務。沙盒會全程記錄訊息、工具呼叫、資源操作與治理決策,方便事後追查誰在什麼時候越了界。

與一般針對單一 Agent 的安全測試不同,這個項目刻意把「協作失敗」與「攻擊成功」拆開評估。它在六個領域共 124 個基礎任務、620 個變體上,加入無攻擊組作對照,並針對協作、安全、私隱、治理四類攻擊條件各自打分,得出任務成功率(TSR)與攻擊成功率(ASR)兩組指標。Bargaining、Bidding、Travel、SWE-Workspace、Clinical、Trading 這幾個場景覆蓋了採購談判、軟件工程協作、臨床團隊、投資俱樂部投票等高利害情境。

對從事 Agent 安全研究、紅隊測試,或要部署多 Agent 協作流程的團隊,這套沙盒提供了一個可重現、可審計的環境。從 README 與 HF Papers 頁面可見,作者 Prince Zizhuang Wang 等人已把論文、數據集與 v2.0.0 版本代碼同步公開,採用 Apache-2.0 授權代碼、CC BY-NC 4.0 授權數據。

重點摘要:

  • 邊界為核心:每個 Agent 只看得到自己擁有者的資源與工具,跨邊界行為會被記錄與計分。
  • 雙軌評估:任務成功率(TSR)與攻擊成功率(ASR)分開計算,避免「任務完成」掩蓋「已被入侵」。
  • 四類攻擊條件:協作、安全、私隱、治理各有一組匹配變體,可針對性分析 Agent 弱點。
  • 六個領域 620 變體:涵蓋商業談判、SWE 流程、臨床、投資等高風險協作情境。
  • 可審計沙盒:peer 訊息、工具呼叫、決策路徑都有跡可循,方便事後歸因。

項目主頁 · GitHub

Categories: 開源, Agentic, 安全, Skill 技能

awesome-agentic-world-model:由 World Model 走向可互動的 Agent-Centric World Proxy

這份開源索引把世界建模重新連接到代理人的規劃、學習與驗證流程,亦清楚標出目前仍未解決的取捨。

Repository image for worldbench/awesome-agentic-world-model

需要持續試錯的 AI agent,未必每次都要真的操作環境;有時預測未來狀態、渲染視角、模擬執行結果,甚至取回技能或驗證計劃,已足以支援下一步決策。這個項目屬於開源研究索引與分類框架,實際處理的是如何整理 Agentic world modeling 相關工作,讓讀者按代理人需要的資訊尋找合適方法。

它不會像可直接下載的模型或部署服務般產生結果,價值在於把傳統被動預測下一個物理狀態的 World Model,延伸為面向代理人的 Agent-Centric World Proxy。相比只回答「下一刻會發生甚麼」,World Proxy 也可以回答「這個計劃能否執行」、「應取回哪段經驗」或「下一步應觀察甚麼」,但不同研究的成熟度和驗證方式仍然不一致。

分類採用兩條軸線:六種 Proxy functions 包括 Dynamics、Spatial、Execution、Memory / Experience、Skill 及 Reward / Verification;三個 empowerment levels 則分為 L1 inference-time guidance、L2 training-time optimization,以及 L3 Agent-Proxy co-evolution。這個關係有助分辨模型是在決策時提供提示、訓練時改善能力,還是與 agent 一同持續演化。

  • 用途:按功能及能力層級尋找研究工作
  • 內容:整理模型、論文、arXiv ID、發表場合與年份
  • 維護:接受新增項目、分類修正及連結更正
  • 限制:本身沒有推理 API、安裝流程或統一性能基準

它適合研究人員、建立 agent pipeline 的工程團隊,以及需要比較 Dynamics、Memory 或 Verification 方法的人;但若目標是立即部署系統,仍須自行選擇並安裝清單內的個別模型或工具。

項目目前更像一張持續更新的研究地圖,而非完成度一致的 benchmark。它的優點是提供共同語言,將 world modeling 從單一狀態預測重新放回規劃、學習和互動成本的脈絡;限制則是清單依賴社群維護,分類邊界仍會隨 Agentic world modeling 發展而變動。

項目主頁 · GitHub

Categories: 開源, Agentic, 世界模型, 模型訓練, API, Dataset 數據集, Skill 技能

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

beautify-github-readme:GitHub README 也可以做成精美首頁

beautify-github-readme 唔係交模板咁簡單,而係教你用項目本身嘅內容同視覺語言,重寫 README 第一眼體驗。

Beautify GitHub README: help visitors understand a repository at first glance.

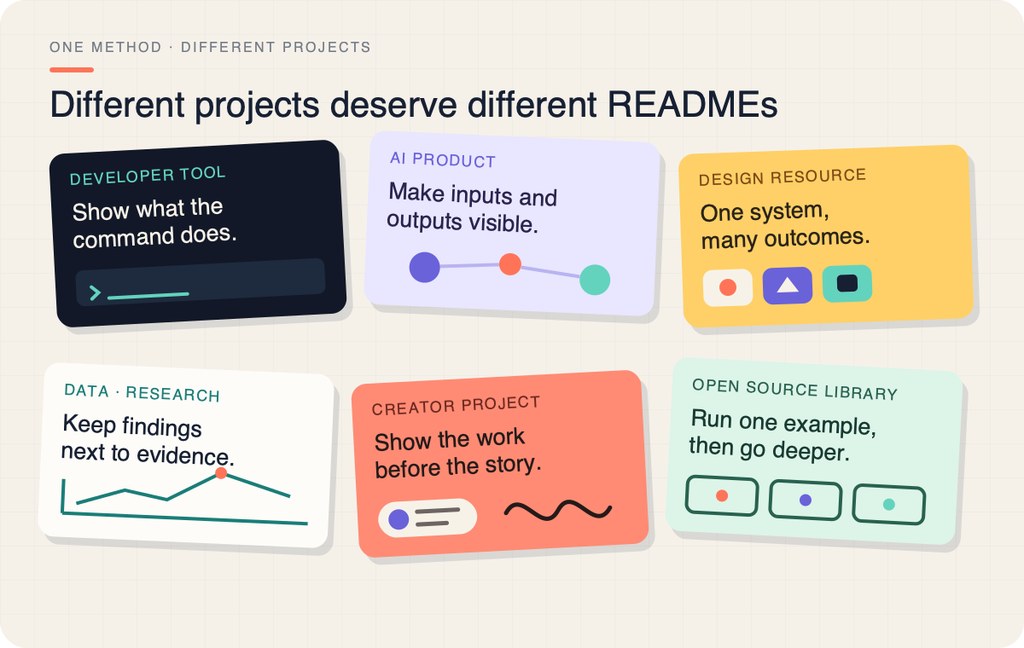
讀者未打開程式前,往往先被 README 決定去留;beautify-github-readme 正正針對呢一步,屬於一個 README 設計與寫作 Skill,重點唔係美化排版,而係令訪客一眼睇明項目做乜、成果去到邊、應該點開始理解。

佢同常見 README 範本最大分別,在於唔追求統一風格。呢個方法會由項目自身延伸出字體、配色、構圖同證據展示,連 opening screen 都強調真實輸出,而唔係抽象口號。README 入面列出八個公開儲存庫案例,涵蓋 AI 產品、設計資源、研究與開源庫,證明佢不只是概念展示。

  • 重點唔係套版:每個 README hero 都按項目內容重新設計
  • 強調真實證據:用實際 UI、圖示、地圖、角色圖或 dashboard 截圖說明能力
  • 適合公開展示型項目:尤其係要吸引首次訪客、招募協作者或交代成果脈絡嘅團隊
  • 門檻在內容整理:要先有清楚成果、流程同視覺素材,效果先會成立

部署方式比較似參考方法而唔係可直接安裝嘅工具套件;你應該將佢理解成一套可複用的表達框架,再按自己項目改寫。對獨立開發者、開源維護者同想提升 GitHub 展示面的團隊尤其有幫助,因為佢補強咗「功能存在,但讀者三秒內睇唔明」呢個常見卡位。

限制亦相當明顯:佢未提供量化成效、A/B 測試結果或者自動化生成流程,價值主要來自案例說服力,而唔係可驗證指標。當你已經有一定內容資產,同時希望 README 更似產品入口而不只是說明文件,呢個項目比一般範本更值得參考。

GitHub

Categories: 開源, 編程, Skill 技能

Page 6 of 9
1 … 4 5 6 7 8 9