EvoSkill-GUI 讓 GUI Agent 在執行中即時修正技能

浙江大學 ZJU-REAL 團隊開源 EvoSkill-GUI,毋須額外訓練,透過結構化技能包、即時修正與自我檢討機制,讓 GUI Agent 在 MobileWorld、AndroidWorld、OSWorld 三個基準上明顯提升成功率。

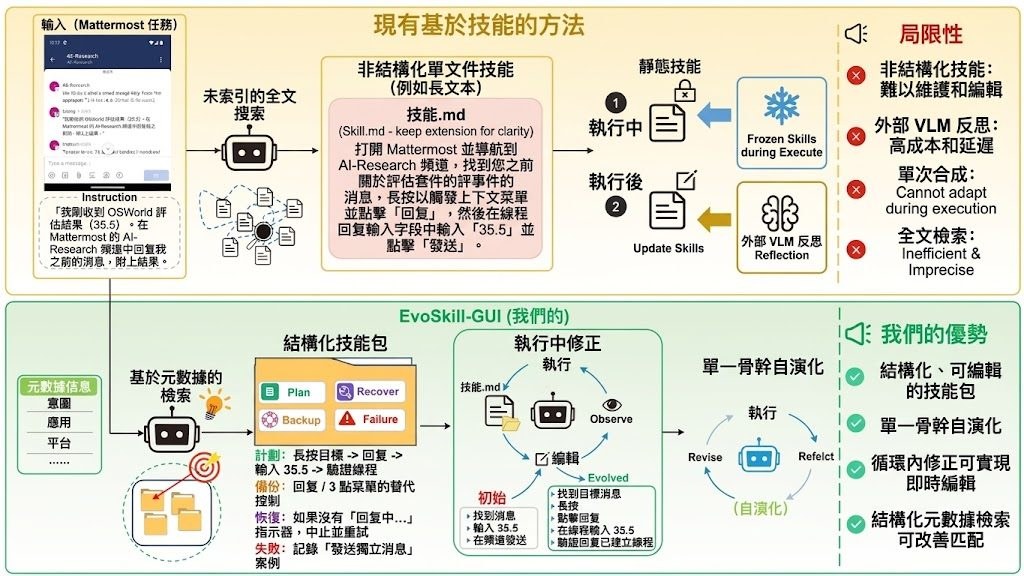
Comparison between static skill methods and EvoSkill-GUI

當手機或電腦彈出視窗、載入延遲、介面元素位置變動,原本寫好的 GUI 操作步驟往往幾步之後就失效。EvoSkill-GUI 正正回應這個痛點——它是浙江大學 ZJU-REAL 團隊推出的開源框架,毋須微調,就能讓 GUI Agent 把「技能」從靜態提示詞變成可即時修補、可重用的程序知識。

以往的 skill-based agent 把規劃、定位、復原規則全部塞進同一份文件,出錯時難以精準修補。EvoSkill-GUI 將每項技能拆成結構化套件,內含計劃、後備定位、復原規則、無障礙工具、檢索 metadata 與失敗案例等獨立檔案,並以 metadata 索引,後續按意圖、應用、平台等條件快速取出對應經驗,而非逐字比對長篇技能文件。

它的核心設計是「同一個骨幹模型」兼任執行者與批評者。執行時若觀察到介面與計劃不符,會即時修補局部錯配,避免小錯滾成大錯;失敗後模型會在嚴格資訊隔離下診斷軌跡,只針對出問題的檔案做精準編輯,毋須額外更強的反思模型輔助。

在 MobileWorld、AndroidWorld、OSWorld 三個基準上,無論通用模型還是 GUI 專用模型,EvoSkill-GUI 都帶來穩定提升,最高絕對增益分別為 +16.2、+6.0、+10.5 個百分點。對做行動 App 自動化、桌面助手或 RPA 的團隊而言,這種毋須重訓又能累積經驗的設計相當實用;不過整套機制依賴骨幹模型本身的反思品質,任務越長、介面越動態,回報會越明顯。

重點摘要:

  • 訓練免費用:以 single-backbone self-evolution 機制,省掉外部批評模型與微調成本。
  • 技能拆件:把計劃、定位、復原拆成獨立可編輯檔案,方便精準修補。
  • 即時修正:在 rollout 內偵測到介面變化就立刻修,避免錯誤擴散。
  • 資訊隔離批評:批評階段只看指令、觀察與動作,避免偷看草稿或答案。
  • 跨基準驗證:在 MobileWorld、AndroidWorld、OSWorld 三項皆有顯著絕對增益。
項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, 提示詞, 框架, 工具, Skill 技能

Hypit:把爆款短片變成可換臉的模板

Hypit 是一套開源影片克隆工具,主打把 TikTok、Reel 或 Short 變成可重用的版面,換掉主持人、產品、開頭與長寬比,就能快速產出多個變體做投放測試。

Hypit

短片團隊最常遇到的卡位,是手上有一條跑出來的素材,卻要趕在疲勞前把它複製成十幾條變體測試新 Hook。Hypit 想解決的正是這個工序:丟一條影片進去,它會拆解成鏡頭、字幕、B-roll、效果這些可組合的工作流部件,而不是只輸出一份腳本分析。對做付費社交投放的人來說,這意味著可以從 Meta Ad Library 複製一條已經贏過的廣告,換掉商品與開場就當日出 50 條 Hook 變體;等兩星期素材疲勞,再用同樣的主體版型換新開頭,主體片段完全保留。

它和一般「AI 影片生成器」差別在定位:生成式模型負責補上會變的部分,Hypit 則是負責把會變跟不會變的部分拆乾淨、串起來。每個組件都能被替換或 fork,使用者不必動到字幕或剪輯邏輯。商業模式上,項目本身是開源(Apache-2.0 with conditions),沒有平台座位費或浮水印,模型服務費則看你接的是哪一家。

技術偏向給內容團隊或 growth marketer 自建的工程師整合進既有管線。素材來源涵蓋 TikTok、Reel、Short,也可以從 Meta Ad Library 抓一支跑得好的 paid ad 當模板。對需要大量 A/B 測試 hook、不同市場語言切版、或長線養帳號的工作流來說,這種「一次結構、N 次變奏」的思路,比每次從腳本重頭來要省事不少。

我用AI 10分钟复刻爆款视频:Hypit详细教程,直接拆成可编辑工程
  • 不是單次生成,而是變奏生產線:同一支片可以反覆換主播、產品、語言、長寬比
  • 組件化設計:字幕、B-roll、效果都能獨立替換,不影響整體結構
  • 開源但非全免費:項目本體免費、無浮水印;模型推理依賴外部服務計費
  • 適合 paid social 與 viral clone 場景:Meta Ad Library、TikTok、Reel 都能當模板來源
  • 技術門檻在整合端:需要 Node.js + TypeScript 環境,較適合有工程支援的團隊

GitHub

Categories: 開源, AI productions, Video, 工具, 庫, Skill 技能

video-to-h3-prompt SKILL:逐幀反推參考影片,自動生成可貼即用 H3 提示詞

項目把『看幾幀就寫 vibe』的拍腦袋流程,換成五通道取證管線:密集抽幀、音頻交叉驗證、因果事件鏈、剪輯層分離,最後產出對應 MiniMax H3 五種輸入模式的完整模板。

Repository image for LoveRain1997/video-to-h3-prompt

如果你試過把一段參考影片丟給 AI 影片模型、要它重做或延伸,應該都撞過同一面牆:憑『整體 vibe』寫提示詞,往往會錯過動作、把 BGM 誤認為現場聲。今次做的是把這個『創作猜測』變成可驗證的逆向工程,輸出可直接貼進 MiniMax H3 的提示詞骨架。

做法上,它不放棄『一對多逆問題』的本質——同一段畫面,背後劇本可以是 A 也可以是 B。它讓多個候選劇本同時存在,再用 4–8fps 密集抽幀和 0.5s RMS 去裁決哪個版本站得住。同時,頻譜圖負責分辨音樂與環境聲。

它對剪輯層的處理也相當細:定格哏、白色閃屏、漫畫風的集中線/網點/狀聲詞,全部歸入 editing 與 overall_soundscape,不會和實景動作混在一起。因果事件鏈(trigger→action→reaction)則把袖口、單手、車頭外殼這類畫面邊緣的施力者也算進演員名單,避免關鍵 3–5 幀就這樣消失。

對 Coser/換角場景,它只換外表不改劇本,再做動作相容性檢查、分級道具,並把動漫設定翻譯成真人 cosplay,最後吐出一張替換表。輸出端覆蓋 T2VA、I2VA、FL2VA、L2VA 的 14 欄模板,以及 Ref2VA 的六段模板,全部用 <Subject>/<Picture>/<Video>/<Audio> 標籤紀律收束。

適合想用影片反推 AI 影片提示詞的人:二創作者、廣告分鏡、動漫改編的工作流。比起『看幾幀就 vibe』,它的取捨是慢、但每一步都有可追溯證據;代價是要提供參考影片與可選劇本線索,並接受密集取證帶來的額外處理成本。

重點摘要:
– 五通道取證管線取代單一直覺寫 prompt
– 密集抽幀 + 音頻峰值用作裁決證據,而非裝飾
– 剪輯層、漫畫後製、鏡頭外施力者都獨立建模
– 覆蓋 H3 五種輸入模式,欄位與標籤紀律齊備
– 換角只動外表,動作相容性與道具分級有 SOP

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, Video, Audio, 提示詞, Content Creator, MiniMax, Skill 技能

qisi-video-remix:喂一段參考片給 Agent 它直接交出改編劇本與分段提示詞

一個專給 AI Agent 用的視頻改編技能:丟一段參考視頻,它就吐回新故事、完整劇本、分鏡表和能直接複製貼去生視頻的分段提示詞。

Repository image for wyuzhi/qisi-video-remix

要做一條短片,常常卡在「找參考、拆敘事、寫分鏡、再翻譯成生成器看得懂的提示詞」這幾步之間。qisi-video-remix 把這條鏈條整進一個 Agent skill:你貼一段參考視頻(或者故事梗概、截圖、逐字稿),它先把原片的敘事手法抽出來,再以此為基礎寫出新故事,並按鏡頭兼容性和時長上限拆段,最後給出每段可獨立複製的生成提示詞。它不依賴特定後端或拼裝服務,所有結果先在對話中展開,能寫檔的環境下再另外存成 creative-plan.md。

重點摘要:
– 屬於視頻策劃向的 Agent skill,不帶模型或生成器,需由宿主 Agent 處理視頻讀取與生成。
– 默認做創意改編,要落實到人物選擇、事件發展或解決方式的變化,不止換名字。
– 分段先看場景、造型與動作複雜度,再看時長;15/30 秒是單段上限,不是固定段長。
– 提示詞各段獨立展開外貌、場景、動作和對白,可直接貼到所選視頻生成工具。
– 倉庫附一份 30 秒、6 鏡、2 段的完整示例,展示交付結構。

Codex 用戶只要把倉庫克隆到 ~/.codex/skills/qisi-video-remix/ 即可載入;其他支持 SKILL.md 的 Agent 按各自技能目錄安裝。它不替你選單段上限,未確認時會先詢問;遇到無法定論的聲音、身份或轉折會標明,不補造證據。對做豎屏短劇、廣告分鏡、或者想用 AI 視頻模型快速試腳本的個人和小團隊來說,這套指令能省下不少從分鏡到提示詞的人肉翻譯工作。

GitHub

Categories: 開源, Agentic, 模型, Video, Audio, 提示詞, 工具, 庫, Skill 技能

anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, 庫, 語音, Anthropic, 動畫, Skill 技能

FFmpeg 變身 AI Agent 影片剪輯師:28 個工具全程本地執行

ffmpeg-skill 為 Claude Code、Cursor、Codex 等編碼代理補上影片剪輯能力。28 個結構化工具涵蓋剪接、字幕、HDR 轉 SDR、多機位等流程,全程本地運作、不上傳素材。

FFmpeg Skill: media processing for AI agents

很多時候,你想叫 AI 幫你剪片、抽音、轉格式,但手上的影片根本不想上傳到雲端。ffmpeg-skill 就針對這個卡位——它不是模型,而是一套 Agent Skill,把 FFmpeg 包成 Claude Code、Cursor、Codex 或任何讀得到 SKILL.md 的代理都能用的工具集。只要機器裝好 ffmpeg 和 Python 3.9+,整套 28 個工具就能離線跑。

它跟一般「叫 AI 寫 ffmpeg 指令」的做法最大分別,在於每個工具都是帶型別參數的腳本,並非丟一段 shell 字串給模型拼裝。代理會先用 probe.py 量度時長、幀率、解析度、色彩和音軌,再依結果決定怎樣剪,文件名稱完全不被當成依據。輸出之後,結果會再被 probe 一次、比對目標規格,畫面有動過的話甚至生成 contact sheet 做肉眼覆檢。

工具覆蓋的工序相當完整:剪接、合併、去靜音、配合時長與比例、字幕與卡拉 OK 效果、overlay 與 motion graphics、HDR 轉 SDR 及 LUT、音頻清理與動態處理、含飄移修正的同步、多機位、響度校準、交付檢查、批次資料夾。音訊部分可從影片直接抽出、淨化,甚至指定軌號。而整組工具既是 CLI 也是 MCP tool,並由一份 machine-readable contract(SPEC)描述——CLI 的 argparse parser 同時衍生出 input_schema 和 MCP 定義,CI 會在規格漂移時自動失敗。

影片從業人員、剪接助理,或者任何需要把 FFmpeg 操作交給 AI 代理、又不想把素材外流的團隊,都會較易受惠。對一般開發者而言,這也是少數把 SPEC 概念實踐到「CLI 即 schema」程度的開源項目。

GitHub

Categories: 開源, Agentic, AI productions, MCP, Video, 影像處理, Audio, 工具, Python, Skill 技能

Dr. Claw 把 AI 研究流程收進一個可審核工作台

一款開源 AI 研究助理,把文獻回顧、實驗、寫作整合在同一介面,讓人類決策與 AI 執行之間留下可追蹤的紀錄。

Dr. Claw

跑過 AI 研究的團隊都遇過同樣的痛:Claude Code、Gemini CLI 等命令行編碼代理(coding agents)能讀寫檔案、撐住長對話,但文獻回顧、構思、實驗、寫論文、投期刊這些步驟散落在聊天工具、IDE、終端機、寫作軟件之間,中間決策也難以回頭追溯。Dr. Claw(GitHub: OpenLAIR/dr-claw)針對的正正是這個碎片化問題——它不是另起爐灶造一個新代理,而是把現有命令行編碼代理(Claude Code、Gemini CLI、Codex,以及透過 OpenRouter 接入的數百個模型)包進一個可控、可審核、人在回路(human-in-the-loop)的工作流。

項目覆蓋 survey → ideation → experiments → paper writing → slides & promotion 整條研究生命週期,與只懂執行程式碼的 CLI 代理相比,差異在於「全流程編排層」。底層靠三個關鍵設計撐起這層:持久化狀態物件(persistent state objects)、可重用技能庫(reusable skill library),以及多執行器協調(multi-executor coordination),把計劃、執行、寫作綁成一條可恢復的循環。論文亦明確指出,比起只共享同一後端執行器的裸 CLI 代理,Dr. Claw 在研究完整性上得分更高,同時保留可審計、可回溯的過程痕跡。

對獨立研究者、AI 實驗室團隊、需要把研究流程制度化的單位而言,這套架構的價值在於把人類決策(目標、約束、驗收)與 AI 執行清楚分開,並透過 checkpoint 反饋(Verify / Revise / Retry / Handoff)保留介入點。它支援本地部署(自家機器、自家 GPU、自家資料),亦提供桌面版(.dmg / .exe)或 npx dr-claw 零安裝啟動,甚至能在終端機直接 dr-claw chat 跑 agentic 對話。

項目已被 EMNLP 2026 System Demonstrations track 收錄(arXiv: 2609.00365),並採用 AGPL-3.0 搭配上游 GPL-3.0 元件授權,免費、無訂閱。需要留意的是,它自定位為 Anthropic Claude Science 的開源、模型中立替代方案,主打全生命週期而非單純計算分析。

GitHub · Paper

Categories: 開源, Agentic, 模型, OpenAI, Gemini, 軟件, 工具, IDE, 庫, 編程, Anthropic, Skill 技能

Hojo TTS Light 輕量語音合成,4000 萬參數就做到 15 種聲線

Hojo-TTS-Light 僅約 0.08B 參數,以 ONNX 格式在 CPU 即時合成 24 kHz 語音,並預載 15 種聲線,免依賴 PyTorch。

Og image

想把文字轉語音(TTS)嵌入邊緣裝置或本地腳本,最大阻力往往來自 PyTorch 依賴肥大、GPU 門檻高。Hojo-TTS-Light 直接以 ONNX Runtime 執行,連 PyTorch 都不用安裝,對只有 CPU 或資源受限的環境相當友善。模型檔約 4000 萬參數(0.08B),輸出 24 kHz 音訊,並內建 15 種預設說話人聲線,開發者只需切換 embedding 即可換聲,省下自行收集語料或微調的工序。

隨倉提供的 infer.py 與 onnx_model.py 展示完整推理流程,搭配 requirements.txt 即可用幾行程式碼完成合成。對需要快速在本地或伺服器側加入語音回饋的項目而言,這種「開箱即播」的設計,比傳統 TTS pipeline 更貼近部署需求。

不過,15 種聲線屬於 preset 性質,若要新增自訂說話人,就需要額外準備參考音訊與對應 embedding,無法像大型 TTS 模型那樣靠一句話克隆。整體取向偏向「輕量、即用」,而非追求擬真度或表現力。

重點摘要:

  • 參數量約 0.08B,屬輕量級 TTS 模型
  • 採用 ONNX 格式,免安裝 PyTorch 即可在 CPU 環境執行
  • 預載 15 種 speaker-conditioned 聲線,可即時切換
  • 隨附 infer.py、onnx_model.py、requirements.txt,方便快速整合
  • 發佈平台為 Hugging Face,授權與權重可至該頁查閱

適合需要把語音合成嵌進邊緣裝置、CLI 工具或本地自動化流程的開發者;對追求高擬真或自訂聲線克隆的場景,則需要再評估擴充成本。

項目主頁

Categories: 開源, 文字轉語音, Agentic, Embedding, 模型, Audio, 語音, Skill 技能

AREX-Skill 把 GitHub 知識變成可執行技能

AREX-Skill 將熱門 GitHub 儲存庫整理成可驗證、可執行的技能,讓 Coding Agent 在複雜機器學習研究任務中少走彎路。

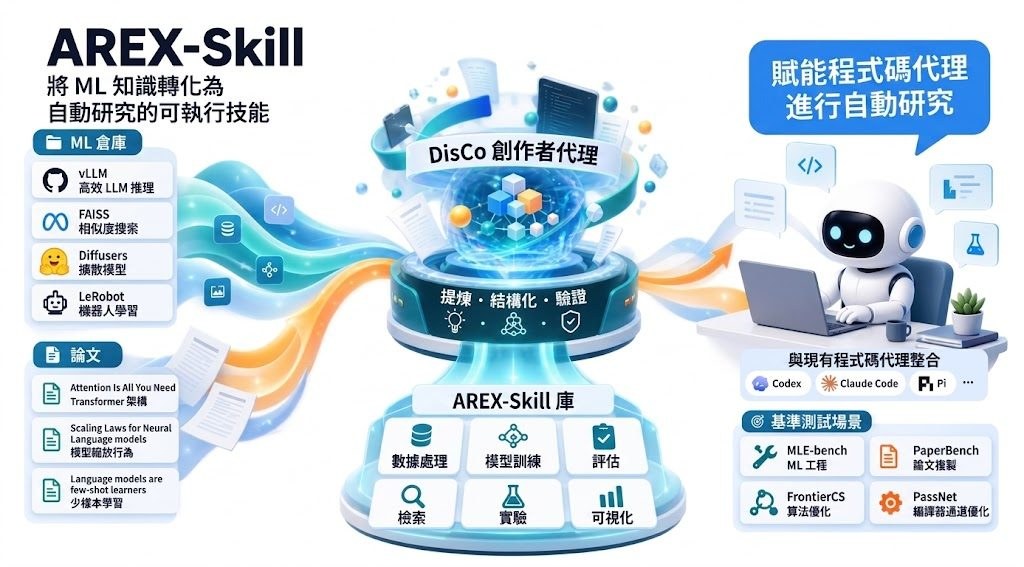
AREX-Skill turns repository and paper knowledge into executable skills for coding agents and autonomous ML research

面對需要查閱多個儲存庫、重現研究流程和逐步驗證結果的工作,AREX-Skill 將分散在 GitHub 的操作知識整理成可重用程序、檢查方法和技能圖譜。它屬於面向 Coding Agent 的開源技能庫與工作流工具,實際處理的是代理有模型能力卻欠缺項目脈絡和操作經驗的問題。

AREX-Skill 已從 1,000 多個熱門機器學習儲存庫提煉超過 5,000 個經驗證、可執行的 skills,並可整合 Codex、Claude Code、Pi 等 Coding Agent。使用時可按任務由 router 從技能庫收窄至相關分支,再由代理執行;DisCo 則負責將儲存庫知識建立、驗證和匯出成技能。

  • 技能包含程序與檢查,而不只是文字說明
  • 技能圖譜協助代理處理跨學科機器學習研究
  • DisCo Meta Skills 支援挑選及使用 Creator meta skills
  • Refreshing Repo Skills 提供維護和更新清單

相較於每次由代理重新閱讀 README、程式碼和論文,技能化做法可把重複的操作步驟預先整理,並將預算集中到較困難的推理工作;代價是技能需要隨儲存庫更新而刷新,覆蓋範圍和驗證品質亦會直接影響結果。儲存庫目前提供 Demo、技能目錄、repository catalog 及 DisCo CLI 文件,適合研究團隊、Coding Agent 使用者,以及需要重現多個 ML 項目的開發者。

GitHub

Categories: 開源, Agentic, Vibe Coding, 編程, Anthropic, Dataset 數據集, Skill 技能

Skill Router:讓 Agent 自己揀技能,毋須死記名稱

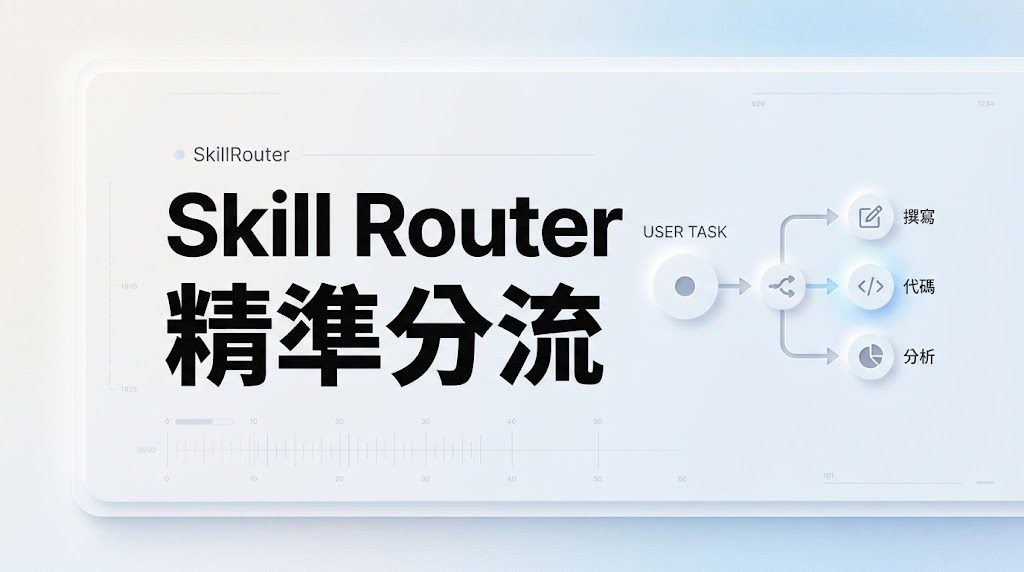
Agent 工具愈多愈難揀?Skill Router 在主 LLM 之前先用確定性規則分類請求,只選出一個主技能加必要輔助技能,仲會擋住高風險操作。

Repository image for luxurylifestyleco/skill-router

工具愈裝愈多,Agent 執行前最頭痛的往往係「到底應該召喚哪一個 skill」。這個名為 Skill Router 的開源項目正正針對這個痛點:它在主 LLM 介入之前,先以一套確定性(deterministic)方式把用戶請求分類,再揀選一個主技能配搭必要的輔助技能,最後輸出一份可供審計嘅裁決結果,而唔會將本地整份技能清單外洩。對管理大量工具嘅 Agent 開發者來說,這層路由令請求與執行之間多了一道可控嘅分流閘。

路由背後嘅結構相當直接:請求會先落入 8 個 action bucket(sense、understand、decide、create、operate、verify、learn、govern),再對應到 4 個 purpose bucket(data-enrichment、orchestration、utility、verification),然後再評估風險同依賴。分類完成後,系統會套用技能 manifest 內嘅 bucket、agent 同 skill 政策,只回傳最終被選中嘅配對。如果偵測到無效 manifest、缺失證據或依賴未就緒,路由會 fail closed 而唔係硬揀一個;如果請求涉及治理或具物質影響,就會觸發 Human Gate,將決定權交返俾人。

同坊間常見嘅「LLM 自己揀工具」做法相比,Skill Router 嘅取捨係將選擇權交給預先定義嘅規則,LLM 只負責執行被揀中嘅技能。犧牲咗一定靈活性,但換來可預測性同審計能力,亦避免將內部技能清單完整暴露俾模型。公開版本唔打包私有目錄、不打遠端服務、不收集遙測數據,運行環境只需要 Node.js 18+,零第三方依賴,並支援 Windows、macOS 同 Linux。

對於需要管理十幾甚至幾十個 skill、又要顧及合規同可審計性嘅團隊,例如內部 Agent 平台、企業自動化流程或帶敏感操作嘅助手,這層路由可以作為統一入口。對一般開發者而言,佢亦提供咗一個清楚嘅分類同風控範式,幫助避免「LLM 亂叫工具」嘅常見問題。

重點摘要

  • 請求先分流、後執行:8 個 action bucket 對應 4 個 purpose bucket,喺主 LLM 之前完成分類。
  • 只回傳必要技能:一個主技能加最少輔助技能,避免將整份本地目錄暴露。
  • 高風險自動擋住:治理或具物質影響嘅請求會觸發 Human Gate,由人手把關。
  • 缺資料就 fail closed:無效 manifest、缺失證據或依賴未就緒會直接 blocked,唔會硬猜。
  • 零依賴、易部署:Node.js 18+ 即可運行,公開包不含私有目錄或遙測,跨平台可用。

GitHub

Categories: 開源, Agentic, Mac, Linux, Skill 技能

Page 4 of 9
1 2 3 4 5 6 … 9