screenwriting-skills:把劇作方法拆成 26 個 Agent 技能

一套供 Claude Code 與 OpenAI Codex 共用的劇作技能庫,涵蓋結構、人物、對白及電視策劃,並以 47 本書與 23 部劇作整理出可執行的方法。

Repository image for jtydhr88/screenwriting-skills

劇作家教與 AI 之間一直有種微妙的距離:前者提供判斷與取捨,後者擅長把要求變成文字。screenwriting-skills 選擇讓 AI 補上前者,把劇作、電視寫作與戲劇理論拆成 26 個 Agent 技能,直接處理結構設計、人物衝突、對白修訂和劇集企劃,而不是只提供一份「寫劇本」的通用提示詞。

這是一套 Agent 技能庫,不是另一個劇本生成模型。它把 47 本劇作技術書與 23 卷中、美、英、日、韓的公開劇本、劇評及戲曲資料濃縮成可由代理程式按需調用的工作流程。電影項目可用一般戲劇理論、劇本格式與改編方法;劇集則再加上季與集結構、故事引擎、編劇室運作等媒體專屬層次。

它與一般提示詞最明顯的分別,在於能連同術語一起工作。logline、act out、beat sheet、showrunner 等概念會對回原始英文,避免不同中文譯名造成理解偏差;遇上沒有直接對應的詞,例如戲眼、扣子或日語的ト書き,便保留原詞再附解釋。技能本體以中文撰寫,但用戶用英文、日文、韓文或法文提問,代理程式便以相應語言回覆,劇本本身也不會因討論語言而被迫轉換。

安裝並不複雜。Claude Code 可以經插件市集、個別使用者或指定項目三種方式載入;Codex 則可從同一套插件市場安裝,也能把技能放入通用技能目錄。檔案依循 agentskills.io 標準,沒有綁定特定代理程式,因此同一份技能檔可跨 Claude Code、Codex,以及其他支援該格式的工具使用,不必為每個平台各維護一套內容。

這套設計也有明確的代價。非中文讀者若要核查技能如何定義流程,便要依賴代理程式的解釋;團隊成員之間也很難像查閱英文文件那樣直接審核同一條規則。項目早前曾保留英文版,但多語版本一旦分叉,便需要持續同步修改,最終選擇以單一中文來源配合執行時多語輸出。

  • 26 個技能覆蓋一般戲劇理論、電視劇集、舞台劇與不同地區的編劇實務
  • sw-workflow 負責統籌項目階段、交付物與各技能之間的銜接
  • sw-series-structure 處理集數劃分、幕結構、資訊投放與季終收束
  • sw-dialogue 與 sw-scene-craft 分別針對對白和場景推進提供修訂框架
  • 同一套技能檔可同時供 Claude Code 與 OpenAI Codex 使用

適合進修編劇課程的學生、獨立編劇、劇集策劃人,以及需要在團隊內統一結構語言的編劇室。對已經熟悉劇作理論的人,它更像一套可查閱、可組合的工作手冊;對初學者,則能提供一條由企劃到修訂的清晰路徑,但生成結果仍要經人手判斷,不能把節拍表或人物弧線直接當成好劇本的保證。
GitHub

Categories: 開源, Agentic, 模型, OpenAI, 提示詞, 框架, 工具, 庫, Anthropic, Skill 技能

music-skill:MIDI 音樂生成可編輯樂譜

music-skill 會實際寫出和弦、聲部與編曲,並能檢查和修正。不靠音訊生成模型,而是由 Agent 寫作音符,再經取樣樂器播放、混音及母帶處理,輸出可修改的 MIDI 與分軌。

music-skill

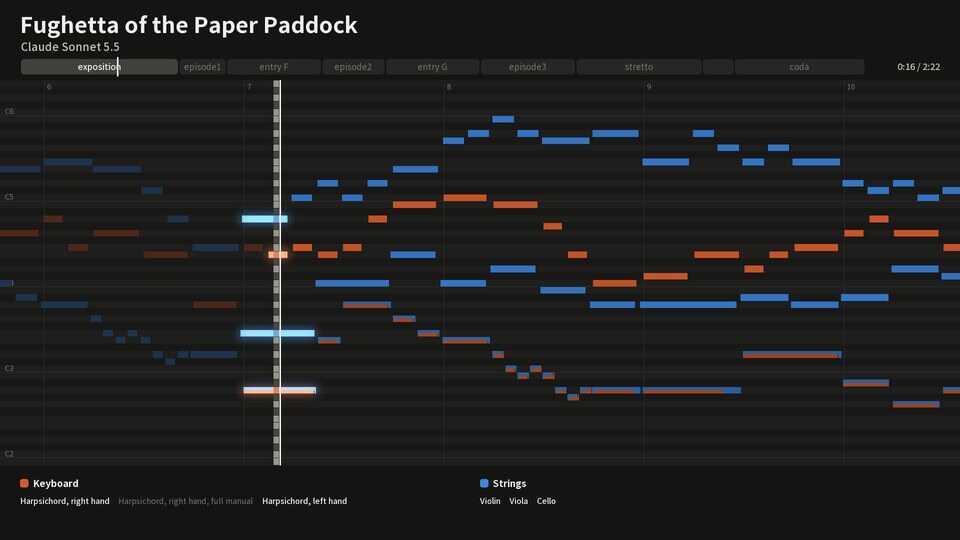
music-skill 是一套 Agent Skill,把「生成一段音樂」改成較接近作曲與小型錄音室的工作:Agent 逐個寫出音符,檢查樂譜,再以取樣樂器播放,經過混音和母帶處理輸出成品。它不直接生成聲音,也不涵蓋歌唱或歌詞;核心產物包括 MP3、WAV、MIDI、各聲部 stem,以及可以改音符後再次渲染的項目檔案。

Agent 可以調整「某個和弦的 voicing(和弦聲位)」,表示它不是只填一組和弦名稱,而是會安排實際音符。所以,你可以要求它例如:「用 C 大調寫一段 I–vi–IV–V 的進行,鋼琴右手彈分解和弦、左手低音,弦樂做 pad,並避免平行五度」,它將會完成對應的檢查與修改機制。

它具備基本的和聲與聲部寫作檢查:

  • Review 會標出聲部之間持續的小二度與九度不協和音程。
  • 它會辨識和弦外音,並區分經過音、掛留音及其他裝飾音;若某個和弦外音沒有以級進解決,也會提出來。
  • 它會檢查獨立聲部之間的平行五度、平行八度,以及過低音域的緊密音程

使用時需要先把 Agent Skill 安裝到支援該技能的環境,再依賴 Surge XT 播放樂器。渲染器可透過 --jobs 控制同時處理的聲部數;合成器或效果器聲部較多時,每個同時渲染的聲部可能佔用約 2 GB 記憶體,記憶體不足便會自動減少並行數量。

这套方法較適合配樂原型、影片音樂初稿,以及需要保留可編輯樂譜的製作流程。項目文件展示六種模型的一次性作品,但沒有提供標準化比較結果;質素評估因此仍要配合實際聆聽,而不能只看輸出格式。

GitHub

Categories: 開源, Agentic, AI productions, 模型, Video, Audio, 提示詞, 音樂, Skill 技能

OpenFilm:讓編碼代理直接製作可編輯影片

OpenFilm 把影片變成網頁時間線,讓 Codex、Claude Code 等代理先製作,再由人在瀏覽器編輯器中修改。

OpenFilm

一部片由代理生成,之後仍要逐項執剪、改字、調音量,往往是 AI 影片工作流最難銜接的一步。OpenFilm 是一套開源 AI 影片工具與框架,將生成、檢查和後製放進同一個瀏覽器工作環境,並讓影片保留為可繼續編輯的網頁項目。

OpenFilm 透過現代化技術棧與開源精神,為影視團隊帶來了以下核心價值:

  • 全方位的專案生命週期管理: 從專案立項、任務分配、進度追蹤到資產歸檔,OpenFilm 提供了一站式的管理介面,讓製片人、導演與技術人員能在同一個資訊源(Single Source of Truth)上高效運作。
  • 無縫的影音資產協同: 支援高效的媒體預覽、線上審片與時間軸標記回饋,讓團隊成員與客戶可以直接在影格(Frame)上進行精準溝通,告別模糊不清的文字描述。
  • 資料自主與開源自由(Open Source & Self-Hostable): 採用開源授權,團隊可以完全掌控自己的核心智慧財產權與高畫質素材資料,不必擔心雲端服務商的隱私侵犯或無預警的訂閱費調漲。

它為每個鏡頭成為一個 frame(t) ,按時間繪畫畫面;影片、圖片、聲音和文字則放在 film.html 的時間線上。代理可運用 HTML、CSS、Canvas、SVG、WebGL、Three.js、GSAP 及現有影片上面建立內容。

  • 一個 HTML 檔案整合動畫、片段、圖片和聲音,CSS 負責樣式與版面。
  • 一個 frame(t) 函式負責每個鏡頭,以支援亂序及並行算圖。
  • Studio 在瀏覽器提供時間線剪輯,可移動、縮放、旋轉物件,亦可裁剪片段、修改文字、色彩、字幕、速度和音量。
  • Canvas 協助整理分鏡、素材、旁白與音樂,再按次序送入時間線。
  • 匯出涵蓋 MP4、GIF、聲音、字幕、靜態圖、透明影片,以及 Final Cut Pro、Premiere Pro 和 DaVinci Resolve 時間線。

透過編碼代理使用內建 CLI 開啟 Studio、檢查畫面和輸出影片。環境需要 Node.js、ffmpeg 與 Git,首次執行會下載約 100MB 的 headless Chromium;macOS、Windows 和 Linux 桌面版已包括 ffmpeg 與瀏覽器。生成語音、音樂、圖片和影片時,可在 Studio 連接 ElevenLabs、OpenAI、Google、OpenRouter 及 fal,並使用自己的 API key。

適合需要快速製作產品示範、社交媒體短片、動態簡報或教學片段,並希望保留人手修改能力的開發者、內容團隊與代理工作流研究者。

GitHub

Categories: 開源, AI productions, 模型, Google, OpenAI, API, Video, Image, Audio, 框架, 教學, 軟件, 工具, Mac, Linux, Python, 語音, Anthropic, 動畫, 音樂, Skill 技能

Terminal Mac:讓 AI Agent 操作虛擬 macOS 電腦

代理可在獨立的 macOS 桌面操作應用程式,不必移動實體 Mac 的滑鼠或改動剪貼簿。terminal-mac 把虛擬機畫面帶到終端機,並提供 MCP 工具供代理控制。

Repository image for govijr/terminal-mac

讓電腦操作代理在另一個 macOS 桌面開啟應用程式、輸入文字和檢查畫面,同時保留實體 Mac 的滑鼠與剪貼簿不受代理操作影響。terminal-mac 是為 Computer-use agents(CUAs)提供獨立 macOS 虛擬機的工具,透過終端機檢視畫面及下達操作。

它使用 Apple Virtualization 執行真正的 macOS guest,guest 有自己的應用程式、檔案、帳戶和權限,不會沿用主機已登入的工作階段。代理透過 MCP 工具截圖、點擊、拖曳、捲動、輸入文字及按鍵,並可依照「觀察、操作、確認」的流程檢查結果。

首次啟動會從 Apple 下載並快取相容的還原映像,也可使用既有的 .ipsw;之後會重用已建立的虛擬機。項目面向 Apple silicon、macOS 14 或更新版本,預設虛擬磁碟邏輯容量為 64 GiB,主機亦須預留還原映像和虛擬機所需的資源。Ghostty、Kitty 或 iTerm2 可顯示終端機內嵌畫面,其他終端機則可改用原生虛擬機視窗及代理命令列工具。

主機輸入與螢幕 API 不會用來執行代理操作;guest 內的 helper 會檢查硬件型號是否以 VirtualMac 開頭,避免操作意外落到主機。這項檢查不是硬件認證,也不能防範已遭入侵的主機。項目仍屬早期候選版本,乾淨 Mac 上的 guest 驗收尚未完成,發行版本亦未經 Apple 公證;tmux passthrough 和自動分割終端機目前不支援。

  • 適合需要隔離代理操作與個人桌面、帳戶及剪貼簿的測試工作。
  • Claude Code 可透過 MCP server 和 skill 接入代理工作流程。
  • 首次建立虛擬機需要網絡下載 macOS,或自行提供相容的還原映像。
  • 虛擬機會佔用主機 CPU、記憶體和儲存空間,預設磁碟邏輯容量為 64 GiB。

GitHub

Categories: 開源, Agentic, MCP, API, 工具, Mac, Anthropic, 蘋果, Skill 技能

Garden Skills:讓 AI coding agents 承接影片、設計與寫作流程

從程式生成短片、網頁設計到整理知識庫,Garden Skills 把多種工作流程包成可供 AI coding agents 使用的技能。創作型工作尤其著重分階段確認與一致的輸出控制。

Motion Showreel Skill

想用 AI coding agent 製作短片、網頁簡報或整理本地知識庫,Garden Skills 提供一組可加入工作流程的 Agent Skills,適用於 Claude Code、Cursor、Codex 等工具。它不是單一模型,而是涵蓋影片製作、前端設計、影像提示、文章生成與知識檢索的技能集合;各技能如何安裝可按 項目文件提供的方式處理,但這份資料未列出完整操作步驟。

影片相關技能的重點,是把畫面與聲音放進同一條時間軸,並由同一個頁面產生不同階段的輸出,包括靜態畫面、聯絡表、預覽代理檔及成品。創作者可以選擇多種視覺風格,調整動態、鏡頭語法和聲音方向;配樂可由內置合成器或 Tone.js 產生,也可以配合自備音軌及節拍、段落變化剪輯。

創作流程設有兩個確認點:先確認需求,再確認風格畫面;若未指定風格,會提供三個方向供選擇,之後才進入自主製作。長片支援分章製作,最長可達 20 分鐘;Gemini 或 MiniMax TTS 只會朗讀使用者提供的稿件,錄音則以實際時間戳記對齊,音樂與音效亦會為旁白讓位。這些安排適合需要反覆檢視視覺方向、又希望聲畫時間一致的內容團隊,但資料沒有提供效能測試或品質評分,成品仍需自行檢查。

其他技能分別處理網頁影片簡報、前端設計、GPT Image 2 提示與影像生成、美化文章,以及本地知識檢索。對需要把重複創作步驟交由 AI coding agent 執行的設計師、影片製作者及內容團隊,這種技能集合比只提供單一功能的工具涵蓋更廣;取捨是各項工作的品質和適用程度,仍取決於所選技能、模型與輸入內容。

【经验开源】AI 做动画视频完全指南:原理、技巧、Skill 一次给全
  • 六種技能涵蓋影片、網頁、影像、文章及本地知識檢索。
  • 影片輸出由同一頁面生成,畫面與聲音共用時間軸。
  • 風格確認後才開始自主製作,未指定時可先比較三個方向。
  • 長片支援分章製作至 20 分鐘,旁白須使用者提供稿件。
  • 項目文件列出多種安裝途徑,但目前提供的資料未包含完整安裝流程或評測結果。

GitHub

Categories: 開源, Agentic, AI productions, Gemini, Video, Image, Audio, Vibe Coding, Content Creator, IDE, 庫, 編程, 音樂, MiniMax, Skill 技能

vibe-knowledge:把知識點做成可查證短片

vibe-knowledge 將查證、旁白、逐幀渲染和質檢串成一套對話式短片製作流程,亦把生成成本攤開給你核准。

风格快闪片

把一個知識點變成有旁白、逐句附來源的 1080p60 短片,vibe-knowledge 以 Claude Code skill 串起選題、查證、寫稿、配音、程式渲染、OCR 質檢和發布包;它屬於 AI 內容製作工作流項目,處理的是知識內容由文字走到可觀看影片時的流程分散問題。

vibe-knowledge 需與 ai-teardown 一併安裝,後者提供 cine 渲染引擎、工作區及配音腳本。渲染環境需要 Python、NumPy、SciPy、Pillow、Playwright、Chromium headless shell 和 ffmpeg;macOS 的 OCR 質檢則依賴 Vision 及 swiftc。

每次提交生成前,流程會列出鏡頭、模型、提示詞和 estimate cost,等使用者在對話中明確同意才繼續。基礎檔可用 0 積分完成程式插畫版;增強檔加入 Renoise 生成的配圖與 Wan 動態鏡頭,示例《商鞅立木》使用 246 積分,常見檔次約為 25–40、250–300 及 600–700 積分。

  • Claude Opus 負責編排,畫面由程式逐幀渲染
  • 早期提供古風、星空、像素、字幕新聞等多套風格
  • 基礎檔與增強檔可保留同一旁白及腳本作比較
  • Release v1.0.0 已提供多段樣片,但未有獨立準確率或品質基準

適合需要持續製作歷史、科普或解釋型短片的內容團隊,尤其重視來源標註、成本審批和可重複流程的工作情境。Renoise 增強檔能擴充視覺效果,代價是積分及外部模型依賴增加;片中亦會標示「AI 示意」,不能當作史實畫面或紀錄片素材直接使用。

GitHub

Categories: 開源, AI productions, 模型, Video, 提示詞, Mac, Python, 新聞, Anthropic, Skill 技能

huashu-motion:AI Agent 按節奏製作產品宣傳片

由 Claude Code 或 Codex 讀取產品內容、編排動畫和配樂,再讓你在瀏覽器畫面上指定位置修改。製作流程可在本機完成,配樂亦毋須呼叫付費接口。

huashu-motion发布片开场:一整面墙的片子,说一句,出一支片

想把產品介紹變成一支短片,可以直接向 Claude Code 或 Codex 提出需求;huashu-motion 會先閱讀產品內容,提供三個創作方向,再編寫動畫與配樂,並在瀏覽器開啟編輯器。它是一套供 AI Agent 使用的動畫製作 skill,處理從產品內容到宣傳片、再到局部修改的工作流程。

修改方式著重畫面定位:在預覽中按 C,再點選要調整的位置並留下意見。評論會附上時間點、場景、所選元素及其原始碼位置,Agent 可針對該處修改;版本會保留,亦可撤回。標題、數字、顏色和停留時長等項目則可直接在編輯器輸入框調整。

配樂不是完成影片後才補上的背景音。Agent 會先按節奏單寫 ABC 記譜法樂譜,並以樂譜標記配合場景切換;樂器音色可選本機採樣或合成音色,音效則配合畫面元素落地的時刻。本機生成配樂不需付費接口;使用三腳鋼琴、弦樂和鼓組等真實樂器音色,需另行下載約 55MB 採樣。口播亦屬可選功能,Kokoro 中文語音和逐字對齊各有額外安裝需求。

項目列出以 Chrome、Chromium 或 Edge 執行截帧、檢查及匯出,不需另外下載渲染器;也展示 Claude Code、Codex 和 DeepSeek V4.1 Flash 等案例。當中一支 22 秒動效片以 DeepSeek V4.1 Flash 製作,經三輪修改,不到半小時完成;文中記錄當時費用為 1.95 元,不能視為固定成本或其他模型的效能保證。安裝方式雖有列出,但資料沒有完整說明各平台的操作流程,首次使用仍要按所選音色和口播功能處理相應依賴。

  • 先閱讀產品內容,再提供三個方向並生成完整短片。
  • 在預覽指定畫面位置,讓 Agent 針對局部修改;版本可保留和撤回。
  • 配樂以 ABC 樂譜和場景標記同步,音樂及音效可在本機生成。
  • 可透過瀏覽器截帧、檢查和匯出;真實樂器採樣與中文口播需額外依賴。

這套流程適合需要快速製作產品發布片、又希望保留逐處審核和修改能力的產品及設計團隊。它把創作交給 Agent,但仍讓人透過畫面評論調整細節;採樣下載、語音工具安裝及各平台實際操作方式,則是導入前需要確認的成本。

GitHub

Categories: 開源, Agentic, AI productions, 模型, DeepSeek, Video, 工具, 語音, Anthropic, 動畫, 音樂, Skill 技能

teardown:把機器原理變成可拆解的 3D 模擬器

想了解引擎、手錶或挖掘機怎樣運作,可以讓 Claude Code 生成一頁式模擬器,邊看機器運轉,邊拆開部件追蹤數值。

Mellis HB-7 robotic bee simulator

想弄清楚四衝程引擎如何運作,單看文字或靜態圖解未必容易掌握部件之間的關係。teardown 是一項 Claude Code skill,會按自然語言指示生成離線 HTML 3D 模擬器,讓機器在畫面中央運轉,周邊面板同步顯示數值,亦可按鈕打開正在工作的部件。

使用者可在 Claude Code 以日常語句描述想了解的機械,例如機械手錶或液壓挖掘機臂,再要求生成模擬器;項目亦附有 V8 引擎、Cessna 飛機和 Strandbeest 機械生物三個例子,可用 Node.js 建成單一 HTML 頁面。安裝需要 Node.js 20 或更新版本,以及 Playwright 的 Chromium;影片輸出另需 ffmpeg,聲效製作則需 Python。主要使用方式是透過 Claude Code 提出描述。

生成的頁面會把 three.js 和字體內嵌,方便離線開啟;模擬器閒置時會自動巡覽,亦可把畫面逐格輸出成 60 fps MP4,並配上時間軸聲效。相較只提供動畫的展示頁,它把機械運作、即時數值與可拆解部件放在同一介面。

較適合製作互動式教學素材、概念展示或機械原理解說的教育工作者、設計師和工程團隊。要留意,生成品質會受描述與 Claude Code 產出影響;若內容用於工程驗證或安全判斷,仍需另行核實模型設定與數據。

  • 以自然語言要求 Claude Code 建立機械 3D 模擬器。
  • 單一離線 HTML 頁面包含機器動畫、數值面板和部件拆解互動。
  • 可將模擬器畫面輸出為 60 fps MP4,並加入程序化聲效。
  • 內附 V8 引擎、Cessna 飛機及 Strandbeest 三個示例。
  • 文件未提供物理準確度評測,生成結果不宜直接當作工程驗證。

GitHub

Categories: 開源, AI productions, 模型, Video, 教學, 3D, Python, 安全, Anthropic, 動畫, 聲效, Skill 技能

Motion Prompt:萬用 AI Motion Graphic

想叫 AI 加入某種鏡頭運動或網頁效果,卻不知道該怎樣描述?Motion Prompt 把名稱、動態示例和提問範本放在一起,方便查找與轉交創作要求。

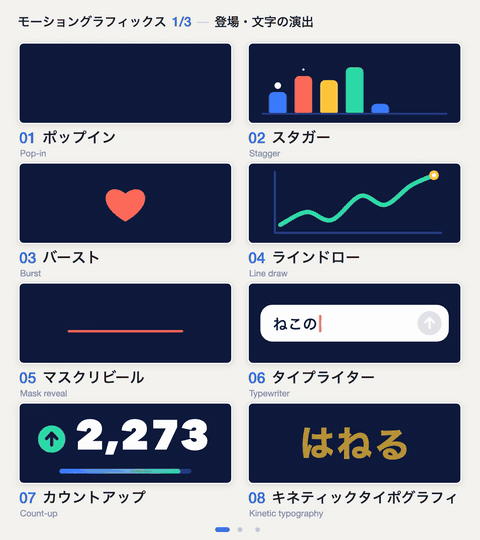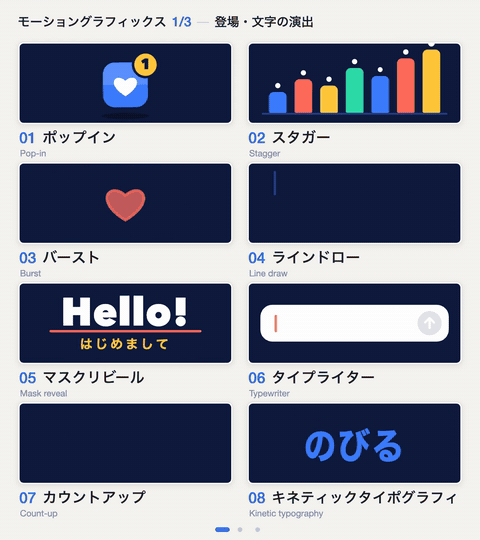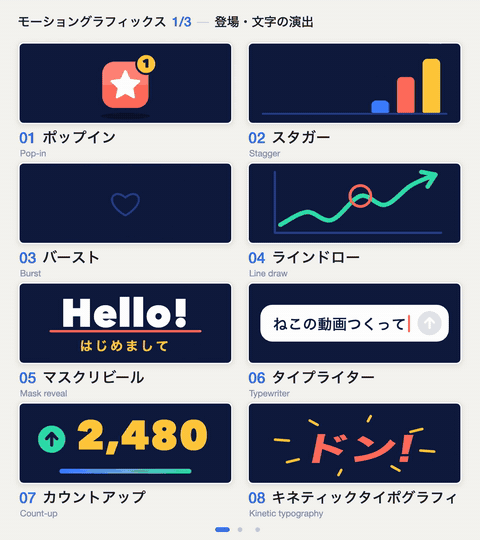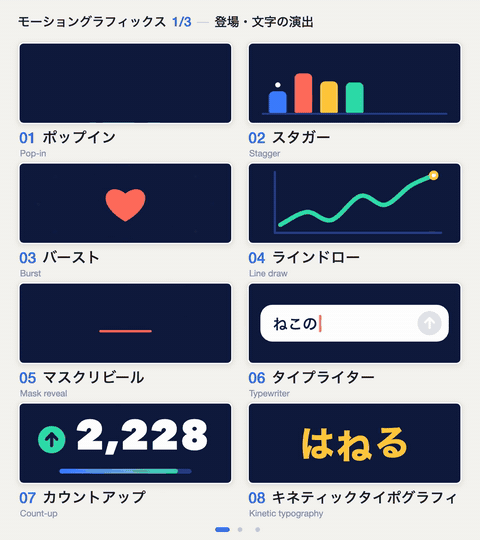
描述鏡頭運動、動態圖像或網頁效果時,光靠「有感覺一點」往往難以讓 AI 掌握方向。Motion Prompt 是一個創作名稱與示例庫,收錄 192 個名稱,每項附有動態示範、簡短解釋和提問例句,涵蓋動態圖像、鏡頭運動、UI 元件、網站效果和攝影風格。

使用者可在網上 Gallery 播放示例、搜尋名稱,再選取多項並附上備註,將整理好的要求交給 AI;不使用技能時,也可複製提示詞和示例連結。 packs/ 提供五種語言的名稱清單,包括繁體中文。項目亦提供建立自訂領域及語言版本的提示詞;說明了技能安裝方式,但沒有提供完整的手動部署流程。

與只列術語的詞典相比,Motion Prompt 把可觀看的動態參考和可直接改寫的提問放在同一項目;每個示例的參考實作以 Canvas 2D 撰寫,不依賴外部程式庫,並可逐格繪製及用於影片輸出。它提供的是創作參考與溝通素材,不代表不同 AI 模型都能產生相同效果,也沒有提供量化性能評測。

  • 可播放示例,並按名稱或編號查找。
  • 多選示例、加入備註,再把要求交給 AI。
  • 不使用技能時,可複製提示詞及參考連結。
  • 提供繁體中文清單,以及製作自訂名稱庫的提示詞。

影片創作者、設計師和需要以 AI 協作的前端團隊,可用它把抽象的視覺想法轉成較具體的術語與參考。若工作流程依賴特定模型或成品品質,仍需自行測試提示詞能否帶出預期結果;現有內容主要是示例庫,並非生成模型或效果保證。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, Video, Image, 提示詞, Content Creator, 庫, Anthropic, Skill 技能, UI/UX

ReGap-Bench:視覺與推理分開評測

模型看見物件,不代表能逐步追蹤它們。ReGap-Bench 用可配對的視覺參照,測出多模態推理究竟卡在哪裏。

Teaser

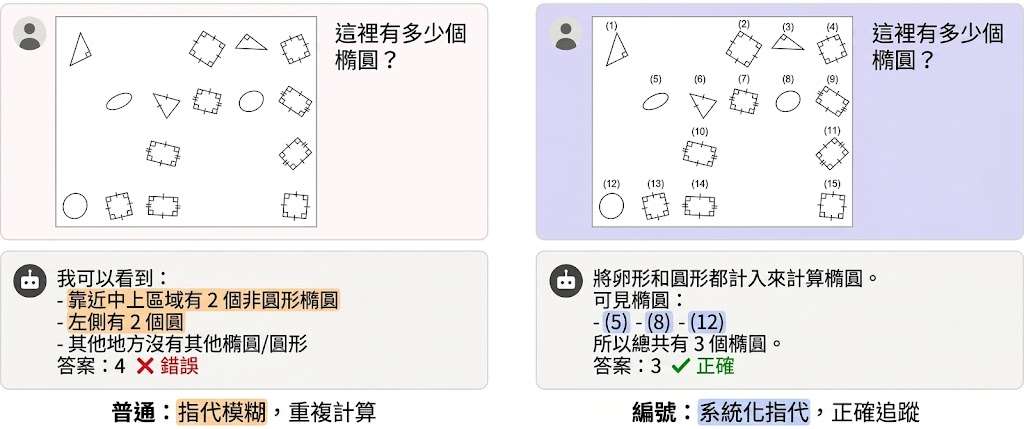
模型明明看見圖中所有物件,數數時卻會重複計算;ReGap-Bench 是一個針對 multimodal large language models(MLLMs)的資料集與評測項目,專門檢查語言推理能否正確對應視覺中的物件、區域和位置,並將問題命名為 reference gap。

它把同一場景、問題和答案固定,只更換額外參照,形成 paired reference-intervention benchmark。編號讓物件可以被索引,陰影標示有界區域,網格線則協助定位、追蹤邊界和比較位移;參照是否配合任務,會直接影響推理結果。

  • 涵蓋 shape counting、angle ranking、size ranking、clock ranking 和 transformation prediction 五項任務
  • 共 200 個場景及 3,400 張圖片,設有 plain、numbering、shading 和 grid 條件
  • task-matched references 可令所有受測模型在所有任務提升,最高達 25%
  • mismatched references 幫助有限,甚至會令表現下降

測試可用 OpenAI、Google Gemini API,亦可透過 vLLM 執行 Qwen3.5;後者需要 GPU,API 模型則只需設定相應金鑰。Python 3.10 環境和 requirements 已列明,輸出會保存到 outputs,方便比較同一模型在不同參照條件下的差異。

ReGap-Bench 的價值不在於再加一個總分,而是把視覺感知和語言推理之間的接合問題單獨拉出來。結果支持一個務實判斷:改善模型未必只靠更強的視覺編碼器,為任務建立合適的外部視覺參照,也可能成為不需重新訓練的 visual skill;不過參照錯配會反過來干擾模型,因此它更適合研究團隊、MLLM 評測人員和需要分析多步視覺推理失誤的開發者。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, 模型, 多模態模型, 模型訓練, Qwen, Google, OpenAI, Gemini, API, Image, Python, Dataset 數據集, Skill 技能

Page 1 of 9
1 2 3 … 9