PhysRSI-Eval:量度機械人自我改進能力

固定模型、不改權重,讓智能體反覆嘗試雙臂機械操作,再評估技能、工具與記憶能否持續改進。

PhysRSI-Eval overview

機械人代理能否靠一次失敗改善下一次操作,而不只是模型本身更強?PhysRSI-Eval 是一套物理遞歸自我改進(physical recursive self-improvement,Physical RSI)評測框架,透過 RoboDojo 模擬環境量度這個過程,適合研究 LLM-as-policy 與機械人學習的團隊。

框架以 K0 基準及 K1 至 K17 最佳化回合運作:K0 在沒有既有工作區下完成操作,之後每輪保留技能、工具、策略程式碼與記憶;代理收到評分和失敗原因後,再修訂工作區。整個評估涵蓋 18 項操作任務,並以 First-Attempt Performance、Efficiency、Success、Budget、Improvement 五個維度記錄成果。

儲存庫提供可在自身機器運行的參考評估迴路,但只涵蓋論文泛化研究中的四項任務。RoboDojo、Isaac Sim、資產及 Codex CLI 均須從各自來源按固定版本安裝,因此成本與環境要求不會低;代理亦沒有系統提示、Shell 或網頁搜尋,只能使用指定機械人工具。

它與一般單次成功率測試的差別,在於保留整段改進軌跡,區分首次表現、後續增益及預算消耗。雙臂 End-Effector(EEF)每次最多移動 5 cm 或 0.35 rad,執行 1 至 5 個控制步驟,每輪模型時間上限為 4,200 秒,並以達到原生成功或回合上限作結。

  • 以固定模型測量工作區改進,避免把權限限升誤當成自我改進。
  • 同時觀察首次分數、成功時間、效率及改善比例。
  • 以持久技能、工具、策略和記憶支援跨回合修訂。
  • 以固定互動預算限制比較條件。

研究結果顯示,不同系統在空間、感知及編碼能力上的強弱並不一致,亦有模型未能解決部分任務。這個基準適合比較代理設計與泛化能力,但公開程式碼只覆蓋四項任務,完整結論仍須結合論文及其餘評估設定解讀。
項目主頁 · GitHub

Categories: 開源, 模型, 框架, 工具, 庫, Dataset 數據集, Skill 技能

Deepseek Recipe 幫本地推論後端連接多格式 API

在本地跑 DeepSeek 模型、想同時提供 Messages、Chat Completions 與 Responses 三種 API 格式?這個 Rust + Python 工具庫把格式轉換、prompt 渲染與 token 編碼一條龍包辦。

DeepSeek

對想自建 DeepSeek 推論服務嘅開發者來說,最頭痛往往唔係模型本身,而係點樣令自家後端兼容外界各種 API 格式。deepseek-recipe 就係針對呢個痛點而來——它用 Rust 寫核心邏輯,再提供 Python bindings,專門負責將 Messages、Chat Completions 同 Responses 三種主流請求格式統一轉換成 DeepSeek 內部嘅 Conversation 結構,再渲染成模型識讀嘅 prompt,最後用附帶嘅 tokenizer 編碼成 token ID。

呢個庫定位相當清晰:佢只處理格式轉換同 prompt 拼裝,模型推論、工具執行、HTTP 傳輸呢啲都交返俾呼叫方自己負責。換句話講,開發者可以揀任何推論引擎,再喺外面搭一層 recipe 做「翻譯員」,咁就可以用同一個後端撐起多個對外 API 端點。對於正在從 Ollama、vLLM 或自家 CUDA 服務過渡到 DeepSeek 模型嘅團隊嚟講,等於慳咗大量重複開發。

它對 DeepSeek V4 同 V4.1 有針對性處理:V4.1 支援圖像(會用 OpenCV 預處理),V4 則會把圖片替換成 [Unsupported Image] 字串,避免下游出錯。Thinking mode 方面亦照顧周到,無設定時自動補 8192 tokens,開啟 thinking 預設 65536,開到 max effort 就去到 131072。Structured output 同樣齊全,Chat Completions 嘅 json_schema、regex,以至 Responses 嘅 text.format 都做咗驗證同轉寫,並會喺 InferenceOptions 揀選對應嘅 OutputConstraint,畀呼叫方決定要唔要開 constrained decoding。

工具支援亦係重點之一。Function tools 全部覆蓋,V4.1 仲額外支援 Messages 嘅 deferred tool loading 同 Responses 嘅 client-executed tool search,對做 agent 框架嘅人特別有用。串流方面,token usage 會回報 reasoning_tokens,logprobs 喺 Responses 格式下亦會被轉成 InferenceOptions。不過要留意,圖片抓取組件 ReqwestImageFetcher 預設連任何地址都得,如果服務面向不可信來源,記得裝返 DestinationFilter。

GitHub

Categories: 開源, Agentic, 模型, NVIDIA, DeepSeek, API, Image, 框架, 工具, Ollama, Python, 庫, Tokenize

CoPE 讓 Agent 逐步預測行動,節省一半訓練樣本

CoPE 以多步行動預測補強 Agentic RL,在不增加推論成本下,提升語言智能體的學習效率。

CoPE

長軌跡只靠完結時一次獎勵學習,往往會令多數步驟欠缺直接回饋。CoPE 是建基於 AgentGym-RL 及 verl 分支的強化學習框架,透過逐步預測智能體接下來會採取的 K 個行動,為每個決策位置加入更細緻的訓練訊號。

模型骨幹同時負責 acting 與 forecasting:智能體按既有 policy 行動,並在每一步預測未來行動;完成 rollout 後,真實行動序列會監督預測結果,再把學習成果蒸餾回同一個 policy。關閉相關功能後,訓練路徑便維持標準 Group Relative Policy Optimization(GRPO),方便按研究需要比較。

  • 每一步預測 K 個後續行動,補充終結獎勵欠缺的分步監督。
  • acting 與 forecasting 共用一個模型,不需額外模型或預訓練階段。
  • 推理時仍逐步行動,不加入額外運算開支。
  • 支援 SciWorld、ALFWorld、WebShop、AppWorld 及 τ²-bench 五個互動環境。

結果顯示,CoPE 在上述環境擊敗 GRPO 與 predictive-auxiliary baselines;樣本效率最高提高 2 倍,其中 ScienceWorld 為 2.0 倍、AppWorld 為 1.6 倍。任務成功率相對 GRPO 在 ALFWorld、WebShop 與 ScienceWorld 分別增加 5.0、12.5 及 8.0 個百分點。

配置需要 Python 3.10 訓練環境及獨立環境服務;WebShop 使用 Python 3.8,τ²-bench 需要 Python 3.12 或以上,並須取得 AgentGym submodule。這套架構適合研究互動式語言智能體、計算成本受控的團隊,以及比較 action forecasting 與稀疏獎勵訓練方法的開發者,但多環境配置與 GPU 需求增加了安裝門檻。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 框架, Python, Meta, 強化學習

Scene-Designer:智能 3D 場景生成與設計

Scene-Designer 把場景生成、質素評估與反覆修正放進同一套 Agent 訓練流程,減少無效改動。

Scene-Designer bear logo

3D 場景生成最難的地方,往往不是砌出物件,而是知道場景是否合理,以及修正錯誤時避免愈改愈亂。Scene-Designer 是一個面向 Agentic 3D Scene Generation 的研究框架,目標正是讓模型學習設計場景、評審質素,再按評語作有效修正。

  • 以 Scene-OTA-35K 的 Observation–Thought–Action 軌跡學習設計與修改流程。
  • 透過 Scene-OTC-15K 的 Observation–Thought–Critic 經驗,比較場景質素。
  • 用 Branch-ranking reward 比較同一父場景產生的分支。
  • 以 Improvement reward 判斷子場景是否真正優於原場景。

Causal Trajectory Consolidation 會移除沒有下游貢獻的無效操作,同時保留有效決定及必要中間狀態。Scene perturbations 則刻意加入佈局偏差、功能退化和物理違規,再建立偏好比較,令模型不只是 spotting 錯誤,而是學習指出哪個場景較好。

Scene-GRPO 結合分支排名與改進獎勵,讓代理在相同起點的候選場景中選擇較佳設計,並減少沒有帶來實際進步的反覆修改。這種做法比只追求最終生成結果的訓練多了一層質素判斷,亦直接回應通用模型「識錯但不懂有效修正」的問題。

研究團隊比較了模型與 GPT-5.2 在成對場景比較及四場景偏好排序上的表現;首頁亦提供十組 prompt-to-scene 示範。不過,公開資料未交代完整安裝流程,Hugging Face 上已列出 Scene-Builder-Qwen3-VL-8B-Instruct 模型與 Scene-OTC-Bench 資料集,較適合具 3D 生成、Agent 訓練及模型評估經驗的團隊先行研究。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, OpenAI, 影像模型, World-Action Model, 框架, 3D, Dataset 數據集

OfficeTown 模擬真實職場流程

Office Intelligence 團隊把辦公室變成可執行的訓練場,讓 AI 代理用 Excel 等真實工具完成對帳、覆核等文書任務,再從中累積學習素材。

A cutaway office with research and analysis desks, a review meeting, and a shared-material cabinet. Four annotations explain roles, artifacts, review, and retained context.

文書工作不像回答一條 prompt 咁單純——開工前要先知道自己係邊個角色、手上有咩檔案、工具開咗未,做完仲要有人覆核。Office Intelligence 就係圍繞呢種「連續作業」嘅場景,幫知識工作代理(knowledge-work agents)搭建貼近真實嘅練習環境。

團隊將呢套框架劃分為四個部分:OfficeTown 提供可執行嘅工作環境,包括角色、權限與開機狀態;DocAtlas 處理文件層面嘅證據與脈絡;XL-DocBench 負責評估交付成果嘅品質;harness 則串接工具介面與審批流程。任務設計以「請求→證據→交付→覆核→下一個任務」嘅循環為核心,每次執行嘅過程都會留底,成為下一輪學習嘅素材。

以一個金融對帳任務為例,代理需要用 Excel 整理三條例外紀錄,喺交付嘅工作底稿中交代差異同處理建議,並標出尚缺嘅證據。呢類任務唔係計較答得幾快,而係睇交付物能否交到下一個人手上覆核。

呢個框架比較適合關注代理長流程作業、文件自動化同企業流程自動化嘅開發者同研究團隊。辦公室場景比純 prompt 模擬更貼近部署環境,對建立可審核、可追溯嘅 AI 工作助手有直接參考價值。OfficeTown 嘅公開版本仍在籌備中,有興趣嘅讀者可留意官方網站嘅後續更新。

項目主頁

Categories: Agentic, 模型訓練, 框架, 工具, 動畫

into-the-unknown:探索未知:AI 智能體能自主撰寫科學論文嗎?

把 15 個領域科學家親自為自己論文提出的延伸方向交給 AI Agent,要求 Agent 真的把研究做出來並寫成後續論文。

A path climbs a mountain under the night sky to an open door full of stars

與其請 AI 寫摘要、改改 bug,「Into the Unknown」要求 Agent 從零完成一段小型研究:閱讀一篇科學家寫的論文,再依據科學家親自提出的延伸方向,跑實驗、收集結果,最後交出一篇誠實且完整的後續論文。15 道題目橫跨不同學科,每一道都來自真正做研究的人對自己工作的下一步構想,而不是從公開資料庫拼湊出來的人工題。

針對想做比較的人,配套已經齊備:Hugging Face 上釋出資料集與 Agent 完整軌跡、檔案系統與產出論文,網站設有排行榜,歡迎提交新 Agent 的論文。Agent 端支援 Claude Agent SDK(opus-4.8、opus-5、opus-5.5、fable-5)、OpenAI Codex 系列(sol-5.6、astra-6),以及以 OpenHands 為底層的 glm-5.3。

想自建評測流程,只要 git clone 儲存庫、執行 prepare_tasks.py 把指定題目的程式碼與資料下載到 tasks/paper{1..15}/,再安裝對應 Agent 框架即可逐題評估。這樣做的好處是可以重現 Agent 的執行路徑與檔案系統,後續審視其論文是否真實反映實驗結果。

與一般 benchmark 不同,它考核的不只是答對或答錯,而是 Agent 面對開放、未定義的研究問題時,能否維持學術誠信並產出符合領域標準的成果。這對做 AI for Science、Agent 評測,以及想了解 Agent 在長程科學任務上瓶頸的團隊特別有參考價值。

項目主頁 · GitHub

Categories: 開源, Agentic, OpenAI, API, 框架, Clone, 庫, Anthropic, Dataset 數據集

yomado:給 Agent一個虛擬螢幕

yomado 讓 Agent 在虛擬螢幕操作 Blender、Marvelous Designer 等桌面程式,毋須為每款應用另接 MCP。實體屏幕可以保留給自己的工作。

yomado night-window icon

需要代理透過截圖、滑鼠和鍵盤操作 Blender 或 Marvelous Designer 時,桌面程式仍要有圖形桌面和顯示畫面。yomado 是一款 Mac 虛擬顯示器工具,讓代理使用獨立工作屏幕,毋須為每款應用另接 MCP;代理負責觀察和操作,yomado 則提供顯示空間。

它會按桌面排列顯示實體與虛擬屏幕,並在屏幕示意圖中標出應用程式。你可以拖曳圖示移動視窗,也可以手動移動;功能表按顯示器分組,並支援個別關閉視窗。隨附的 yomado skill 可引導 Codex 建立工作屏幕、移入指定視窗、確認畫面可見,並在任務完成後移回視窗。

  • 可為不同代理建立各自的虛擬屏幕,將工作視窗分開管理。
  • 可從 Finder 將正在執行的 .app 拖入,移動該應用的一般視窗。
  • 虛擬屏幕存在期間,程式會要求系統和圖形桌面保持喚醒。
  • 目前版本為實驗版,使用 macOS 14 或以上的 Apple Silicon Mac,並使用 macOS 私有 API。

這做法補足顯示空間,而非代理本身的視覺理解或操作能力;截圖、判斷和輸入仍由 Codex 或其他代理工具處理。對需要代理操作可視化介面、又想讓自己的實體屏幕保持原有工作的 Mac 使用者,分屏管理有實用價值。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, Google, API, Video, 工具, Mac, 蘋果, Skill 技能

Hy Memory 共享不同 Agent 的記憶

Hy Memory 的模型、框架、應用三層全開源。將聊天脈絡、工作進度與代碼修改原因分開管理,再讓不同 AI 工具共享同一份記憶。

Tencent Hunyuan

當 AI 需要記住的不只是單句事實,還包括事情是如何發展、任務做到哪一步,以及代碼為何這樣修改,Hy Memory 便提供了一套較完整的處理方式。它屬於面向 LLM agents 的認知記憶引擎與 Python SDK,將 Chat、Working、Coding 三類場景分開處理,減少長對話和長期任務中召回錯誤脈絡的問題。

Chat 以分層長期記憶整理事件及後續發展;Working 同時保存任務事實與可重用經驗,重用前會檢查適用條件;Coding 則以版本演化鏈追蹤每次改動,將相關指令、真實 diff 和指定函式區塊連結起來。這比單純把內容切段後交給向量搜尋更適合需要延續工作的 Agent,但也依賴清晰的 user id、workspace id 和代碼變更來源。

• 自動按工具呼叫及搜尋模式分流到三類記憶
• 支援記憶的新增、更新、刪除、列出及 System 2 演化
• Coding 可讀取本地 Git diff,亦可處理 path、old、new 替換記錄
• MemHub 將 Claude Code、Cursor、Codex、OpenCode 和 Qwen Code 等工具的資料集中管理

評測涵蓋四套 benchmark:LoCoMo 聊天記憶準確率為 72.6%,MemoryArena 工作記憶平均分為 55.31%,CodeMemoryBench 的問答及解決率為 64.2% 和 35.6%,SWE-ContextBench 解決率為 28.3%。官方亦指記憶儲存佔用維持在較低水平,但不同任務和資料來源仍會影響結果。

透過 hy-memory SDK 接入,按場景寫入及搜尋;不指定場景時,無工具呼叫的寫入會直接進入 Chat,帶工具呼叫的內容才會分類。Hy-Memory-30B-A3B 是負責記憶讀寫的專用模型,約有 3B 激活參數,並可與引擎分開使用;MemHub 則提供 local-first 桌面及 CLI 產品,適合需要跨 AI 工具延續對話或編程工作的個人與團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, 模型, API, 工具, IDE, Python, 編程, Dataset 數據集

DeepSeek 為 Agent 和 RAG 補上即時資料來源

DeepSeek Search 與 Fetch API 將網頁搜尋與單頁抓取整合成兩個 API,為 Agent 和 RAG 應用補上即時資料來源。

Og image

當 Agent 或 RAG 應用需要查找最新網頁資料,單靠模型內置知識往往不夠。DeepSeek API 現已提供 Search 與 Fetch 兩個原始 JSON API,讓應用程式可以搜尋網頁,再按需要讀取指定頁面的內容。

Search API 由 DeepSeek 自研搜索引擎支援,會按 query 返回結構化結果,包括標題、網址及摘要;將 need_content 設為 true,則可一併取得網頁正文。Fetch API 則針對單一網址抓取內容,並以 Markdown 文本返回,方便後續交給模型處理。

搜尋條件可透過 site:、lang:、after:、before: 及精確短語等語法收窄範圍,也能排除指定網站或關鍵詞。count 可設定返回 1 至 50 筆結果,ori_question 則可補充使用者原始問題,協助系統理解搜尋意圖。

• 適合建立需要即時資料的 Agent 與 RAG 工作流
• Search 用於找資料,Fetch 用於讀取指定頁面
• 支援中文及多語言搜尋條件
• 兩個 API 均使用 Bearer API Key 鑑權
• 搜尋沒有匹配結果時會返回空陣列

兩個接口共用 https://api.deepseek.com Base URL,分別對應 /v1/tools/search 與 /v1/tools/fetch。開發者需要自行處理 API 呼叫、結果篩選及網頁內容交給模型前的整理,文件目前提供 cURL 和 Python requests 範例,適合直接接入現有資料問答流程。

項目主頁

Categories: Agentic, RAG, DeepSeek, API, 軟件, Python

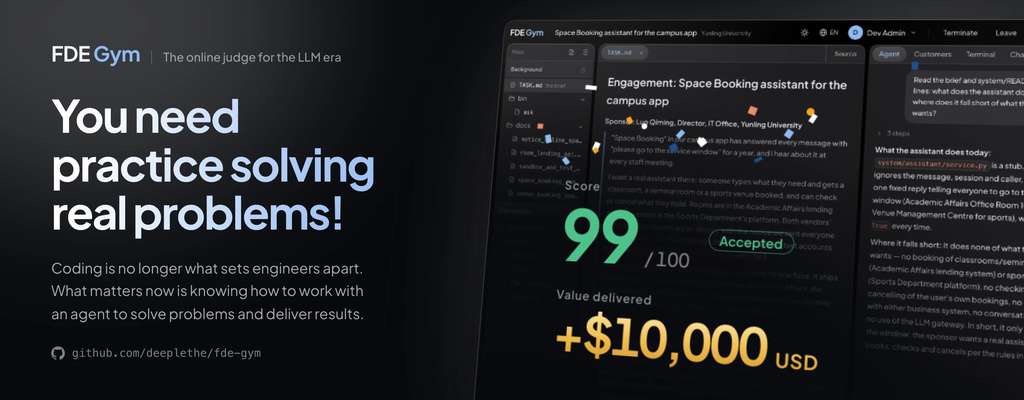
fde-gym:評測由寫程式推進到交付整個系統

FDE Gym 把 AI 評測放入真實交付場景,檢驗代理能否在資訊不完整下令系統真正運作。

FDE Gym, the online judge for the LLM era: you need practice solving real problems

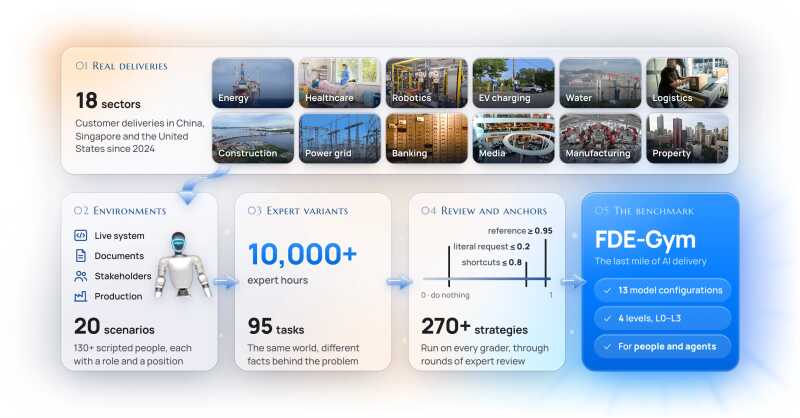
面對客戶只交來一段需求、現成系統、文件和幾位可詢問的人,AI 代理要處理的不只是寫程式。FDE Gym 屬於面向 coding agent 的端到端線上評測工具,將每個案例還原成 Forward Deployed Engineer(FDE)交付工作,最後按系統上線後面對的保留流量評分。

它刻意把需求澄清、未寫明的流程規則、人手介入時機和事故責任放入同一個工作流程。代理可以閱讀客戶交接資料、操作終端機、向相關人員提問,再交付可運行系統;評分不只看程式碼是否通過範例,而是看沒有預先展示的情境能否處理妥當。

• 20 個案例涵蓋端到端客戶交付情境
• 評測對象是 coding agent 及其交付的運行中系統
• 以 held-out traffic 檢驗未公開情境,而非只測固定輸入輸出
• 代理需要判斷哪些工作可自動化,哪些必須交由人員處理

相較經典 online judge 只提供完整題目、輸入輸出格式和樣例,FDE Gym 將模糊需求與現場決策納入評測,因此更接近企業採用 AI 代理時遇到的風險。不過,結果會同時受代理的提問策略、工具能力和交付系統質素影響,未必能單獨反映某個模型的程式編寫能力。

項目以 TypeScript 建成,提供網站工作台、案例管理及執行案例的機器;自建版本可配合 managed database 和 cloud object store,亦可新增案例及運行節點。案例資料另有 Hugging Face 資源,文件亦交代隔離範圍,適合研究團隊比較 coding agent、建立內部測試集,或讓負責 AI 產品交付的工程師測試代理能否處理上線後的未知情況。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 微軟, Vibe Coding, 工具, 編程, Dataset 數據集

Page 8 of 47
1 … 6 7 8 9 10 … 47