DeepMind Sierra AI 原生即時語音

Google DeepMind 與 Sierra AI 討論原生音訊模型,聚焦即時語音互動的速度、自然度與工程限制。

Og image

語音助手要做到自然對話,關鍵不只是把文字轉成聲音,而是要在用戶說話期間理解內容、掌握語氣,並快速作出回應。Google DeepMind 的 Valeria Wu 與 Sierra AI 的 Soham Ray 透過對談,介紹原生音訊模型如何處理這類即時語音 AI 的核心問題。

討論內容集中於 native audio models,以及建立更流暢即時語音系統時遇到的挑戰。相較於把語音先轉成文字、再交由文字模型處理的流程,原生音訊模型直接處理音訊訊號,有機會保留更多語調、停頓和對話節奏;但系統仍要兼顧理解準確度、回應延遲和運算成本。

內容涵蓋的重點包括:
– 原生音訊模型如何支援更自然的語音互動
– 即時對話中延遲與回應流暢度的取捨
– 建立高質素 voice AI 所面對的工程挑戰
– Google DeepMind 與 Sierra AI 對下一代語音體驗的觀察

這段內容適合關注語音介面、客服自動化、AI agent 和多模態模型的讀者。影片沒有提供完整技術規格或獨立效能測試,因此較適合作為理解發展方向與產品設計難題的入門材料,而不是部署指南。
影片介紹

Categories: Agentic, AI productions, 模型, 多模態模型, Google, Gemini, Video, Audio, 語音, 安全

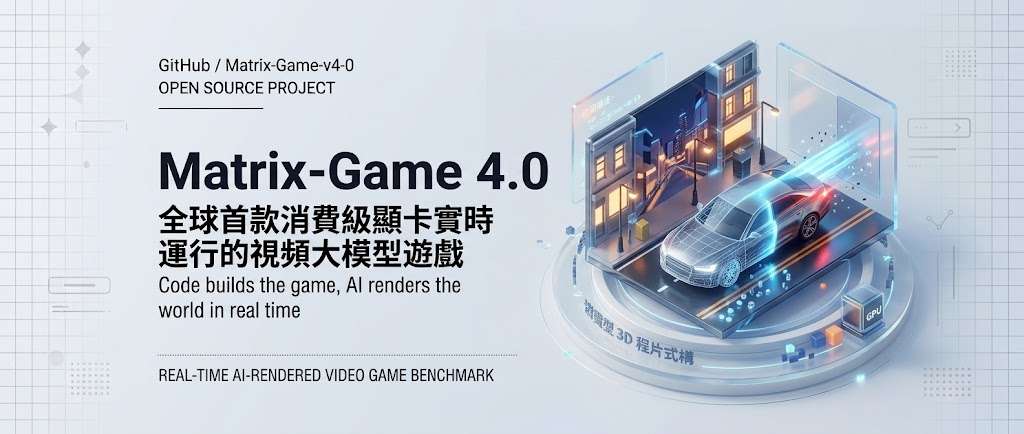
Matrix-Game:AI 即時渲染可玩世界遊戲引擎

Skywork AI 把遊戲引擎的穩定規則交給模型外的程式,再用因果視頻模型即時生成細緻畫面。

Repository image for SkyworkAI/Matrix-Game

玩家按鍵、物理碰撞和世界狀態由可執行遊戲引擎處理,低模 RGB 畫面再交給因果視頻模型轉成細緻影像。Matrix-Game 4.0 屬於開源互動世界模型項目,實際處理的是「畫面生成很逼真,但遊戲規則和長期狀態難以維持」的矛盾。

它把視頻模型限制在渲染工作,逐段讀取低模代理畫面、動態描述和參考影像,以蒸餾至一至兩步去噪的 causal DiT,每步生成四幀 latent。Coding Agent 可把玩家指令轉成新規則、修改遊戲引擎,並按相機位置檢索空間記憶,補足引擎未能直接表達的玩法。

  • Medieval Castle、Ancient Egypt 支援第三人稱射擊,City Racing 支援駕駛
  • 提供瀏覽器 Demo、離線渲染、模型權重與三款原生遊戲資產
  • README 列出 A100 與 RTX 5090 的單 GPU inference 路徑
  • RTX 5090 路徑加入 FP8 linear layers、fused kernels、CUDA graphs,並可選 SageAttention

和只靠逐幀像素外推的世界模型相比,Matrix-Game 讓規則可由引擎明確保存,減少物件離開視野後狀態消失的問題;代價是每個場景仍需配合遊戲程式、資產和模型。Matrix-Game 1.0 至 3.0 是前身,分別逐步加入即時長視頻生成及 long-horizon memory,4.0 則把重點推向可玩的引擎整合。

測試可先開啟線上瀏覽器 Demo,再按 v4 README 下載資源,選擇離線渲染或單 GPU inference。適合研究互動世界模型、遊戲生成、AI 遊戲原型及需要可控世界狀態的團隊;硬件需求、場景覆蓋範圍,以及 Coding Agent 生成規則的可靠程度,仍會限制它距離通用遊戲製作的距離。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視頻模型, 世界模型, NVIDIA, Video, Image, Vibe Coding, 編程, Dataset 數據集

ManimGX 高速 3D 動畫渲染

面向 AI agents 的 Manim 相容動畫引擎,以 Rust 和 wgpu 大幅縮短 2D、3D 教學動畫的製作等待時間。

ManimGX

製作數學教學片時,渲染速度往往比寫動畫程式更容易拖慢流程。ManimGX 屬於開源 3D 動畫引擎,兼容 Manim CE API,讓 Python 使用者可用熟悉的文字、方程式、曲面和鏡頭,處理 2D 與 3D 動畫生成。

它以 Rust 和 wgpu 重寫渲染核心,並加入完整靜態類型、關鍵字參數及 .animate 鏈式寫法;LaTeX 或 Typst 不需另行安裝。項目亦支援瀏覽器執行,透過 Pyodide 讓示範、教學或 AI agents 生成的動畫毋須先配置完整本地環境。

• M4 Pro、1080p60、五個場景合計 36.2 秒影片,渲染需時 3.08 秒
• 同一測試中,比 Manim CE 快 90.6 倍、ManimGL 快 11.5 倍、Blender Workbench 快 18.7 倍
• manimgx inspect 可檢查 storyboard、2D 版面,以及指定時間或播放結束時的畫面
• 支援語音同步,方便按旁白內容安排動畫節奏

安裝可選 prompt、PyPI 或 npm,適合數學教育、技術內容製作,以及需要反覆生成和檢查畫面的 agent 工作流。速度數字來自 Apple M4 Pro 的固定場景測試,不能直接代表所有硬件、動畫複雜度或互動需求;對已深度依賴 Manim CE 生態的團隊,API 相容性可降低遷移成本,但仍應先驗證現有場景和第三方功能。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, 教學, 3D, Python, 語音, 動畫, 蘋果

Urbex 讓城市級 3D 定位改用主動搜尋

Urbex 讓視覺語言代理在城市級 3D 場景自行搜尋證據,毋須預先建立物件候選框,定位能力與效率取捨更值得檢視。

Urbex logo

面對城市級 3D 場景,逐一比較預先產生的物件候選框容易拖慢搜尋,也會受候選品質限制。Urbex 屬於開源的 Agentic 視覺模型項目,將 3D grounding 改成主動空間搜尋,讓 vision-language agent 按需要查詢地標、縮放區域、切換斜視角,再提交目標 bounding box。

它不是只靠一次影像判斷,而是在互動式 multi-view environment 逐步收集證據。Reinforcement learning 同時訓練定位和搜尋決策,模型會學習應該檢查哪裏、何時縮窄範圍,以及幾時足以作答;這免除對 precomputed instance proposals 和 ground-truth boxes 的依賴,但每次搜尋仍要承受多步操作成本。

CityRefer 測試中,Urbex 的 ND Hit@1、Hit@3、Hit@5 為 25.8、39.2、42.3,NO 對應為 23.9、36.9、40.7,搜尋時間約 3.2 秒。相較 CityAnchor 的 32.1 秒,速度明顯較快;模型亦在 STPLS3D-Refer 取得 zero-shot 結果,反映跨場景泛化潛力,但不能直接等同於所有城市環境都同樣穩定。

• 支援 CityRefer 訓練及單查詢互動式 3D 推理
• 提供 Hugging Face 的 Urbex-4B 模型和 Urbex-Data 數據集
• 可透過 Colab notebook 試用預測視圖
• 安裝需要 Linux、Python 3.11、CUDA 12.8 及 C++ 編譯器

研究城市建模、3D 視覺定位或多模態代理的團隊,較適合用它測試 candidate-free grounding;想快速驗證概念的人則可先用 Colab。完整訓練需要 CUDA 12.8、Megatron Core、Transformer Engine 和 FlashAttention,硬件及環境門檻明顯高於單純推理,因此本地部署前應先確認 GPU、編譯工具和數據下載流程。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Image, 工具, 3D, Linux, Python, Dataset 數據集, 強化學習

CineRecon 以 Blender 重建實景影片

CineRecon 將影片重建變成可檢驗的 Agent 任務,要求模型由參考影片建立可編輯、可動畫化的 Blender 場景。

CineRecon logo

由完整參考影片出發,Coding Agent 透過 Blender MCP 撰寫及修改 Python,反覆比對渲染畫面,再建立包含幾何、材質、角色動作與鏡頭動畫的可編輯場景。CineRecon 屬於影片重建 benchmark,處理的是模型能否將時間連續的影像內容還原成可修改的 3D 工作成果,而不只是產生相似畫面。

項目以三個重建層級拆開能力差異:Proxy 只要求位置、互動及鏡頭運動,Simplified 再保留可辨認形狀和主要外觀,Detailed 則加入特色形狀、材質和細節。三個層級都要求相同的主體動作、事件及攝影機行為,方便分辨模型是只掌握構圖,還是能重建完整視覺內容。

  • 50 段參考影片,切分成 360 個評估片段
  • 35,836 筆獨立 checklist 記錄,按層級擴展至 49,668 項檢查
  • 評估 Camera、Static、Dynamic 三類一致性
  • 支援畫面選取、時間戳對齊、並行評分、續跑及分數彙總

評分由獨立 VLM judge 對齊參考與渲染影片,按片段 checklist 檢查 11 個類別,並以 Camera、Static、Dynamic 三個同等權重維度計算結果。這比單一影像相似度更能揭示鏡頭是否跟足、物件是否保持穩定,以及動作和事件有沒有在正確時間發生。

測試需要 Python 3.10 或以上,支援 Linux 及 macOS;項目提供資料、提示詞、驗證工具和離線 smoke test,但不包含 Agent launchers。團隊可先用離線流程確認資料與評分管線,再接駁 Blender MCP 和隔離 worker 執行重建;研究模型能力時,CineRecon 的價值在於把「看似相似」拆成可追蹤的鏡頭、靜態內容和動態內容,而不是只比較最後一段影片。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, 模型, 視覺模型, Video, Image, 提示詞, Vibe Coding, 工具, Mac, 3D, Linux, Python, 編程, Anthropic, 動畫, Dataset 數據集

Agent Sociodrama:以社交方式強化 Agent

北航與南洋理工團隊提出 Agent Sociodrama,追蹤多智能體對話中的情緒與關係演變,再以 Trajectory-Guided Persona Recasting 重新分配角色,部分場景準確率提升達 83.3%。

Repository image for lululu896/Agent-Sociodrama

多個 LLM agent 組隊做任務時,常出現一些尷尬的社交故障:掌握關鍵資訊的角色不發言、意見領袖把答案鎖死在錯處、有人越界卻無人制止。北京航空航太大學與南洋理工大學的合作研究 Agent Sociodrama,正是要把這些「社交病徵」量化,再對症下藥。

這個項目的核心做法是把每一次對話拉成兩條可追蹤的軌跡:每個 agent 的情緒狀態 S,以及彼此之間有向、不對稱的關係 R。系統在六款主流骨幹模型、五個社會情境中重播這些軌跡,檢驗它們是否符合社會學經典模式,並比對人類評審的判斷。當軌跡顯示團隊運作出現結構性偏差,便啟動 Trajectory-Guided Persona Recasting(TPR)診斷失敗根源,重新調整各 agent 的人格設定再重跑任務。

四個協作基準測試中,TPR 在異質與隨機初始的團隊組合上皆有改善,準確率最高提升 83.3 個百分點;在分散資訊合作及混合動機議題類任務中,三個場景擊敗 SOTOPIA 與 AgentVerse,Pareto 比率領先最多 37.5%。對於需要模擬談判、群體決策或角色扮演的研究團隊,這套框架把「為何對話走偏」變成可分析的數據,而非只能靠事後觀察。

目前已公開 fidelity 與 recasting 兩組實驗的處理結果、重算表格的腳本,以及 Tavern 繼承糾紛與 Lost at Sea 兩個完整對話範例;模擬引擎與 TPR 控制器則待論文獲接收後釋出。要快速理解這套方法,可以直接看 fidelity_tavern 資料夾內 Claude Sonnet 4.6 驅動的五位 agent 九輪對話,逐輪檢視 S 與 R 的更新。

  • 追蹤情緒狀態 S 與有向關係 R,建立可量化嘅多 agent 社交軌跡
  • 以社會理論模式同人類評審交叉驗證社交保真度
  • TPR 自動診斷團隊失敗並重塑人格,喺四個基準平均顯著提升表現
  • 已釋出數據、重現腳本同完整對話範例,方便本地分析

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, World-Action Model, 框架, Anthropic

tabulaflow:自然語言查數據(text2SQL)

TabulaFlow 讓使用者用自然語言分析、轉換和視覺化多種數據,並可由圖表追查背後的資料表與查詢。它適合需要跨資料來源探索數據、又要保留分析脈絡的團隊。

想查詢資料庫、整理檔案或探索 Hugging Face 數據集時,使用者可以用自然語言描述分析目標,再由 TabulaFlow 這個開源 Python 數據代理程式處理查詢和圖表。它支援 SQL 和圖形資料庫、檔案、Wikidata 及網頁,適合研究、數據分析和需要把數據功能整合進應用程式的團隊。

與以檔案和 Shell 為核心的編程代理不同,TabulaFlow 把表格當作主要工作單位。代理程式負責產生查詢和視覺化規格,系統則處理資料解析和圖表呈現,減少模型直接拼接資料值或 HTML 的需要;核心數據工作亦可在關閉 Shell 和檔案存取時運作。它仍能編寫程式、執行 Shell 指令和瀏覽網頁,但這些能力不是數據工作的必要條件。

每張視覺化結果都能查看所用的資料表,而資料表亦保留產生它的查詢,方便核對結果來源和重現分析。這對需要審視數據處理過程的團隊有幫助;不過,查詢是否符合使用者原意,仍會受問題描述和模型判斷影響,追蹤來源不等於保證結果正確。

項目提供互動式消歧、資料庫對話、研究資料庫建立及圖形數據查詢等示範。研究者亦可用配套工具進行 text-to-query 實驗;ARCS 是用來評估 SQL 問題歧義處理的基準,不是 TabulaFlow 本身的效能分數。文件列出安裝方式為透過 uv 安裝並設定模型供應商金鑰,支援哪些模型則需查閱其模型文件;提供的資料未列出完整操作流程或各資料來源的設定細節。

  • 支援資料庫、檔案、Hugging Face datasets、Wikidata 和網頁等來源。
  • 以查詢和視覺化規格驅動分析,資料解析及圖表呈現交由系統處理。
  • 圖表、資料表與來源查詢之間保留可追溯關係。
  • 適合數據分析、研究及建立數據應用程式;結果仍需按資料和查詢目的核實。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 工具, Python, 庫, 編程, Dataset 數據集

ExpActivator:讓 GUI 代理學懂何時啟用個人經驗

ExpActivator 不再把所有相關歷史硬塞進每一步,而是按畫面、時間與情境判斷哪些經驗真正適用。

當個人 GUI 代理執行多步任務時,相關歷史未必適合每一個畫面;ExpActivator 把這個取捨轉化成經驗啟用問題。它屬於免訓練的個人 GUI 代理框架,處理歷史操作何時應該介入當前決策,以及何時應該保持沉默。

逐步啟用會把新畫面放入凍結 GUI backbone 的 latent space,尋找相近的歷史狀態,再把對應動作交給 policy 作參考,代理可以採用、修改或拒絕。任務級啟用則只會在時間和情境都支持時提出重複意圖,否則選擇 abstain;相比把整段檢索歷史附加到 context,歷史不再被視為每一步都有效。

PersonalAlign 評估涵蓋 775 個個人化執行 episodes、7,915 個 actions,以及 215 個正面和 100 個負面 proactive suggestion states,測試 Qwen3-VL-8B、MAI-UI-8B、Qwen3.5-9B 和 GUI-Owl-1.5-8B。以 Qwen3-VL-8B 為例,ExpActivator 的開首步驟成功率為 70.06%,後續步驟為 26.67%,高於無歷史的 28.26%和 18.43%;研究頁亦報告平均軌跡步驟成功率提升約 28%,proactive suggestion 的 MCC 約為最強基線的 2.3 倍。

適合研究個人化 GUI 代理、重複工作流程和主動建議的團隊測試。項目不會訓練模型或預測參數,PersonalAlign 提供安裝及執行流程,但需另取 PersonalAlign 的 Fingertip20k;記憶應採用每位使用者按時間排列的前 80%,避免與執行測試 episodes 重疊。

  • 按畫面逐步啟用歷史動作,而非只按任務檢索
  • 按時間與情境判斷是否提出主動建議
  • 凍結 backbone,無需重新訓練模型
  • 同時測試個人化執行與 proactive suggestion
  • 依賴外部 Fingertip20k 歷史資料及多個 GUI backbone

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 庫, UI/UX

Work2Skill 把人手 GUI 操作變成可重用 Agent 技能

Work2Skill 將人手操作錄成多模態證據,再整理成 Computer-use agents 可重用的工作技能。

Work2Skill overview: human GUI demonstrations, multimodal recording, action-linked evidence, agentic skill induction, an

面對陌生桌面軟件,單靠任務描述往往不足以交代按鈕位置、操作次序及完成後應有的狀態。Work2Skill 屬於 GUI 操作記錄、數據集與 Agentic skill induction 項目,處理的是如何把人手示範轉成可供 Computer-use agents 重用的程序指引,而不是另一個獨立基礎模型。

WorkRecorder 將螢幕影片、關鍵影格、滑鼠鍵盤事件及可用的無障礙資訊放在同一條時間線,讓每個動作同時保留畫面背景和介面狀態。WorkDemo-350 收錄 350 個桌面示範、約 8.48 小時錄製內容,包括 64 個 MyPCBench 任務及選出的 286 個 OSWorld 任務;AgenticSkillInduction 則提供基於 NexAU 的技能歸納範例,將流程整理成可執行時參考的技能。

它和只保存點擊座標或純文字步驟的做法不同,保留了操作前後的多模態證據,較適合處理介面改變、控制項含義不明或需要驗證結果的工作。不過,項目目前仍有清晰限制:macOS 錄製器及 Linux X11 AT-SPI 服務已提供,跨平台現場驗收仍待完成;下游評估整合亦尚未完成。

網站列出的結果以 0 至 100 分的 MyPCBench 平均分計算,四個執行模型在加入技能後最高提升 10.54 分。對需要累積桌面工作流程、研究 Computer-use agents,或希望以共同示範數據比較技能歸納方法的團隊,這套資源較有參考價值;資料集與錄製資料放在 Hugging Face,完整錄製及技能流程則要按各子目錄指南處理,原始資料未提供單一即用安裝流程。

  • 核心價值: 把人手 GUI 經驗連同畫面、輸入及介面證據保存。
  • 資料規模: 350 個示範,涵蓋 MyPCBench 與 OSWorld 任務。
  • 技術組成: WorkRecorder、WorkDemo-350 及 NexAU 技能歸納範例。
  • 主要取捨: 證據更完整,但跨平台驗收和評估整合仍未完成。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, Video, 軟件, Mac, Linux, 中國, Dataset 數據集, Skill 技能

SoftwareGym 讓電腦代理在真實桌面中反覆修正

SoftwareGym 把可執行軟件變成訓練環境,讓 Computer-use agents 在真實 GUI 操作中接受測試與修正。

Repository image for MrKiing-Jin/SoftwareGym

要測試 ChatAPP、PicEditor 等軟件操作能力,單靠靜態截圖不足以反映代理能否完成任務。SoftwareGym 屬於環境合成管線,會生成具備介面及可執行功能的應用程式,再交由 Computer-use agents (CUAs) 在真實 GUI 中操作和驗證,處理訓練環境難以大量製作且欠缺互動性的問題。

流程由 FunctionDesigner 撰寫需求,StyleDesigner、SubStyleDesigner 產生 Avalonia .axaml 介面藍圖,IconDesigner 系列工具建立 SVG 圖示;Coder 再以 .NET 8 和 Avalonia 11 實作,DevCoder 按測試結果修補。各階段透過 Codex CLI 執行,EvalTaskGenerateAgent 負責建立 GUI 測試案例,GPT-5.4-style computer-use agent 或 Seed 則在 OSWorld 的 Ubuntu Docker 虛擬機內操作生成軟件。

  • 以 OSWorld 相同的 Docker、Ubuntu 桌面環境對齊後續評估條件
  • 透過 screenshots 與 PyAutoGUI actions 驗證真實操作流程
  • v1 至 v3 每輪把 summary.json 和審查結果交回 Coder/DevCoder 修正
  • runner-events.jsonl、GUIEval 分數及 cost summary.json 用於追蹤進度、品質和 token 使用量

這種做法把「生成應用程式」與「代理能否操作」放入同一個閉環,適合研究 Computer-use agents、GUI agent、軟件生成及 OSWorld 評估的團隊。README 提供輸出路徑、代理設定和執行紀錄格式;使用者仍需自行確認 Docker、OSWorld VM、Codex CLI 及相關模型環境是否已備妥。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, OpenAI, 軟件, 工具, Linux

Page 10 of 47
1 … 8 9 10 11 12 … 47