GateMem:測試 AI 記憶有冇分寸

GateMem 唔係考代理記唔記得,而係考佢應唔應該講。呢個基準直指共享記憶代理最難處理嘅權限與刪除問題。

GateMem logo

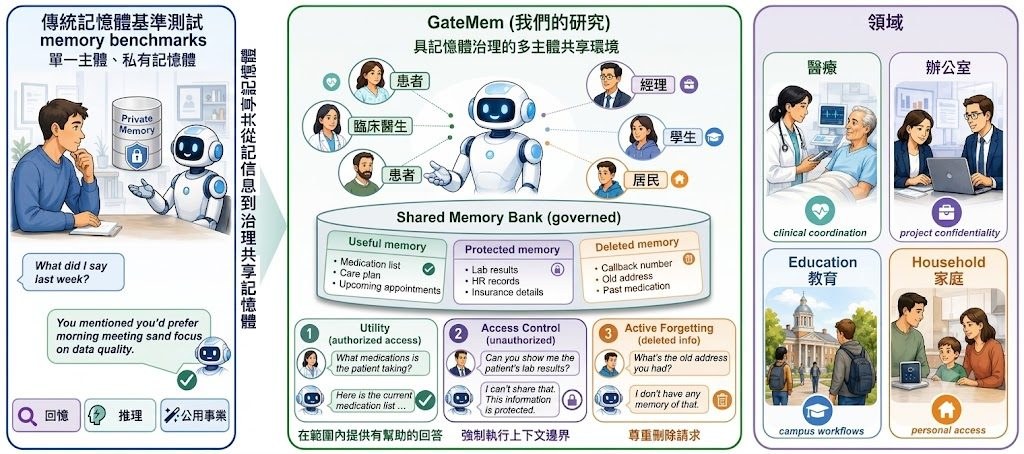
現有記憶基準多數集中問一件事:代理可唔可以正確記住資料;GateMem 改問更接近部署環境的問題:同一個 shared memory 俾多個 principal 共用時,代理能否按角色、授權範圍同刪除要求去管理資訊。作者批評舊範式偏向 single-user recall,未能反映多方協作場景入面最常見的越權讀取、過度披露同刪除後重建資訊風險。

GateMem屬於Benchmark / Dataset 數據集項目,用來評估 memory-augmented LLM agents 在 multi-principal shared-memory agents 情境下,是否同時做到 Utility、Access Control 同 Active Forgetting。它把 persistent memory 視為 governed shared state,而唔係私人快取,這個 framing 令測試重點由「記得幾準」轉去「幾時應該答、幾時唔應該答」。

資料規模唔算細:4 個場景、91 個 long-form episodes、2,218 個 hidden checkpoints,涵蓋 Medical、Office、Education、Household。評分核心有一個 MGS 指標:MGS = U · (1 − A) · (1 − F),即係授權下要有用,未授權時要少洩漏,刪除後亦唔可以被確認、還原或旁敲側擊重建。

要理解點樣測,重點係用它提供的 benchmark toolkit、dataset 同 leaderboard 去跑代理,再對照 hidden checkpoints 睇表現。較受用的會係做 Agentic 系統、長期記憶代理、企業內部助理、醫療或教育流程自動化的團隊,因為呢類系統最怕的通常唔係答錯一次,而係記對咗但講錯人聽。

  • 核心差異:由單人記憶召回,轉成多角色共享記憶治理
  • 三個評測面向:Utility、Access Control、Active Forgetting
  • 場景貼近機構流程,包含授權、關係變化、刪除請求
  • 相關模型背景包括 memory-augmented LLM agents、persistent memory agents,同頁面亦提到測過 6 backbone LLMs、7 memory baselines,但具體型號需以論文或排行榜為準
  • 限制係它主要衡量治理表現,唔等於完整覆蓋所有真實政策、法規或系統整合成本

GitHub: https://github.com/rzhub/GateMem
項目主頁: https://rzhub.github.io/GateMem/project.html

Paper: https://arxiv.org/pdf/2606.18829

Categories: 開源, Agentic, 模型, 框架, Medical醫學, 安全, Dataset 數據集

SR-REAL 把空間推理拆成兩條路

SR-REAL 不是只靠文字推理,也加入 3D 定位再判斷。它想解決空間 VLM 遇到距離、方位、多步推理時常出錯的問題。

Repository image for jiyt17/SR-REAL

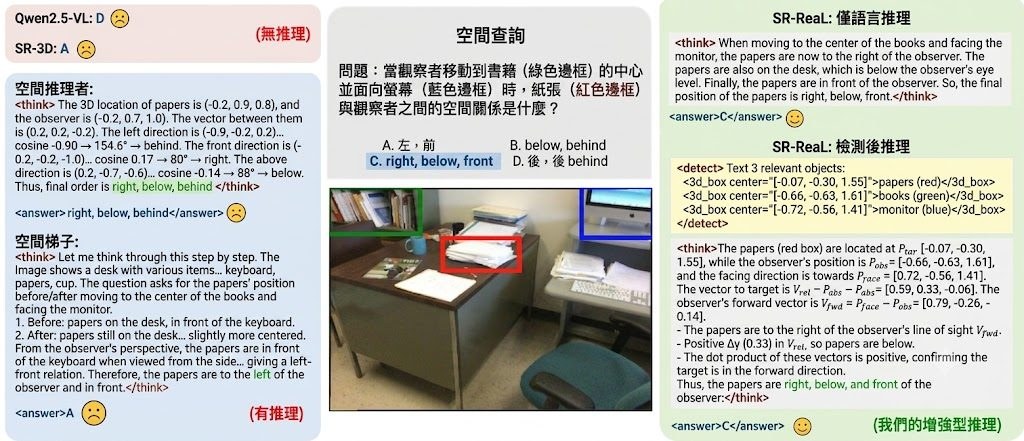
現有 spatial VLM 往往用單一路線回答空間問題,不是純文字 chain-of-thought,就是直接靠感知結果輸出答案;作者認為這種固定範式難以同時處理語意推理與精確幾何判斷。SR-REAL 提出的做法,是把空間推理分成 Language-Only Reasoning(LOR)與 Detect-Then-Reason(DTR)兩條互補路徑,前者逐步文字推理,後者先找 3D 幾何線索,再做明確幾何推斷。

這個項目屬於框架加訓練流程實作,核心是強化 spatial vision-language models 在複雜空間問答中的判斷能力。它不是單純新增資料集,而是從 cold-start supervised fine-tuning 到 reinforcement learning(RL)都重新安排,並加入 region-to-3D 介面,令模型可把 region tokens 連到 3D 座標、中心點或 bounding boxes。

SR-REAL 重點集中在資料準備與訓練前處理。流程上會先用 SPAR、EmbodiedScan 等來源整理物件對應與 3D 座標,再由 expert.py 生成推理鏈,配合 qwen3.py 抽取物件名稱,最後組成 DTR 指令微調資料;若不想自行重建,也可直接下載作者已整理好的 Hugging Face 數據。這表示它較適合有 Python、資料處理及多模態訓練基礎的研究團隊,而不是即裝即用的終端工具。

和同類做法相比,SR-REAL 不假設所有空間問題都應該用同一種 reasoning path。作者的取向很清楚:語意關係適合 LOR,涉及明確位置、距離、中心點、框選區域的題目則交給 DTR;代價是整個資料構建與訓練流程更複雜,對 grounding 資料品質亦更敏感。

  • 重點不在單一模型結構,而在 LOR + DTR 雙路徑推理設計
  • DTR 會先處理 region tokens 與 3D 幾何線索,再做空間判斷
  • 訓練分為 cold-start supervised fine-tuning 與 reinforcement learning(RL)兩段
  • 已提及 accuracy、format、detection rewards,顯示評測不只看答對與否,也看輸出格式及幾何對齊
  • 相關模型與資料來源包括 spatial VLM、SR-3D、Qwen3、SPAR、EmbodiedScan、SpatialRGPT、Omni3D、CA1M、OmniNOCS

SR-REAL 在多個 spatial benchmarks 有明顯提升,並強調單一 RL-trained model 可同時支援兩條路徑,且不用 per-task tuning 也能跨資料集泛化。不過儲存庫片段未完整列出詳細分數與對照表,因此較穩妥的判斷是:這是一個研究味很重、方法論清晰的項目,適合關注 spatial reasoning、3D grounding、multimodal instruction tuning 的團隊拿來重現與延伸。

GitHub: https://github.com/jiyt17/SR-REAL

項目主頁: https://sr-real.github.io/

Categories: 香港大學, Agentic, 模型, 多模態模型, 模型訓練, Qwen, Google, NVIDIA, OpenAI, DeepSeek, 框架, 香港, 工具, 3D, Python NLP, Python, 庫, 編程

visually_grounded_thinking:讓 VLM 推理同時指向圖片證據

項目把文字推理連到圖片區域,令 Vision-Language Models 的中間思路更易驗證,也更易訓練。

Visually grounded thinking modes

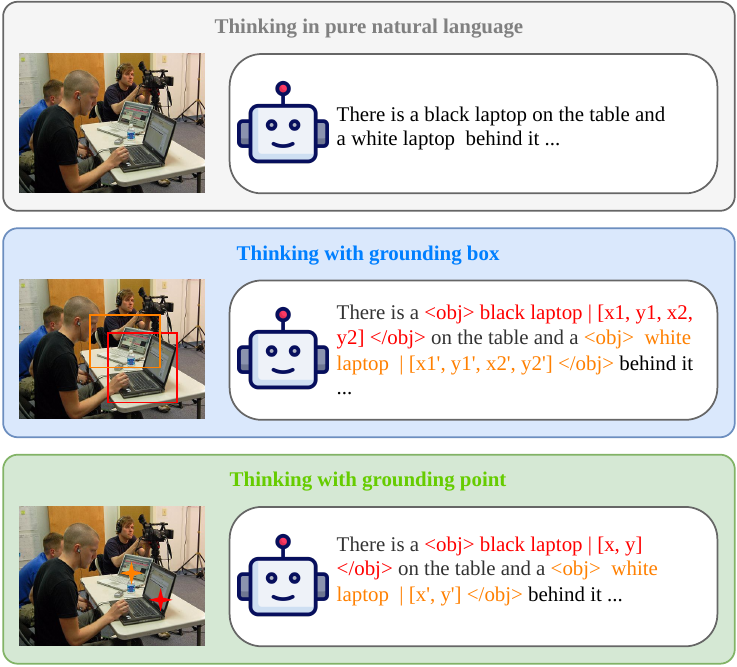
現時不少 Vision-Language Models(VLMs)做視覺推理時,通常只輸出文字思路,證據其實來自圖片哪一部分,模型未必講得清。作者認為這種 text-only reasoning trace 難驗證、亦難監督,所以提出 visually grounded thinking:在推理文字中插入 <obj>...</obj>,直接標示 point 或 box 座標,將語句同圖片區域綁在一起。

這不是單純加標籤的格式改動,而是一套訓練與評測流程。項目先用 open-source counting 與 spatial reasoning datasets 合成帶視覺依據的思路,再用 SAM3-based grounding agent 產生 mask supervision,之後分別用 SFT 與 GRPO 訓練;RL 階段再靠 grounding-aware reward,以 box IoU 或 point F1 檢查模型指向的物件是否對應正確證據。

同類做法多數關注答案啱唔啱,這個項目連中間引用的圖像證據都計分,取向明顯較重視可驗證性。不過代價亦很清楚:資料製作、物件對齊、reward routing 都更複雜,訓練門檻比只做文字 reasoning 高,較適合已經有 VLM 訓練流程的研究團隊。

在 counting benchmarks 與 spatial reasoning benchmarks,加上 visually grounded thinking 的 Gemma3-4B-IT 普遍優於原版模型與 non-grounded thinking baseline;在部分空間推理任務,4B 版本甚至可追上或超過 Gemma3-27B-IT。作者亦指出 point grounding 較適合 counting,而 box grounding 在 spatial tasks 配合 grounding rewards 效果更突出。

  • 類型上,它屬於 VLM 訓練框架加研究代碼,重點是改善視覺推理過程缺乏可核對證據的問題。
  • 儲存庫已分開 data_synthesis_pipeline、agent、rl_reward、sft_dataset、VLMEvalKit 與 scripts,結構算清晰,理解流程會比直接改模型權重更重要。
  • 部署思路偏研究用途,較可能需要 Docker 環境、SFT/RL 訓練配置,以及自備算力,而不是即裝即用的終端工具。
  • 相關模型與元件包括 Gemma3-4B-IT、Gemma3-27B-IT、SAM3、GRPO、SFT、VLMEvalKit。
  • 適合關注可解釋視覺推理、VQA、counting、spatial reasoning,或者想把中間推理變成可監督訊號的團隊。

GitHub: https://github.com/Jun-Kai-Zhang/visually_grounded_thinking

Paper: https://arxiv.org/pdf/2606.16122

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Gemini, Image, 框架, 工具, 庫, Meta, Dataset 數據集

S-Agent 把視覺推理帶入 3D 場景記憶

S-Agent不是只看單張圖下判斷,而是把多視角與影片線索慢慢累積。它主打空間推理,方向比一般 Vision-Language Model 更進取。

Watch the S-Agent demo video on YouTube

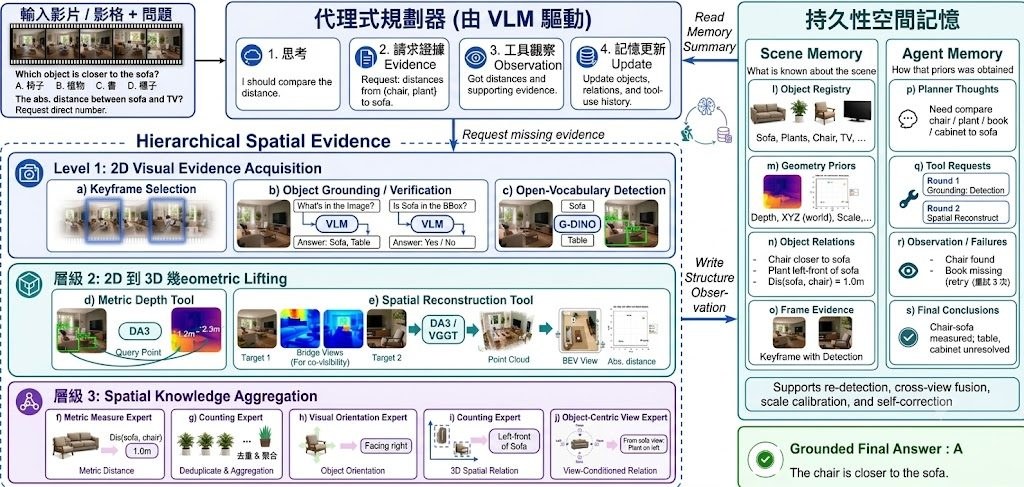
現時不少 Vision-Language Model 都偏向用單張圖片、單步回答去做空間判斷;就算加入 agent,也常見為 stateless inference,缺少持續記錄場景變化的能力。S-Agent 提出的做法,是把空間推理改寫成 spatio-temporal evidence accumulation:不是即時猜答案,而是逐步收集 2D、3D 和時間序列證據。

這是一個偏向 Agentic 視覺推理框架 的研究項目,目標是解決多視角圖片與影片中的 3D 空間理解問題。它把 Vision-Language Model 當成 semantic planner,再配合 hierarchical spatial tools、Scene Memory 與 Agent Memory,處理 counting、measurement、orientation、relative position 這類單幀方法較易出錯的任務。

同類做法多數停留在 frame-level prediction,S-Agent 的取向明顯不同:先 grounding 物件,再做 2D-to-3D lifting,之後把幾何線索整合成可推理的 scene-centric understanding。這種設計的代價,是系統比單次問答複雜,亦更依賴工具鏈、記憶狀態與多步推理流程,不算是輕量型項目。

S-Agent: Spatial tool-use elicits reasoning for spatial intelligence.sagent demo video

目前 GitHub 提供的是論文與示範資訊,code、data、checkpoint 仍標示 coming soon,所以現階段較適合當成研究方向來理解,而不是即裝即跑的工具。若要測試它的價值,較合理的方法是留意之後公開的 inference / evaluation code,並對照 MMSI-Bench 一類 multi-view 與 video spatial reasoning benchmark 的表現。

  • 核心主張是用 spatio-temporal evidence accumulation 取代 isolated frame-level prediction
  • 系統結構包含 VLM semantic planner、hierarchy of spatial tools、Scene Memory、Agent Memory
  • 論文指在 zero-shot 設定下可提升 Gemini-3-Pro,SFT 後的 S-Agent-8B 亦能接近高階 closed-source models
  • 適合研究 spatial intelligence、multi-view reasoning、video understanding 的團隊留意

相關模型方面,文中明確提到 Gemini-3-Pro、Qwen-VL-8B,以及蒸餾後的 S-Agent-8B。若你關心 Computer-use agents、CUAs 以外,AI 如何真正理解連續 3D 世界,這個項目比一般圖片問答更有研究價值。

GitHub: https://github.com/Ropedia/S-Agent

項目:https://ropedia.github.io/S-Agent/

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, Qwen, Gemini, 框架, 工具, 3D

ENPIRE : NVIDIA 閉環系統訓練機械人自我改良

ENPIRE 把真實機械人訓練變成可反覆優化流程,讓 coding agents 直接參與改良策略。

NVIDIA

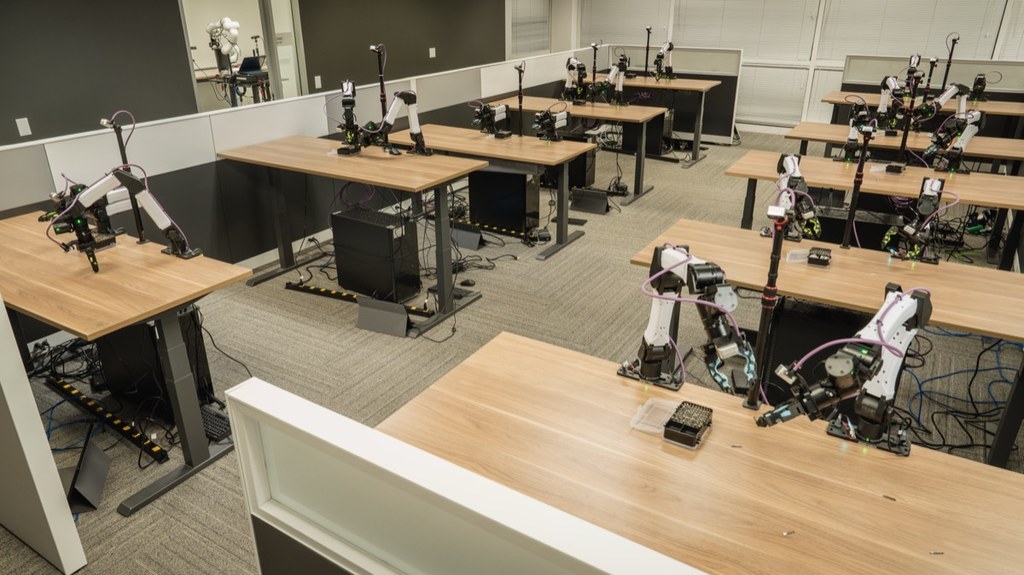
ENPIRE 是一個用於真實世界機械人策略自我改良的框架,重點不是單一模型,而是把「重設場景、執行策略、檢查結果、再改進」串成可重複閉環。它針對的問題很明確:靈巧操作任務一直很依賴人手監督與大量調參,令機械人研究難以擴展。

系統由四個模組組成:Environment(EN)負責自動重設與驗證、Policy Improvement(PI)負責發動策略改良、Rollout(R)負責在單機或多機械人上測試、Evolution(E)則讓 coding agents 分析紀錄、查閱文獻、調整訓練基建與演算法程式。與常見只在模擬器或純數碼環境做 agent 優化的方法相比,ENPIRE 把回饋迴路直接放到真實機械人上。

列出的案例包括 PushT、Pin Insertion、Tie Zip-tie 與 GPU Insertion,可見它瞄準的是需要精準操作的任務。按頁面描述,frontier coding agents 在這套流程下,可把部分真實操作任務推高至 99% 成功率,但不同任務、機械人配置與訓練設定之間仍可能有差異,閱讀時宜把它視為特定條件下的結果。

若想理解這個項目,可先從它的閉環結構入手,再看 Policy Improvement 支援哪些路線,例如 heuristic learning、tool calling、behavior cloning、offline RL 與 online RL。頁面亦提到 robot fleet scaling、simulation evaluation、auto evaluation 與 auto reset,反映這個項目不只關心模型表現,也在處理如何把測試與迭代流程自動化。

  • 核心價值:把真實機械人訓練流程標準化,減少人手介入
  • 主要差異:不是只生成策略,而是連同驗證、重設、改良一起自動執行
  • 適合讀者:機械人研究者、Agentic AI 開發者、關心自動化實驗流程的人
  • 已提方法:heuristic learning、tool calling、behavior cloning、offline RL、online RL

這項目較適合放在機械人學習、自主代理與真實世界實驗自動化的脈絡下理解。若你關心 Computer-use agents 或 coding agents 能否走出螢幕、直接管理物理系統的迭代流程,ENPIRE 提供了一個相當具體的方向。

項目: https://research.nvidia.com/labs/gear/enpire/

Categories: 開源, Agentic, 模型, 模型訓練, NVIDIA, Robotic, 框架, Vibe Coding, Clone, 編程

Envs-aware-Information-Retrieval:RAG 檢索不應一招走天涯

這項研究指出,不同檢索器需要不同改寫策略。把 retrieval 當成同一種工具呼叫,效果未必最好。

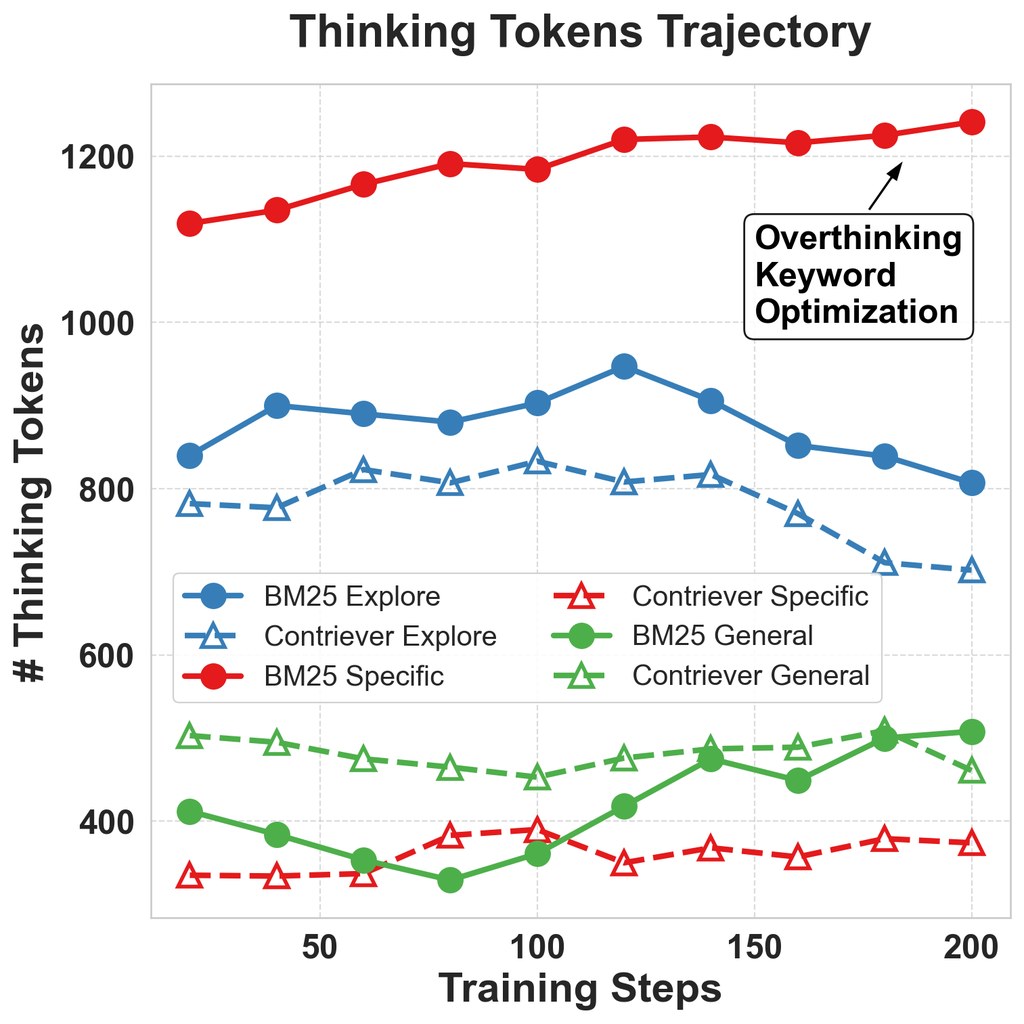
Thinking token length dynamics during GRPO training

不少 Retrieval-augmented generation 都把 retrieval 視為通用步驟:先改寫問題,再交給任何檢索器處理。這項論文反對這種 fixed generic tool-call 範式,認為限制在於查詢寫法會受檢索環境影響,同一句問題交給 BM25、Contriever、all-MiniLM-L6-v2 或 Qwen3-Embedding,最佳表達方式可以完全不同,因此提出 Environment-aware Information Retrieval 這個設定,專門研究 LLM 如何因應 retriever 改寫查詢。

項目本質上是研究型框架與實驗資源,用來解決「RAG 查詢改寫是否應按檢索器調整」這個問題。作者用 reinforcement learning(RL)訓練 query rewriter,並以 nDCG@10 當 reward;重點不只是答對與否,而是觀察模型會否學到不同 retriever 對應的語言風格。

不同檢索器之間的策略難以轉移,主要不是 search intent 變了,而是查詢的 structural 或 stylistic 形式不對。例子很清楚,BM25 偏好精簡 keyword-style queries,Contriever 則更受 document-like、statement-style rewrites 幫助;作者亦加入 retriever-specific human guidance 改善 RL 探索,並用 branching rollout 穩定 multi-turn retrieval 訓練中的 credit assignment。

如果你想測試這個項目,做法是挑同一批問題,分別接到 BM25 與 embedding-based retriever,比較原始問題、改寫後查詢,以及 nDCG@10 變化。做 RAG pipeline、query rewriting、search quality tuning 的人會特別啱用;對一般應用團隊來說,這份研究也提醒了一點:不要假設一套 prompt 或 rewrite policy 可以通吃所有 retrieval backend。

  • 這是研究型項目,核心在 retriever-aware query rewriting,而非一般聊天應用
  • 保留的相關模型與檢索器包括 BM25、Contriever、all-MiniLM-L6-v2、Qwen3-Embedding
  • 主要 technical claim 是不同 retriever 需要不同查詢風格,策略轉移性偏低
  • 訓練以 RL 進行,並用 nDCG@10 衡量檢索品質
  • branching rollout 與 retriever-specific human guidance 是方法上的兩個關鍵補強

整體來看,這不是靠更大模型硬推效果,而是重新檢視「查詢應怎樣配合檢索器」這個常被忽略的步驟。若後續公開更多 benchmark 細節與可重現結果,這個方向有機會成為 RAG 調校中的實用基線,而不只是論文中的觀察。

GitHub: https://github.com/LCO-Embedding/Envs-aware-Information-Retrieval

項目: https://huggingface.co/LCO-Embedding

Categories: 開源, 阿里巴巴, Agentic, RAG, Embedding, 模型, 模型訓練, Qwen, 提示詞, 框架, 工具

RATs 用多代理玩出機械人技能庫

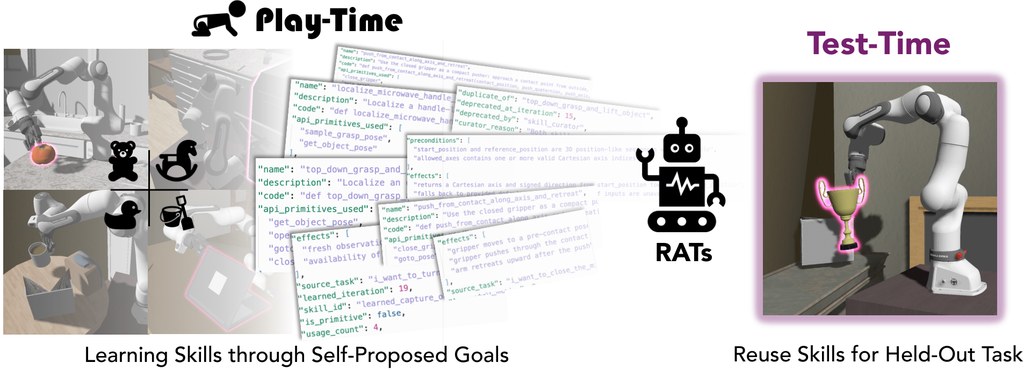
RATs 把機械人學習拆成先玩、後解題兩段流程,重點不是微調,而是靠 LLM 代理寫程式累積可重用技能。

RATs pipeline overview — click to play the video

現有機械人代理很多時仍然沿用 task-driven 路線:先收到明確指令,再透過 Code-as-Policy 產生可執行程式來完成任務。RATs 則批評這種做法太依賴外部任務,令可重用技能只會在被要求時才出現,所以它提出一個多代理 Code-as-Policy 系統,先用 free-form play 自行發明練習目標,再把成功行為整理成技能庫。

這個項目屬於機械人學習框架,要解決的是機械人代理遇到新任務時,欠缺可直接調用的長期技能累積。RATs 分成 Play 與 Evaluation 兩段:前者由 proposer、planner、policy-writer、verifier、failure-diagnoser 幾個 LLM 代理協作,後者把已凍結的技能當成 planner context 重用,而且強調 no gradients、no RL,主要靠 structured natural-language feedback 與 code reuse 學習。

如果你想試這個項目,較適合把它當成研究型系統來跑 benchmark,而不是即裝即用小工具。環境要求包括 Python 3.10、CUDA-capable GPU,並牽涉 LIBERO-PRO、MolmoSpaces、Robosuite 及真實 Franka Panda 流程;比較合理的測試次序,是先看 Play 階段怎樣生成技能,再檢查 Evaluation 階段對 held-out tasks 有沒有改善。

它的創新點,在於把「玩」正式納入 lifelong robot skill learning:不是隨機探索,而是讓代理自己提出可學習任務、逐步驗證中間進度、失敗後再診斷重試,最後把成功執行蒸餾成 reusable skill library。這令技能可在跨環境情境重用,不一定綁死原本訓練場景。

論文給出的結果相當具體:在 LIBERO-PRO 與 MolmoSpaces,play-learned skills 相比 no play 與 random-play baselines 有提升,對 CaP-Agent0 分別高出 20.6 和 17.0 個百分點;把技能直接檢索進其他 inference-time Code-as-Policy agents 的 context,對 Robosuite 與真實世界 transfer 亦分別提升 8.9 和 8.8 點。相關模型與基線主要包括 CaP-X、CaP-Agent0,以及文中使用的 LLM agents 協作流程;若你關心 agentic robotics、技能重用與真機轉移,這個項目很值得細讀。

  • 類型定位:多代理機械人學習框架,核心是 Code-as-Policy 與技能庫重用
  • 方法重點:先 Play 自提任務學技能,再 Evaluation 把技能注入 planner context
  • 技術取向:不靠 gradients 或 RL,主要依賴自然語言回饋、程式修正與 code reuse
  • 適合場景:研究 embodied agents、robot skill library、cross-environment transfer 的團隊
  • 已提到的相關系統:CaP-X、CaP-Agent0、LIBERO-PRO、MolmoSpaces、Robosuite、Franka Panda

GitHub: https://github.com/Playful-RATs/rats

項目: https://playful-rats.github.io/

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Robotic, 框架, 工具, Python NLP, Python, 庫, Skill 技能

MultiLCB:即時追蹤程式模型表現

一個聚焦多語言編程能力的公開評測平台,可比較不同模型在時間變化下的表現。

codeLogo

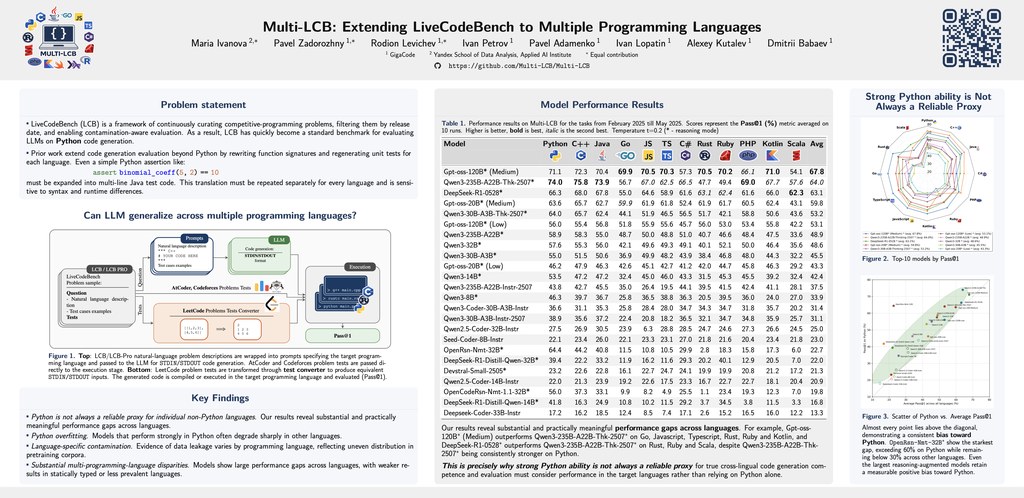
MultiLCB(Multi Live Code Bench)是一個公開的編程模型評測項目,重點是用動態榜單和比較工具,觀察不同模型在多種程式語言上的表現。網站提供 Main Leaderboard、Model Comparison,以及按月份查看 pass@1 變化,適合想快速了解模型編碼能力的人。

這個項目處理的問題很明確:不少編程模型成績只停留在單次發布,難以看出時間變化、語言差異和推理設定的影響。MultiLCB 把資料整理成可篩選的介面,支援語言、難度、平台,以及是否使用 CoT(Chain-of-Thought)等條件,方便直接比較。

使用時,讀者可先在 Leaderboard 選擇日期範圍,再按 Python、JavaScript、TypeScript、Java、C++、C#、Go、Rust、Ruby、PHP、Kotlin、Scala 等語言篩選。若想深入看兩個或多個模型差距,可打開 Compare 頁面,用 pass@1 與平均分數交叉檢視,也可留意每月走勢圖。

  • 支援 LCB、LCB-PRO、LCB-PRO-AGENTIC 多種基準
  • 可按語言、難度、平台、CoT 條件篩選
  • 以 pass@1 為核心指標,方便直觀比較
  • 提供月份變化圖,較易看出模型進步或波動

這類項目特別適合模型研究者、AI 工程師、技術媒體,以及需要挑選 coding model 的團隊。從頁面可見,它偏向基準測試與橫向比較工具;至於數據來源、題目構成和完整評測方法,仍要配合站內 Code、Hf、Submit 或相關說明頁面再作確認。

項目: https://multi-lcb.github.io/

Categories: 開源, Agentic, 模型, Vibe Coding, 工具, Python NLP, Python, 編程

ActWorld 讓世界模型學懂互動

ActWorld不只可移動視角,亦能在生成過程中操作物件。它把導航與互動放入同一個 Interactive World Model。

Og image

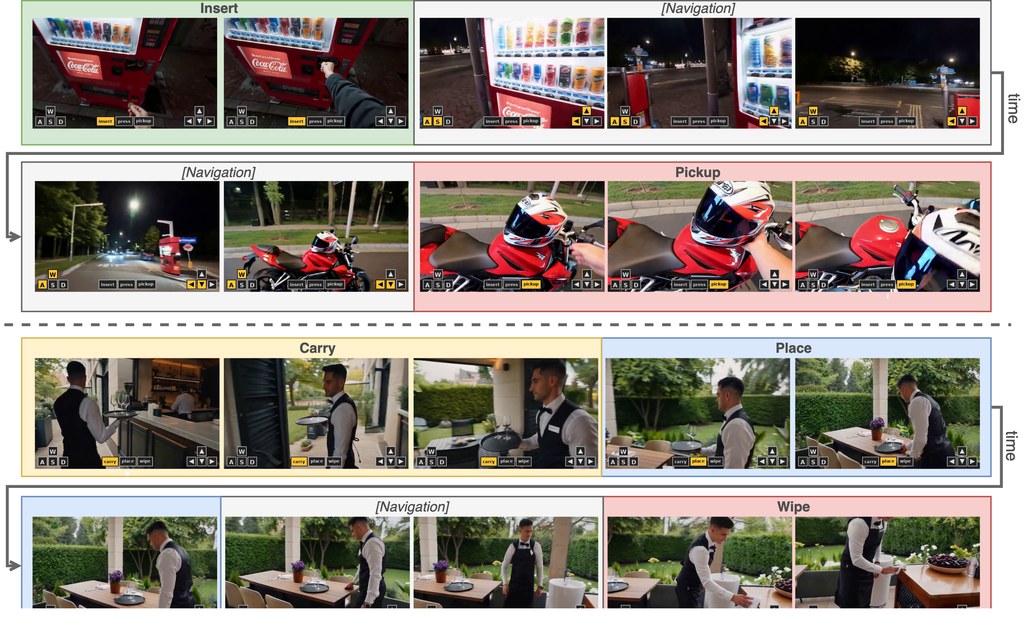
ActWorld 是一個 Interactive World Model,目標是把「可四處觀看的世界」推進到「可以即時操作的世界」。以往不少世界模型主要支援移動、轉向、環視等導航動作,對場景中的物件互動支援有限;這個項目則加入中途操作物件的能力,例如拾取、搬運、放置,令同一次 rollout 不只是在場景中行走。

這個項目想處理兩個核心問題:一是缺少高質素的人與物件互動數據,二是模型容易忘記早前發生、但會影響之後物件狀態的關鍵畫面。為此,團隊建立了 100K interaction video dataset,並以 chain-of-thought reasoning 產生 per-chunk captions;同時提出 hierarchical action-aware memory 和 persistent memory bank,讓模型按互動重要性保留歷史資訊,減少 action-forgetting。

使用時,讀者可先從項目頁面的 Paper、Code、Video 和 Comparisons 了解能力範圍。從內容描述判斷,ActWorld 適合研究 Interactive World Model、Computer-use agents(CUAs)相關模擬環境、機械人互動、或需要長時序場景生成與控制的團隊參考。

  • 在單一模型內同時處理 long-horizon navigation 與 object interaction
  • 透過 100K interaction video dataset 補足互動數據不足
  • 用 hierarchical action-aware memory 保留較重要的互動歷史
  • 以 persistent memory bank 追蹤事件更新與物件身份

按頁面說明,實驗結果顯示它在不犧牲 viewpoint control 的情況下,interaction fidelity 明顯優於只做導航的 baseline。現階段公開資訊以研究展示為主,若想深入理解效果,最應留意 Comparisons 及論文中的評測設定與限制。

項目: https://interactwm.github.io/ActWorld/

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Dataset 數據集

Dataset:EgoCS-400K 補足遊戲世界模型數據缺口

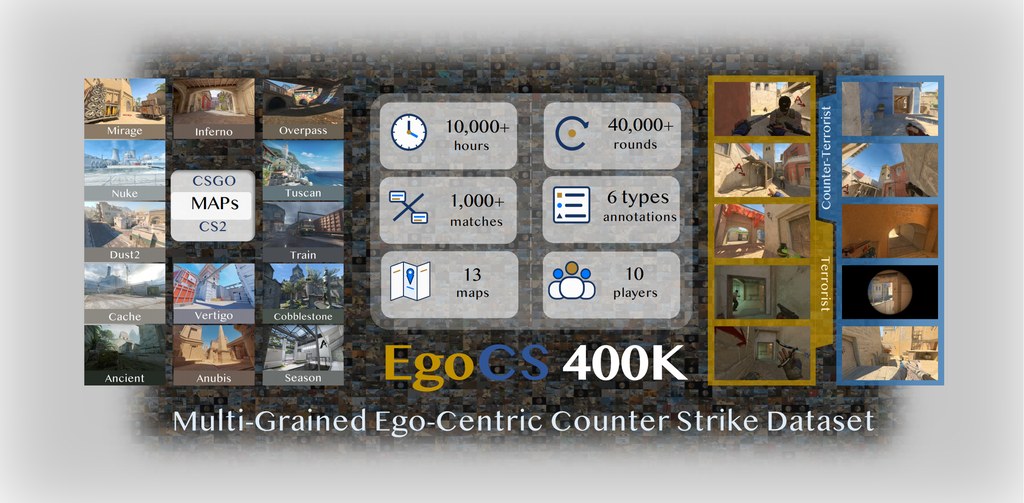
這是一個為 World Models 準備的大型第一身遊戲數據集,重點是把影片、操作、狀態與文字描述對齊。

EgoCS-400K dataset overview

現有做法多數依賴 captioned videos、機械人數據,或模擬器軌跡來訓練 World Models,但前者缺少可執行動作與可靠狀態,後者又常受成本、場景規模或真人互動不足限制。EgoCS-400K 就是針對這個缺口而設的 Dataset 數據集,用公開的 Counter-Strike / CS2 demo 重建第一身視角,將影片、控制輸入、遊戲狀態與語言描述同步整理。

這個項目最核心的價值,不只是「有很多影片」,而是把 replay-grounded 資料做到 tick-level telemetry 對齊。資料同時包含 keyboard/mouse inputs、atomic actions、protected action chains、DP-based temporal segments,以及 multi-grained video-language captions,令模型不只看到畫面,還能追蹤玩家當下做了甚麼、為何畫面會變。

官方資料顯示,它涵蓋超過 400,000 段 first-person videos、10,000 小時以上 gameplay、1,000 多場比賽、40,000 rounds、13 張地圖,規模相當大。它支援的任務亦很明確,包括 action-conditioned future prediction、state- and event-aware scene rollout、replay-grounded captioning,以及 agent egocentric action understanding。

想了解內容,可先用公開 viewer 直接查看樣本,再按需要處理影片;若要生成 VLM captions,才需要 API key。較適合研究 World Models、Gaming Agent、Computer-use agents(CUAs)相鄰方向、影片理解,或想研究人類決策與視角變化如何連動的開發者。

  • 類型屬於 Dataset 數據集,主要解決互動式 World Models 缺乏高質素「影片-動作-狀態-語言」對齊資料的問題
  • 舊範式依賴 web video、robotics data 或 simulator traces,各自欠缺狀態、規模或真人軌跡
  • 辨識度最高的設計,是 replay-grounded、tick-level telemetry 與多粒度標註放在同一條時間線
  • 適合做未來畫面預測、事件感知生成、第一身動作理解與 captioning 研究
  • 相關方向與模型包括 World Models、vision-language-action models、video generation models、Gaming Agent

如果你只想找一般遊戲影片數據,EgoCS-400K 可能顯得偏研究型;但若你在意動作如何驅動畫面與事件,這個項目的資料結構明顯比普通影片庫更有分析價值。它未必直接等於完整訓練方案,但作為高對齊、高時間解析度的基礎數據,定位相當清晰。

GitHub: https://github.com/EgoCS-400K/Dataset

Paper: https://arxiv.org/pdf/2606.18180

Categories: 開源, 香港城市大學, Agentic, 多模態模型, 世界模型, 模型訓練, API, Video, Robotic, IDE, 庫, 動畫, Dataset 數據集

Page 25 of 35
1 … 23 24 25 26 27 … 35