spillway:智能體免被攻擊工具,鎖定在用戶指定目標

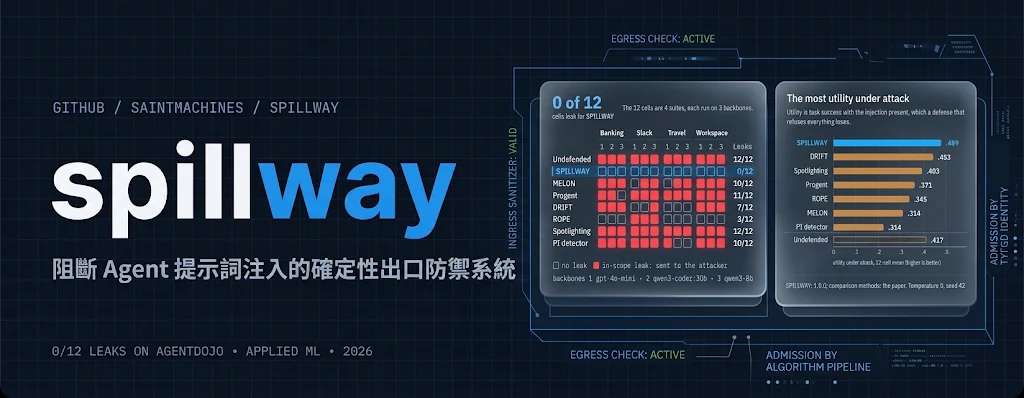
SPILLWAY 在工具執行前核對收件人與資源目標。標準攻擊測試中,2,847 組攻擊未有一次把操作導向用戶未指定的目標…

SAINT Machines

SPILLWAY 1.0.0 是一款即時安全防護工具,供 AI 智能體在執行操作前,核對收件人、帳戶或資源目標是否來自用戶任務。它處理的是提示詞注入 (Prompt Injection) 造成的越權操作,不是替模型判斷所有內容是否可信。

它先用結構化規則決定是否放行,再把工具回傳中有類型標記的欄位,與用戶的目標作集合比對。當電郵或網頁內的攻擊文字要求智能體把資料送往另一個地址,這個地址若只出現在攻擊者提供的文字,而不在用戶任務中,lookup 就會拒絕相關呼叫。

SPILLWAY 先依固定規則和目標比對作決定。管理者可選擇讓 local judge 檢查部分被拒呼叫,也可啟用 identity-target recovery;兩者在預設的 Guard(task) 中均關閉。

使用 AgentDojo v1.2.2 的標準攻擊測試涵蓋 Banking、Slack、Travel、Workspace 四個 suite,配合 gpt-4o-mini、qwen3-coder:30b、qwen3:8b 三個 backbone,共 2,847 組攻擊配對。SPILLWAY 在 12 個測試格中都沒有觀察到範圍內攻擊成功。這個結果表示測試中的攻擊沒有把操作導向用戶未指定的目標。

測試範圍亦包括 ChatInject 的 forged chat template 攻擊,共 665 組配對;以及 AutoDojo 的 389 組已發布、由最佳化器生成的攻擊配對。AutoDojo 結果被文件標註為 descriptive,且所提供內容沒有列出其限制細節。這些數字應視作特定測試集的觀察,不宜延伸成對未知攻擊的保證。

安裝需要 Python 3.10 或以上,項目文件提供的套件版本為 spillway-guard 1.0.0,可用 pip 安裝。安裝後,團隊仍需把防護接入智能體的工具呼叫流程,讓規則在操作執行前檢查目標;文件亦提供瀏覽器試用入口。對已有工具型智能體、且需要限制外發地址或資源操作的團隊,測試時應先用自己的任務與工具回傳驗證規則,再確認 judge 和 recovery 是否符合安全政策。

  • 先以用戶任務和 typed tool returns 比對目標,再按固定規則決定是否放行。
  • Local judge 與 identity-target recovery 均為可選功能,預設關閉。
  • AgentDojo 標準攻擊測試中,12 格均沒有範圍內攻擊成功,UAU 平均值為 .489。
  • ChatInject 測試涵蓋 665 組配對;AutoDojo 涵蓋 389 組,後者結果屬描述性資料。
  • 安裝要求 Python 3.10+;歷史成本數據未有為 1.0.0 重跑。
項目主頁 · GitHub

Categories: 開源, Agentic, 模型, Qwen, Gemini, 工具, 安全

Axiom大師班-智能體工程(ADK & MCP)

GoTech World 2026 的一日實作課以 Antigravity IDE 和 Gemini 3.5 Flash… Axiom Masterclass:把程式代理納入人手把關的工程流程

Repository image for gsans/axiom-masterclass-gotech-world-2026

讓 coding agent 改程式碼時,工作可以在獨立 Git worktree 進行,再交由人手批准、確定性檢查和獨立 reviewer 把關。Axiom Masterclass 是一日實作課,面向 GoTech World 2026 的參加者,聚焦 Agentic Engineering(智能體工程)及 ADK(Agent Development Kit)與 MCP(Model Context Protocol);活動於 Tue 10 Nov 的 10:00–17:00,在布加勒斯特 ROMEXPO Pavilion B1 舉行。

課程提供 Antigravity IDE 的 code labs,參加者可在每個時段開始時更新 repo,取得當日發布的 lab。notebooks/ 內有各 block 的唯讀參考筆記,適合跟着內容核對,而不是直接當作可執行練習。項目文件沒有列出 labs 的具體發布時間,亦未交代各 block 的詳細課程安排。

正式活動前,參加者要安裝 Antigravity IDE (Standalone),並以個人 Gmail 登入;另外還要在 Google AI Studio 建立 API key。兩者用途不同:IDE 登入本身不會提供 code labs 所需的 API 存取權。API key 需要放在本機環境設定中,並避免貼到聊天或提交至 Git。

一般環境需要 Node.js v20 或更新版本,以及 Git。安裝依賴會下載約 380 MB,宜在網絡穩定時預先完成;之後執行 npm run verify,由 verify.mjs 檢查 API key,成功會顯示 Ready for Tuesday,失敗則提示需要修正的內容。項目文件亦提供 setup guide 和 Slow Engineering Field Manual 兩份 PDF,供參加者事前準備。

免費 API key 配合 Gemini 3.5 Flash Lite 約有每日 60 requests,而每次向 lab agent 提問會消耗 2 至 6 requests。免費層每週 quota 亦較少,因此文件要求參加者在 Tuesday 前不要於 Antigravity 執行 agents;這會限制預先試跑的次數,測試時應先保留額度給課堂練習。文件沒有說明每日配額是否適用於其他模型。

收尾示範 Mission Control,展示一個 coding agent 如何在獨立 Git worktree 內工作,再由 human gate、人手可控的批准點、deterministic checks 和 independent reviewer 分別把關;操作可用 clicks 或 voice。這套流程比單靠 agent 自行完成更重視審核與可檢查結果,但多了人工關卡和檢查步驟,工作流程也較複雜。

  • Antigravity IDE 與 Google AI Studio API key 必須分開準備。
  • 執行一般 code labs 需要 Node.js v20 或更新版本及 Git。
  • npm run verify 可在活動前確認 API key 是否可用。
  • 每個 block 開始時以 git pull 取得新 lab;發布時間未有說明。
  • Mission Control demo 另需 Python,並有獨立 setup;Python 版本要求未列明。

這項課程較適合想親手走過 coding agent 開發流程、並了解人手審批與自動檢查如何分工的工程師及團隊。要自行執行 Mission Control,除 Node.js 外還要準備 Python;而 repo 的一般安裝步驟只明確列出 Node.js v20 或更新版本及 Git。項目文件沒有提供發布節奏或維護活動資料,參加者宜按活動安排預先完成環境檢查,並把免費配額留到課堂使用。

GitHub

Categories: 開源, Agentic, MCP, 模型, Google, Gemini, API, Vibe Coding, IDE, Python, 編程, 語音

rea-video:逐鏡反推還原影片製作路線

將影片拆成拍攝、生成與程式動效等不同做法。rea-video 逐鏡整理畫面、剪接和聲音,輸出可供人閱讀或交給 AI agent 使用的製作方案。

rea-video

一條影片可能混合實拍、AI 畫面、程式驅動的動畫和螢幕錄影,這些製作方法卻各不盡相同。rea-video 是一個強大的影片分析工具,會逐鏡判斷素材類型,再整理重製所需的拍攝、生成或編碼工作;它只提供完整方案,不會直接生成成片。

安裝十分簡單,你只要把本地影片交給能執行命令的 AI agent,例如 Claude Code 或 Codex 輸入 「安裝 https://github.com/JuneYaooo/rea-video,然後拆解這個影片」 ,agent 便可運行分析流程。執行環境需要 ffmpeg 和 Python 3.10+;目前文件沒有列出硬件需求、模型規模或 CLI 版本。分析結果有兩種形式:report.html 或 PDF 方便閱讀,VIDEO.md 則按層整理,讓 AI 只讀取回答問題所需的內容。

它不止能辨認實拍與 AI 生成,也包括 Avatar、3D/動畫、程式模板、螢幕錄影,以及混合剪輯。每個鏡頭會放回原有時間線理解,並可記錄字幕出現時間與樣式、貼圖位置、畫中畫、剪接節奏、音樂和音效落點。若畫面由程式動效構成,結果可整理成 Remotion 項目;字幕則可匯出為 SRT 或 ASS。

這種逐鏡拆解,對想參考短片製作自家廣告的內容團隊尤其實用:先看哪些畫面需要自行拍攝,哪些可用生成模型處理,哪些其實用程式重建更合適。以一段 70 s、12 個鏡頭的產品宣傳片為例,83% 是程式動效,12% 是螢幕錄影;案例認為整片可用一個 Remotion 項目製作,不必依賴影片模型。這個例子說明,拆解結果可能把製作方向由生成畫面轉向程式編排,但不代表所有宣傳片都適用同一做法。

若要分析實拍、AI 與 3D 畫面的來源,離線工具可先提供判斷,再由 agent 複核有疑問的鏡頭。接駁 Gemini 或 Doubao 等支援影片的模型後,live/AI/3D 判斷會更準確,並能替每個鏡頭加入反推提示詞;不接模型也能運作。燈光分析涵蓋 12 種布置,並可附器材清單,方便把觀察結果轉成拍攝準備。

  • 實拍素材偵測率為 97–99%。
  • 9 段人工標註片段的鏡頭邊界召回率為 95%,精確率為 94%。
  • 按鏡頭時長加權的來源判斷,Tuning set 有 15 個樣本,離線工具結果為 98.3%。
  • Holdout 有 16 個樣本,離線結果列為 99.6%/98.9%;接駁 Gemini 後為 99.6%/99.8%。
  • 10 個重新編碼的 WeChat 影片,離線結果為 88.6%;接駁 Gemini 後為 99.6%,再由 agent 視覺複核則為 100%。
rea-video, 复刻视频神器,8.8k star,解读+实测

這些數字不能直接套用到所有影片。平台重新壓縮會抹去雜訊等判斷線索,令離線工具在 WeChat 影片上明顯吃虧;視覺複核有助恢復準確度,但也表示結果仍需要人或模型檢查。項目提供 eval/RESULTS.md 重現評估;示例影片經重新壓縮後亦可能失去 TikTok/Douyin 平台標籤,因此自行重跑的結果可能與原報告不同。

分析只能從成片線索推斷製作方式,不能保證還原原作者的實際流程。對創作者、影片製作團隊和需要整理拍攝素材的行銷人員來說,它適合用來估算各鏡頭的製作路線與所需素材;最終拍攝、生成和剪輯仍要在其他工具中完成。

項目主頁 · GitHub

Categories: 開源, 字節跳動, Agentic, AI productions, 模型, Gemini, Video, Audio, 提示詞, 工具, Content Creator, 3D, Python, Anthropic, 動畫, 音樂

screenwriting-skills:把劇作方法拆成 26 個 Agent 技能

一套供 Claude Code 與 OpenAI Codex 共用的劇作技能庫,涵蓋結構、人物、對白及電視策劃,並以 47 本書與 23 部劇作整理出可執行的方法。

Repository image for jtydhr88/screenwriting-skills

劇作家教與 AI 之間一直有種微妙的距離:前者提供判斷與取捨,後者擅長把要求變成文字。screenwriting-skills 選擇讓 AI 補上前者,把劇作、電視寫作與戲劇理論拆成 26 個 Agent 技能,直接處理結構設計、人物衝突、對白修訂和劇集企劃,而不是只提供一份「寫劇本」的通用提示詞。

這是一套 Agent 技能庫,不是另一個劇本生成模型。它把 47 本劇作技術書與 23 卷中、美、英、日、韓的公開劇本、劇評及戲曲資料濃縮成可由代理程式按需調用的工作流程。電影項目可用一般戲劇理論、劇本格式與改編方法;劇集則再加上季與集結構、故事引擎、編劇室運作等媒體專屬層次。

它與一般提示詞最明顯的分別,在於能連同術語一起工作。logline、act out、beat sheet、showrunner 等概念會對回原始英文,避免不同中文譯名造成理解偏差;遇上沒有直接對應的詞,例如戲眼、扣子或日語的ト書き,便保留原詞再附解釋。技能本體以中文撰寫,但用戶用英文、日文、韓文或法文提問,代理程式便以相應語言回覆,劇本本身也不會因討論語言而被迫轉換。

安裝並不複雜。Claude Code 可以經插件市集、個別使用者或指定項目三種方式載入;Codex 則可從同一套插件市場安裝,也能把技能放入通用技能目錄。檔案依循 agentskills.io 標準,沒有綁定特定代理程式,因此同一份技能檔可跨 Claude Code、Codex,以及其他支援該格式的工具使用,不必為每個平台各維護一套內容。

這套設計也有明確的代價。非中文讀者若要核查技能如何定義流程,便要依賴代理程式的解釋;團隊成員之間也很難像查閱英文文件那樣直接審核同一條規則。項目早前曾保留英文版,但多語版本一旦分叉,便需要持續同步修改,最終選擇以單一中文來源配合執行時多語輸出。

  • 26 個技能覆蓋一般戲劇理論、電視劇集、舞台劇與不同地區的編劇實務
  • sw-workflow 負責統籌項目階段、交付物與各技能之間的銜接
  • sw-series-structure 處理集數劃分、幕結構、資訊投放與季終收束
  • sw-dialogue 與 sw-scene-craft 分別針對對白和場景推進提供修訂框架
  • 同一套技能檔可同時供 Claude Code 與 OpenAI Codex 使用

適合進修編劇課程的學生、獨立編劇、劇集策劃人,以及需要在團隊內統一結構語言的編劇室。對已經熟悉劇作理論的人,它更像一套可查閱、可組合的工作手冊;對初學者,則能提供一條由企劃到修訂的清晰路徑,但生成結果仍要經人手判斷,不能把節拍表或人物弧線直接當成好劇本的保證。

GitHub

Categories: 開源, Agentic, 模型, OpenAI, 提示詞, 框架, 工具, 庫, Anthropic, Skill 技能

music-skill:MIDI 音樂生成可編輯樂譜

music-skill 會實際寫出和弦、聲部與編曲,並能檢查和修正。不靠音訊生成模型,而是由 Agent 寫作音符,再經取樣樂器播放、混音及母帶處理,輸出可修改的 MIDI 與分軌。

music-skill

music-skill 是一套 Agent Skill,把「生成一段音樂」改成較接近作曲與小型錄音室的工作:Agent 逐個寫出音符,檢查樂譜,再以取樣樂器播放,經過混音和母帶處理輸出成品。它不直接生成聲音,也不涵蓋歌唱或歌詞;核心產物包括 MP3、WAV、MIDI、各聲部 stem,以及可以改音符後再次渲染的項目檔案。

Agent 可以調整「某個和弦的 voicing(和弦聲位)」,表示它不是只填一組和弦名稱,而是會安排實際音符。所以,你可以要求它例如:「用 C 大調寫一段 I–vi–IV–V 的進行,鋼琴右手彈分解和弦、左手低音,弦樂做 pad,並避免平行五度」,它將會完成對應的檢查與修改機制。

它具備基本的和聲與聲部寫作檢查:

  • Review 會標出聲部之間持續的小二度與九度不協和音程。
  • 它會辨識和弦外音,並區分經過音、掛留音及其他裝飾音;若某個和弦外音沒有以級進解決,也會提出來。
  • 它會檢查獨立聲部之間的平行五度、平行八度,以及過低音域的緊密音程

使用時需要先把 Agent Skill 安裝到支援該技能的環境,再依賴 Surge XT 播放樂器。渲染器可透過 --jobs 控制同時處理的聲部數;合成器或效果器聲部較多時,每個同時渲染的聲部可能佔用約 2 GB 記憶體,記憶體不足便會自動減少並行數量。

这套方法較適合配樂原型、影片音樂初稿,以及需要保留可編輯樂譜的製作流程。項目文件展示六種模型的一次性作品,但沒有提供標準化比較結果;質素評估因此仍要配合實際聆聽,而不能只看輸出格式。

GitHub

Categories: 開源, Agentic, AI productions, 模型, Video, Audio, 提示詞, 音樂, Skill 技能

Gemini for Healthcare:智慧醫療代理與臨床流程整合

Google Cloud 推出醫療專用方案,以 Gemini agent 串接臨床、保險與行政系統,減少資料核對時間並保留人工監督。

醫護與行政團隊面對的其中一項麻煩,是同一個問題往往分散在病歷、保險政策、臨床證據及行政工具內;要取得完整答案,人工需要反覆核對。Google Cloud 推出的 Gemini for healthcare,是把通用 Gemini agent 延伸到醫療場景的專用方案,核心作用是在既有系統之間協調多步工作,並保留人員監督。

這套方案與一般聊天式 AI 的分別,在於它不只回答問題,而是規劃步驟、保留組織脈絡,再按工作需要調度不同模型與工具。醫療團隊可藉此串連臨床、財務和行政流程,例如整理不同就醫階段的病歷、預備診前紀錄,以及處理保險授權等事項。

Gemini for healthcare
  • 跨系統整合病歷、保險政策與臨床證據
  • 沿用企業身分及角色權限,限制資料存取範圍
  • 在原有工具內完成多步任務,減少轉換應用程式
  • 將可驗證證據整理成較完整的行政與決策依據

Google Cloud 指出,臨床人員每週花在人手核對資料的時間接近 28 小時;方案的目標,正是降低這類資料整理成本,同時讓患者更快取得照護及保障方面的答案。

方案已包含精細權限控制、集中政策管理,以及適用於每個 agent、sub-agent 和工作流程的 need-to-know 邊界。對資料高度敏感的醫療機構而言,安全治理並非附加功能,而是能否真正投入日常流程的前提。

項目主頁

Categories: Agentic, 模型, 模型訓練, Google, Gemini, API, 軟件, 工具, Medical醫學, 安全

Duo:讓模型在對話中即時插嘴及回應

Duo v1 是螞蟻集團(Ant Research)開 Apache 2.0 授權的全雙工互動世界模型,主分支提供離線研究流程,vLLM-Omni 與 SGLang-Omni 分支則走向線上即時串流。

Duo

先聽你說一半被打斷,然後繼續講——這種像真人對話的互動,一直是擴散模型(diffusion model)難以處理的部分。Duo v1 由 inclusionAI 團隊推出,是一個 Reciprocal World Model(互惠世界模型),把「智能」與「物理現實」放在同一個世界裡看待:一邊持續感知影音輸入,一邊即時回應,讓 spontaneous conversation(自發對話)與插話打斷自然發生。

這是一個模型加推論管線的開源項目,Apache 2.0 授權。跟純文字對話模型最大的不同,是它把「決定要不要參與」與「決定要說什麼、發出什麼聲音」拆成兩個模組,交錯在同一條時間線上運作,因此不需要等使用者講完才回話。

要做到這一點,技術上用了三招:

  • 自迴歸建模處理持續互動的推理與參與決策,而不是把生成限制在指令理解
  • 分塊條件與跨塊 token 同步,加上模組專屬的 attention mask,確保因果依賴關係,讀不到未來的輸入
  • 雙重 rollout 蒸餾,用自迴歸生成的 Intent token 與合成的影音歷史訓練,緩解兩個模組之間的 distribution shift

模型權重在 Hugging Face 公開:Duo-1.0 causal base、distill、quantized,以及 Duo-1.2 causal base,同時附上離線推論程式碼給研究用。想線上部署的話,vLLM-Omni 與 SGLang-Omni 兩條分支提供加速的即時串流流程,vLLM-Omni 是官方推薦的那條。

硬體門檻不低:參考離線配置需要兩張 CUDA GPU,一張給 Intent 與 codecs、另一張給 Realization,另有記憶體要求;離線環境還要把模型與語音環境分開,因為 qwen-asr 綁定了特定版本的 Transformers。

要留意的是,這仍是 preview 版本,目前只支援基本影音對話,官方表示新版會陸續推出。適合關注實時語音互動、數碼人(digital human)、陪伴式 agent 的團隊,以及做世界模型、串流推論與語音多模態研究的實驗室。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 數字人, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, NVIDIA, Video, Audio, 語音, Dataset 數據集

Pinky:讓 AI 操作手機而風險審批留在你手上

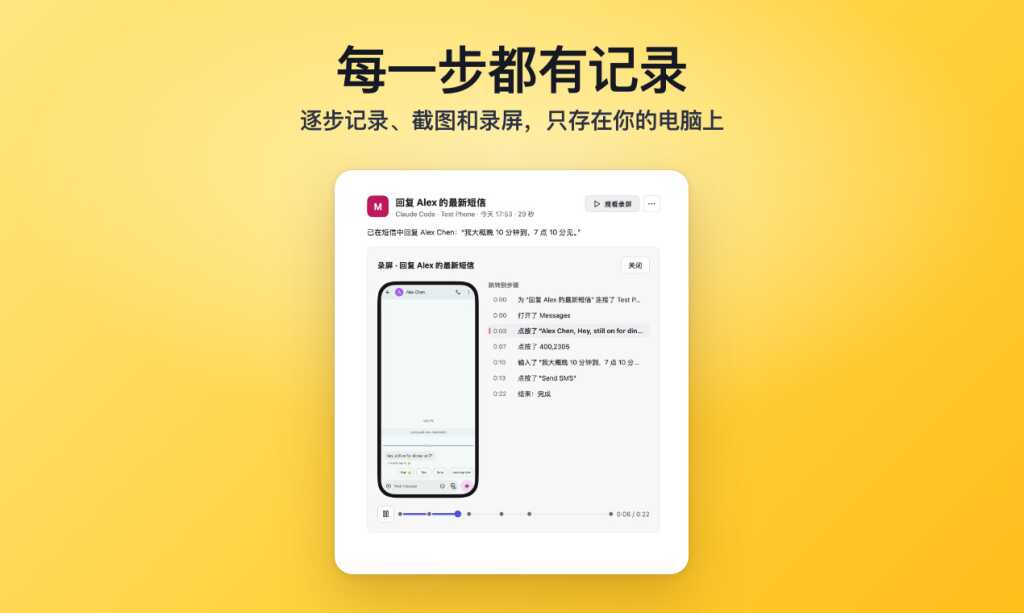
Pinky 是一個手機操作工具與 MCP 伺服器,讓 AI Agent 真正點擊 iPhone 或 Android,同時把付款、刪除等高風險決定交回用戶審批。

pinky macos 1024

讓 AI 替你點開手機 App、下單、回覆訊息,真正難處不在模型識字,而在誰有權按下最後一按。Pinky 是一款原生桌面工具兼 MCP(Model Context Protocol)伺服器,透過電腦連接 iPhone 與 Android,讓 Claude Code、Claude Desktop、Codex、Cursor 或自訂 Agent 操作真實手機;手機端另有原生 App,選用模型後可脫離電腦執行。

它取捨明確:Agent 可以行動,但安全規則由 Pinky 的 gateway 執行,不靠提示詞要求模型「小心」。付款、交易、轉帳預設等待確認,發送訊息、下單、刪除、致電、安裝、外部連結與系統設定亦可納入審批。銀行、錢包及密碼管理 App 預設不可見,密碼及一次性驗證碼欄位禁止輸入,避免 Agent 自行取得敏感資料。

  • 連接方式:支援 macOS、Windows、Linux,可控制 Android 10 至 17 及 iOS 17.4 以上裝置
  • 接入模型:涵蓋 DeepSeek、Qwen、Kimi、GLM、Claude、GPT、Gemini,以及 Ollama 或 LM Studio 的本地模型
  • 運行方式:可從電腦操作,也能在手機 App 內直接安排任務或定時執行
  • 安全邊界:每個新 Agent 都要獲批准,並只取得你授權的範圍
  • 稽核紀錄:保留逐步說明、截圖及螢幕錄影,並可輸出 HTML 報告

與單靠 Agent 自身安全提示的做法相比,Pinky 把審批放在控制層,而非寄望模型每次都聽話。代價是首次設定需要配置裝置、Agent 與權限;iOS 17.4 至 26 要從 Mac 以 Xcode 安裝手機端程式。iPhone 與較舊 Android 仍使用主螢幕,Android 13 以上則可讓 Agent 在隱藏第二屏操作,減少打斷。

原生視窗由 MyGo 在 GPU 上繪製,沒有 Electron 或 WebView,Mac 版下載約 16 至 22 MB,閒置時約佔 70 MB 記憶體及 0% CPU。桌面版可從官方發行頁下載;手機控制功能需要手機與電腦配對。想做跨裝置自動化、研究手機 Agent,或需要保留人工確認與完整操作紀錄的團隊,會較容易感受到它的價值。

GitHub

Categories: 開源, Agentic, MCP, 模型, Qwen, DeepSeek, Gemini, 提示詞, 工具, IDE, Mac, Linux, Ollama, 安全, Anthropic, Kimi

PAN 2:讓代理先預演行動再決定下一步

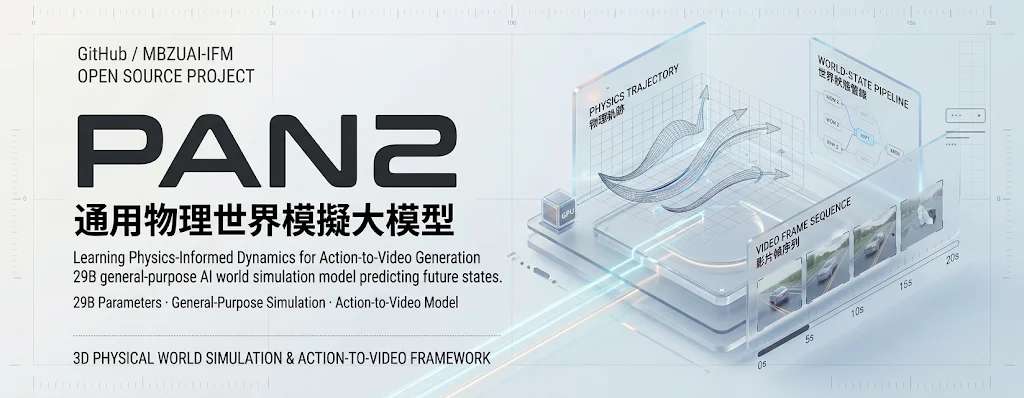
PAN 2 可把圖片、文字與行動指令轉成最長 20 秒的影片,協助代理比較不同方案可能帶來的結果。

PAN 2

PAN 2 把「如果採取這個行動,會發生甚麼」變成可觀看的影片。這個由 MBZUAI 基礎模型研究所(Institute of Foundation Models,IFM)開發的世界模型(world model),會接收現有畫面、可選文字描述及以文字表達的行動,模擬最多 20 秒的變化,方便代理(agent)先比較不同選擇再採取行動。

它的設計取捨在於把語意與視覺分工處理。大型語言模型(large language model,LLM)負責理解情境、列出事件時序與鏡頭運動,再由 latent diffusion model 把結構化描述轉成影片;當中的 29B 參數 MMDiT(Multimodal Diffusion Transformer)負責細節生成。這種安排不是單靠影片模型猜測物理與因果,而是先建立可檢查的行動與時間關係。

目前模型可透過 Hugging Face、Diffusers 與 vLLM 使用,亦有本地部署文件,毋須自行拼接推理流程。不過 29B 參數版本對 GPU 記憶體和運算資源要求不低,影片生成速度亦會限制逐個方案試算的實務節奏。

PAN 2 採用的 Generative Latent Prediction(GLP)架構,源自《Critique of World Models》研究;模型資料頁亦涵蓋多步計劃、人手評估、安全護欄與已知訓練限制。

  • 輸入可包含圖片、文字及文字行動描述
  • 模擬影片長度可達 20 秒
  • LLM 負責概念推理,latent diffusion model 負責視覺生成
  • 29B 參數模型提供公開權重與部署路徑

研究團隊、影片生成開發者,以及需要預先推演操作後果的 robotic(機器人)與 Agentic 系統團隊,都可把 PAN 2 當作方案評估工具。

GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Google, NVIDIA, Video, Image, Robotic, 工具, 安全, 蘋果

OpenFilm:讓編碼代理直接製作可編輯影片

OpenFilm 把影片變成網頁時間線,讓 Codex、Claude Code 等代理先製作,再由人在瀏覽器編輯器中修改。

OpenFilm

一部片由代理生成,之後仍要逐項執剪、改字、調音量,往往是 AI 影片工作流最難銜接的一步。OpenFilm 是一套開源 AI 影片工具與框架,將生成、檢查和後製放進同一個瀏覽器工作環境,並讓影片保留為可繼續編輯的網頁項目。

OpenFilm 透過現代化技術棧與開源精神,為影視團隊帶來了以下核心價值:

  • 全方位的專案生命週期管理: 從專案立項、任務分配、進度追蹤到資產歸檔,OpenFilm 提供了一站式的管理介面,讓製片人、導演與技術人員能在同一個資訊源(Single Source of Truth)上高效運作。
  • 無縫的影音資產協同: 支援高效的媒體預覽、線上審片與時間軸標記回饋,讓團隊成員與客戶可以直接在影格(Frame)上進行精準溝通,告別模糊不清的文字描述。
  • 資料自主與開源自由(Open Source & Self-Hostable): 採用開源授權,團隊可以完全掌控自己的核心智慧財產權與高畫質素材資料,不必擔心雲端服務商的隱私侵犯或無預警的訂閱費調漲。

它為每個鏡頭成為一個 frame(t) ,按時間繪畫畫面;影片、圖片、聲音和文字則放在 film.html 的時間線上。代理可運用 HTML、CSS、Canvas、SVG、WebGL、Three.js、GSAP 及現有影片上面建立內容。

  • 一個 HTML 檔案整合動畫、片段、圖片和聲音,CSS 負責樣式與版面。
  • 一個 frame(t) 函式負責每個鏡頭,以支援亂序及並行算圖。
  • Studio 在瀏覽器提供時間線剪輯,可移動、縮放、旋轉物件,亦可裁剪片段、修改文字、色彩、字幕、速度和音量。
  • Canvas 協助整理分鏡、素材、旁白與音樂,再按次序送入時間線。
  • 匯出涵蓋 MP4、GIF、聲音、字幕、靜態圖、透明影片,以及 Final Cut Pro、Premiere Pro 和 DaVinci Resolve 時間線。

透過編碼代理使用內建 CLI 開啟 Studio、檢查畫面和輸出影片。環境需要 Node.js、ffmpeg 與 Git,首次執行會下載約 100MB 的 headless Chromium;macOS、Windows 和 Linux 桌面版已包括 ffmpeg 與瀏覽器。生成語音、音樂、圖片和影片時,可在 Studio 連接 ElevenLabs、OpenAI、Google、OpenRouter 及 fal,並使用自己的 API key。

適合需要快速製作產品示範、社交媒體短片、動態簡報或教學片段,並希望保留人手修改能力的開發者、內容團隊與代理工作流研究者。

GitHub

Categories: 開源, AI productions, 模型, Google, OpenAI, API, Video, Image, Audio, 框架, 教學, 軟件, 工具, Mac, Linux, Python, 語音, Anthropic, 動畫, 音樂, Skill 技能

Page 1 of 47
1 2 3 … 47