RouteWeaver:先選工作方式,再決定呼叫哪些模型

同一個問題未必適合只問一次、逐步追問或交由多個角色協作。RouteWeaver 把「如何組織模型呼叫」也交給路由策略判斷,並以成本回饋約束選擇。

RouteWeaver logo

遇上簡單查詢,多輪推理可能徒增成本;碰到程式或需要拆解的任務,只呼叫一次模型又可能不夠。RouteWeaver 是一個大型語言模型路由框架,讓單一策略先選擇單輪、多輪或 agentic 執行模式,再安排工作模型處理子問題,嘗試同時照顧答案品質與呼叫成本。

路由策略採用 Qwen3-4B-Instruct-2507,並在六個凍結的工作模型之間分配任務。所有模式共用一套行動格式:單輪只呼叫一次;多輪會按前一次觀察結果作出兩至四次連續呼叫;agentic 模式則可在最多八次呼叫中,以角色和參照關係組織多層協作。工作模型的輸出只作為策略的上下文,不會直接接受梯度更新。

訓練方法 COMET-GRPO(COordinated Mode–Execution Training)分開比較模式選擇和模式內執行,避免只看整段任務的獎勵時,難以判斷失誤源於選錯模式,還是執行不佳。漸進式探索會先由外部指定模式,待各模式累積執行經驗後,才逐步交由策略自行選擇;另一項獎勵則把成本納入考量,令路由器不只追求答案表現。

這套做法適合需要按任務難度調整模型呼叫流程的研究團隊,以及同時處理查詢、數學、程式和知識任務的服務。單輪模式可減少簡單工作的額外呼叫;多輪及 agentic 模式則提供分步推理或角色協作空間。代價是增加了路由策略與執行流程的訓練、協調複雜度,而成本獎勵也不能單獨保證每個任務都會選到最合適模式。

  • 一個策略同時決定執行模式及工作模型路由。
  • 六個工作模型保持凍結,策略負責編排呼叫與整理答案。
  • COMET-GRPO 分開給模式決策和模式內執行評分。
  • 成本獎勵與漸進式探索,分別處理資源取捨及模式探索。

程式碼、訓練後的路由器及項目頁已公開;提供模型與資料入口。先理解方法及評估設定,再按公開程式與模型資料判斷是否符合自己的任務。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架

從影片理解世界:統一 Video World Models 的四種能力

一份涵蓋 669 篇參考文獻的調查,整理影片模型如何讀取、生成、共享及互動於不斷變化的世界。

Og image

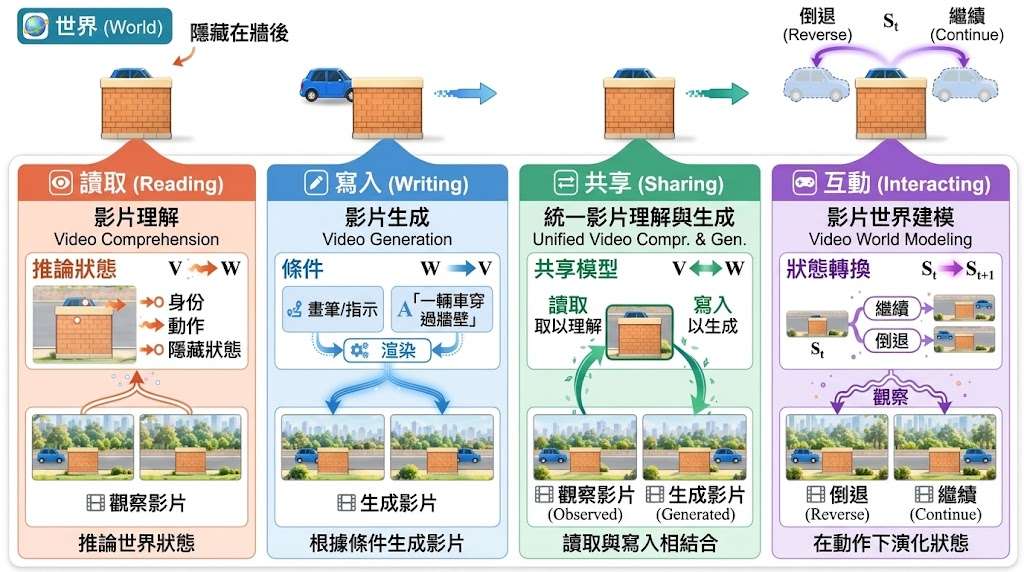
當模型要由片段影片理解場景、推演未來,甚至回應外部行動時,單純辨認畫面中的物件並不足夠。這份影片世界模型調查以影片與世界狀態的關係為主線,整理 Video Foundation Models 如何處理觀察不完整、時間變化和因果推理等問題。

調查將能力分成四個互相關聯的操作:Reading 從影片讀取語意、空間、時間、物理及因果資訊;Writing 生成可能發生的未來;Sharing 建立可供不同任務共用的表示;Interacting 則把感知結果連接到行動、控制和環境回應。內容涵蓋影片表示學習、Video-LLMs、影片生成、影片代理及世界預測等方向。

影片只是世界的部分記錄,而且可能遺失被遮擋的物件、視角以外的資訊或事件之間的因果關係。調查因此區分 temporal coherence 與 world consistency:畫面可以連續流暢,但物件再次出現時未必保持同一身份;鏡頭突然切換,也不一定代表世界狀態中斷。

• 以世界狀態統一影片理解與生成
• 覆蓋 2017 至 2026 年的研究發展時間線
• 比較 contrastive、masked、predictive 及 generative learning
• 關注長片段、串流觀察與影片代理的證據累積
• 收錄 669 篇參考文獻及多個尚待解決的研究問題

這份材料適合研究影片模型、World Models、多模態模型和 Computer-use agents 的讀者,也可作為設計影片理解、未來預測、模擬環境或機械人互動工作流時的索引。它屬於調查項目,並非可直接下載或安裝的單一模型;原始資料亦沒有提供具體使用流程。

項目主頁

Categories: Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Discord, 動畫

Agent4Sci 把 AI 編程代理放進真實科學實驗場

AI 編程代理能否在有限算力、沒有人工協助的情況下,超越論文已發表的最佳結果?Agent4Sci 讓代理在真實機器學習科研任務中接受長時間測試,並檢查成果是否可信。

protocol

面對一篇研究論文、程式碼、訓練資料和指定指標,AI 編程代理能否在固定算力內推進結果?Agent4Sci 是一個長時間測試與評估工具,涵蓋 11 個科學領域的 20 個基準和 25 項任務,檢視前沿代理在沒有人工協助下能否超越已發表的最佳表現。

它不以排行榜為目標,而是讓代理在標準化環境中修改程式、執行實驗和提交成果。每項任務會先核對已發表的基準結果、修整資料切分,並封存測試集;代理只能查看訓練及驗證資料,避免直接利用測試答案調整結果。

評估分成三步:代理進行實驗並提交成果,另一個代理在封存的測試集上評分,第三個代理則審查過程有否選擇性呈報、測試資料污染、操弄指標或硬編碼輸出。這種分工有助分辨模型進步是否來自有效研究,而非鑽評測漏洞;但長時間實驗本身結果波動較大,作者也提醒應把結果視為研究能力的探測,而不是穩定排名。

  • 覆蓋 20 個基準、25 項任務及 11 個科學領域。
  • 以固定運算預算測量代理相對於已發表最佳結果的進步幅度。
  • 測試集封存,並由獨立階段評分及審查評測操弄風險。
  • 提供 research、experiment 和 checklist 工作流程,分別支援文獻引導構思、實驗安排及定期檢查研究方向。

研究團隊、AI 代理開發者及機器學習科研團隊,可用它檢查代理能否在真實程式碼和資料條件下完成持續實驗,而不只是產生看似合理的修改。儲存庫提供 agent4sci run 執行評估流程,另有後端與自建基準容器的說明;提供的資料未列出完整安裝及模型預設細節,因此無法據此判斷所需 API、算力配置或具體執行時間。

GitHub

Categories: 開源, Agentic, 模型, 模型訓練, API, 工具, 庫, 編程

Socratic-Skill-Learning:Agent 技能能否真正跨任務重用?南京大學提出 SSL

SSL 讓 Agent 在導師指導下自行練習及編寫技能,並以新任務測試 transferable Skills 是否真正遷移。

NJU-LINK

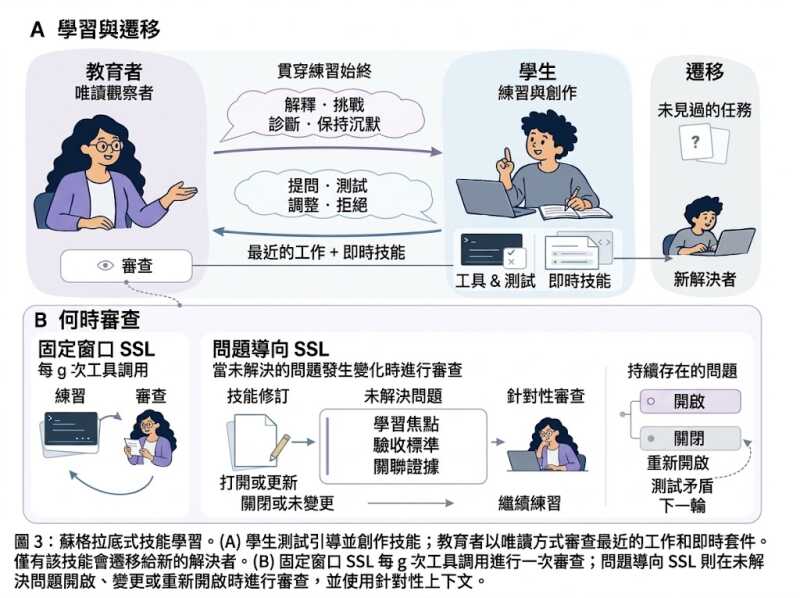
Agent 從一次任務學到的做法,未必能直接套用到新情境;SSL(Socratic Skill Learning)把這種「學會與重用」拆開,讓 Student 練習、提問及編寫 Skill,再由全新的 solver 接手未見任務。南京大學 NJU-LINK 將它定位為可重用 Agent Skills 的學習框架,關鍵不是複製完整答案,而是保留程序及其適用條件。

流程由 Educator 介入指導,但 Student 仍是環境操作者及 Skill 作者,可以質疑、測試和修改建議。Fixed-Window SSL 會按固定間隔檢視進度;Issue-Guided SSL 則追蹤仍未解決的問題,隨 Skill 版本變化集中檢視,避免每輪都重新教訓。

評測工具 SkillTransferBench 涵蓋 35 個任務系列、408 個可執行個案及 6 個領域;主評估使用 22 個系列、155 個 held-out cases,並以新 solver session 測試遷移。Fixed-Window SSL 的 utility 為 0.801,高於無 Skill 的 0.723、Trace2Skill 的 0.761,以及 SKILL-KD 的 0.751;Issue-Guided SSL 達 0.805,較 Fixed-Window SSL 節省 61.7% Educator tokens,但整體流程仍需 Node.js 22.19+、Docker 及 OpenAI-compatible API 支援。

  • 讓 Agent 自己提問、測試和修訂 Skill
  • 以未見任務及新 solver 檢查技能是否可遷移
  • 比較固定間隔與問題導向兩種複核方式
  • 提供跨 Qwen、DeepSeek、Kimi 等模型的評測

這套方法較適合研究 Agent 教學、技能記憶及長期工作流程的團隊,而不只適合聊天機器人。它沒有直接把大型模型換掉,而是處理更實際的問題:如何把一次成功任務轉成可攜、可審核的 Skill,同時控制導師介入所帶來的額外成本。

GitHub · 數據集

Categories: 開源, 南京大學, Agentic, 模型, Qwen, OpenAI, DeepSeek, API, 框架, 教學, 工具, Dataset 數據集, Kimi, Skill 技能

DeepSeek Harness(DSH) 的「可視化插件市場」

把外掛搜尋、相容性核對和整理放進 DeepSeek Harness,並讓同一目錄接入 Discover。

dsh-market logo

DeepSeek Harness 的 dsh-market 是外掛市集及目錄索引,簡單講,就似 VS Code 嘅 Extensions 頁面:你可以喺介面搜尋、安裝、更新同管理插件,唔使每次自己打指令。方便搜尋社群外掛、核對相容條件並一鍵安裝。

目錄有 4,200 多個項目,支援分類、星數、熱門/最新排序和雙語介紹。相容提示讀取 engines.dsh 或 lockstep @deepseek-ai/dsh-* peers;篩選器只隱藏已確認不匹配的項目,資料缺漏時仍會保留,避免誤判。

dsh 0.2.1 起可在 Discover 加入 npm 提供的 format-1 索引,較能配合主機 15 秒載入時限;GitHub Pages 複本在部分網絡可能超時。

  • 官方桌面版要透過應用程式內的 Settings → Plugins 安裝。
  • 討論串採用 GitHub Discussions 和 giscus;閱讀免登入,發文需 GitHub 帳戶,開啟時會連接 [redacted] 及 GitHub。
  • 收藏、主題及分組資料存於個人檔案的 state.json;群組可統一開關外掛。

需要 dsh web 0.1.0-rc.6 或以上版本,安裝後須重新啟動。

GitHub

Categories: 開源, Agentic, DeepSeek, Image

CoEvo-RSI:讓模型跟上會進化的 Agent Harness

CoEvoX 讓模型與執行框架同步演化,改善 AI Agent 的能力與工作流程互相錯配及自我進化(RSI - Recursive Self-Improving)的問題。

CoEvoX framework

當 Agent 的執行流程不斷改變,模型可能未學懂新要求,也可能因 Harness 限制而用不出原有能力。CoEvoX 屬於 LLM agent 的模型—Harness 共演框架,透過共同演化歷史檔案,協調模型檢查點、執行框架與實驗結果。

每輪流程由 meta-agent 編輯新 Harness,從歷史檔案選擇或合併模型 checkpoint,再用拒絕取樣軌跡進行 SFT;只有通過驗證的改善組合才會晉升。TIMR(Turn-level Interface Mismatch Rate)用來診斷逐回合的介面錯配,亦令模型選擇不再只看單一模型能力。

• Qwen3.5-9B 經 CoEvoX 調整後,部分失效歸因測試超越更大型模型
• 評估涵蓋多代理失效歸因、角色感知 text-to-SQL 及智能家居指令
• Held-out 測試避免同時參與訓練與演化選擇
• 結果並非全面領先,部分演算法生成或 When 指標仍落後其他方法

失效歸因結果中,CoEvoX 在 Hand-Crafted 的 Who、Pro 的 Who,以及 TraceElephant 的 Who 分別取得 68.39%、69.43% 和 70.78%,但在 TraceElephant When 只有 28.92%,低於 GSPO 的 38.36%。這反映共演化能改善特定工作分工,卻未必對所有推理步驟同樣有效。

項目較適合研究 recursive self-improving agents、模型訓練及 Harness 設計的團隊,用來測試模型與工作流程是否互相配合。提供的資料沒有完整安裝、執行指令或部署流程,亦不應直接假設可隨意下載;目前較合理的理解是把它視為附有實驗框架與評估方向的研究項目。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架

SolarRenderer:Minimax H3 四步完成影片

SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

FocusGUI 自動揀對的訊息做 GUI 代理

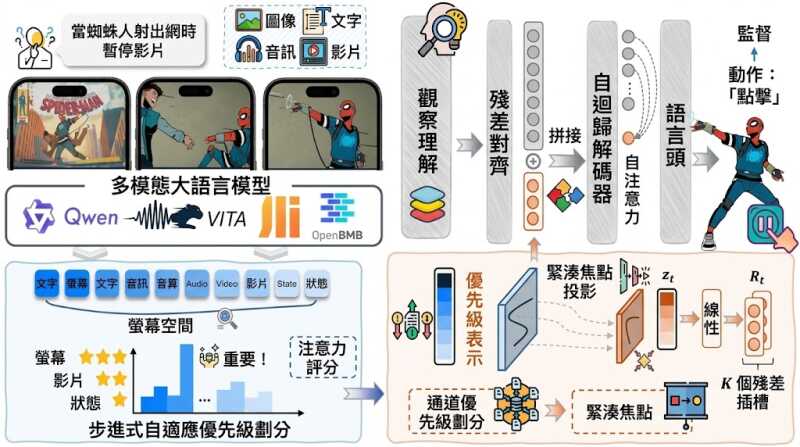
南洋理工大學與阿里共同發表的 FocusGUI,主打用極少可訓練參數處理多模態 GUI 代理嘅分心問題。你能把它理解成幫現有多模態模型動態挑選畫面、音訊、影片當下最相關訊息嘅外掛模組。

FocusGUI architecture: channel prioritization, compact focus, and residual alignment with a frozen decoder

南洋理工大學與阿里巴巴合作的 FocusGUI,試圖解決多模態 GUI 代理一個很具體的困擾:畫面、音訊、影片、互動紀錄同時湧進來,模型往往被不相關的訊息干擾,導致操作軌跡逐步失控,研究團隊稱之為「Sequential Distraction」。FocusGUI 的回應方式相當克制——它是一個輕量的 adapter(適配器),只在每一步動態替當前決策挑選最相關的多模態證據,再壓縮成低維潛向量,最後透過零初始化的殘差注入到凍結 decoder 的嵌入空間中。原始的 Transformer decoder 與語言模型頭完全不被替換,背骨模型也保持凍結。

它和一般做法的主要差別,是不把整段完整觀察平均塞進去處理,而是針對每一步決策參考做「step-adaptive prioritization」。頻道分解先拆解當下觀察裡互補的證據來源,緊接著做加權,再壓縮成低維表示,最後用殘差對齊方式回接到動作生成邊界。輸出仍以結構化 JSON 形式自迴歸生成,方便整合到既有的 GUI 代理 pipeline。對於已有穩定 GUI 代理系統、想提升多模態場景精準度但不想重新訓練底層模型的團隊,FocusGUI 提供了一條低侵入式的升級路徑。

對開發者而言,這代表幾個直接的好處:訓練時只需要動作標註,不依賴模態相關性標註;可訓練參數只有 1.15 至 1.45 百萬,卻在四款多模態背骨模型上把 Type Match 提升 33.2 個百分點,Exact Match 從原本的 11.2% 提升至平均 33.5%,相對於凍結底層提升約三倍,並在 24 個測試場景全部取得最佳表現。對比目前最強的增強方法,Type Match 仍領先 30.1 個百分點。

項目適合負責多模態代理研發、GUI 自動化測試、或在手機與桌面環境構建 Agentic 流程的團隊。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio

Google Harness² 讓 Agent 自我改良執行系統

Harness² 能在模型不變下,按任務改進提示詞、工具與技能,並將經驗沿用至後續任務。

Harness²

Agent 的落差往往不只來自模型能力,提示詞、工具配置、記憶和任務編排同樣影響結果。Google Research 開源的 Harness²,便是一個處理這層「執行系統」的研究框架:它固定模型權重,先按眼前任務調整 harness,再把成果與經驗帶到下一項任務。

它的核心是兩層遞迴。Task-level recursion 透過 Propose–Probe–Compose,先提出修改、在相同任務測試效果,再整合有效部分;Harnessing-level recursion 則把已採用的 harness 與有證據支持的經驗寫入持久 improvement harness,協助後續改進。這種取捨是把資源由重新訓練模型,轉向持續優化模型周邊配置。

  • 模型權重固定,主要改進 prompts、tools、memory、skills 與 orchestration。
  • 不依賴標準答案,以同一任務不同執行結果的行為差異作為回饋。
  • 支援 parallel、sequential recursion,以及 OpenCode、Codex executors。
  • 可配合 JobBench、LAB、WorkBuddy-Bench 測試。

在四種 model–harness 組合中,Harness² 為 GLM-5 與 Gemini 3.5 Flash 的基礎 harness 帶來提升:WorkBuddy-Bench 最高增加 11.5 分,JobBench 增加 4.5 分,LAB partial pass rate 增加 11.8 個百分點;提高 task-level recursion budget 還可繼續增加結果。不過,資料涵蓋三個專業 benchmark,尚不足以證明所有工具和模型組合都能受惠,而且每輪提出、測試及整合會增加執行成本。

需要多工具、複雜編排或持續接力的 Agent 團隊,較能感受到這種架構的價值;維護者可用 JobBench 流程建立環境,再按自身 executor 與評估基準測試。研究人員亦可沿用遞迴設計,但應核對額外呼叫、錯誤傳播及 improvement harness 累積錯誤等問題。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Google, Gemini, 提示詞, 框架, 工具, Dataset 數據集, Skill 技能

Manga2Animate 雙智能把關分鏡,動漫不走樣

把漫畫直接餵進影片模型,角色與分鏡往往走樣。Manga2Animate 改走正規動畫流程:先寫腳本、再繪分鏡,最後才生成影片,由審核智能體把關忠實度。

想用 AI 把幾頁漫畫變成連貫動畫,最常撞到的兩個卡位是:純文字輸入會讓角色外貌與畫風消失,直接把分鏡頁送進影片模型又會誤判版面、講錯故事。Manga2Aniate 屬於多智能體框架,它把整條流程切成「預處理 → 腳本與分鏡優化 → 影片生成」三個階段,第二階段是關鍵差別所在:系統先生成動畫腳本,再產出視覺分鏡,兩者各由一個 creator agent 撰寫,並由對應的 reviewer agent 對照原始漫畫頁給意見,前後跑兩輪迭代才進入成片。

預處理階段用 Magi 偵測漫畫格並排出閱讀順序、抽取文字,再由 Character Description Creator 從角色參考圖歸納出識別特徵,避免後續鏡頭換角色就認不出來。這個雙層審核機制,是它和一般 I2V(image-to-video)套法最大的分水嶺。

對動漫改編從業者、影像敘事研究者,或想快速把作品原型化的獨立創作者,這套 pipeline 提供了比端到端模型更可控的中介層。論文與用戶研究都顯示,無論是角色一致性還是跨鏡頭連貫性,輸出都較接近既有方法優勝。

重點摘要

  • 三階段流程:Magi 切格+轉錄 → 腳本與分鏡兩輪迭代 → 片段式影片生成
  • 雙智能體架構:creator 撰寫、reviewer 對照原頁把關,腳本與分鏡各有獨立審核
  • 兩種生成模式:ref 模式以角色參考為主,i2v 模式則把分鏡切成首幀再生成
  • 開源後端齊全:程式碼、評測資料與模型設定皆公開,方便重現
  • 改善既有 I2V 套法常見的「角色走樣、敘事錯位」問題,在忠實度與一致性上有所提升

需要留意的是,目前公開的程式碼屬於研究框架性質,本地重現需要自行串接影片生成後端,權重未統一打包,下載及設定流程會比一般一鍵安裝的開源項目多幾道手續。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, Video, Image, 框架, Content Creator, 動畫

Page 7 of 47
1 … 5 6 7 8 9 … 47