awesome-smart-glasses:智慧眼鏡參考索引

這份 GitHub 項目整理了 smart glasses 的產品、核心能力和應用場景,適合想看清這條路線現況的人。你可以把它理解成一份把「看見」和「做事」串起來的參考索引。

Smart Glasses Survey Logo

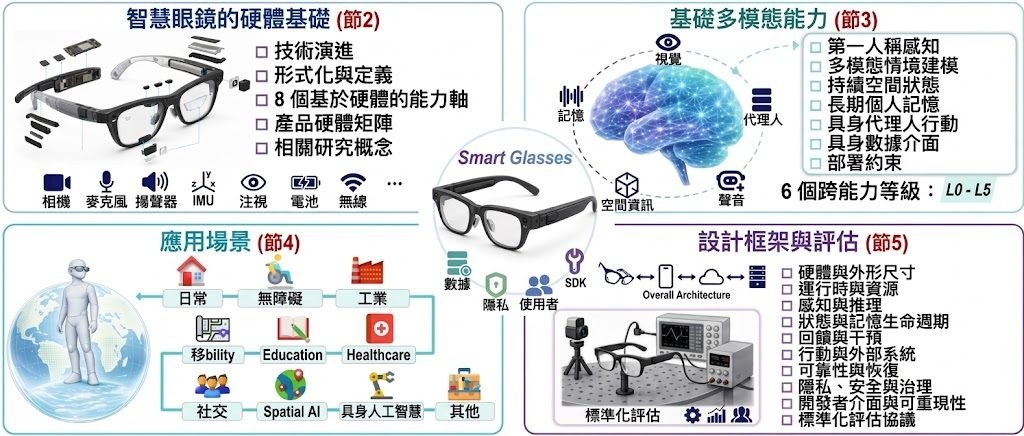
這是一份開源整理型資源,目標是把 smart glasses 由感知走向行動的能力拆開來看,方便比較產品、平台、基礎能力同應用場景。對開發者、研究員同做可穿戴 AI 的團隊來說,它提供的是一個選型同對照框架,而唔係即插即用的應用。

它收錄代表性 smart-glasses products/platforms、foundational capabilities,同唔同 application scenes,等讀者可以順住一條線理解:眼鏡點樣接收第一身視角、點樣支援互動、再點樣落到日常協助、無障礙、工業流程、醫療同交通安全等場景。相關 paper 亦係主線之一,資料會持續更新。

  • 將產品、能力、場景放喺同一個脈絡比較,唔使自己逐篇搵資料
  • 適合做市場掃描、研究綜述同產品定位參考
  • 對第一身 AI、穿戴式助手同 agentic workflow 特別有參考價值
  • 現階段偏向知識整理,唔係部署型工具

GitHub

Categories: 開源, Agentic, 工具

AutoSaddler 重新整理 LLM Agent Harness

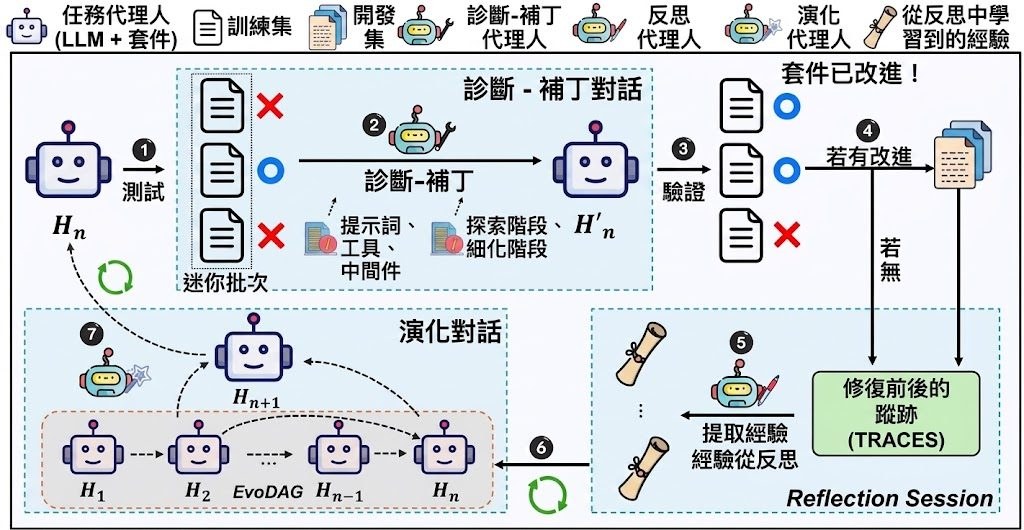
AutoSaddler 會從執行失敗紀錄入手,幫 LLM agent 自動調整提示詞、工具同中介層。它唔只修一條路徑,仲會檢查改動能否推廣到其他情境。

AutoSaddler Overall Framework

Microsoft 研究團隊聯同 POSTECH、KAIST 及南方科技大學開發 AutoSaddler,針對長流程 AI Agent 容易因小錯誤累積而失敗的問題,建立自動優化 harness 的方法。

AutoSaddler 係一個用嚟自動優化 LLM agent harness 嘅開源項目,處理嘅係長流程任務入面,agent 因為提示詞、工具或控制邏輯有少少偏差,就一路累積錯誤而失敗呢個問題。佢唔係單靠反覆改 prompt,而係將 harness 當成程式去診斷同修補。

佢會分析執行 trace,找出失敗根源,再按既定補丁分類去改 prompts、tools、middleware 同 agent-loop logic。資料夾同 佢用 durable、plugin-based 方式記錄狀態,適合要反覆試驗、回復同追蹤修改歷程嘅工作流。

同類方法通常只改少量提示詞,AutoSaddler 就將搜索範圍擴大到整個 harness,仲會用 validation 去挑選較能泛化嘅更新。初步結果顯示,佢喺 GAIA2、SWE-Bench Pro 同 Terminal-Bench 2.0 都帶來約 9 到 10 個百分點嘅 Pass@1 提升。

對做 agent 系統、評測框架或者自動化工作流嘅團隊特別有用,因為佢處理唔係單一模型輸出,而係整套執行環境點樣更穩定。項目要求 Python 3.12-3.14、uv 同 Git,官方建議用 uv run 去執行 Python 指令,代表佢偏向可重現同可追蹤嘅研究與工程整合。

  • 以 failure trace 診斷問題,唔係淨係做表面反思
  • 改動範圍包括 prompt、工具、middleware 同 agent loop
  • 會驗證更新喺其他情境可唔可以保持效果
  • 初步 benchmark 結果顯示有明顯提升
  • 適合要持續調整 LLM agent harness 嘅團隊

項目主頁 · GitHub

Categories: 開源, Agentic, 微軟, 框架, 工具, Python, Dataset 數據集

AutoResearch:AI 研究由構思變成可審查證據

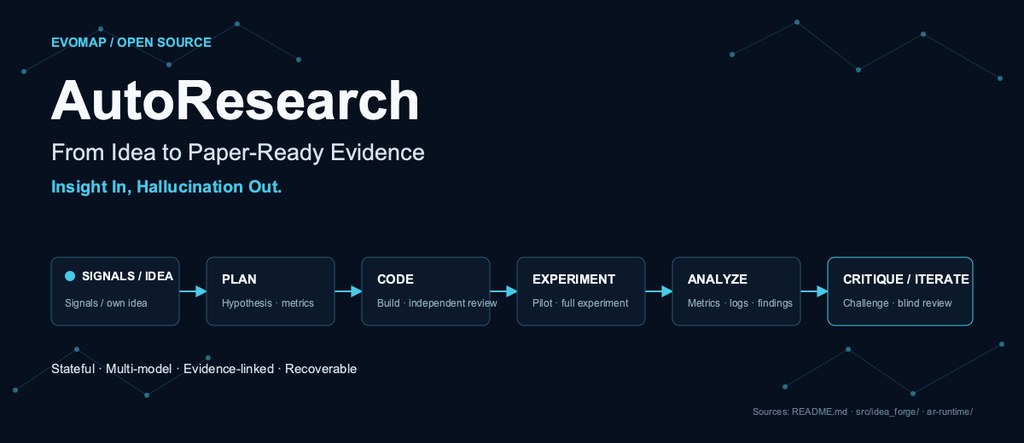
由研究方向發掘、實驗執行到獨立評估,AutoResearch 將一連串研究工作串成可追蹤流程。

AutoResearch workflow from a research idea to reviewable evidence

研究者只需提供一個想法,或者讓系統從近期論文、開發者社群及開源趨勢尋找方向,便可把研究構思推進至實驗計劃、程式碼、結果分析和獨立評估。AutoResearch 屬於開源的 AI and machine learning agent workflow,處理的是研究流程分散、難以重現,以及結果未有足夠證據支撐的問題。

流程不止於叫模型產生一份研究計劃。它會整理、去重和篩選網上訊號,再結合 knowledge base/ 內由使用者維護的研究經驗、限制和常見失敗模式,產生候選方向,經過 cross-review 後制定實驗計劃。已有研究想法的團隊亦可以略過發掘階段,直接執行指定項目。

研究計劃、程式碼、run logs、metrics、失敗原因、critic reports 和 blind reviews 都會寫入磁碟,流程亦具備 stateful、recoverable 特性,方便研究者檢查中途結果、接手工作或停止執行。這比一次過要求模型寫完整論文更適合需要反覆試驗的研究項目,但成果質素仍取決於模型、API、資料來源和實驗環境,不能把自動產出的證據視為已完成同行審查。

  • 從近期論文、社群討論及開源趨勢收集研究訊號
  • 以本地 knowledge base/ 補充領域經驗和限制條件
  • 支援由 idea generation.py 啟動構思、篩選及結果更新
  • 透過 config/providers.local.json 配置 endpoint、model alias 和角色模型
  • Python 3.10+,並要求把含 API URLs、keys 和 proxies 的 .env 留在本機

對個人研究者、小型 AI 團隊及需要大量驗證想法的實驗室,AutoResearch 可減少整理資料、安排實驗和記錄結果的重複工作。它更像一個可接管的研究協作流程,而不是單一模型;要測試完整能力,應先準備本地知識庫和模型供應商設定,再由一個小型研究方向開始,檢查生成計劃、執行記錄及獨立評估是否足以支持後續寫作。

GitHub

Categories: 開源, Agentic, API, 框架, Python

GameXpert-Bench | Coding Agents for Game Development

騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

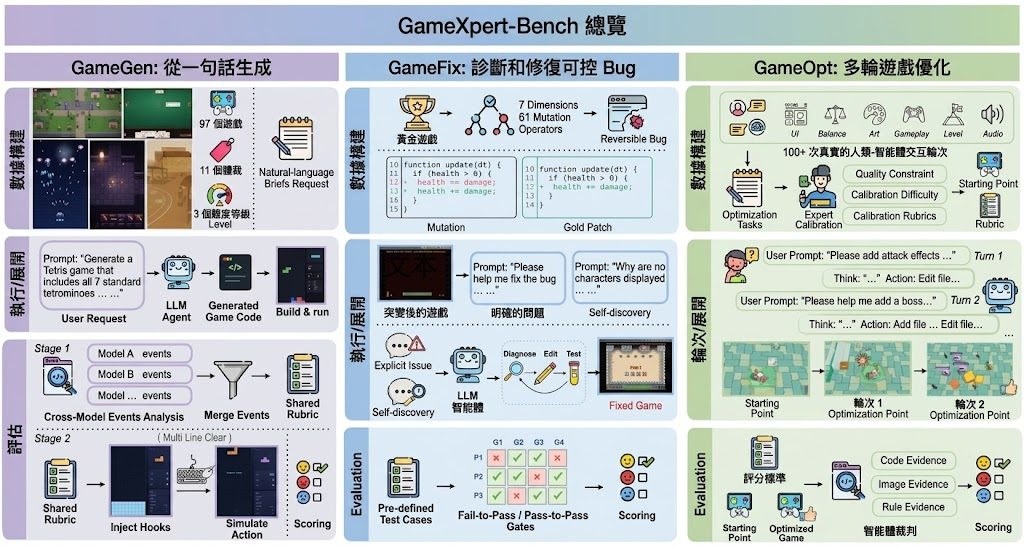
騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

PhysCaP 讓機械人用互動摸清物件物理特性

當視覺無法分辨重量或軟硬,PhysCaP會主動安排互動,讓機械人用更少動作完成操作任務。

Og image

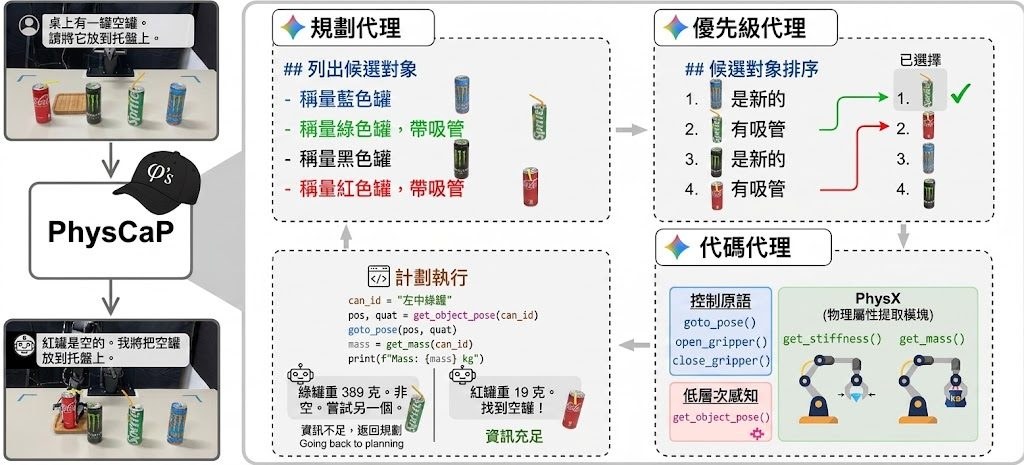
由國立台灣大學、NVIDIA Research、Google DeepMind 及國立陽明交通大學研究人員組成的團隊,推出 PhysCaP,將物理資訊探索加入 Code-as-Policy 機械人代理。

當機械人只靠相機無法分辨哪罐是空的、哪個牛油果已熟,PhysCaP會主動安排提起、夾取等互動,從動作反應推斷隱藏的重量與硬度。這個 physics-informed Code-as-Policy agents 項目,針對被動視覺不足時的機械人操作問題加入主動感知能力。

PhysCaP以雙代理探索框架配合可執行程式碼。Planner先判斷視覺資訊是否足夠,Prioritizer再按預期 information gain 排序互動,過濾不合理或重複的動作,最後呼叫 PhysX(physical property extraction modules)中的 get_mass 和 get_stiffness。

  • 透過 joint-torque 差異及 end-effector Jacobian 估算物件質量
  • 根據 gripper displacement 和 normalized motor effort 分類硬度
  • 無需額外感測硬件,直接利用 robot proprioception
  • 涵蓋找藍色方塊、辨認空罐和挑選熟牛油果
  • 模擬與真實任務中,部分結果達到 9/10 成功率

測試亦包括 LIBERO Empty Can 模擬環境。研究結果指,這種按資訊價值選擇互動的方式,在多項 benchmark 中較被動方法和直接進行互動的方法取得更高任務成功率,同時減少互動次數及執行時間;不過,推斷質量和硬度仍取決於固定提舉軌跡、重複測量及機械人本身的 proprioception。

項目主頁

Categories: Agentic, 模型訓練, Google, NVIDIA, World-Action Model, Robotic, 框架, Dataset 數據集

DeepSeek Harness 把多 Agent 協作變成可控工作台

[教學影片]DeepSeek Harness 讓 DeepSeek dsh 變成可啟動 Web UI 的開發者工作台,重點放在多個 Agent 並行處理、動態工作流同插件擴展。它適合要在複雜程式碼庫入手審計、協作同加速探索嘅使用場景。

Og image

DeepSeek Harness 把 DeepSeek dsh 做成一個可啟動 Web UI 的開發者工作台,處理的是複雜程式碼庫入面要同時分工、同步同收斂結果的問題。影片實測重點放喺並行只讀審計、動態派生 SubAgent,同埋最後將多路輸出整合返去。

它同一般單一路徑的助理做法不同之處,在於可以按工作內容拆成多個 Agent Teams,再根據任務需要即時調整流程。這種安排適合審查、分析同探索型工作,因為不同子任務可以同時展開,唔使一條線慢慢行。

片中亦提到插件開發門檻較低,代表它不只係拿來跑預設流程,仲可以按團隊習慣加功能。對要處理既有代碼、要快速驗證想法,或者想將 AI 工具接入日常開發流程的人,這種擴展性會更實用。

重點摘要:
– 以 Web UI 包裝 DeepSeek dsh,方便直接操作
– 支援多個 Agent 並行工作,減少單線等待
– 可動態派生 SubAgent,按任務拆分工作
– 插件擴展門檻較低,方便接入自訂流程
– 適合複雜程式碼庫審計、協作同探索任務

項目主頁

Categories: 開源, Agentic, DeepSeek, 教學, 編程, 安全, UI/UX

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。
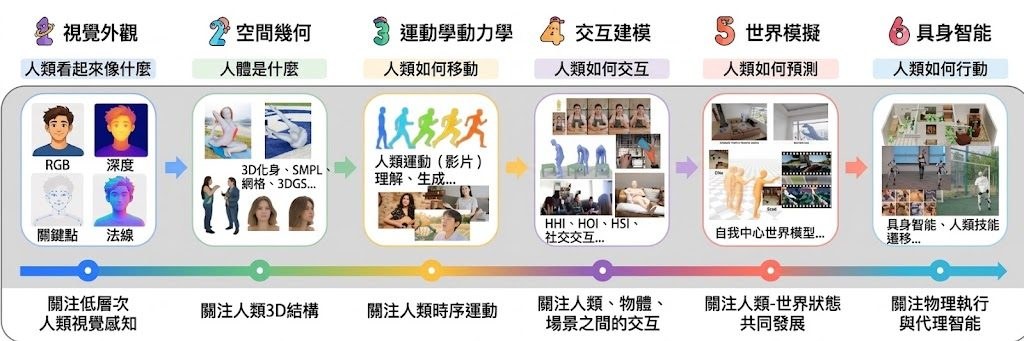
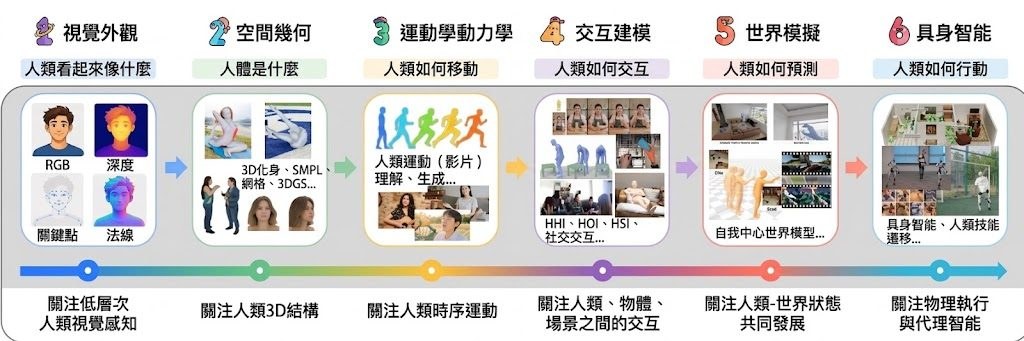
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。
資源庫並非可直接下載執行的模型或軟件,使用方式是瀏覽 GitHub 內容及項目首頁,按 Academic Knowledge、Research Infrastructure 和 Community Learning Hubs 等部分尋找材料。研究者亦可透過社群渠道提交或維護資源,因此內容會隨社群整理持續更新,但完整度和一致性仍取決於後續貢獻。

伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者,GitHub 資源庫和 survey 應該一併閱讀;只想立即執行模型或測試 API 的使用者,則需要另找具體實作項目。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

[技術文章] RecVerse 讓購物代理更像真人行為

RecVerse以分層記憶和整段軌跡訓練,模擬更貼近真人的網上購物流程。

Hero image preview

網上購物模擬器要重現真人由瀏覽、比較到購買的連續決定,才能支援推薦系統的離線測試和 Reinforcement Learning(RL)訓練。RecVerse 是一個以 GUI 為基礎的模擬代理,透過螢幕截圖理解頁面,生成多輪購物軌跡,處理長時間瀏覽中用戶狀態不斷變化的問題。

現有做法各有缺口:Rule-based simulators 依賴向量化商品特徵和預設行動空間,難以涵蓋複雜的電商介面;Large Language Models(LLMs)和 Vision-Language Models(VLMs)代理雖然加入推理及 persona 建模,長會話仍可能丟失早期觀察,或者把所有歷史硬塞進 context window。逐步模仿每個已記錄行動,亦可能令整段流程出現過度探索或過分被動等不自然模式。

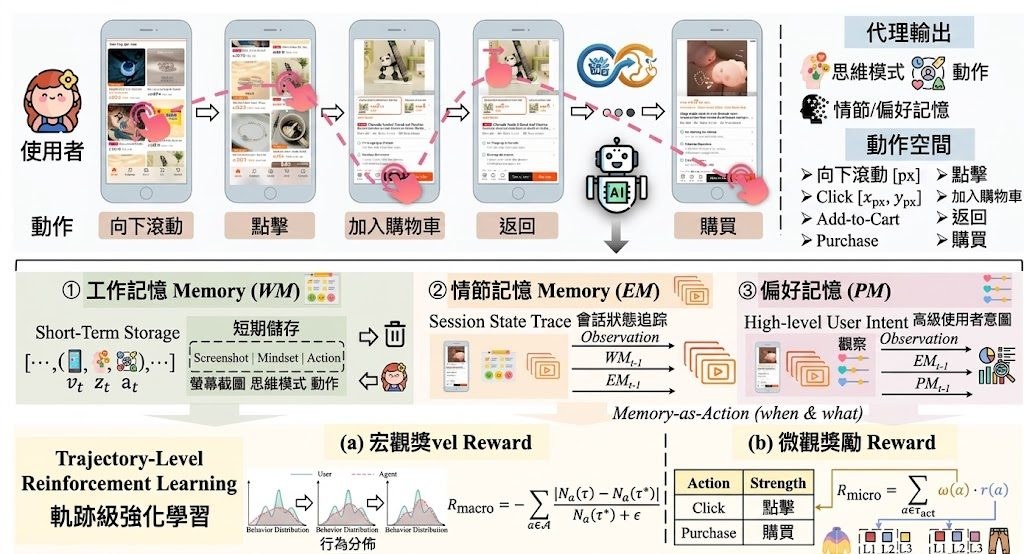
RecVerse以認知啟發的分層記憶處理長期資訊,包括短期焦點用的 Working Memory、保存本次會話軌跡的 Episodic Memory,以及記錄高層次意圖的 Preference Memory。記憶更新本身被視為行動,代理可以按情況學習何時及應該保存哪些資訊。

訓練時,系統改用 trajectory-level RL,直接為完整購物會話評分,同時對齊真人的宏觀行動類型分佈和微觀購物意圖。研究團隊亦發布 USB(UserSimulationBenchmark)互動式電商 GUI 軌跡數據集;實驗結果指 RecVerse 在行為忠實度和意圖一致性上均優於現有基線。

  • 以螢幕截圖理解電商 GUI,生成多輪購物行為
  • 透過三層記憶保留短期焦點、會話經歷和用戶偏好
  • 用完整軌跡目標修正逐步模仿帶來的不自然行為
  • USB 提供互動式電商 GUI 軌跡數據集
  • 可用於推薦策略的離線及反事實測試

Paper

Categories: 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, 中國

AgentMercury 生成可驗證商業世界

把企業情境轉成可執行環境,讓AI代理在多服務流程中訓練,再轉移到未見過的評測項目。

Og image

當AI代理要處理跨部門企業流程,難點往往不只在於選擇工具,還要在多個服務之間維持一致狀態,最後交出可以核實的結果。AgentMercury是一個用於訓練 Computer-use agents(CUAs)的環境生成項目,讓高層次商業情境直接變成可執行、可重播和可驗證的虛擬世界,代理可以在其中進行多輪操作,而系統會按完成後的狀態計算獎勵。

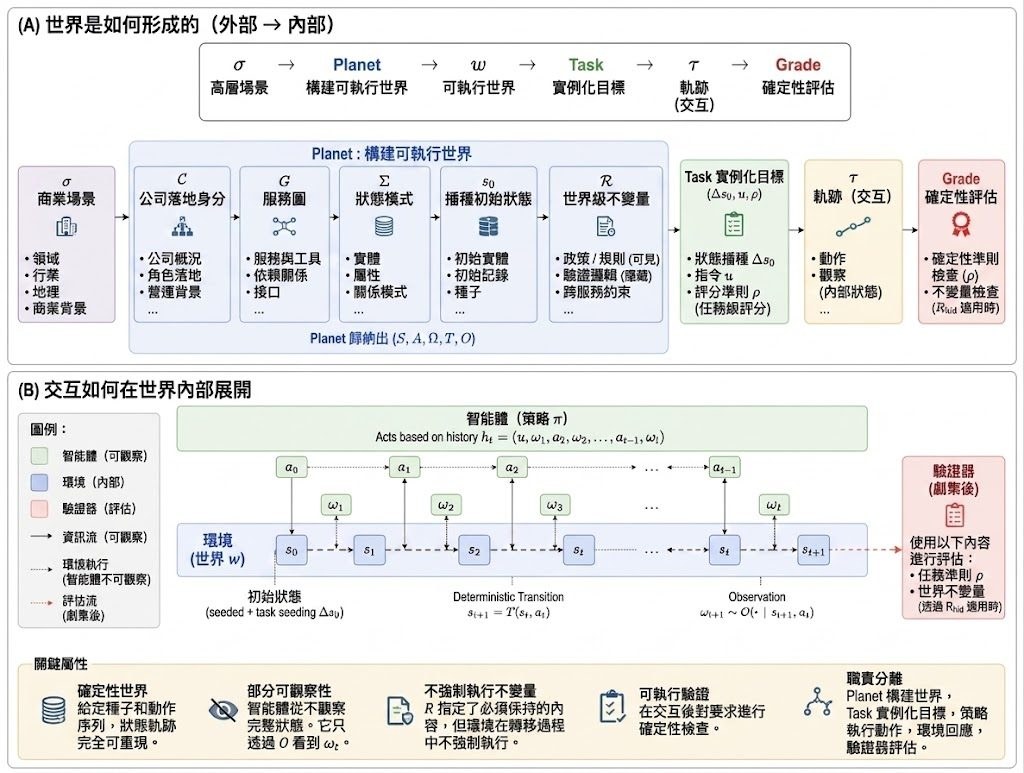
常見做法會先為指定任務或 benchmark 手工建立環境,環境自然只覆蓋測試者預先想到的流程。AgentMercury則把環境建構本身交給 Planet:它由公司身份、服務圖、資料表結構、初始狀態和跨服務不變條件組成一個完整世界,再由 Task 在共享世界上加入不同目標和評分規則。一個世界可以承載多個任務,減少每個新流程都要重新造環境的成本。

驗證條件主要以環境資料庫上的 SQL 形式執行。代理完成一輪操作後,系統會根據任務 rubric 和隱藏的不變條件,對整條 trajectory 進行確定性評分;環境不會在每一步替代理判斷對錯,代理必須自行處理跨服務要求,完成後才接受檢查。這種安排讓結果可以重播,也令 Reinforcement Learning(RL)訓練得到較穩定的回饋。

目前項目整理出4,783個 executable worlds,涵蓋14個產業和50個國家,包含13.98M seeded state rows、842種工具和43,300個可驗證 RL 任務。典型世界約有13項服務、65種工具、31張狀態表,以及約15個以 SQL 編寫的 deterministic verifiers;訓練資料涉及4,326個公司環境,但 Qwen3.5-4B 的報告只使用其中3,200個任務取得梯度,仍覆蓋53.5%的環境、62.9%的產業和75.8%的工具。

項目以 Qwen3.5-4B 和 Qwen3.5-35B-A3B 進行 RL 訓練,代理透過 Model Context Protocol(MCP)操作即時形式的商業軟件,並以 GRPO(Group Relative Policy Optimization)為主要優化方法,SAO 則作為另一種選項。Qwen3.5-4B 的平均獎勵約由0.25升至0.53,截斷回應比例由78%降至3%;在未參與訓練的 EnterpriseOps-Gym 八個企業領域,平均分數由12.3升至15.7,增幅為27.6%。35B-A3B 使用 GRPO 和 SAO 後,平均分數分別由24.8升至28.1及28.3,但結果仍屬項目所報告的訓練和評測範圍,未代表代理已能可靠處理所有企業工作。

  • 將高層次商業情境編譯成可執行世界,而不是只為單一任務造環境
  • 以共享資料庫、SQL 驗證條件和可重播評分檢查跨服務結果
  • 提供4,783個環境、842種工具和43,300個可驗證 RL 任務
  • Qwen3.5 系列在多輪 MCP 工具操作訓練後,獎勵和未見領域表現均有改善
  • 仍需留意合成環境與真實企業軟件之間的差距,以及評測範圍有限的問題

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, Qwen, Dataset 數據集

Page 9 of 35
1 … 7 8 9 10 11 … 35