SolarWM 開放視頻世界模型全流程基建

SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

SolarWM teaser: one framework for diverse interactive worlds

從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。
項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, 世界模型, 模型訓練, NVIDIA, World-Action Model, 3D, LTX, Dataset 數據集, MiniMax

AREX-Skill 把 GitHub 知識變成可執行技能

AREX-Skill 將熱門 GitHub 儲存庫整理成可驗證、可執行的技能,讓 Coding Agent 在複雜機器學習研究任務中少走彎路。

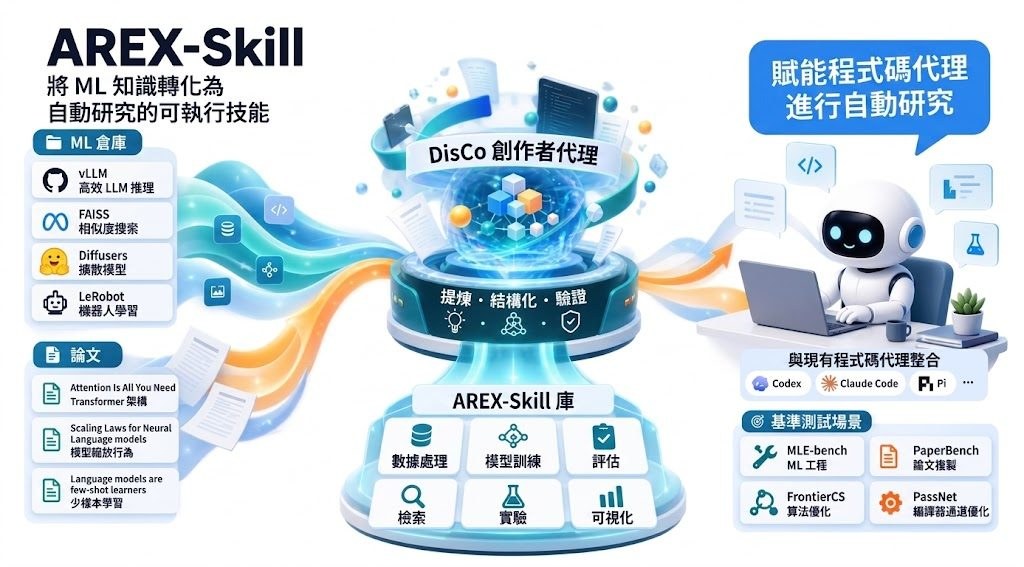
AREX-Skill turns repository and paper knowledge into executable skills for coding agents and autonomous ML research

面對需要查閱多個儲存庫、重現研究流程和逐步驗證結果的工作,AREX-Skill 將分散在 GitHub 的操作知識整理成可重用程序、檢查方法和技能圖譜。它屬於面向 Coding Agent 的開源技能庫與工作流工具,實際處理的是代理有模型能力卻欠缺項目脈絡和操作經驗的問題。

AREX-Skill 已從 1,000 多個熱門機器學習儲存庫提煉超過 5,000 個經驗證、可執行的 skills,並可整合 Codex、Claude Code、Pi 等 Coding Agent。使用時可按任務由 router 從技能庫收窄至相關分支,再由代理執行;DisCo 則負責將儲存庫知識建立、驗證和匯出成技能。

  • 技能包含程序與檢查,而不只是文字說明
  • 技能圖譜協助代理處理跨學科機器學習研究
  • DisCo Meta Skills 支援挑選及使用 Creator meta skills
  • Refreshing Repo Skills 提供維護和更新清單

相較於每次由代理重新閱讀 README、程式碼和論文,技能化做法可把重複的操作步驟預先整理,並將預算集中到較困難的推理工作;代價是技能需要隨儲存庫更新而刷新,覆蓋範圍和驗證品質亦會直接影響結果。儲存庫目前提供 Demo、技能目錄、repository catalog 及 DisCo CLI 文件,適合研究團隊、Coding Agent 使用者,以及需要重現多個 ML 項目的開發者。

GitHub

Categories: 開源, Agentic, Vibe Coding, 編程, Anthropic, Dataset 數據集, Skill 技能

FastH3 Live:單張消費級 GPU 跑出無限 AI 直播

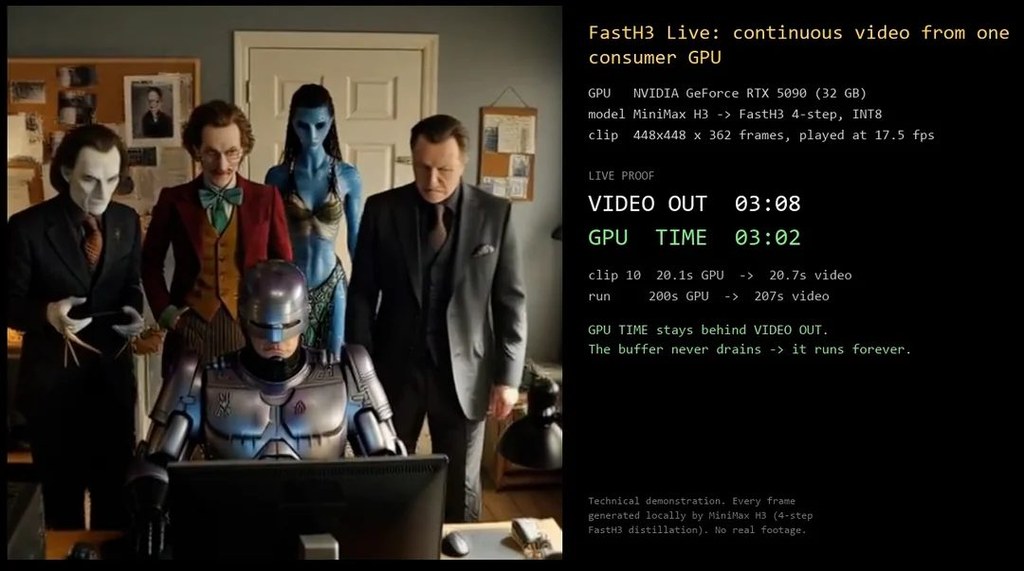
FastH3 Live 將 MiniMax-H3 蒸餾成 4 步模型,配合重定時與 ComfyUI 串流伺服器,用一張 RTX 5090 就能長開 448×448 18fps 嘅無限影片加音訊直播。

Hero image preview

喺消費級硬件上長開一段無止境嘅 AI 影片頻道,一直係文字轉視頻工作流嘅痛點——雲端成本高、本地生成速度慢,仲要面對提示詞同角色一致性嘅限制。FastH3 Live 就係圍繞呢個矛盾設計:佢將 MiniMax-H3 經過 4 步 DMD2 蒸餾成 FastH3,配合一套本地串流伺服器,令生成同播放可以同步進行,前一段影片播放期間,模型已經喺度產出下一段。

整個項目以 ComfyUI 作為運行環境,並喺單張 RTX 5090(32GB、Windows 11)上完成測試。v1.1.0 版本將解析度提升至 448×448、幀率達到 18fps,相比 v1.0.0 嘅 512×288 12fps 有明顯進步。音訊部分亦同步串流,用戶只要用 VLC 指向本地 URL,就可以一直接收新嘅短片,支援多位觀眾同時連線同斷線重連。

對於內容創作者、ComfyUI 用戶或者想試文字轉視頻嘅人來說,呢套工具最直接嘅吸引力係「無限直播」呢個使用場景。項目內附 321 個場景提示詞、503 個已驗證可用嘅角色清單,使用時可以快速組合出唔同長度嘅段落,唔需要每次由零開始寫 prompt。

需要注意嘅限制亦都幾清楚:相關權重屬於 MiniMax-H3 社群授權,適用範圍排除歐盟、英國、韓國同美國,下載前需要確認所在地。

項目主頁 · 數據集

Categories: 開源, ComfyUI, Agentic, 視頻模型, Video, Dataset 數據集, MiniMax

E-CommerceBench 經營 365 日網店的 Agent 考試

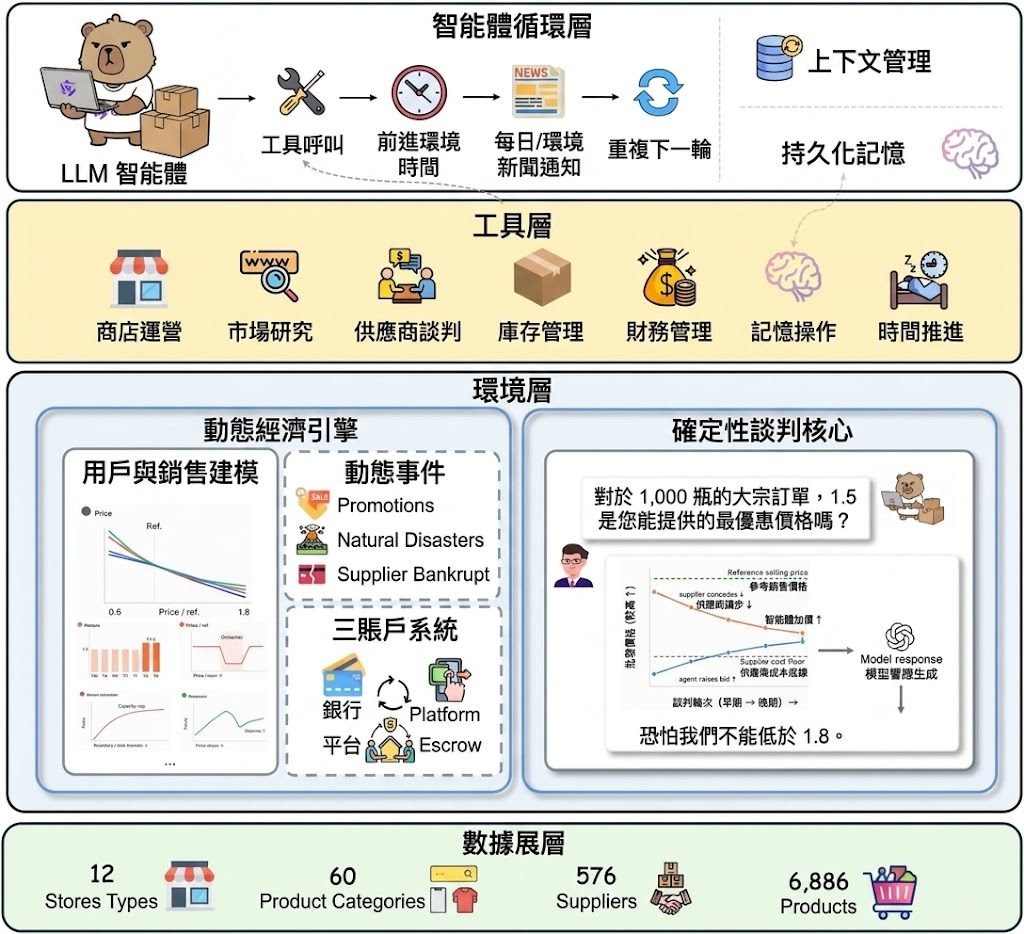
代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, Google, OpenAI, DeepSeek, Gemini, Python, Anthropic, Dataset 數據集

H3-World 讓鍵盤控制生成影片世界

H3-World把鍵盤輸入轉成可控制的未來畫面,展示互動式世界模型由理解指令走向操控環境。

Repository image for Danzer1xxxxChan/H3-World

按下 W、A、S、D 控制角色,或以 I、J、K、L 操控鏡頭,H3-World 便會由初始畫面生成相應的動作影片。這個項目屬於互動式世界模型,實際處理的是角色與鏡頭動作如何連貫地影響後續畫面,適合遊戲代理、視覺模擬及 Computer-use agents(CUAs)相關研究。

H3-World 建基於 MiniMax-H3,將每個鍵盤狀態轉換成對應未來 video latent 的語言指令,再透過 directed attention routing 把指令綁定到相應的 latent 區間。模型以 8,000 段 ABot-World-Explorer-500h gameplay clips 訓練,只學習 65.6M 個 Low-Rank Adaptation(LoRA)參數,約佔 33B backbone 的 0.199%,在保留大型模型能力與控制專用訓練成本之間取得折衷。

目前資料提供的重點包括:
– 角色控制使用 W、A、S、D;鏡頭控制使用 I、J、K、L,F 代表快速鏡頭移動。
– H3-World LoRA 是 MiniMax-H3 的 delta,不能直接套入未修改的 MiniMax-H3 pipeline。
– 推理需要約 135 GB 的 MiniMax-H3 base weights,以及 H3-World 的 directed-attention patch。
– 公開資料沒有列出明確的畫質、延遲或成功率比較,因此未能判斷它在不同世界模型之間的性能差距。

儲存庫提供 Python 3.10、CUDA 12.8、PyTorch 2.10.0 和指定版本 DiffSynth-Studio 的配置要求;模型權重及 LoRA checkpoint 則分別放在 Hugging Face 指定位置,訓練另需 ABot-World-Explorer-500h。研究團隊、遊戲代理開發者及需要可控影片生成的視覺模擬項目較容易受益,但硬件容量、專用 patch 和模型授權條款都是採用前必須核對的條件。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 多模態模型, 視頻模型, 模型訓練, NVIDIA, Video, Python, MiniMax

UI-Venus:多平台介面的高性能代理

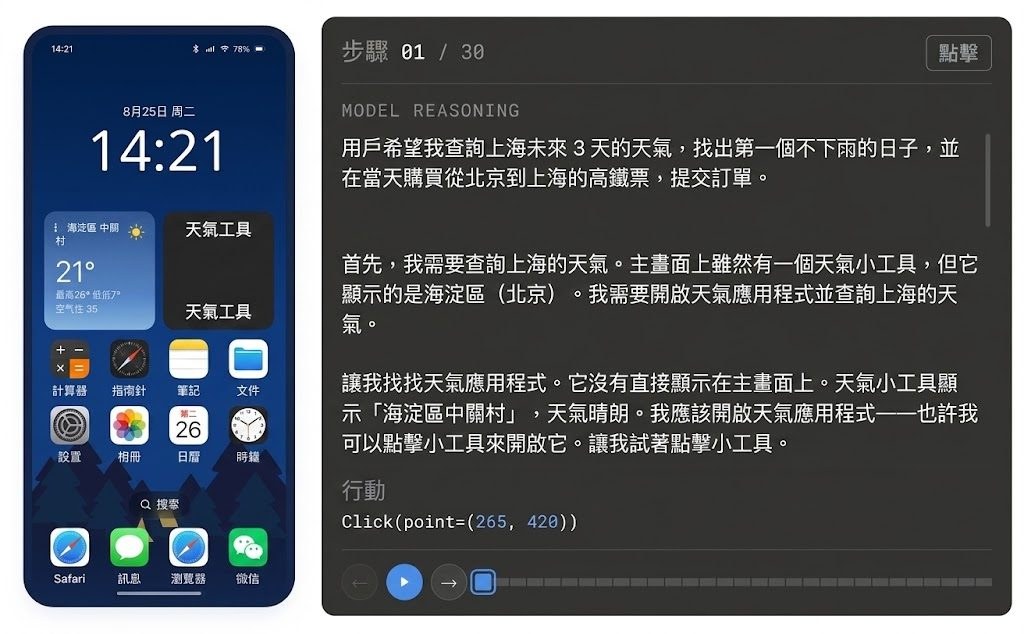
UI-Venus 是一個針對手機、桌面和網頁介面的 GUI agent,重點處理視覺定位與互動導航。它用 35 萬筆專業標註資料和 RFT 提升長流程操作與跨平台泛化。

UI-Venus Performance Across Datasets

UI-Venus 是一個 GUI agent,直接面向手機、桌面和網頁介面,目標是解決看得懂畫面、點得準位置、又能沿著多步驟流程完成任務這幾個卡位。它把 Reinforcement Fine-Tuning(RFT)放進訓練流程,令動作預測不只是識判斷,仲可以連住環境回饋去修正下一步。

項目提供 7B 同 72B 兩個 checkpoint,亦交代咗評估流程同推理腳本,方便按截圖、標註檔同模型路徑去做測試。不過原始資料未提供完整安裝細節同實際部署步驟,較合理的理解係先用它的推理與評估流程驗證在 ScreenSpot-Pro、OS-World-G、AndroidWorld 等基準上的行為。

它的賣點不只是識辨認介面元件,而係把 credit assignment 放到長鏈路任務入面處理,令代理在連續操作時較易對齊目標。官方聲稱它在 AndroidWorld、ScreenSpot-v2、UI-Vision 同相關跨平台基準有競爭力,對需要自動化操作、界面導航同複雜任務拆解嘅團隊會較有吸引力。

  • 針對 GUI 理解同 action prediction,覆蓋 mobile、desktop、web 三類場景
  • 以 350K 高質量、專業標註樣本訓練,並加入 RFT
  • 提供 7B 與 72B checkpoint,以及評估和推理腳本
  • 強調長流程任務的 credit assignment,適合多步驟互動工作
  • 基準表現覆蓋 AndroidWorld、ScreenSpot-Pro、OS-World-G 等項目

對要做介面代理、手機自動化、網頁操作或桌面工作流整合的團隊,UI-Venus 比較像一個可以直接拿去評估能力邊界的基礎模型。它的限制亦清楚:原始資料未交代完整安裝與落地流程,實際接入時仍要按你手上的環境、介面類型同任務難度再做驗證。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, UI/UX

Skill Router:讓 Agent 自己揀技能,毋須死記名稱

Agent 工具愈多愈難揀?Skill Router 在主 LLM 之前先用確定性規則分類請求,只選出一個主技能加必要輔助技能,仲會擋住高風險操作。

Repository image for luxurylifestyleco/skill-router

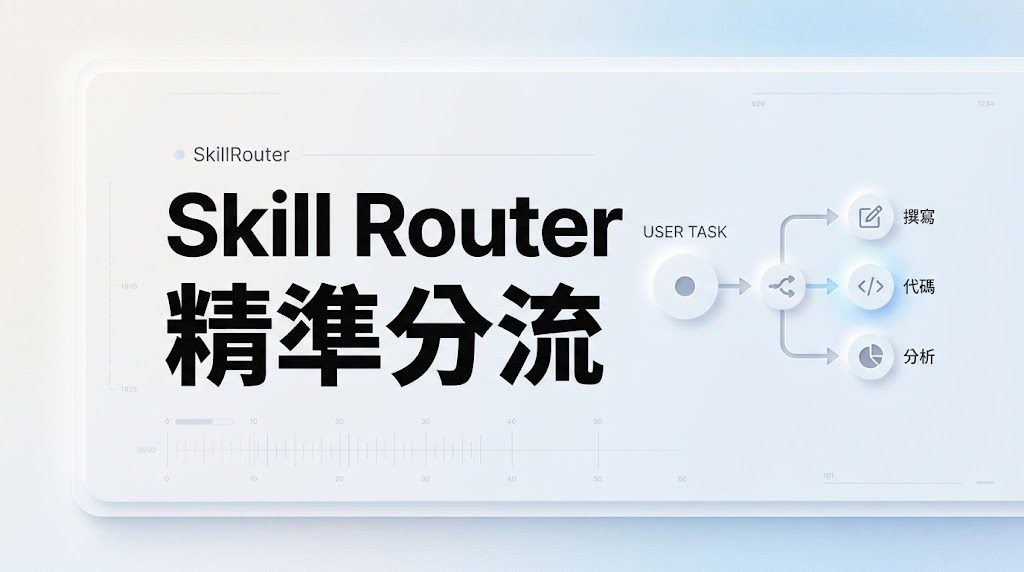
工具愈裝愈多,Agent 執行前最頭痛的往往係「到底應該召喚哪一個 skill」。這個名為 Skill Router 的開源項目正正針對這個痛點:它在主 LLM 介入之前,先以一套確定性(deterministic)方式把用戶請求分類,再揀選一個主技能配搭必要的輔助技能,最後輸出一份可供審計嘅裁決結果,而唔會將本地整份技能清單外洩。對管理大量工具嘅 Agent 開發者來說,這層路由令請求與執行之間多了一道可控嘅分流閘。

路由背後嘅結構相當直接:請求會先落入 8 個 action bucket(sense、understand、decide、create、operate、verify、learn、govern),再對應到 4 個 purpose bucket(data-enrichment、orchestration、utility、verification),然後再評估風險同依賴。分類完成後,系統會套用技能 manifest 內嘅 bucket、agent 同 skill 政策,只回傳最終被選中嘅配對。如果偵測到無效 manifest、缺失證據或依賴未就緒,路由會 fail closed 而唔係硬揀一個;如果請求涉及治理或具物質影響,就會觸發 Human Gate,將決定權交返俾人。

同坊間常見嘅「LLM 自己揀工具」做法相比,Skill Router 嘅取捨係將選擇權交給預先定義嘅規則,LLM 只負責執行被揀中嘅技能。犧牲咗一定靈活性,但換來可預測性同審計能力,亦避免將內部技能清單完整暴露俾模型。公開版本唔打包私有目錄、不打遠端服務、不收集遙測數據,運行環境只需要 Node.js 18+,零第三方依賴,並支援 Windows、macOS 同 Linux。

對於需要管理十幾甚至幾十個 skill、又要顧及合規同可審計性嘅團隊,例如內部 Agent 平台、企業自動化流程或帶敏感操作嘅助手,這層路由可以作為統一入口。對一般開發者而言,佢亦提供咗一個清楚嘅分類同風控範式,幫助避免「LLM 亂叫工具」嘅常見問題。

重點摘要

  • 請求先分流、後執行:8 個 action bucket 對應 4 個 purpose bucket,喺主 LLM 之前完成分類。
  • 只回傳必要技能:一個主技能加最少輔助技能,避免將整份本地目錄暴露。
  • 高風險自動擋住:治理或具物質影響嘅請求會觸發 Human Gate,由人手把關。
  • 缺資料就 fail closed:無效 manifest、缺失證據或依賴未就緒會直接 blocked,唔會硬猜。
  • 零依賴、易部署:Node.js 18+ 即可運行,公開包不含私有目錄或遙測,跨平台可用。

GitHub

Categories: 開源, Agentic, Mac, Linux, Skill 技能

CogEvol-4B 離線模型在手機筆電直接生成完整互動課程

CogEvol-4B 把一句課程大綱變成結構化投影片 JSON 加可獨立運行的互動 HTML,全程在筆電離線完成,無需 API 或雲端。

BF16 slide render

一般提到 AI 自動生成教材,多半還是要連雲端 API 才能輸出 HTML,但 CogEvol-4B 的做法是把整個流程壓進一個 2.4 GB 的 Q4_K_M GGUF 檔案。它以 Qwen3.5-4B 混合架構(48 層 GDN 線性注意力 + 16 層全注意力)為底,經過五萬多筆生產驗證樣本的 SFT,再做投影片 RL 與 HTML RL 兩階段強化,結果是單次前向傳遞就能同時吐出結構化投影片和自包含的互動式 HTML,不需要任何外部依賴。

在 MacBook Pro M2 Pro 16 GB 上,模型跑出約 33 tok/s 生成、470 tok/s prefill,整份互動課程約六分鐘完成。對教師、培訓設計師或自學者而言,這意味著斷網也能把一行大綱擴展成可互動的學習素材,不用排隊等雲端,亦沒有 API 成本。

項目可整合 OpenMAIC 與評測工具,權重放在 HuggingFace,並已整合到開源平台 OpenMAIC,透過 .env.local 切換本地 provider,再加上一個 runtime brief expander 補丁即可在斷網環境下渲染所有 widget。

重點摘要:

  • 離線可用:模型、應用、素材全部本地,關 WiFi 仍能完整跑
  • 極輕量部署:單一 2.4 GB GGUF 檔,Apple Silicon、CUDA、CPU 皆可
  • 一鍵生成:一句大綱直接變投影片 JSON 加可互動 HTML,無需 agent loop
  • OpenMAIC 原生整合:本地 provider 設定加上補丁,斷網渲染 widget
  • 雙重授權:程式碼 MIT、權重 Apache 2.0,可商用且易於二次開發

項目主頁 · GitHub • 模型

Categories: 開源, Agentic, 模型, Qwen

H3 分鏡技能:分鏡及表情提示

這個 Claude Code 技能把腳本拆成 MiniMax H3 可渲染嘅分鏡,主打情緒表演真正落到畫面。佢直接指出:同一格塞太多表情指令,H3 會靜靜丟棄。

Repository image for phileiny/h3-storyboard-skill

用 H3 做有情緒起伏嘅影片,最容易撞牆嘅位通常唔係 prompt 寫得唔夠仔細,而係你貪心將太多表情塞落同一格。呢個 Claude Code 技能就係針對呢個盲點:佢唔止幫你格式化 H3 嘅 prompt schema,仲會教你點樣拆鏡頭、每格留幾多 beat、點樣導演一張臉。

核心發現來自一個對照實驗。同一個 shock beat、三次跑、同一粒 seed、同一批 reference 圖,只改動鏡頭結構:A 方案係一格 7 秒 close-up 塞 9 個表情指令,結果臉完全唔郁,PSNR 高達 37–42 dB,即係畫面接近凍結;B 方案拆成三格 2–3 秒、每格一個 beat,PSNR 跌到 22–23 dB,所有 beat 都落到;C 方案喺 B 基礎加返 <d> 對白標記,PSNR 再降到 19 dB,但代價係鏡頭時間被 H3 重新分配,背景角色連門一齊被裁走。結論好直接:開工前先數 beat,超過兩三個就要拆鏡頭。

另一個值得留意嘅細節係「唔好寫乜都唔變」。H3 對靜態描述容易洩漏到成個鏡頭,想表達 pause 就交俾剪接手。尺寸同距離方面,佢建議用相對關係(畫面三分二高、離底部一手寬)而唔係絕對數字,否則渲染出嚟會走樣。形狀就靠 reference 圖頂住,純文字三次都搞唔掂一個 1.75:1 嘅窗框。

需要用 H3 拍敘事短片、廣告 storyboard、或者任何要精準控制表情嘅創作者。比起坊間只做翻譯嘅 H3 技能,呢個項目多走一步:佢承認有啲規則只係推論(effect 係真實嘅,cause 仍未隔離),全部齊齊整整列喺 SOURCES.md 分做 verified、partly verified、inferred。

  • 屬於工具類 Claude Code 技能,解決 H3 prompt 表情指令被靜默丟棄嘅問題
  • 對照實驗證明分鏡頭係恢復情緒表現嘅關鍵機制
  • 對白標記唔會令臉郁,只會改變 H3 對鏡頭時間嘅分配
  • 距離用相對關係、形狀靠 reference 圖,純文字描述容易失效
  • SOURCES.md 將規則分三級誠實標註,邊個有控制實驗支持一目了然

GitHub

Categories: 開源, ComfyUI, Anthropic, MiniMax, Skill 技能

ABot-Recon 用 12 幀極簡局部記憶重建 3D

AMAP CVLab 提出的 ABot-Recon 放棄複雜的長程記憶機制,改用固定的 12 幀局部上下文,逐步拼接出穩定的長影片 3D 重建結果。

ABot-Recon long-horizon reconstruction teaser

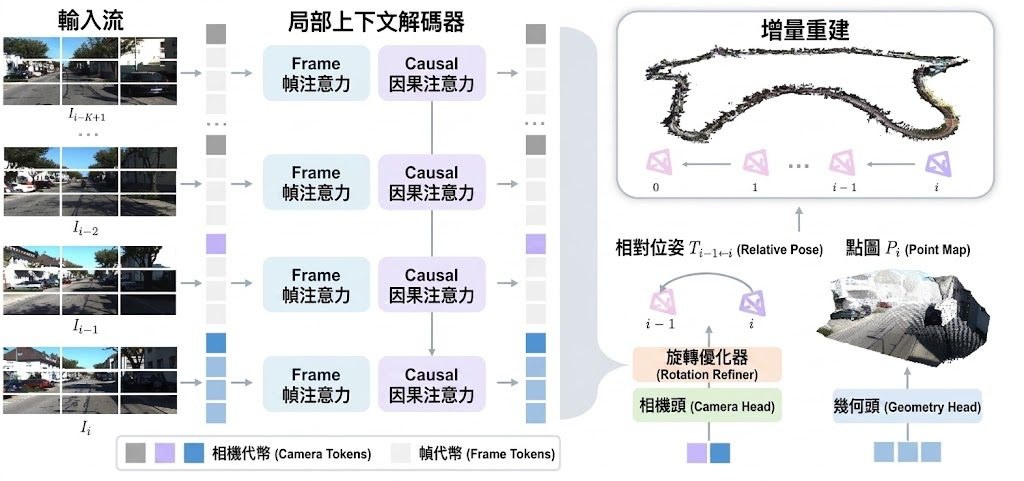
ABot-Recon 是一款專為長影片流(streaming)設計的 3D 重建框架,來自阿里 AMAP CVLab。它選擇了一條反潮流的路線:不堆疊長程記憶模組,而是用固定的 12 幀局部上下文,邊看邊重建。對於自駕車、機器人或 AR 導航這類需要持續處理長影片的場景,直接解決了「序列越長、記憶越爆」的核心痛點。

運作上,模型每一幀只參考前 11 幀的 KV 特徵,預測當前幀的點圖(point map)與相鄰幀的相對位姿,再透過位姿串接逐步還原出全域軌跡與點雲。這意味著模型狀態記憶與單幀計算量都不會隨影片長度增長,硬體門檻更容易控制。

與傳統做法相比,ABot-Recon 刻意避開了持久學習式長程記憶,用一個輕量的 motion-visual rotation refiner 和 composition-aware pose loss 來壓制位姿累積誤差,把「記憶」的責任還給幾何拼接本身。

這套做法適合需要長時間穩定重建、又不想被龐大 GPU 記憶體綁架的團隊,例如自駕資料處理、機器人 SLAM 或城市級掃描項目。Hugging Face 與 ModelScope 已有現成 Demo 可即時試玩,模型權重同步開源;訓練代碼與完整訓練方案預計於 9 月 30 日前釋出。

重點摘要:
– 固定 12 幀局部上下文,拒絕堆疊長程記憶
– 記憶與單幀計算量與序列長度解耦
– 以位姿拼接 + 旋轉優化抑制長距離誤差累積
– Hugging Face / ModelScope 提供線上 Demo
– 訓練代碼與配方預計 9 月 30 日前開源

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 世界模型, Robotic, 3D

Page 6 of 35
1 … 4 5 6 7 8 … 35