NeuraDock Agent:把 7 通道 EEG 變成可用狀態訊號

這不是一般腦波展示工具,而是把7通道EEG整理成可供應用程式使用的即時狀態。它重點不在生成炫技介面,而在穩定解析、質量把關與本地處理。

Repository image for Neuradock/eeg-workstation-agent

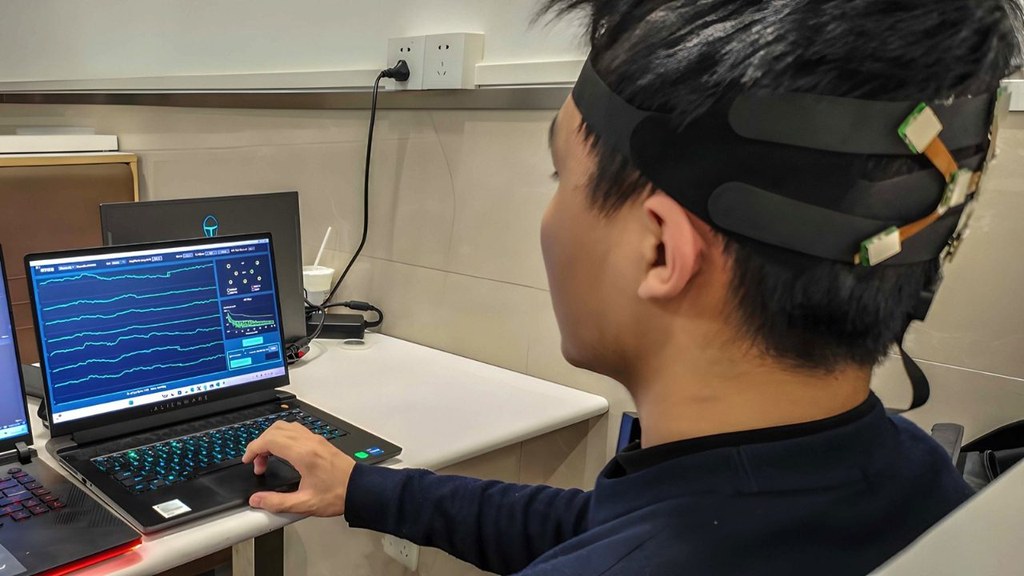
NeuraDock/eeg-workstation-agent 是一個本地優先的 Python 工具項目,也可視為面向應用整合的 EEG agent。它主要將 NeuraDock EEG Workstation 的 7 通道腦電訊號,轉成經過質量檢查的 visual cognitive-load 狀態,讓介面、XR、車載 HMI 或互動系統可以即時讀取,而不必直接處理原始 EEG。

現有不少 EEG 流程會把重心放在原始波形顯示、離線分析,或讓開發者自行拼接 preprocessing、quality control 與特徵提取;作者在技術文件中明確反對讓通用 LLM 直接對感測結果作自由解讀的做法。這個項目的取向,是把 deterministic local EEG engine 與 hardware-aware language layer 分開:前者負責解析、前處理、spectral workflows 與 machine-readable artifacts,後者只接收 allowlisted summary 與 versioned context pack,避免模型對 7-channel EEG 說出超出量測邊界的結論。

NeuraDock EEG Agent Workflow

部署路線算清晰。儲存庫列出 Python 版本範圍、支援 Windows、macOS、Linux,亦提供無硬件 synthetic replay,所以就算未買 NeuraDock EEG Workstation,也可以先啟動本地 dashboard 與 API,檢查 GET /api/status 會輸出哪些欄位;真正連接裝置時,Agent 會經 TCP 收流、做 online preprocessing,再輸出如 visual_load_index、alpha_peak_hz、alpha_suppression_from_baseline 及 quality.status 等狀態。示例資料要到另一個資料儲存庫下載,這裡沒有直接附上人類 EEG 數據,反映作者對資料安全與分發邊界相當保守。

和同類做法相比,它的差異不在「能否分析 EEG」,而在於它刻意收窄可宣稱的範圍。這套工具聚焦 posterior Alpha dynamics、within-subject Rest/Task visual cognitive-load comparison,以及 quality-gated adaptation,並清楚說明它不是 medical device,亦不能直接診斷 attention、fatigue、impairment 或跨個體比較表現。這種取捨令它的野心比一些泛用腦機介面平台細,但換來較可控的輸出與較低的誤讀風險。

  • 定位明確:屬於本地執行的 EEG 分析工具項目,重點是把 7 通道訊號轉成應用可讀狀態。
  • 測試門檻較低:有 synthetic replay,未接硬件都可以先驗證 dashboard、API 與流程。
  • 邊界控制做得細:LLM 不接觸 raw EEG 與 dense time-series arrays,只接收精簡指標與受控上下文。
  • 適合即時互動場景:視覺搜尋、adaptive vehicle HMI、cognitive load game 都是直接示範。
  • 資料解讀有限制:結果偏向個體內比較,不適合把不同人的 workload 分數直接放在同一把尺上。

性能描述方面,技術報告提供了幾個辨識度很高的訊號。其一,12 份錄音在十次 numerical repetitions 下得到相同 structured results,完整 Rest/Task 執行在三次重跑下亦產生相同 result、report 與 figure hashes,說明 deterministic pipeline 不是口號。其二,作者做了 request-capture 與 failure-injection experiments,檢查資料邊界與本地 artifacts 在 HTTP、格式錯誤及連線失敗下是否仍能保留。其三,boundary-awareness benchmark 涵蓋 ordinary 與 adversarial questions,並結合 qwen3.7-max 和 kimi-k2.6 生成輸出;這部分重點不是比較哪個模型最聰明,而是檢查語言層有沒有超越硬件與工作流容許的解釋範圍。

相關模型與組件方面,README 沒有把核心 EEG 推理包裝成 foundation model,而是以 reviewed workflows 為中心;可見的外部模型主要是 optional LLM mode 會用到的 LLM,例如 qwen3.7-max、kimi-k2.6。適合受益的人,包括做 HCI、XR、遊戲互動、復健訓練、工業監測與研究原型的團隊;他們想要的通常不是一套醫療級診斷系統,而是一個可以穩定輸出、容易接入前端或控制邏輯、又盡量把資料留在本機的腦訊號工具鏈。
項目主頁 · GitHub · Paper

Categories: Agentic, Qwen, API, 框架, Medical醫學, Mac, Linux, Python

用 vision-language-action 把人類操作轉移到機械人的雙手

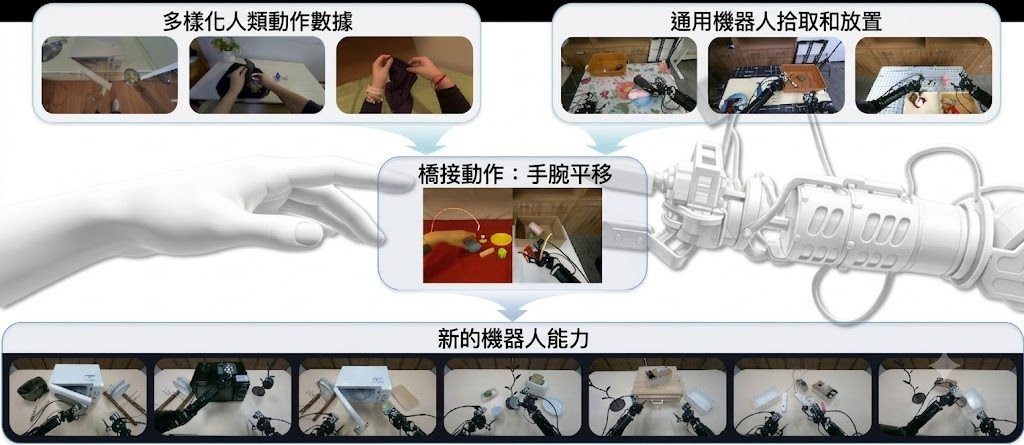
這項論文提出一種橋接動作表示,改善人類示範向雙手夾爪機械人的技能轉移。重點在於避開嘈雜的6DoF手部姿態。

Hugging Face

人類操作數據廉價、豐富且多樣化,使其成為擴展機器人學習規範最有前景的資源之一。然而,將人類技能遷移到機器人仍然困難重重:以往的大多數工作都將人類視為另一種雙手6自由度(6DoF)的具身模型,這存在兩個問題:手部姿態估計存在噪聲,並且人類手指的接觸模式與並聯機械臂的接觸模式存在根本差異,導致手腕旋轉與機械臂操作在語義上不一致。我們認為,從人類資料中學習包含旋轉的動作訊號並非最優方案,因此提出了一種 橋接動作表示:在初始頭部-攝影機座標系內的相對手腕平移,這是一個人類和機器人共享的動作空間。

如何把人類操作資料轉移到使用 parallel grippers 的雙手機械人,重點方法是用「relative wrist translation within the initial head-camera frame」作為 bridging action representation。

作者認為把人類直接當成另一種 bi-manual 6DoF embodiment 並不理想,因為手部姿態估計本身有噪聲,而且人手手指接觸模式與 parallel gripper 有本質差異。與其硬學包含旋轉的動作訊號,這項工作改為只保留更容易跨人類與機械人共享的平移資訊,減少 embodiment mismatch。

作者建立了一個 π0-like vision-language-action model,配合 interleaved action tokens 與 attention masking,處理不同 embodiment 可能缺少某些動作成分的問題。這種設計的意義,在於模型不需要假設人與機械人擁有完全相同的控制維度,較適合跨載體技能遷移。

  • 以 wrist translation 取代完整 6DoF human actions,降低人手到夾爪的表示落差
  • 採用 vision-language-action 架構,並加入 interleaved action tokens 與 attention masking
  • 在 novel bi-manual manipulation tasks 上,較 noisy 6DoF human actions 有更有效的知識轉移
  • 效果會隨 human data 數量增加而提升,說明方法具備一定擴展性

這項內容較接近方法論與表示學習分析,而不是部署指南。頁面沒有列出推論框架、硬體需求、v2 檔案更新、chat template 或 MTP draft speculation 等資訊;能確定的是,它針對 Robotic 技能轉移提出一種更貼近夾爪機械人控制需求的動作抽象,適合關注 imitation learning、cross-embodiment transfer 與雙手操作研究的人閱讀。

項目主頁 · Paper

Categories: 香港大學, 字節跳動, 視覺模型, 多模態模型, Robotic, Skill 技能

ProMSA 把 KB-VQA 變成會搜尋的代理

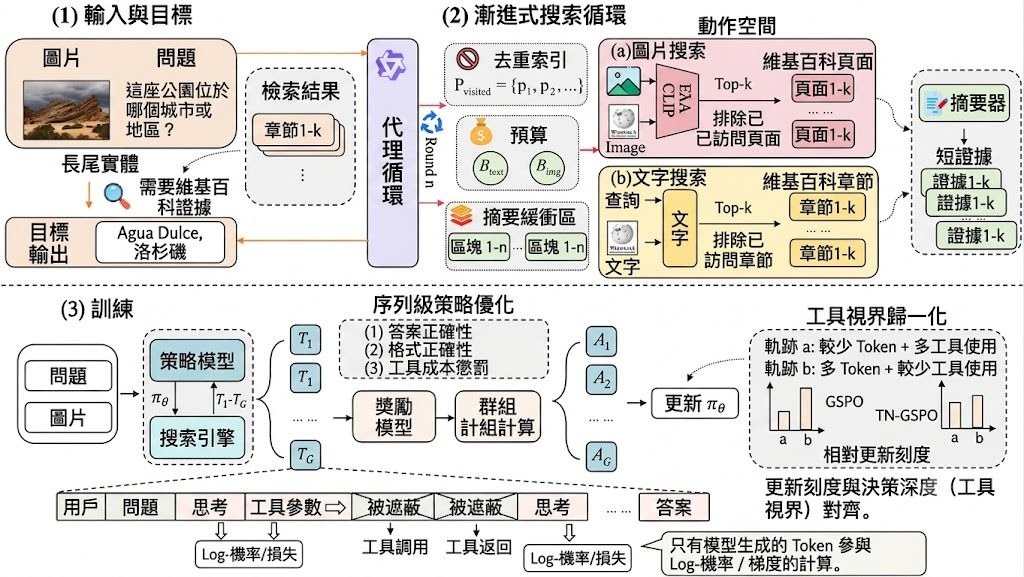
ProMSA不是普通問答模型,而是會逐步搜尋證據的KB-VQA研究項目。它用TN-GSPO訓練代理,重點在於搜尋節奏、模態切換與停止時機。

ProMSA overview

這是一個針對 Knowledge-Based Visual Question Answering(KB-VQA)的研究原型兼訓練項目。它要處理的問題,是模型不只要看懂圖片內容,還要連接外部知識來源例如 Wikipedia,先找對實體,再用足夠證據回答問題。

現有做法多數採用固定的 retrieve-then-generate 流程:先選好 retriever、設好 static top-k,再做一次檢索後直接生成答案。作者認為這種範式遇到 long-tail entities 很脆弱,第一步找錯就難以修正,也不擅長組出 multi-hop 證據鏈;所以 ProMSA 改成 progressive multimodal search agent,讓同一個 MLLM 逐輪決定用 image search、text search,還是 stop。

這個項目的取向很明確:它不是單純把檢索接到模型前面,而是把搜尋本身變成推理流程一部分。配合 de-duplication exclusion list、tool-call budget 同 reward penalty,它會避免重覆撈同一批內容,亦會在證據足夠時停手,減少無效工具呼叫;訓練上再用 TN-GSPO,而不是只靠 GRPO 或 vanilla GSPO,目標是令長度與工具步數不同的軌跡都能較穩定更新。

  • 支援 image search、text search、stop 三種動作
  • 針對錯誤首次檢索加入 failure recovery 與 multi-hop 搜尋
  • 採用 veRL 工具介面,包含 multi-turn rollout、reward 與 loss
  • policy backbone 包括 Qwen/Qwen2.5-VL-7B-Instruct、Qwen/Qwen3-VL-2B-Instruct、Qwen/Qwen3-VL-8B-Instruct

網頁 已交代 Installation、Data & Model Preparation、Service Architecture、Training 同 Evaluation,表示它不只是概念展示,而是有完整實驗流程的研究項目;不過部署時應預期需要 Python 3.10+、veRL、外部搜尋服務同相應資料準備。結果描述提到在 E-VQA 與 InfoSeek 對強 RAG 和 agent baselines 有一致提升,但目前提供的是研究報告式結論,較適合做 KB-VQA、multimodal agent、RAG policy 訓練的團隊參考,而不是即裝即用的通用產品。

項目主頁 · GitHub · Paper

Categories: 清華大學, Agentic, RAG, 視覺模型, 模型訓練, Qwen, Python, 中國

LLM 組合唔一定勝過最佳單模

呢個 Hugging Face Space重點唔係新模型,而係用統計上限分析多模型編排何時無明顯收益。

Og image

這是一個 Hugging Face Space,用來展示多個大型語言模型組合策略的分析結果,而不是可下載微調模型;頁面亦無提供 base model,因為它本身並非基於某個基礎模型微調而成。它主要回答一個很實際的問題:把多個 LLM 放入 routing、voting、cascade 或 mixture-of-agents(MoA)之後,是否真能穩定超越單一最佳模型。

核心結論圍繞 β = P(all wrong),即所有模型在同一題一起答錯的機率。文中指出,凡是輸出仍然只能選自成員模型答案的策略,理論上準確率上限就是 1 − β;常見的 pairwise error correlation ρ 即使相同,亦未必能反映 β,所以只看模型之間「錯得是否相似」並不足以估算可提升空間。

這個項目的價值,在於它把模型編排問題由「多加幾個模型會否更準」轉成「這些模型是否在不同題目上出錯」。作者用 67 個 frontier models、21 個供應商資料說明:就算是多樣化模型池,all-wrong tail 仍比單靠相關性模型估算更高;在 open-ended mathematics、execution-graded code 這類可檢查任務,多模型通常難以大幅勝過最強單模,除非有很強的 query-level routing signal。

  • 這不是生成模型權重頁,沒有參數規模、context length、GGUF、mmproj 或量化檔案清單
  • 不涉及 llama.cpp、Ollama、LM Studio 部署,亦無 Q4_K_M 一類量化建議
  • 方法重點是用 Clopper–Pearson bound 先估計 β 上限,再判斷是否值得訓練 router
  • 與 Self-MoA 類做法相比,低 ρ 且真正「錯題互補」的模型組合更有機會帶來收益

對技術決策者而言,這個 Space 更像一個模型編排可行性檢查工具。它提醒人不要把 orchestration 當成免費性能加成:當共同失敗率高,多模型系統增加的可能只是成本、延遲與系統複雜度,而非可觀準確率提升。

項目主頁 · Paper

Categories: Agentic, Qwen, OpenAI, DeepSeek, Gemini, 工具, LLaMa, Ollama, Anthropic

GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

OpenBioRQ 用未解醫學問題測試 AI 代理

這不是一般醫學問答集,而是用未解研究問題檢驗 AI 代理找證據與引用是否可信。它更重視能否誠實保留不確定性。

Repository image for minstar/healthcare-research

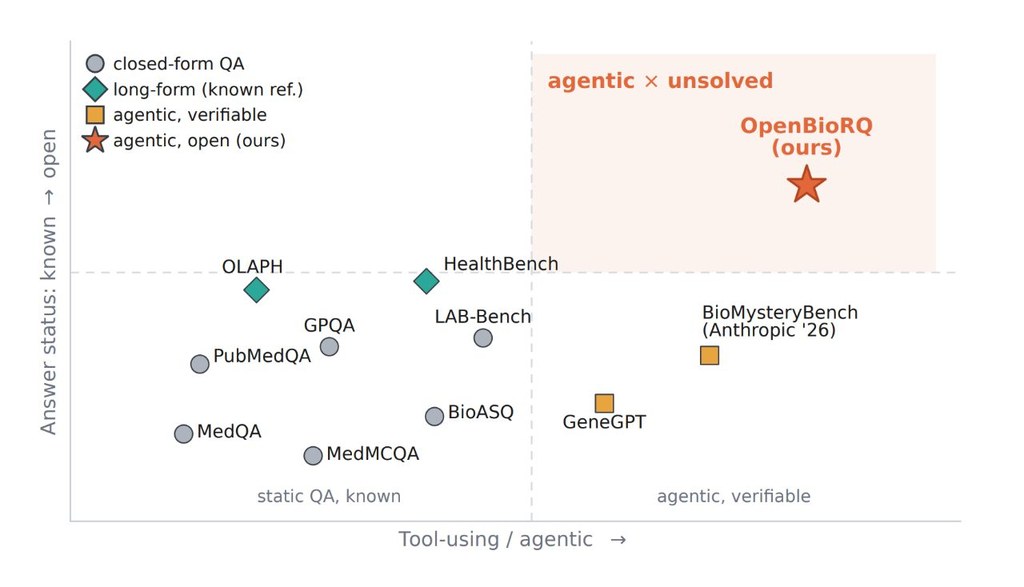
OpenBioRQ 是一個生物醫學基準資料集兼評測流程,聚焦於目前仍未解決的 biomedical / clinical research questions。它要解決的不是背答案能力,而是測試 LLMs 在 agentic tool use 情境下,能否自己找證據、正確引用文獻,並在沒有定論時保持 abstention。

現有 benchmark 多數採用固定答案 key 的問答範式,模型有機會靠記憶或線索反推標準答案,未必真的驗證過來源。OpenBioRQ 直接改用 retrieval-grounded openness:每條問題的 open_status 會用後續論文與 trial records 重新核對;難度也不是作者主觀標示,而是先讓強模型連工具一起跑,再用 pass/fail 結果界定哪些題目真的難。

項目的資料流程相當完整,從 crawl、extract、refine、dedup,到 status verification、contamination audit、agentic-eval 都有清楚分工。README 顯示它以 v3 的 12,553 題為基礎,另有 frozen core 作主要評測集;refine 步驟亦把問題整理成較自足的表述,自含性由 51.6% 提升到 85.4%,這對模型和人工評審都重要。

它和同類做法最大的分別,是把「引用可打開」與「引用真的支持答案」分開看。項目指出 agent citations 超過 99% 可以解析,但約 15.9% 其實連到錯誤論文;同時最難題組出現 agentic collapse,部分模型就算關掉工具,分數變化也不大,反映工具調用未必自然轉化成更好推理。

  • 類型定位:屬於基準資料集加評測 pipeline,不是臨床決策系統
  • 主要價值:檢查 evidence retrieval、faithful citation 與 abstention,而非考模型背誦
  • 評測設計:用 per-question checklist rubrics 固定評分,inter-judge agreement 由 Spearman 0.35 升到 0.82
  • 資料可靠性:core 657 與 expand 483 均報告 contamination hard 0%
  • 相關模型:Google、Anthropic、OpenAI 三條獨立 lineage,以及 README 提到的 GLM-5.1、MiniLM-L6

受惠最大的會是做醫療研究助理、文獻檢索代理、醫學 AI 評測的團隊,而不是想直接拿去做診斷的機構。它目前更像一個研究基建項目:幫人看清楚模型在高不確定、無標準答案場景下,究竟是有能力找證據,還是只是在生成看似合理的回答。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, Medical醫學, Anthropic, Dataset 數據集

Qwythos-9B GGUF 技術拆解

這是 Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版,主打 1M context、推理與工具調用。頁面亦交代 v2 檔案更新與 MTP 用法。

Og image

這個模型之所以值得注意,主要是因為它把 推理能力、超長上下文、以及本地部署友好性 結合在一個 9B 級別的模型裡。它是基於 Qwen3.5-9B 的全參數推理模型,並用 5 億多條 Claude Mythos / Claude Fable traces 做後訓練,還支援 1M context、vision 和 function calling 。

Hugging Face empero-ai/Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版本屬於 quantized 形式,而非原始訓練權重。它的主要用途是在 llama.cpp、Ollama、LM Studio 等 GGUF 執行環境中部署一個支援推理、視覺輸入、function calling 與長上下文的 9B 模型;其表現超越 base Qwen3.5-9B,但這一層關係屬於上游模型說明。

Qwythos-9B 是 full-parameter reasoning model,經過超過 5 億 tokens 的 Claude Mythos / Claude Fable traces 後訓練,並使用 Empero AI 內部 rethink 工具生成 chain-of-thought。能力上支援 1,048,576 tokens(1M context),透過 YaRN rope-scaling 預設開啟;同時標示為 image-text-to-text、multimodal、vision、agentic,表示它不只是文字聊天模型。

v2 已要求重新下載,原因包括 tokenizer metadata 對 Qwen3.5 GGUF runtimes 的修正、chat template 更新,以及新增 -MTP- 版本。已列出的一般版本包括:Qwythos-9B-Claude-Mythos-5-1M-Q4_K_M.gguf(5.24 GiB,官方建議預設)、Q5_K_M(6.02 GiB)、Q6_K(6.85 GiB)、Q8_0(8.87 GiB)與 BF16(16.69 GiB);頁面亦提到 vision projector smoke-tested,但截取內容未見 mmproj 檔名。

  • Q4_K_M 是最適合起步的量化級別,容量較低,而且頁面直接標成 recommended default
  • Q5_K_M / Q6_K 較適合想提高品質、又想控制記憶體佔用的部署
  • Q8_0 接近 near-lossless,較適合重視輸出穩定度的情境
  • -MTP- 檔案是為 llama.cpp MTP draft speculation 準備,一般相容性則以普通檔名版本較穩陣

與一般只做指令微調的同類模型相比,這個項目強調三點:一是 1M context 已預設可用,二是 native function calling 依照 Qwen3.5 spec,三是 v2 連 chat template 都針對 tool calling 與 OpenCode-style agent loops 修正。限制亦很清楚:完整訓練細節與評測數字需要回到 base model card 查看,而這個頁面主要是量化分發頁;使用時亦要留意舊版 GGUF 檔名已被替換,否則 chat template 與 runtime 相容性可能受影響。

項目主頁

Categories: 開源, Agentic, 模型, 多模態模型, Qwen, Image, Anthropic

Robust-TO:更穩陣的影片理解代理框架

Robust-TO 針對 Video-LLMs 在受干擾影片中的誤判問題,用信心分數協調工具與證據。重點不只準確率,還包括出錯時能否有節制地退化。

Repository image for ROVA-V2/Robust-TO

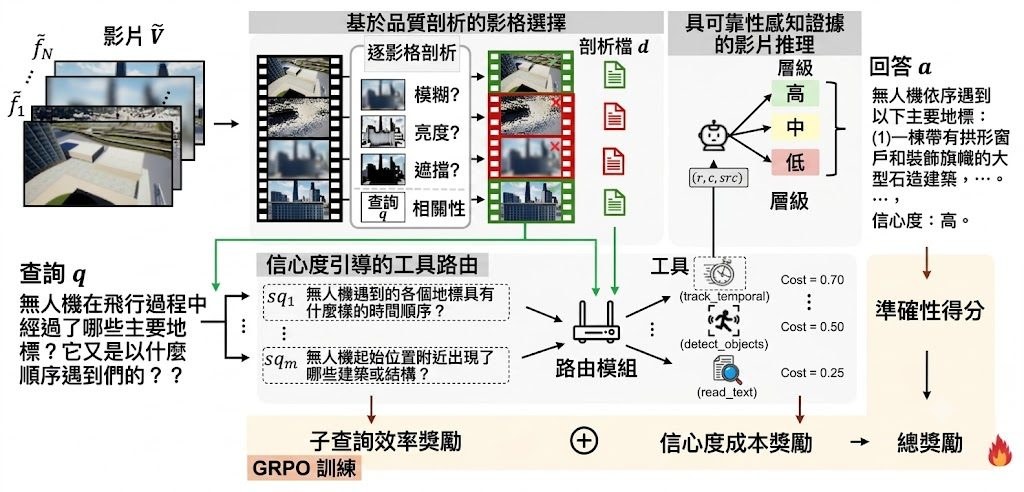
Robust-TO 是一個面向影片理解的 agentic framework 研究原型。它主要解決 Video-LLMs 在模糊、過暗、遮擋等干擾下,仍然盲目相信每一格畫面,導致答案與自信程度脫節的 Blind Trust Problem。

現有做法常把所有影格近乎同等對待,再交由單一模型或固定流程推理;作者認為這種範式忽略了畫面可靠度,所以提出 Confidence-Aware Tool Orchestration。它先用不需額外參數的 profiler 為每格評估 blur、brightness、occlusion,只保留較可靠片段,再把問題拆成子查詢,交由 track_temporal、detect_objects、read_text 等工具處理,最後用 High / Mid / Low 三層證據整合答案。

這個項目最值得留意的,不是單靠更大模型硬推結果,而是把 (result, confidence, source) 當成統一介面,連工具成本與可靠度一併納入。取捨也很明顯:流程比直接問一個 Video-LLM 更複雜,但換來對受污染影片更穩定的表現,而且官方指出在乾淨輸入上延遲開銷低於 5%。

  • 平均準確率比最強開源基線高 +10.6
  • clean-to-corrupted accuracy drop 最小,重點在抗干擾而非只看乾淨數據
  • 使用 GRPO 訓練 policy,獎勵同時考慮正確性、證據可靠度與計算成本
  • 相關組件與模型角色包括 profiler、Router,以及工具如 track_temporal、detect_objects、read_text

目前較適合把它理解為方法框架與研究結果,而不是立即可部署的成品。較受用的會是做 Video-LLMs、Computer-use agents、CUAs 式多工具協作、影片問答或魯棒性評測的研究團隊,特別是想把「模型知道自己何時不可靠」納入系統設計的人。

GitHub

項目主頁

Paper

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Video, 框架

Hermes3D:把 AI 團隊放進 3D 辦公室協作

Hermes3D 將 AI agents 的工作流程搬入自建 3D 辦公室,讓協作、程式碼審查和 QA 監控變得可見。

Hermes3D

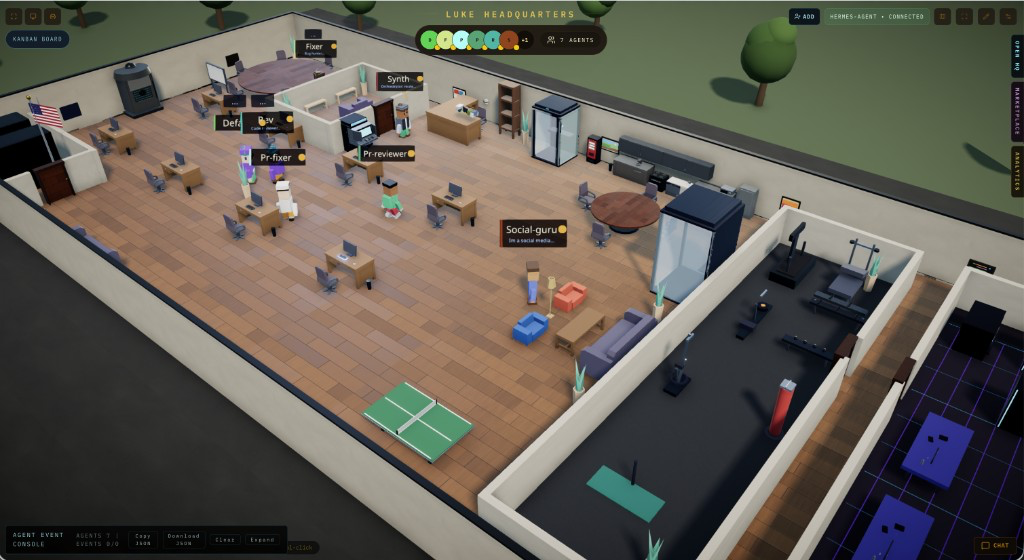
將 AI agents 的協作、standup、Pull Request 審查和 QA pipeline 放進同一個可行走的 3D 空間,Hermes3D 便是一個自建的 3D 虛擬辦公室項目,處理的是 AI 工作流程難以觀察和管理的問題。它把原本分散在 dashboard、GitHub、Jira 和 logs 的活動,集中到共享辦公室內呈現。

Hermes3D 本身只是 visualization and interaction layer,Gateway 則負責控制和連接後端。項目支援內置 Gateway adapter,讓 Hermes 透過 WebSocket 接入;亦可使用 direct HTTP custom runtime provider 連接其他 orchestrator-backed stacks,另有 built-in demo gateway,方便先探索辦公室功能而毋須接入真正的 agent framework。

使用者可先用 demo gateway 檢查 3D 辦公室、代理協作和介面流程,再按需要接駁 Hermes、GitHub、Jira 或自訂 HTTP runtime。README 暫未提供完整安裝步驟或效能基準,因此較適合視為仍在發展中的 self-hosted workspace,而不是可直接取代現有監控系統的成熟平台。

  • 以 3D 場景即時查看 AI agents 的工作狀態
  • 在辦公室內進行 standup、Pull Request 審查和 QA 監控
  • 透過 gym 訓練 agents 發展新技能
  • 以 janitor system 重設 session 和清理 context
  • 支援 Hermes、custom runtime 及 demo gateway

對管理多個 AI agents、需要追蹤程式碼交付流程,或希望資料留在自家基礎設施的個人開發者和小型團隊,Hermes3D 提供了比純文字 logs 更直觀的觀察方式。代價是 3D 顯示層會增加系統複雜度,是否適合正式工作流仍要以團隊自己的 runtime 和整合測試為準。

GitHub

Categories: 開源, Agentic, 框架, 3D

Wan Streamer:即時生成影音互動模型

阿里推出的 Wan Streamer v0.1,以單一 Transformer 同時處理聽、說、看、生成,實現亞秒級全雙工音視頻互動。

Wan Streamer framework

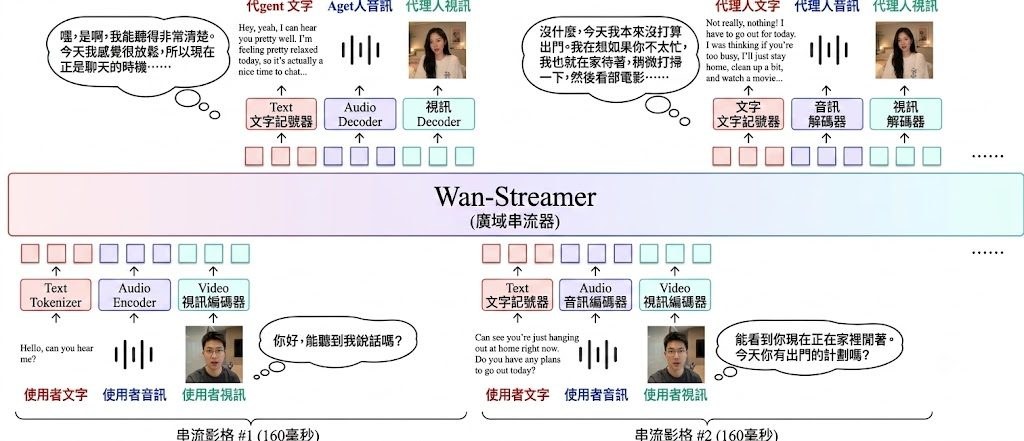
Wan Streamer v0.1 是一款由阿里巴巴(通義萬相/Wan 團隊)開發的原生流式端到端基礎模型,專為即時、低延遲、全雙工的音視頻互動而設計。它把語言、音訊、影像同時作為輸入與輸出,全部整合在單一 Transformer 之中,並以 block-causal attention 協調增量式生成。

現有即時互動系統普遍存在的延遲與不同步難題。純語音方案雖然回應快,但沒有可見的影像輸出;音視頻方案則多由 ASR、語言模型、TTS、動畫模組拼接而成,每個邊界都會疊加延遲,而且很少有系統公開端到端時延數字。Wan Streamer 把整個流程重新設計為可流式架構,包括因果編解碼器、block-causal attention、低延遲多模態 token 排程,在 25 fps 下最短流式單元可達 160 毫秒。

與常見做法的最大差異在於「端到端」與「同步影音輸出」。模型側延遲約 200 毫秒,加入 350 毫秒雙向網絡延遲後,總互動延遲約 550 毫秒,可支援亞秒級全雙工通訊。同時輸出語音與影片內容,而非分別由不同模組拼接,這是它最值得留意的特點。模型覆蓋聽、看、思考、說話、生成影像回應五種能力,適用於需要即時數字人、互動助理、虛擬陪伴等低延遲場景。

重點摘要:

  • 由阿里 Wan/通義萬相團隊研發,定位為即時互動基礎模型
  • 單一 Transformer 同時處理語音、影像、文字輸入與輸出
  • 模型側延遲約 200 毫秒,總互動延遲約 550 毫秒
  • 支援 25 fps 串流,最短流式單元 160 毫秒
  • 與拼接式方案相比,延遲更低且影音輸出真正同步

項目主頁: https://wan-streamer.com/

Categories: 阿里巴巴, Agentic, 數字人, 模型, 多模態模型, 視頻模型, 語音

Page 23 of 35
1 … 21 22 23 24 25 … 35