Cura 1T 瞄準醫療代理工作流

Cura 1T唔只想答醫療問題,而係朝住診療對話、臨床推理同 EHR 操作一條龍處理。對想評估醫療 Agentic 能力嘅團隊,呢個項目值得細看。

main comparison

醫療場景最難處理嘅,往往唔係單次問答,而係要連續對話、讀文字同影像、再連到 EHR 做操作。Cura 1T 就係朝住呢種 Agentic healthcare 用途打造嘅大型模型,重點不在通用聊天,而在病人諮詢、臨床推理同 FHIR-based record operations 呢三類高風險任務。

同類模型多數以通用能力再加醫療微調去應付需求,Cura 1T 則明顯押注 recursive self-improvement:由 training agent 規劃目標能力、訓練、沿 benchmark trajectories 找失誤,再調整 data mixture,而且每輪都有人類決定 keep-or-revert。呢個取向反映佢想解決嘅不只是知識覆蓋,而係醫療流程中跨回合、跨工具、跨模態嘅穩定度。

現階段最實際係經 OpenAI-compatible API 接入,model id 為 actava/cura-soar;公開資訊未見完整開放權重,較似面向企業試用與系統整合,而唔係本地自行訓練或離線推理。對醫療機構、健康科技團隊,或者要做 EHR、care management、行政自動化項目嘅開發者,呢種交付方式會較直接。

  • 以醫療模型定位,但核心賣點其實係 agentic workflows
  • 支援 text + vision,同時提供 256K context,適合長病歷與多模態判讀
  • 基於 Kimi-K2.6 後訓練而成,並非由零開始訓練
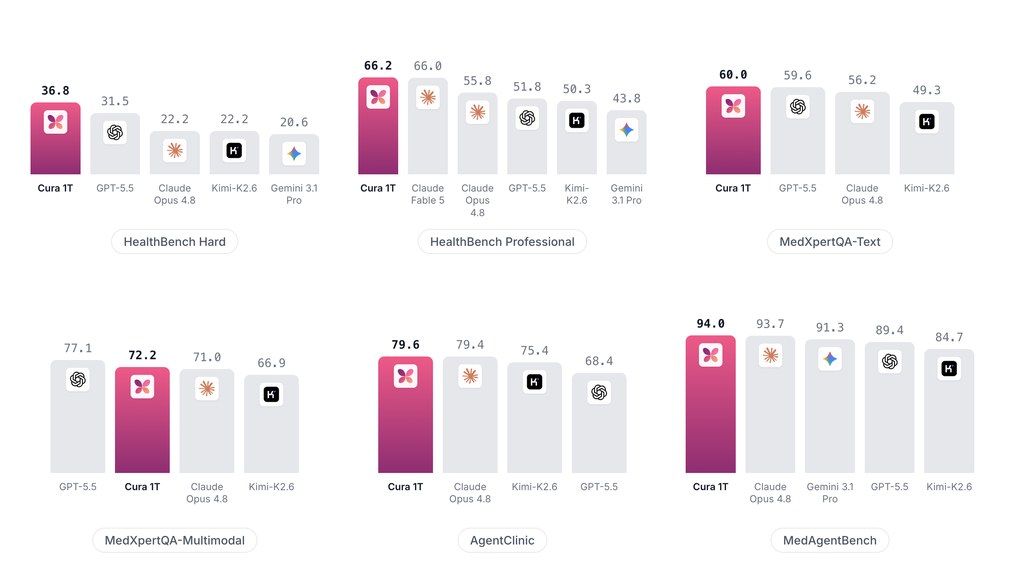
  • 基準測試在 6 個 healthcare benchmark panels 之中領先 5 項,但 MedXpertQA-Multimodal 仍落後 GPT-5.5

表現:HealthBench Hard 36.8、HealthBench Professional 66.2,亦在 AgentClinic 與 MedAgentBench 略勝 Claude Opus 4.8;相對 base model Kimi-K2.6 亦有明顯進步。要留意嘅限制係,分數來自 technical report 指定 protocol,而且 API 仍需排隊申請,現階段更適合做能力評估、流程驗證同企業整合規劃,未算係隨手可用嘅開源醫療模型。
項目主頁 · GitHub · Paper

Categories: 清華大學, Agentic, 多模態模型, API, Medical醫學, Dataset 數據集, Kimi

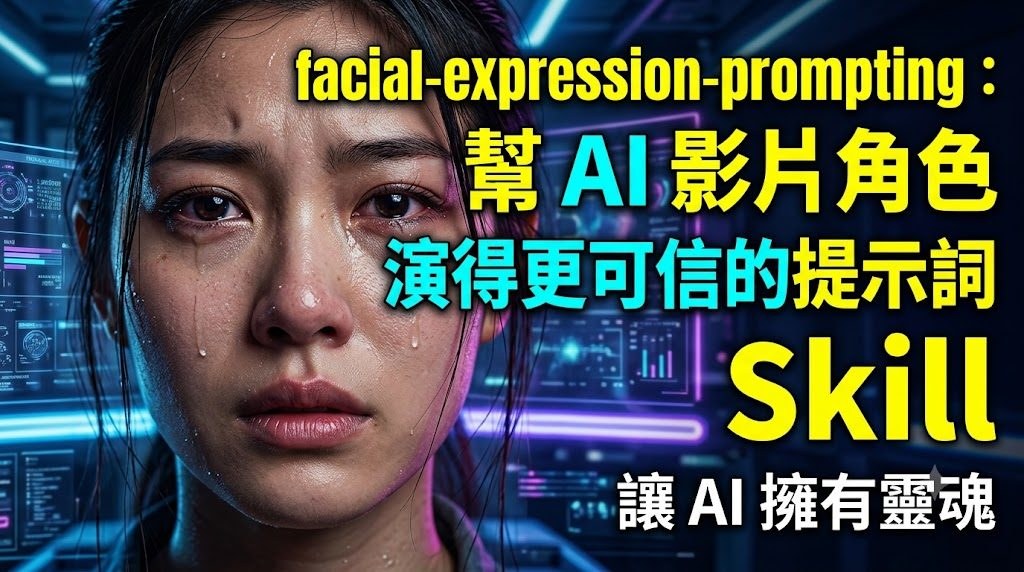
Facial-Expression-Prompting:幫 AI 影片角色演得更可信的提示詞 Skill

想拍角色反應戲,但提示詞只寫到情緒名?這些 Skill 會把動機、微表情同鏡頭節拍補完整,令 AI 影片生成更似一場表演。

Repository image for zhouwei713/facial-expression-prompting

情緒寫得太粗,AI 影片角色往往只會交出一個「表情」,而唔係一段有起伏的反應。呢個 GitHub 項目定位好明確:它係一個為人物表演而設的提示詞 Skill,專門把模糊情緒拆成可拍、可生成、可放入文生視頻與圖生視頻模型的演出指令,處理的是角色點樣由看到事件、壓住反應,再慢慢洩露情緒。

最有用的地方不只是擴寫字數,而係先補足角色點解會有反應。它用五個問題建立因果鏈,再把眼神、眼瞼、眉間、嘴角、下顎、呼吸、姿態同聲音排成時間軸,連鏡頭、光線、時長同負面約束都一併整理。對 Seedance、Kling、Runway、Veo 呢類模型來講,呢種寫法比單一句「她很傷心」更容易生成連貫畫面。

同類做法常見是堆情緒形容詞,或者直接放大表情強度;呢個項目反而重視克制、遞進同角色自我控制,所以特別適合特寫、關係戲、對白反應同微表情場景。代價亦好清楚:它偏向劇情演出導向,唔係追求高速出稿的萬用提示詞模板,使用者最好本身知道角色處境,先能發揮得更準。

  • 支援完整視頻模式同表演片段模式,前者補全整段提示詞,後者可插入既有腳本
  • 適合 Seedance、Kling、Runway、Veo 等 AI 視頻模型
  • 重點唔在誇張表情,而在可見的情緒轉折、微表情同鏡頭配合
  • 會按表演節拍決定時長,而唔係固定把每段反應寫成同一秒數

這個 Repo 可理解成一個可直接複用的 Agent Skill/提示詞模板項目,而唔係獨立模型或推理服務。它較適合內容創作者、短片導演、角色動畫設計者,或者要反覆修改人物反應戲的團隊;當目標係令 AI 生成的角色「有心事」而不只是「有表情」,呢個項目的取向相當實用。

GitHub

Categories: 開源, Agentic, AI productions, Video, txt2img, 提示詞, Skill 技能

FunASR 工業級語音辨識:支援廣東話

想在本地架一個 OpenAI 相容嘅語音轉文字 API?ModelScope 嘅 FunASR 將 SenseVoice、Paraformer、Fun-ASR-Nano 等模型收喺同一個 Python 接口,仲支援 vLLM 加速同 MCP 接入 AI Agent。

Repository image for modelscope/FunASR

如果你做過語音相關項目,大概率遇過呢種情況:開源模型散落喺唔同倉庫、部署方式各異、要接入 Agent 仲要自己寫 WebSocket 中間層。FunASR 就係針對呢類工程痛點嘅工業級語音識別工具包,屬於開源框架,由阿里達摩院維護,提供統一 Python 接口,將 ASR、VAD、標點恢復、說話人分離、情感偵測同音訊事件辨識串成一條流水線。

旗艦模型 Fun-ASR-Nano 係基於 LLM 嘅解碼架構,覆蓋中、英、日三語以及中文方言群組;針對 31 種語言嘅場景可以用 Fun-ASR-MLT-Nano-2512;鍾意多語言又有 LLM 解碼能力嘅,亦有 Qwen3-ASR(52 種語言、0.6B/1.7B 參數)。如果想要更輕量、非自迴歸嘅選擇,Paraformer 同 SenseVoice 仍係穩陣起點,前者適合生產線串流,後者額外送情感同音訊事件標籤。

funasr-server 一行指令就可以拉起 OpenAI 相容嘅轉寫 API,本地聽返 localhost:8000,配合 vLLM 仲可以做到 2-3 倍 LLM 解碼加速同 tensor parallel 批次推理。Agent 整合係另一個重點:MCP Server 可以直接接入 Claude 或 Cursor,OpenAI API 接口又同 LangChain、Dify、AutoGen 無縫對齊。最近幾個版本(v1.3.18 至 v1.3.22)就專門執緊 SRT/字幕分段、長時 WebSocket 連線、verbose_json 回傳呢啲工程細節。

要留意嘅取捨係:Fun-ASR-Nano 需要 GPU;新環境第一次 import funasr 已唔再強行依賴 PyTorch,但用 AutoModel 仍然要先裝 torch。FunASR 比較適合需要私有語音 API、字幕生成、長會議轉寫、或想將語音能力塞入 Agent 工作流嘅團隊開發者。

重點摘要:

  • 統一 Python 接口整合 ASR、VAD、標點、說話人分離、情感偵測
  • Fun-ASR-Nano 旗艦模型支援 31 種語言及中文方言,Fun-ASR-MLT-Nano 覆蓋更廣
  • funasr-server 提供 OpenAI 相容 API,搭配 vLLM 可達 2-3 倍加速
  • 內建 MCP Server 支援 Claude/Cursor,亦可接入 LangChain、Dify、AutoGen
  • 近期版本持續優化字幕分段、WebSocket 長連線、verbose_json 回傳等工程細節

以下是其對粵語支持的詳細信息:

  • UniASR模型:這是一個專為粵語設計的語音識別模型,能夠處理簡體中文的粵語語音識別任務。
  • ITN模型:用於對粵語語音識別結果進行擬文本正則化後處理,以提高識別結果的準確性。
  • VAD模型:語音端點檢查模型,用於檢測長語音片段中有效語音的起止時間點,這對於粵語方言的語音識別同樣重要。
  • 訓練語料:為了提高模型的準確性和適用性,通常會使用大量的粵語語料進行訓練,以便模型能夠更好地理解和識別粵語中的特有詞彙和表達方式。
  • 離線功能:Funasr提供了離線語音識別模型,這意味著即使在沒有網絡連接的情況下,也能夠進行粵語語音識別。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, Qwen, NVIDIA, API, IDE, LangChain, Python, 語音, Dataset 數據集

Hermes Missing Control 用 Telegram 管理五人 AI 團隊

使用 Orchestrator 配四個常駐助手搬到 Telegram,再用只讀儀表板統一追蹤任務、對話和文件。這項草稿可理解成一個面向實戰的多 Agent 工作流搭建示例。

Og image

這個教程價格為 US$15, 它是一套多 Agent(multi-agent)工作流,核心是用一個 Orchestrator 牽頭,配合 Scout、Scribe、Reach 和 Dev 四個常駐助手,分工處理探索、記錄、外聯和開發。它解決的不是單一對話,而是多角色協作、訊息路由同埋狀態追蹤,令每個助手各守其位。

同一般把所有工作塞入同一個聊天頻道的方法相比,這套做法把每個助手分到獨立的 Telegram 頻道,再配合 Telegram bot 和 routing plugin 做轉發。好處是角色邊界更清晰,對話唔易混亂,亦方便之後把任務、日誌同檔案接入同一個 mission-control dashboard。

文章亦展示咗點樣將資料層做成只讀,並把 Overview、Agents、Tasks Board、Chat、Content Library 同 Schedule 等版面逐一接上 live data。對需要長時間跟進 AI 工作流的人會幾有用,尤其係想喺 VPS 上集中監控,又唔想直接改動底層資料的人。

  • 以 Orchestrator 統籌四個專職助手
  • 每個助手都有自己嘅 Telegram 頻道同工作邊界
  • 儀表板只讀,方便監察而唔會誤改資料
  • 支援任務板、聊天記錄、文件庫同排程追蹤
  • 內容亦包含部署、故障排查同可選擴充做法

整體嚟講,呢個項目示範咗點樣把多 Agent 協作變成可觀察、可路由、可回溯嘅系統。對想用 Telegram 做日常 AI 協作中樞嘅讀者,會比一般聊天式代理更貼近日常工作需要。

項目主頁

Categories: Agentic, 教學, 庫

Grok Build 開源後,編碼代理點樣運作一目了然

想知道 AI 編碼代理點樣讀上下文、調工具同改碼,Grok Build 而家可以直接睇原始碼。它更吸引的地方,是連本地推理流程都可自行接駁。

Og image

想追到 AI 編碼代理點樣一步步理解程式碼、決定用咩工具,再把結果送回終端,Grok Build 而家提供了一個相當直接的入口。這個由 SpaceXAI 公開的 coding agent 與 TUI,不只方便試用,還把整個運作骨架開源,重點是讓人真正查清楚代理在處理什麼、又可以改到什麼。

對開發者而言,價值不止在「可用」,而是在「可驗證」。你可以直接查看它怎樣組裝 context、解析模型回應、分派 tool calls,也可以理解它怎樣讀寫程式碼、搜尋內容與執行指令。做緊技能擴充、插件整合,或者研究 MCP servers、subagents 工作流的人,這份原始碼會比單靠文件更有參考價值。

  • 開源範圍涵蓋 agent loop、tools、terminal UI 與 extension system
  • 可研究 skills、plugins、hooks、MCP servers、subagents 的載入與呼叫方式
  • 支援 local-first 用法,可自行編譯並接上本地 inference
  • 主要透過 config.toml 控制整體執行流程

和常見只提供託管服務或有限介面的工具相比,Grok Build 把關鍵細節直接攤開。使用時不一定要綁定雲端環境,亦可以自己編譯、指向本地推理後端,令測試、除錯、客製化與安全審視都有更大空間;代價是你要自己處理部署與整合,門檻自然較高。

對需要打造自訂 coding agent、終端工作流,或研究代理工具調度方式的人來說,這次開源相當有參考價值。

項目主頁

Categories: 開源, Agentic, MCP, API, Vibe Coding, 編程, 安全, Skill 技能

VideoChat3 一個睇得耐又睇得準的影片模型

要同一個模型同時處理細微動作、長片理解同直播回應,一向好難。VideoChat3 把重點放在時序理解同效率,定位相當清晰。

VideoChat3 logo

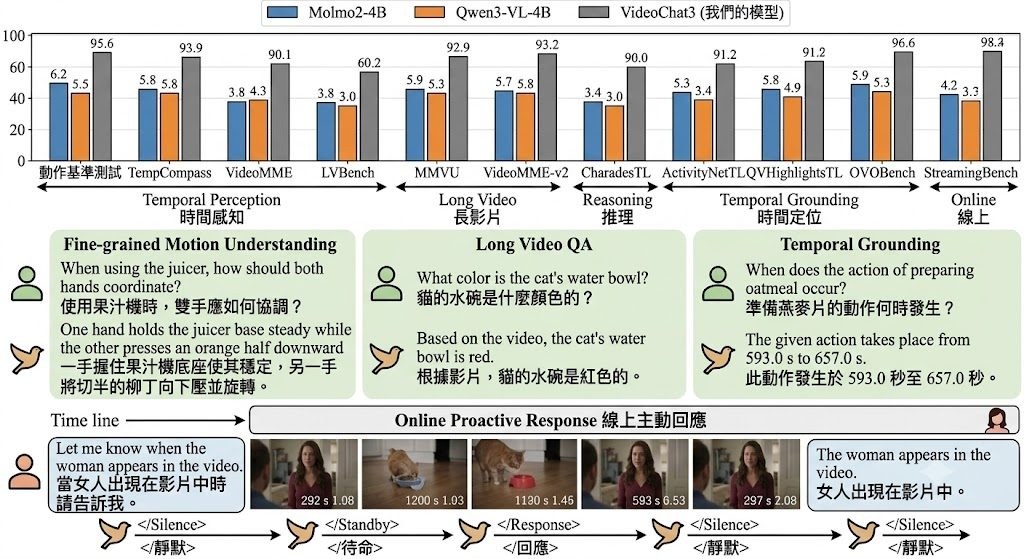
影片理解最麻煩的地方,往往唔係「識唔識睇」,而係要一邊保留動作細節,一邊捱得住長時間片段。VideoChat3 就係朝住呢個矛盾落手:它屬於多模態模型(Multimodal Large Language Model, MLLM),目標係用同一個 4B 模型處理細微動作、長片推理、temporal grounding 同 live streaming 回應。

同類項目好多時只會專注其中一段工作流,例如短片動作辨識,或者長片問答。VideoChat3 的取向係做 generalist video understanding,代價就唔係追求單一場景最極致的規格,而係用 I3D-ViT 同 Adaptive Frame Resolution 平衡 token 成本、時序證據同延遲,令模型唔需要全程用高成本方式讀完整段影片。

  • 重點唔只係睇單格畫面,而係保留跨時間的證據
  • I3D-ViT 提供 16× spatiotemporal compression,主打效率
  • Adaptive Frame Resolution 會按需要提高畫面解析度,較適合 streaming 場景
  • 已公開 model weights 同完整訓練數據,但 training code 仍未釋出

部署同測試的理解方式幾直接:現階段較接近研究釋出與模型體驗,適合先經 Hugging Face 取用 models & data,再按示範場景驗證長片問答、時間定位同串流回應表現。README 已列明完整訓練資料包括 Academic2M、LV116K、OL617K,對研究團隊、做 video agent、或者要建構影片檢索與監察流程的團隊最有參考價值。

公開資訊亦交代咗幾個關鍵數字:4B parameters、3M curated instruction samples、2,048 frames 下約 20.4s latency。呢啲數據未必代表所有環境都會有同樣效果,但至少講清楚它想證明的方向:唔靠超大模型,都可以把影片中的時間線索、事件關聯同即時反應放入同一套架構。相關模型與模組則以 VideoChat3、I3D-ViT、Adaptive Frame Resolution 為核心,整體更似一個面向研究與進階應用的開源影片理解項目。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, 模型, 視覺模型, 多模態模型, Video, 框架, 3D

Wan Streamer v0.3:讓 AI 學懂「世界不變,只有事件在流動」

Wan Streamer v0.3 把影片拆成「持續存在的世界」和「持續發生的事件」,讓即時音視頻對話支援自由動作描述,延遲仍維持約 200ms。你可以把它理解成:一個會記得場景、然後跟著時間線即興演下去的 AI 對手。

A robot navigates a suburban neighborhood and drives a car through a sequence of events

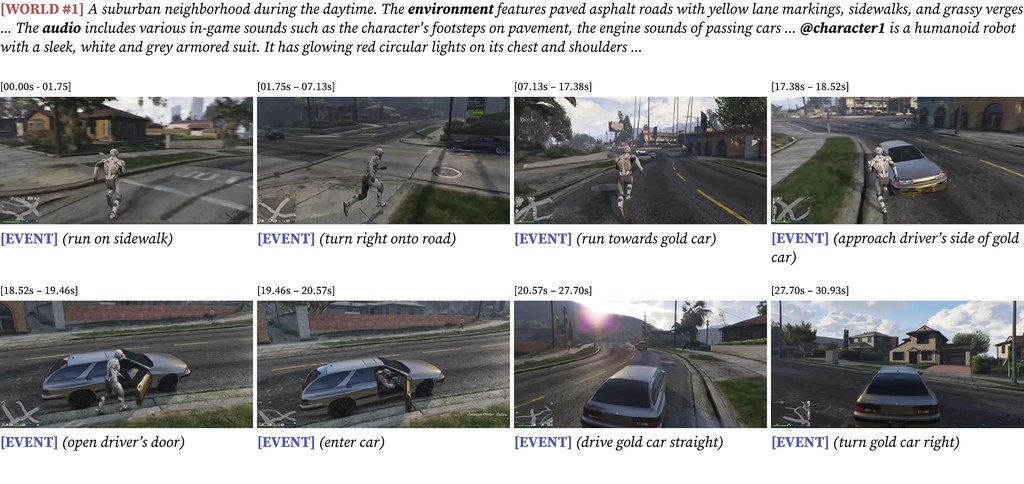
玩過 AI 影片對話工具的人都會發現一個矛盾:模型可以跟你聊天,但一旦想做動作,畫面就容易卡頓、失憶,甚至換了一張臉。Wan Streamer v0.3 想解決的就是這個問題——它把影片分成兩件事來學,一件是「世界設定」(場景、角色、畫風、聲音這些要長期保持一致的東西),另一件是「事件流」(說話、動作、鏡頭移動、環境變化這些隨時間發生的事)。

這個拆法聽起來抽象,但對使用者來說,最直接的差別就是角色終於可以做自然語言描述的動作了。你打開鏡頭,模型會一邊跟你說話,一邊伸手拿起眼前的物件、轉向聲音來源、或者露出驚訝的表情,而且動作和對嘴的時序是學出來的,不是後製對齊的。延遲仍然維持在約 200 毫秒,解析度 640×368、幀率 25fps,即時互動不會被打斷。

從工作流角度看,這個版本最大的價值是把普通影片變成訓練素材:先建立世界,再沿時間軸學接下來會發生什麼。同一套能力日後可以遷移到漫遊探索、機器人控制等場景,而這次發佈聚焦在即時音視頻對話。

重點摘要:

  • 拆解式學習:將「持續世界」與「事件流」分開建模,避免長對話中場景漂移
  • 自由動作描述:支援用自然語言寫出動作(如拿取物件、轉向、變換姿勢),並與對話同步渲染
  • 即時互動規格:640×368、25fps、約 200ms 模型側延遲,支援全雙工音視頻
  • 普通影片即訓練素材:不需特殊標註,現成影片就能用於學習時間軸上的因果事件
  • 可遷移架構:同一套預訓練能力可延伸至具身導航、漫遊等場景

對於做數位人、虛擬主播、互動敘事或即時陪聊的團隊,這個方向值得留意;對於只是想試試看的個人,現有 demo 已經足夠展示「角色真的在過日子,而不只是在回話」的差異。

項目主頁

Categories: 多模態模型, 世界模型, 模型訓練, Video, Audio, Robotic, 語音, Skill 技能

SearchOS:把搜尋變成像作業系統排程一樣的多代理協作

面對開放領域的複雜提問,多數 AI 搜尋都困在對話歷史裡打轉。SearchOS 把問題拆成一張覆蓋表,由多個子代理平行補齊每個空格,最後交出一份附引用的答案。

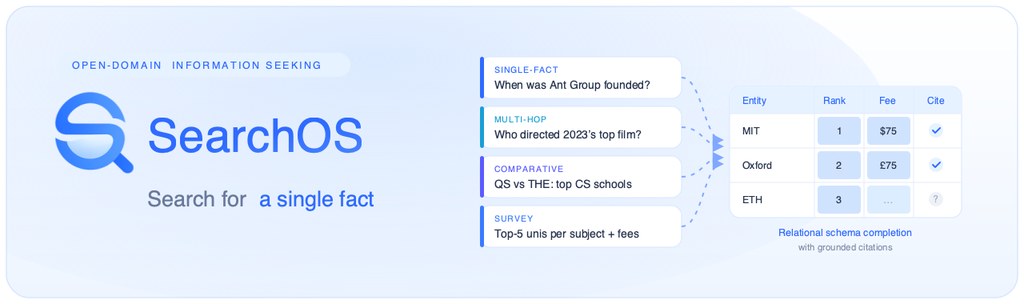
SearchOS — from single-fact lookups to full-domain research, unified as citation-grounded relational schema completion

開放領域搜尋最常見的瓶頸,不是模型不夠聰明,而是任務一複雜,搜尋狀態就會淹沒在對話紀錄裡,代理開始遺忘、繞圈、重複。SearchOS 嘗試解決的正是這個卡位:它把搜尋狀態從對話裡抽離,放進一個像檔案系統一樣的常駐層,由 Search-Oriented Context Management(SOCM)統一管理任務序列、證據圖和覆蓋表。

這個開源框架以 LangGraph 為骨幹,把提問先正規化成 entity × attribute 的覆蓋表,再把空格派給多個 pipeline-parallel 子代理去填。每格證據都帶著來源寫入共享的證據圖,最後由合成階段產出附引用的答案。整體端到端耗時接近最慢的那條單鏈,而不是各鏈相加。內建 sensor 機制會偵測五種迴圈或停滯,必要時重新派工。

Introduce SearchOS: Agentic Search Operating System

Skills 系統與 SF PROVIDER 讓它能處理反爬、登入牆,也能對接多家搜尋供應商。對做深度研究、競品盤點、盡職調查的團隊來說,這種「每個結論都追得到來源」的設計,比單純的長上下文檢索更貼近真正的工作場景。需要留意的是,覆蓋表驅動的設計在簡單事實查詢上略嫌重,平行代理也會增加 API 成本;但對於需要高召回、可審核的研究任務,差異是明顯的。

GitHub

Categories: 開源, Agentic, API, LangGraph, Skill 技能

Kimi K3 把開源大模型推到 3T 級別

想要一個同時處理寫碼、長文件同推理工作的模型,Kimi K3值得留意。它未追平最強閉源模型,但已把開源模型的上限再推高一截。

Kimi K3 hero visual

長上下文、程式開發同知識工作往往要分開交畀不同模型處理,Kimi K3嘗試把這幾件事收在同一個開放模型內。它屬於大型多模態模型,重點是處理長流程 coding、長篇資料閱讀與推理之間的切換成本,並提供原生 vision 能力與 1M context。

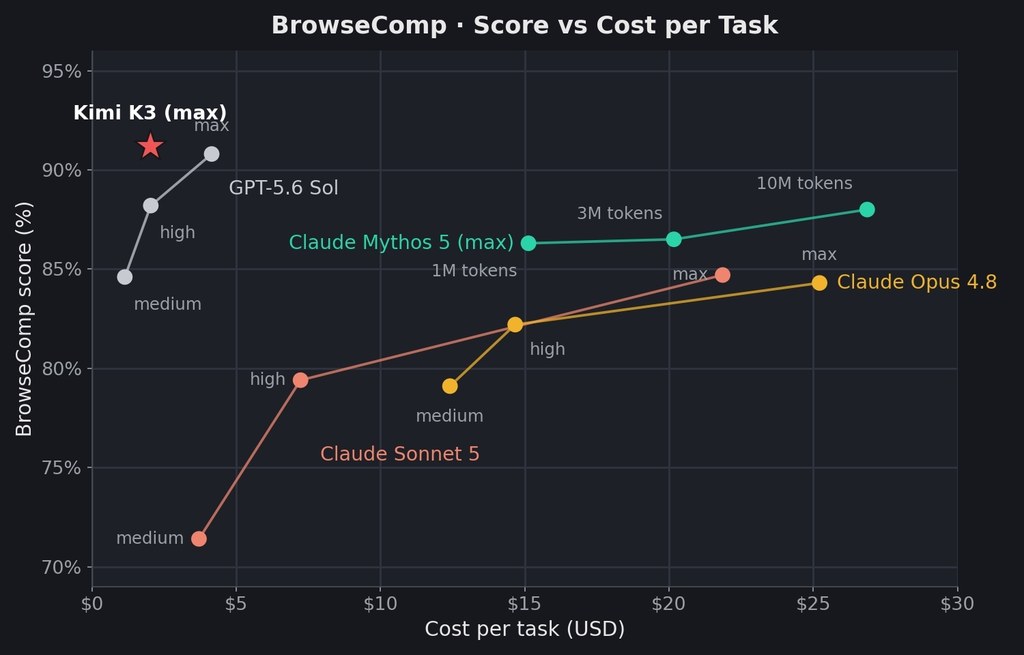
Kimi K3 的定位,不是單靠參數規模取勝,而是想在開源路線上逼近 frontier intelligence。資料提到它有 2.8T parameters,屬於首個 open 3T-class model,整體表現仍落後於 Claude Fable 5 和 GPT 5.6 Sol,但在自家 evaluation suite 內已持續超過其他被測模型,顯示它在開源陣營有明顯競爭力。

技術上,這個模型建基於 Kimi Delta Attention(KDA)同 Attention Residuals(AttnRes),目的是改善資訊在長序列與深層網絡中的流動方式;同時也擴大了 Mixture of Experts(MoE)sparsity。這種做法反映它要處理的核心矛盾:一邊維持超長 context 與多類任務能力,一邊控制推理與訓練效率。

  • 首個 open 3T-class model,規模達 2.8T parameters
  • 原生支援 vision,並提供 1M context window
  • 目標場景包括 long-horizon coding、knowledge work 同 reasoning
  • 採用 Kimi Delta Attention(KDA)、Attention Residuals(AttnRes)與 Mixture of Experts(MoE)
  • 已在 Kimi.com、Kimi Work、Kimi Code 同 Kimi API 提供使用

對開發者、研究者同需要長文檔工作流的人來說,Kimi K3最有吸引力的地方,在於它把「夠長、夠廣、夠開放」放在同一個項目裡。現階段可確認的限制也很清楚:它未到最強閉源模型的水平,而完整權重、架構與訓練細節仍要等後續 technical report 與正式釋出。

項目主頁

Categories: 開源, Agentic, 多模態模型, API, Vibe Coding, 教學, 線上服務, IDE, Mac, 編程, OpenClaw

awesome-Self-Improving-Agents:拆解自我改進 Agent 地圖

想追蹤 self-improving agents 點樣由概念走到方法,呢個整理庫比單看論文更省時間。它把分散做法收成一張可導航地圖,方便快速判斷研究路線。

Main figure of the survey

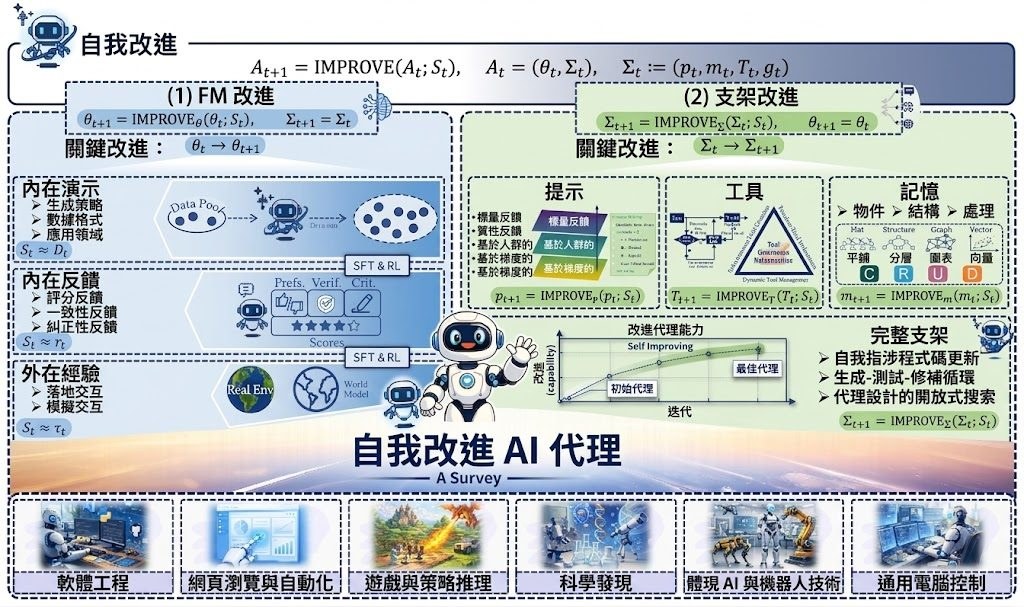
當大家都在談 Agent 會否愈跑愈聰明,真正麻煩的往往不是資料太少,而是做法太散、名詞太多、更新位置又不一樣。awesome-Self-Improving-Agents 把這件事整理成一個論文地圖型資源庫,核心不是教你直接部署系統,而是幫你分清楚 self-improving agentic systems 究竟在改進模型本身,還是在改進 prompt、memory、tools 與 control logic 這些外圍 scaffolds。

現有討論常把各類自我改進方法混在一起看,作者則用一條很實際的分界重組內容:一邊是 Foundation Model Improvement,另一邊是 Scaffolding Improvement。這個切法的好處,是你很快知道某篇工作追求的是更持久但較重的參數更新,還是較快、較平、亦較容易回退的代理層更新,閱讀時不會把 LoRA、工具路由、記憶結構調整當成同一類問題。

它不是可即裝即跑的軟件工具,更像研究與產品規劃都用得著的索引庫。你可以直接從 GitHub README、survey hub 同 arXiv 論文交叉閱讀;要測試這個項目的價值,最直接的方法是按 taxonomy 揀一條路,例如 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback,或者 memory、tool refinement、full scaffolding,看看它能否幫你更快找到代表性工作與相近分支。

  • 把 self-improvement 分成 Foundation Model Improvement 與 Scaffolding Improvement 兩大路線
  • 收錄 239 篇 papers,當中 73 篇屬 FM improvement,166 篇屬 scaffolding improvement
  • 細分到 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback、dynamic tool routing、autonomous tool creation 等機制
  • 適合研究員、Agent 產品團隊、技術寫作者整理文獻脈絡與比較方法取向

相關模型與系統脈絡圍繞 Foundation-Model-Based Agents 展開,但這個項目本身不提供單一模型權重或 benchmark 分數,也不是 OSWorld 那類直接跑任務的評測框架。它的價值在於建立閱讀順序與判斷框架;想找可落地的 agent 改進方向,這份 curated map 比單篇 survey 更接近工作清單。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 模型, 多模態模型, Meta, Dataset 數據集

Page 18 of 35
1 … 16 17 18 19 20 … 35