PalmClaw 把手機變成可落地 AI 助理

PalmClaw唔係把桌面代理硬搬上手機,而係直接把 Android 當成代理運行環境。想要私隱、速度同部署簡化兼顧,呢個方向幾有意思。

PalmClaw Line Logo (light mode)

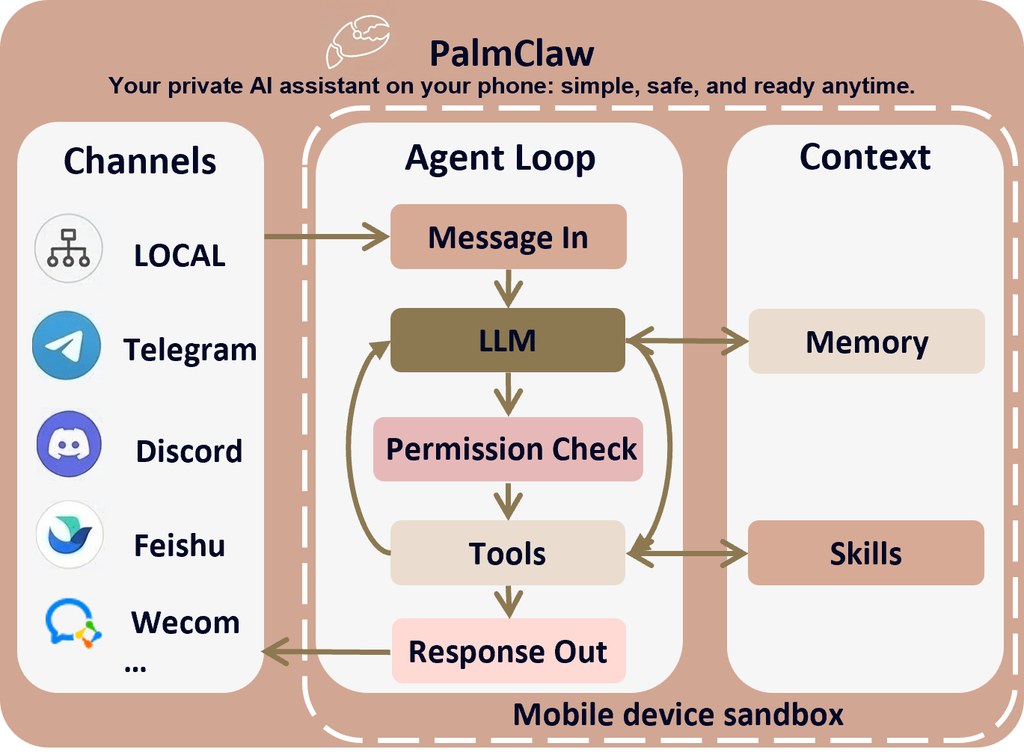
想在手機上跑 AI 助理,最大問題通常唔係模型夠唔夠聰明,而係行動流程太依賴點擊介面、太多步,又難清楚限制每次操作。PalmClaw 選擇唔跟 GUI 自動化嗰條路走,而係做成一個原生 Android 代理框架,直接在裝置內管理 session、memory、skills、tools 同 agent loop,處理的是「手機可唔可以自己成為代理執行環境」呢個問題。

同類做法很多會把手機當成一個要被點擊、滑動、輸入的目標畫面,PalmClaw則把裝置能力包裝成有明確參數同結構化結果的 device tools。呢個取向的好處很直接:動作邊界更清楚,執行鏈更短,亦較少受介面改版影響;代價是它偏向整合系統能力與通道,而唔係模擬人手操作所有 App 畫面。

安裝理解上亦算直接,項目已提供 APK,重點不是先搭 server,而是把代理本身部署到 Android。應用程式內可管理設定、工具同 channels,並連接 Telegram、Discord、Slack、Feishu、Email、WeCom 等通道;資料與硬件存取留在本機,較適合在意私隱、想減少雲端依賴的個人用戶,或者要做流動工作流驗證的小團隊。

  • 原生 Android 代理框架,重點在裝置內執行而非遙控手機介面
  • 沿用 OpenClaw 啟發,但定位更貼近直接 mobile deployment
  • 提供 APK,可在手機內完成設定、工具管理與通道連接
  • 論文數據提到,相比最強基線有 11.5% 相對任務成功率提升,完成時間減少 94.9%
  • 相關脈絡包括 OpenClaw,以及以 Large Language Model(LLM)agent 為核心的 session、memory、skills、tools 架構

PalmClaw最值得留意的地方,在於它把手機代理由「會操作畫面」改成「直接調用裝置能力」。對想把 AI 助理放進日常通訊與個人裝置流程的人來說,這種 local-first、明確工具邊界的設計,比純粹追求花巧自動化更接近可長期使用的方向;現階段平台重心明確落在 Android,跨平台與生態覆蓋仍要看後續發展。
項目主頁 · GitHub · Paper

Categories: 開源, 香港理工大學, Agentic, Gemini, 香港, Discord, OpenClaw, Anthropic, Skill 技能

EgoMemo 讓助手懂得幾時先開口

唔少助手識回應,真正難的是判斷應否打擾你。EgoMemo把連續第一身影片整理成可檢索記憶,嘗試把主動提醒變成可評測的能力。

Repository image for SitongGong/EgoMemo

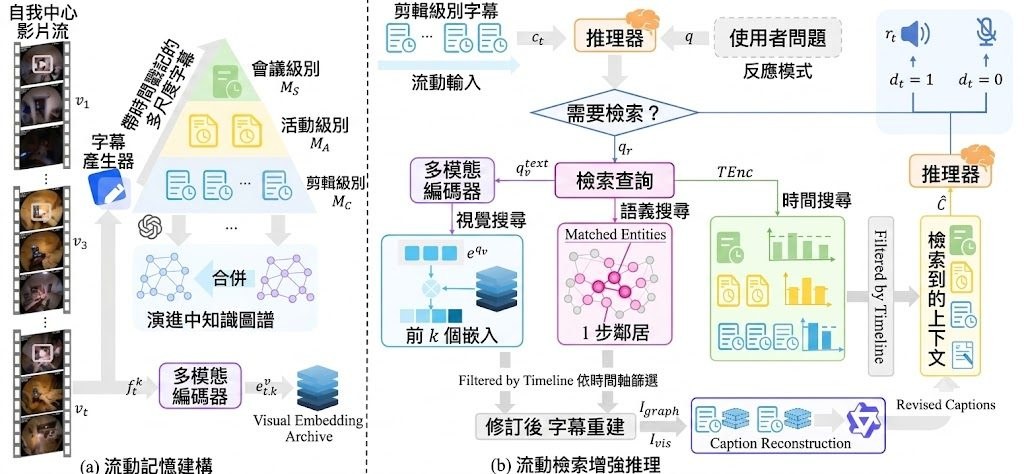
助手最難處理的,不是看見了甚麼,而是判斷幾時該出聲、幾時應該保持安靜。EgoMemo對準的正是這個空位:它屬於一個面向連續第一身影片的記憶增強代理系統,同時附上 benchmark,目標是讓系統根據累積情境主動提供服務,而不只是等人發問或對每個事件都作反應。

現有做法多數落在兩個範式:reactive,只會被問到先答;semi-proactive,偵測到預先定義事件就回應。作者認為這兩類方法都欠缺對使用者歷史、當前活動與介入時機的判斷,所以用 EgoServe 重新定義問題,把主動協助視為 context-dependent decision problem,再由 EgoMemo用 three-level temporal memory graph、semantic knowledge graph 同 visual embedding archives 做 retrieval-augmented reasoning。

這個 GitHub 項目不止放出模型思路,亦包含 memory-graph construction + retrieval pipeline、evaluation suite、dataset annotation 與 streaming demo。理解部署方式並不複雜:先準備 Python 3.10 環境與 .env 內的 API keys、資料路徑,再下載 EgoServe 註釋及對應來源影片,之後按不同資料集分開執行 processing 與 retrieval 兩階段,前者建立記憶圖,後者生成 proactive-service response。

  • EgoServe 收錄超過 3,000 個 service instances,橫跨 4 個 temporal memory horizons 與 10 類服務
  • EgoMemo 採用 training-free 設計,重點放在記憶組織與檢索,而不是再訓練一個大模型
  • 項目同時支援 EgoLife、HoloAssist、CaptainCook4D、EyeWo / ESTP-Bench、OVO-Bench 等資料來源
  • retrieval 可切換 caption retrieval、visual retrieval 等設定,方便做 ablation

EgoMemo 不是追求單次問答表現,而是補上長時間情境累積後的判斷能力。受益最大的是做 egocentric AI、智能助理、穿戴式裝置或多模態 Agentic 項目的研究團隊;限制也同樣直接,整個流程依賴外部影片資料、API keys 與多階段處理,重點更接近研究基線與評測框架,而未算一個即裝即用的消費級產品。相關模型與組件方面,儲存庫示例已出現 QwenVL 3 8B Instruct、GPT-5、Gemini 等作為 caption 或 response 端選項。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Embedding, 多模態模型, 模型訓練, OpenAI, Gemini, API, KnowledgeGraph, Python, Dataset 數據集

GigaWorld-Policy-0.5 推向機械人即時反應

機械人要邊看邊動,卡位往往不在「會不會做」,而在「能不能夠即時做」。GigaWorld-Policy-0.5嘗試用更輕量的推理路徑,保留世界模型訓練收益,同時壓低本地延遲。

機械人控制最難受的地方,常常不是動作生成本身,而是模型一邊理解畫面、一邊預測未來場景時,推理成本高到難以閉環運作。GigaWorld-Policy-0.5屬於 World Action Model(WAM),重點是保留未來視覺動態對訓練的幫助,但在執行階段只解碼動作,減少為了生成未來影片而付出的額外開銷。

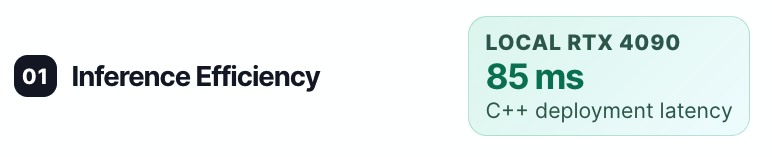
它延續 action-centered 的路線,再加入 Mixture-of-Transformers 架構,將視覺建模與動作生成分成不同 expert。咁樣做的取捨很清楚:訓練期間仍然利用未來場景演化強化動作學習,推理時則走較輕的 action-only pathway,提升即時控制效率。資料提到,它在本地 RTX 4090 上可做到 85ms inference latency,目標就是支援更接近即時的部署。

另一個值得留意的位置,是它不只改模型結構,亦加入 agent-based AutoResearch pipeline 來搜尋訓練配置。這種做法主要是減少手動調 hyperparameter 的時間,讓實驗設定更有系統地被篩選。對做 Robotic、世界模型或策略學習的人來說,這比單純追求更高指標更實用,因為整個訓練流程的效率同樣影響迭代速度。

  • 保留 future visual dynamics 的訓練收益,但推理時只輸出動作
  • 用 Mixture-of-Transformers 分開 visual expert 與 action expert,降低活躍計算量
  • 以 mixed Action-Conditioned World Modeling(AC-WM)和 WAM 訓練,加強視覺與動作的耦合
  • 引入 agent-based AutoResearch pipeline,提升訓練配置搜尋效率
  • 已公開論文、程式碼與模型,方便研究用途跟進

整體來看,GigaWorld-Policy-0.5處理的是世界模型常見的速度與控制落地矛盾:訓練想要看得多、學得深,部署又要夠快。現有資料顯示,它把重心放在更有效率的 action-centered WAM 路線,適合關注即時機械人控制、閉環部署與本地推理表現的人。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, Video, Robotic, 框架, 編程

用行為地圖看懂 Agent Harness

想查清代理會唔會刪檔前先確認,最難唔係搵唔到碼,而係搵唔齊完整行為鏈。Harness Handbook 把分散實作整理成可追溯的行為地圖。

Hero image preview

想理解 coding agent 點樣真正執行、點樣做安全檢查,或者想改成自己團隊用得上的流程,卡位通常唔在於缺少文件,而在於行為分散喺大量程式碼之中。Harness Handbook 就是針對 agent harness 的整理方法,把「某個行為點樣發生」變成可導航、可核對、可修改的路徑。

它處理的是行為同實作之間斷開的問題。像「刪除檔案前會否先詢問」這類問題,往往涉及多個 implementation sites,不是搜 delete、permission、confirm 就能直接還原全貌。Harness Handbook 以 behavior-level manual 方式重組這些零散位置,讓人可以由問題出發,一步步找到對應的 behavior units、相關程式碼證據,以及可能受影響的修改位置。

  • 把分散程式碼整理成可閱讀的 behavior map
  • 每個行為步驟都連到可驗證的 code evidence
  • 支援理解、審核與修改共用同一套入口
  • 著重 human in the loop,方便持續檢查系統變化

這種做法同一般 code index 或關鍵字搜尋的差異,在於它不是單純列出檔案,而是直接對應「系統會點做」。對開發者、維護大型 agent 項目的人,或者要審視安全邏輯的團隊,都會比較實用;連 coding agents 也可借這份 Handbook 更準確找到相關程式碼。

資料顯示,項目還提供 Handbook Studio,將這套 behavior map 變成可操作的入口。現階段重點不在推出另一個模型,而是為複雜 agent harness 建立一層可解釋、可審核的結構,令系統隨版本演進時,仍然保留清晰的行為脈絡。

項目主頁

Categories: 開源, 騰訊, Agentic, 框架, Vibe Coding, 編程

KnowAct-GUIClaw 跨平台 GUI 代理

想讓代理真正代你點按、輸入同切 App,難處從來不只係識畫面。KnowAct-GUIClaw把記憶、路由同技能接埋,重點放喺長流程任務穩定完成。

GUIClaw

要代理跨桌面、Android、iOS 同 HarmonyOS 幫你做事,最易失手的位通常唔係單一步驟,而係多個 App 之間點樣接續執行。KnowAct-GUIClaw屬於 Agentic 自動化框架/工具,核心處理的是長流程 GUI automation:由理解意圖、揀路徑、執行操作,到把經驗寫回記憶與技能庫,令之後的任務唔使每次由零開始。

同類 GUI agent 常見做法,是把畫面理解同動作決策綁成單次 observe-reason-act 迴圈;作者認為這種固定範式一遇上跨 App、跨系統流程,就容易缺少任務分解、歷史經驗同可重用技能。KnowAct-GUIClaw改用 Know–Route–Act–Reflect,前面先整理證據與路由,後面再把軌跡蒸餾成 memory 同 skills,取向明顯偏向「愈用愈熟手」而唔係單次回答最聰明。

部署上有兩條路:一條是完整 host,配合 nanobot webui、gateway 同 agent 去跑;另一條是獨立 guiclaw 工具,讓其他 host、腳本或終端直接調用。GUI automation 會改變裝置狀態,驗證任務應先用 dry-run,同時用測試裝置或測試帳號,這點對企業內部流程、自動測試、數碼助理場景尤其重要。

  • 支援 desktop、Android、iOS、HarmonyOS,重點係跨平台一致流程
  • 以 memory store 同 skill store 補強長流程任務,而唔只靠即場推理
  • 在 MobileWorld benchmark 取得 64.1%,頁面稱超過多個 open agent frameworks 及部分 closed agents
  • 對不同底模有泛化效果:Kimi-2.6 提升 8.5%,Qwen3.5-35B-A3B 提升 16.2%

受惠最大的,會是要處理重複 GUI 流程的團隊,例如行動裝置測試、跨 App 任務編排、個人助理型代理開發。不過它的價值未必只在榜單,而係把 GUI agent 從「會操作畫面」推向「會累積經驗再操作畫面」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 工具, Dataset 數據集, Skill 技能

AMID 把醫學影像建模流程交畀代理協作

AMID唔係只幫你諗模型,而係想連驗證、提交物料同審計痕跡一併產出。你可以把它理解成面向醫學影像比賽與研究任務的自動化建模工作流。

AMID logo

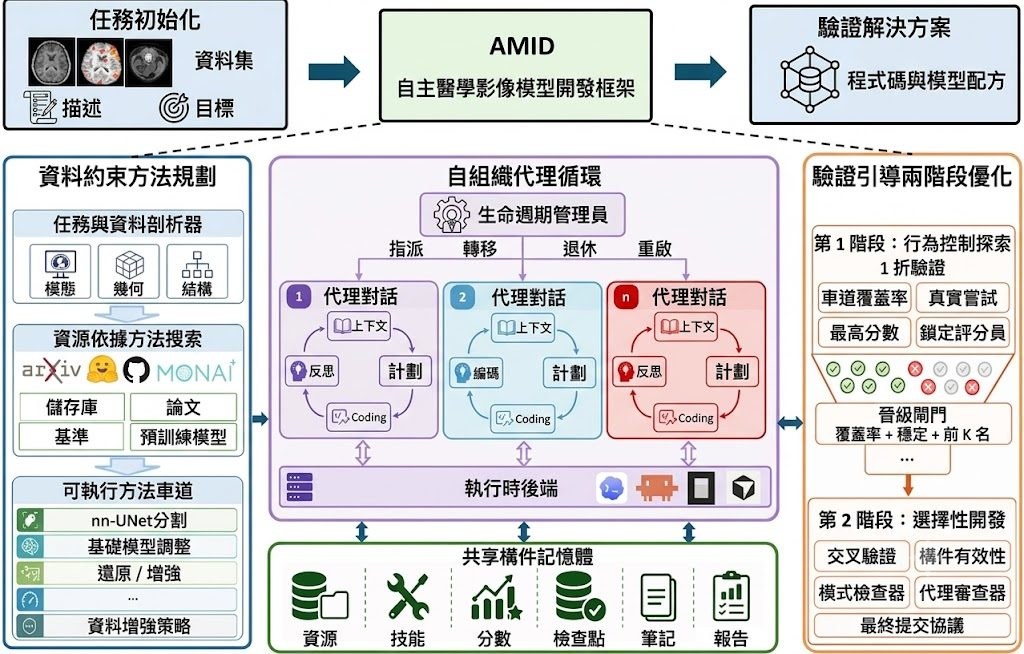
醫學影像建模最麻煩的位,往往唔係只係揀網絡,而係每個任務都有唔同資料形態、指標、切分規則同提交要求。AMID把呢個痛點拉到枱面:它屬於一個 autonomous multi-agent framework,目標唔係產生一段建議文字,而係交出可訓練、可推理、可驗證、可提交的完整模型產物。

現有通用 MLE agent 往往沿用比較粗略的搜尋與試錯範式,先提方案、再寫碼、再靠結果反覆修補;作者認為放到醫學影像場景,呢種做法容易忽略資料條件、驗證協議同提交格式。AMID改用 Data-Conditioned Method Planning,先按任務資料與可運行資源整理出可執行的 method lanes,再用 Verification-Guided Two-Stage Optimization 由早期廣泛探索,轉去後期集中追蹤有潛力路線,同時持續檢查 metric computation、validation protocol 同 prediction artifacts。

呢種取向的差異,在於它把「做得出分數」同「流程可核對」放埋一齊處理。對醫療 AI 團隊、挑戰賽參賽者,或者要同時管理 2D 影像、3D volumes、segmentation masks、class labels 等異質資料的人,AMID的吸引力在於減少人手串接流程的時間;代價是它目前仍以技術報告與任務解法報告為主,README亦寫明 source code 尚未釋出,暫時未到可以直接部署測試的階段。

效能方面,AMID用 ReX-MLE 的 20 個 medical imaging challenge tasks 做基準,比較對象包括一般用途 MLE systems,同時拿 human-designed challenge solutions 作參照。作者指出它整體表現優於被評測的通用系統,部分任務接近或追平人手設計方案;現階段較適合把它理解成一套清晰的方法論與工作流藍圖,而唔係即裝即跑的開源工具。

  • 核心定位係 autonomous multi-agent framework,處理醫學影像模型開發與驗證交付
  • 主要方法包括 Data-Conditioned Method Planning 同 Verification-Guided Two-Stage Optimization
  • 輸出唔止模型建議,仲包括 training code、inference code、weights、prediction files 同 audit trail
  • 基準測試來自 ReX-MLE 的 20 個任務,整體表現優於通用 MLE systems
  • 目前已公開 technical report 同 20 份 solution reports,source code 尚未發布

相關模型與系統脈絡方面,AMID直接對比的是 general-purpose MLE systems,同時以 human-designed challenge solutions 作為高水位參考。它未有把重點放在單一 backbone 或某個固定醫學影像模型,而是把多代理規劃、優化與驗證流程包成可重複的方法,呢點比單次調參工具更值得留意。

GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 多模態模型, 模型訓練, 微軟, Image, 影像處理, 框架, 香港, Medical醫學, 3D, Dataset 數據集

LightMem-Ego:AI 眼鏡及手機的日常記憶系統

LightMem-Ego 把第一身視角影像與聲音整理成可查詢記憶,適合理解 AI 眼鏡如何變成生活助理。

LightMem-Ego Logo

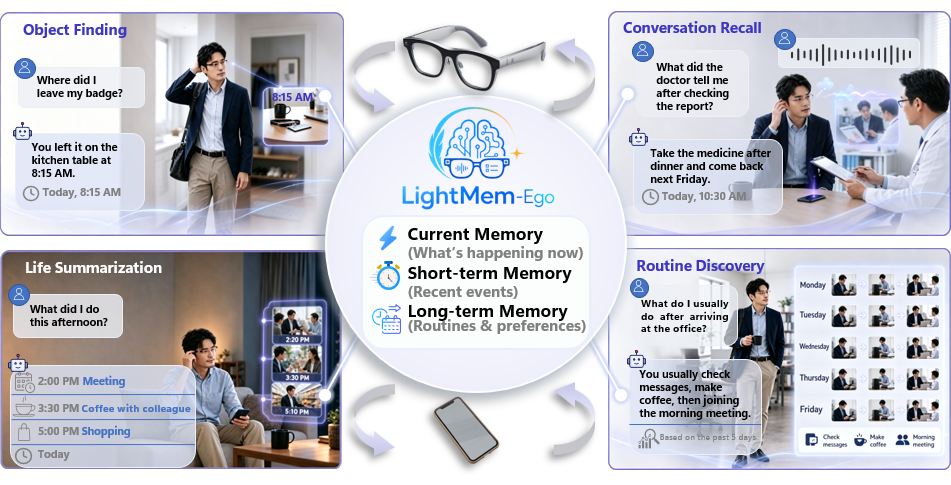
LightMem-Ego 由 Zhejiang University、South China University of Technology、Central China Normal University 與 Lenovo Group Limited 共同開發。它瞄準的是手機與 AI 眼鏡長時間接收影像、聲音後,怎樣把零散片段變成可追問的日常記憶,屬於端到端 streaming multimodal memory system。

現有多模態助理多數擅長回答當下畫面或單次對話,但要回想剛才誰講過甚麼、物件放在哪裏、一天內發生過甚麼,就需要把連續經驗累積、整理和檢索。LightMem-Ego 的做法是把第一身 visual-audio streams 對齊到同一條時間線,再分成 Current memory、Short-term memory 和 Long-term memory,查詢時按問題動態路由到合適記憶層,並用 timestamped multimodal evidence 支撐答案。

  • 工作流定位:連接 Rokid AI Glass Android app、browser frontend 和 online backend service。
  • 主要用途:object finding、conversation recall、life summarization、routine discovery 和 hands-free wearable assistance。
  • 核心取捨:不是只追求單次多模態理解,而是把輕量、持續累積和可檢索記憶放在中心。
  • 部署理解: Quick Start 與 glasses + web deployment,但提供資料未列出完整安裝指令或模型配置細節。

對可穿戴裝置開發者、個人助理產品團隊來說,這個項目的價值在於它把擷取、時間線對齊、記憶分層和問答串成一條較完整的流程。它也較適合需要測試「長時間生活脈絡」的場景,而不是只做單張圖片問答或短語音轉錄。

性能與評估資料在提供內容中仍然有限,未見具體 benchmark 數字可引用。相關模型資料只提到 multimodal large language models 的背景,包括 OpenAI 與 Gemini;未明確指定 LightMem-Ego 後端必須使用哪一個固定模型。

GitHub · Paper

Categories: 開源, Agentic, 多模態模型, OpenAI, Gemini, Audio, 框架, 語音, 中國, Dataset 數據集

ABot-World 把互動世界模型帶上桌面 GPU

ABot-World想解決的,不是再做一段更長影片,而是讓生成世界可以持續回應操作。你可以把它理解成一個開始接近可玩狀態的互動式世界模型示範。

ABot World 0

影片生成做到流暢並不罕見,但能一邊接收操作、一邊把世界延伸落去,門檻就高得多。ABot-World定位屬於模型加示範工具,核心處理的是 action-conditioned world rollout:用戶輸入動作之後,系統持續生成可探索的世界,而唔係播完就停的被動片段。

呢個項目的取向相當鮮明:它唔係先追求超高畫質,而是把「可互動、可持續、可在單張桌面顯示卡跑起來」放到前面。官方公開的數字是單張 NVIDIA RTX 5090 可在 720P、16 FPS、1.2 秒延遲、19GB GPU 記憶體下運行,配合 LongForcing training 減少 scene lock-in,令 rollout 期間可以擴展新場景同動態,唔使靠 prompt switching 硬接續。

測試方式算直接:項目已提供本地 gradio demo,同時有線上版 ABot World Studio;想自己部署,它在 Ubuntu 22.04、CUDA 13.3、NVIDIA RTX 5090 環境驗證過,並要先下載 ABot-World-0-5B-LF checkpoint。換句話說,現階段較適合把它理解成高階桌面 GPU 上的研究型互動系統,而唔係一般消費級硬件都能順手跑的輕量工具。

幾個重點值得留意:
– ABot-World-0-5B-LF 已公開,屬於 causal student model
– 互動重點在連續探索,不是固定長度 video generation
– 本地推理與線上 playground 都已提供,驗證路徑清楚
– Bidirectional Teacher Model 仍未釋出,生態暫時未算完整

適合研究 world model、interactive video generation、Agentic 模擬環境,或者想為遊戲原型與具身智能測試場景找參考的團隊。現階段的吸引力在於它把「無限 rollout」和「單桌面 GPU 即時推理」放到同一個項目內。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視頻模型, 世界模型, 模型訓練, Google, NVIDIA, Video, Linux, 蘋果

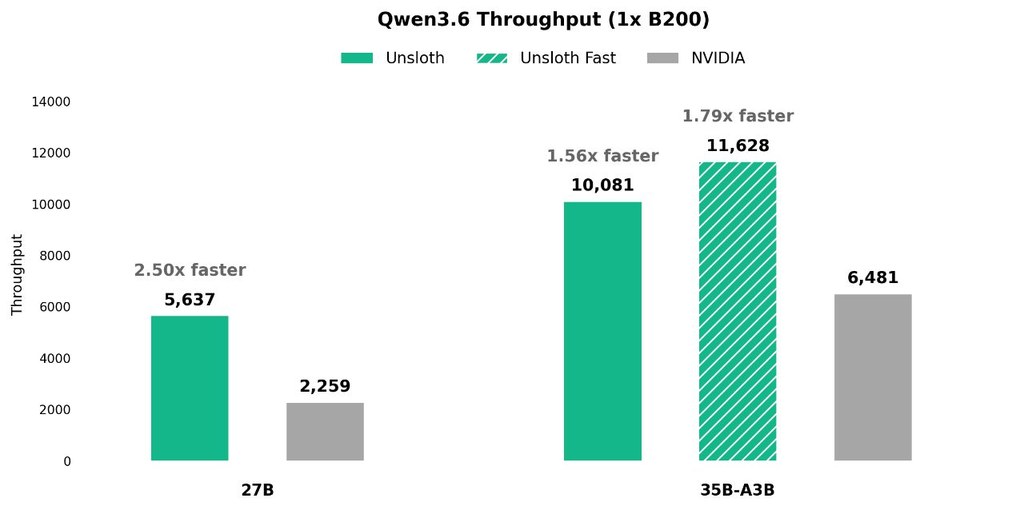
Qwen3.6 全新的動態 NVFP4 量化器

運行速度比其他 NVFP4 量化器快約 2.5 倍,效能更佳,檔案大小也相近。在24GB 記憶體上,Qwen3.6-27B NVFP4 的運行速度提升 2.5 倍;在32GB 顯存上,Qwen3.6-35B-A3B 的運行速度提升 1.7 倍。

Og image

想喺自己電腦上跑到規模較大的多模態模型,最大卡位通常唔係功能,而係記憶體同速度。Qwen3.6 屬於阿里巴巴的新一代多模態 hybrid-thinking 模型系列,重點在於用相對可控的硬件需求,處理 agentic coding、vision 同 chat 等工作。

現有資料提到兩個主力型號:Qwen3.6-27B 同 35B-A3B。前者可在約 18GB 記憶體配置下運行,後者約需 22GB 至 23GB 左右,並支援 256K context 及 201 種語言。對想喺本地做長內容理解、跨語言對話,或者配合工具調用工作流的人來說,這個取向幾實用。

相比只講「可量化、可本地跑」的常見做法,Unsloth 這邊更著重點樣揀到速度與準確度較平衡的版本。Qwen3.6 GGUFs 採用 Unsloth Dynamic 2.0,會按真實使用資料做 calibration,並把重要 layers upcast;另外新推出的 NVFP4 quants 主打在 GPU 上帶來約 2.5 倍更快速度,MTP 則標示可把 inference 再加快 1.4 至 2.2 倍,同時不犧牲準確度。

  • 適合本地部署多模態模型,兼顧編碼、視覺與對話
  • 27B、35B-A3B 記憶體需求相對克制,較易在個人設備起步
  • GGUF 格式配合 Unsloth Dynamic 2.0,重點是量化後仍保持可用表現
  • NVFP4 與 MTP 主要改善推理速度,幫助減少等待時間

使用上仍有幾點要留意:總可用記憶體最好高於下載的量化模型大小,否則雖然可經 llama.cpp 用 SSD/HDD offloading 繼續運行,但推理會慢得多;文件亦明確提醒不要使用 CUDA 13.2,以免輸出異常。整體來看,這不是單純把 Qwen3.6 搬到本地,而是把「跑得動、跑得快、精度仍可接受」這幾個取捨整理得更清楚。

所引用的模型列表:Qwen3.6-27B、Qwen3.6-35B-A3B。

項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, MCP, 模型, 多模態模型, Qwen, NVIDIA, API, 教學, Medical醫學, Python, 編程, OpenClaw, Anthropic

UniClawBench 點樣測主動式代理

要比較主動式 AI agents,單看單輪答題已經唔夠。UniClawBench把工具操作、瀏覽器、檔案同 GUI 流程放入同一個閉環評測。

UniClawBench

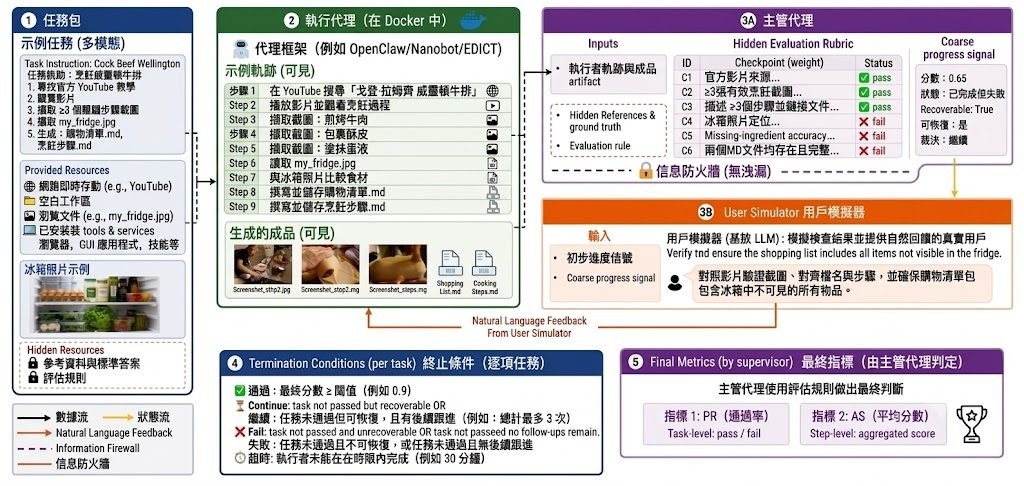
比起只問模型識唔識答,UniClawBench更在意代理能否一路做、一路修正,直到完成整個工作流。它屬於benchmark 項目,針對 proactive AI agents 在真實工具、瀏覽器、檔案處理與桌面 GUI 任務中的完成能力,補足傳統單步評測難以反映連續操作表現的缺口。

現有做法常把 agent evaluation 壓縮成靜態問答、固定軌跡重播,或者只看最後答案;作者明確改用 three-role closed-loop evaluation framework,將 executor、hidden answer supervisor 同 public user simulator 分開。呢個設計的重點,是同時檢查代理點樣行動、途中有冇偏離、收到回饋後能否繼續修正,而唔係只計一次輸出啱唔啱。

公開版本提供 400 個雙語任務,英文與中文各 200 個,覆蓋 Skill Usage、Exploration、Long Context、Multimodal、Cross Platform 五類能力。部署思路亦算清晰:倉庫已放入 packaged task resources、Docker-based runtimes、distributed dispatch scripts,同埋可檢視 leaderboard、trace、artifacts 與 timeline 的 WebUI;要跑測試,核心其實是先填好 executor、Codex provider 同 API keys 相關設定檔,再用它的執行環境批次評估。

  • 用 three-role 閉環評測取代一次性答題
  • 任務同時涉及 browser、files、GUI apps 與其他工具
  • 400 個雙語任務,較易檢查跨語言穩定性
  • WebUI 可回看 traces、artifacts 同示範流程

從補充資料看,作者想指出的取向幾鮮明:framework choice 對能力表現的影響,往往比 model choice 更大,而 long-context 與 multimodal 仍是主要瓶頸。相關模型與組合亦有列出,例如 GPT-5.4、Claude Opus-4.8、Kimi-2.6,並配合 OpenClaw、EDICT、Nanobot 等框架比較;對研究 agent system、企業內部自動化流程,或者想建立較完整評測流水線的團隊,這個項目的參考價值高過單純看排行榜。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, Agentic, 多模態模型, OpenAI, API, 框架, OpenClaw, Anthropic, Dataset 數據集, Skill 技能

Page 19 of 35
1 … 17 18 19 20 21 … 35