OmegaUse-OfficeVal 量度 Office 代理能力

想比較 LLM agents 做 Office 工作交付得好唔好,單靠主觀打分唔夠。OmegaUse-OfficeVal 用可執行驗證器同經濟訊號,將評測流程整理成可重跑的框架。

OmegaUse-OfficeVal benchmark framework

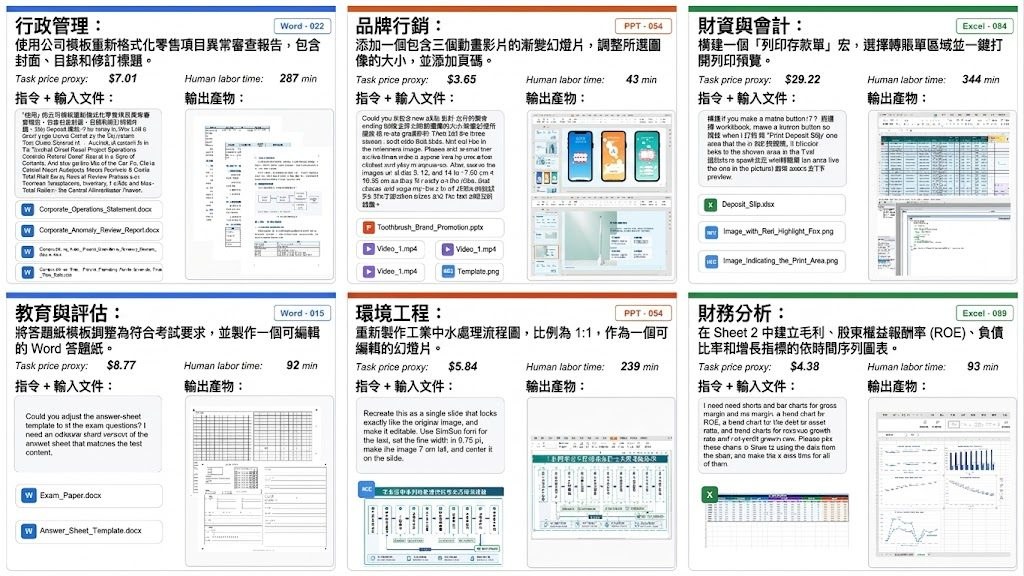
做 Office-suite 長流程任務,最難唔係叫模型產生文件,而係點樣穩定判斷交付物到底合格未。OmegaUse-OfficeVal 把這件事做成一個 Python 框架,同時連接 benchmark 思路與驗證流程:它收 ZIP 提交、先做安全檢查,再逐個執行 100 個 Office document evaluators,最後輸出 JSON 同 CSV 報告,適合用來評測 LLM agents 在 Office 任務中的完成度。

呢個項目的取向幾鮮明:重點唔放喺即場互動,而係放喺可重複、可審核、可批量執行的驗證。網站資料亦交代,OmegaUse-OfficeVal 對應的是一組有經濟 grounding 的長時程 Office-suite tasks,100 個任務平均要 2.32 小時人手完成,並附有人力時間與 task price proxy,方便把模型推理成本同人類成本放埋一齊看。相比只做最終分數排行,這種設計更接近團隊挑選 agent、比較交付價值時會遇到的問題。

它不是把資料集、提交內容同工作目錄全部包在倉庫內,而是把評測框架與 verifier source code 分開提供,benchmark data 另外發佈。Python 3.10 以上可跑,Windows、macOS、Linux 都支援 normal mode;其中 91 個 verifiers 可跨平台執行,另有 9 個 verifiers 依賴 Windows 上的 Office COM,相關環境未齊時會被跳過或只限指定平台處理。

  • 以 evaluate(directory: str) -> dict 統一 100 個驗證器介面,方便批量評測與整合
  • 收件前先檢查 ZIP traversal、加密、大小、檔案數量與壓縮比,安全性考慮算完整
  • 每個 verifier 在隔離 subprocess 執行,可設定 concurrency 同 timeout,減少互相干擾
  • 輸出採用 machine-readable JSON、CSV,而且每個 verifier 各有結果,後續分析較方便

這個倉庫裡主要體現在覆蓋範圍與流程穩定性,而唔係模型速度本身:可見進度、目前 verifier ID、執行 channel 同耗時,對跑大批提交會實用。它更像一個面向 Agentic 評測、研究復現同內部驗收的基建項目;想測 Office 類代理,尤其想把安全收件、隔離執行、可讀報告放進同一條流水線,這個項目的完成度相當高。
項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 框架, Mac, Linux, Python, Dataset 數據集, 百度

HumanCLAW 直指 VLM 身體感缺口

當 Vision-Language Models 真正要控制一個會碰撞、會受重力影響的人形身體,表現遠比畫面理解困難。HumanCLAW 把問題拆開來量度,直接揭開 VLM 行動判斷的弱點。

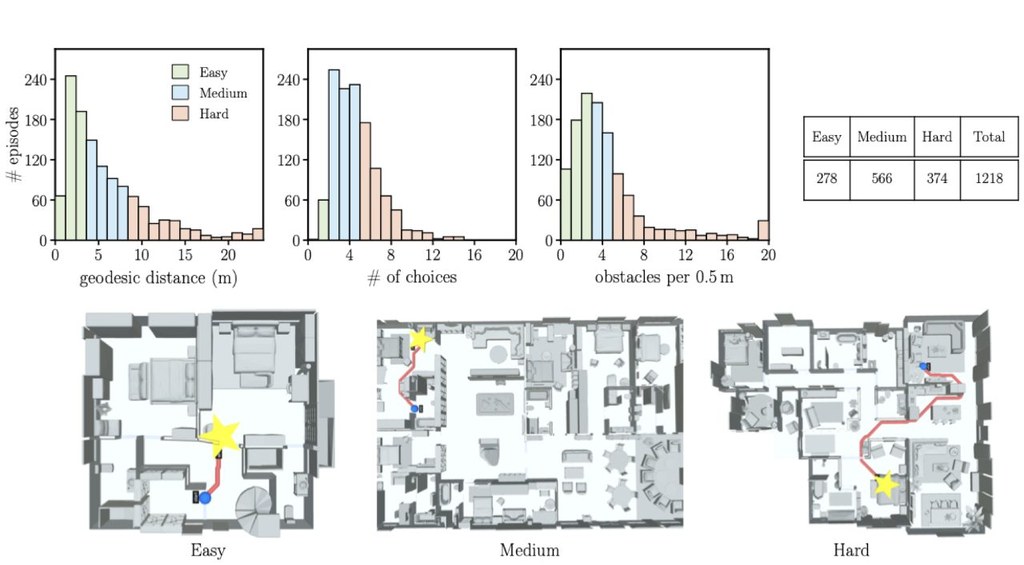
HumanCLAW teaser

畫面睇得明,不等於身體識得郁得啱。HumanCLAW 把 Vision-Language Models(VLMs)放進一個閉環人形行動測試環境,集中量度模型每個瞬間應該做哪個動作,而不是把失敗全數歸咎於低層馬達控制。它屬於評測框架兼基準測試項目,處理的是 VLM 在具身場景中的行動決策能力,到底有沒有足夠「身體感」去完成找路、移動與互動。

呢個設計最值得留意的地方,是它把 action decision-making 與 low-level motor execution 分開。每 0.5 秒,凍結的 VLM 只需要根據第一身視角、指令、技能列表與歷史內容,提出一個 atomic whole-body skill;後面的 verifier、motion generator 同 half-physics simulator 再負責驗證、安全過濾與連續動作執行,令接觸、碰撞、重力等物理後果仍然保留下來,但平衡失誤與動作追蹤誤差會被盡量排除。

HumanCLAW-Bench 則在這個框架之上提供 1,218 個長時程 find–navigate–interact episodes,覆蓋 41 個室內場景。數字相當直接:九個最先進 VLM 全部未能解決這套基準,最佳成績只有 16.8% success rate,反映問題不在單次辨識,而在模型持續追蹤自身位置、判斷是否到達目標,以及理解自己有沒有撞上環境。

  • 把高層決策同低層動作分離,較易睇清 VLM 真正弱點
  • 保留真實物理後果,唔會因為純符號化環境而高估能力
  • HumanCLAW-Bench 著重長時程、第一身視角、連續互動任務
  • 目前公開資訊顯示程式碼與 benchmark 仍在準備釋出

對研究 embodied AI、Computer-use agents 延伸方向、VLM 評測方法的人來說,呢個項目有參考價值,尤其適合用來檢查模型是否具備 closed-loop spatial action intelligence,而不只是識描述畫面。現階段較大的限制也很清楚:GitHub 儲存庫尚未正式放出 harness、motion generator weights、half-physics simulation environment 與完整評測內容,暫時主要仍是透過 project page、paper 同 leaderboard 理解方法與結果。

項目主頁 · GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, Meta, Dataset 數據集, Skill 技能

SkillRise 把技能文件變成可累積學習

同一個策略連續解幾類相關任務,邊做邊整理可轉移的技能文件,正是 SkillRise 想處理的學習斷層。它不是只追單次成功率,而是想讓經驗在下一題繼續生效。

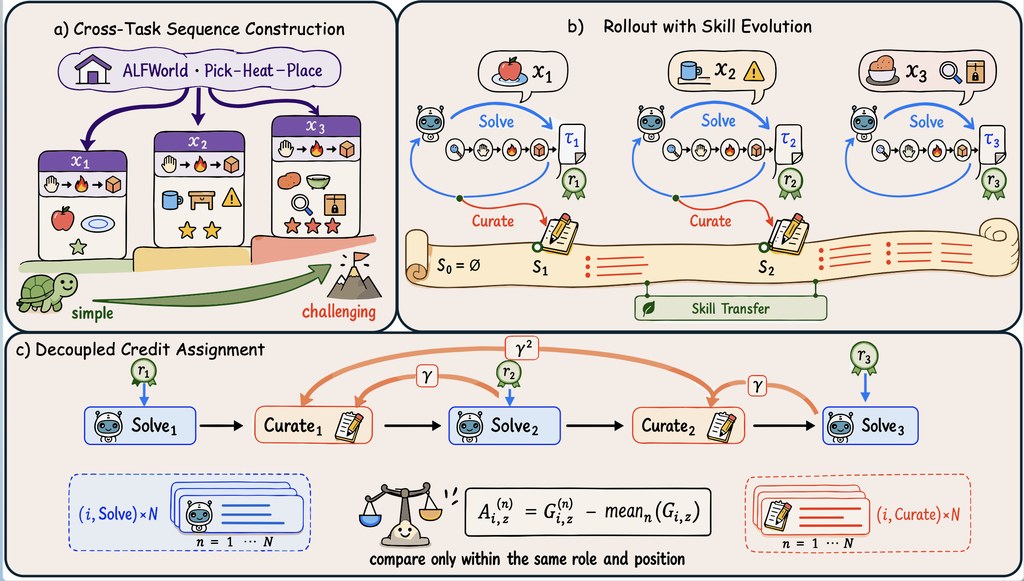
SkillRise method

做完一題就把經驗丟掉,往往是代理系統訓練最可惜的地方。SkillRise 屬於強化學習框架,焦點放在 cross-task skill learning:讓同一個 policy 按次序處理同一家族的任務,一邊解題,一邊把軌跡整理成會持續演化的 skill document,將前一題學到的做法帶去下一題。

它的取向不是把每個任務分開訓練到最好,而是刻意安排由淺入深的任務序列,讓 Solve 與 Curate 交替發生。這個設計針對的是跨任務遷移能力,而不是單一回合表現;代價是環境設定與資料組織較講究,ALFWorld、WebShop 要跟隨 verl-agent 的環境配置,ScienceWorld 則沿用 BEACON 的 setup,並且要先整理模型路徑、資料路徑與追蹤設定。

README 提供了可直接對照的執行方式:同一套 examples 結構下,既有 SkillRise,也有 GRPO baseline,方便把新方法與基線放在相近條件下比較。模型部分從腳本名稱可見已準備 Qwen3-4B 配置,底層也建立在 veRL、verl-agent、BEACON 等現成項目之上,所以它比較像研究與實驗工作流的延伸,而不是即裝即用的產品。

  • 把「解任務」與「整理技能」拆成兩個交替角色
  • 用同一家族、逐步變難的任務序列測試技能轉移
  • 在 ALFWorld、WebShop、ScienceWorld 都有評估
  • README 明確保留 GRPO baseline 方便做對照

成果描述指向一個清楚結論:SkillRise 在 ALFWorld、WebShop、ScienceWorld 的整體結果最好,勝過 prompting-based methods 與 RL baselines。較適合研究 Agentic workflow、長程技能累積、跨任務學習的團隊;想觀察 skill document 如何影響後續決策的人,也會比只看最終分數得到更多訊息。

GitHub

Categories: 開源, Agentic, Qwen, 提示詞, Skill 技能

CodeNib 把代碼庫上下文交到 Coding Agent 手上

CodeNib 讓 Coding Agent 直接取用帶引用的代碼庫上下文,減少翻找檔案和拼湊脈絡的時間。它把同一份倉庫整理成多個視圖,再按需要供應給工具和介面。

CodeNib

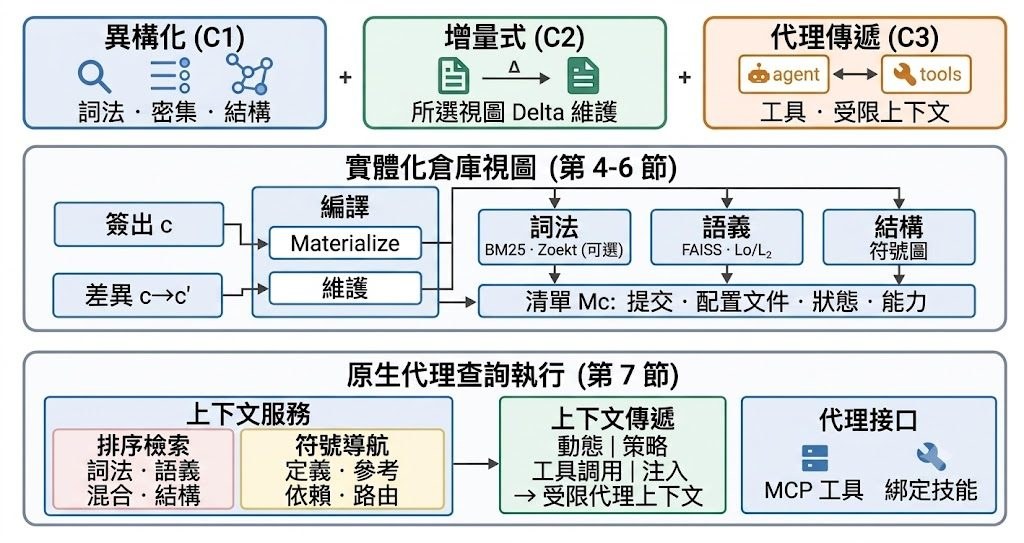
CodeNib 核心處理 Coding Agent 在大型項目裡最常卡住的問題:資料太散、脈絡太長、引用不清。它把倉庫編譯成 lexical、semantic、structural 同 static-navigation 多個視圖,再經 MCP、LSP-shaped providers、Python 或 HTTP API 交出去,讓工具直接拿到有來源位置的證據。

這個設計不只是做索引,而係重視增量更新同可追溯性。倉庫變動後,只會修補受影響的視圖;不適合保留的轉換才會重建。每個 view 都有獨立 manifest,記錄來源、狀態、能力同 artifact 位置,方便確認目前供緊咩上下文。

  • 主要解決 Coding Agent 讀懂倉庫時的上下文供應問題
  • 以 MCP 為核心接口,兼容 agent-native 工作流
  • Wiki、Ask view、Dependency Map 都係同一 runtime 的檢視層
  • 依賴 SCIP symbol resolution 生成 dependency map,唔靠模型猜測
  • 回答會附 file 同 line citation,方便核對

同類做法常見只係把檔案切片再丟入檢索,CodeNib 則把 lexical、dense、graph 同導航視圖放到同一個編譯流程裡。Docs 提到 live demo 支援 Python、C/C++、Go、Rust 同 TypeScript,亦展示咗一個針對 codebase 的實用取向,而唔係停留喺概念層面。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, API, Vibe Coding, Python, 編程

Octafuse Gateway:幫 Agent 管好多模型入口

Octafuse 團隊做的不只是轉發層,而係把模型、工具同配額管理收埋到同一個入口。對要同時接多個 AI 服務嘅團隊,呢種集中控制會直接省下不少營運工序。

Octafuse Gateway 运营概览

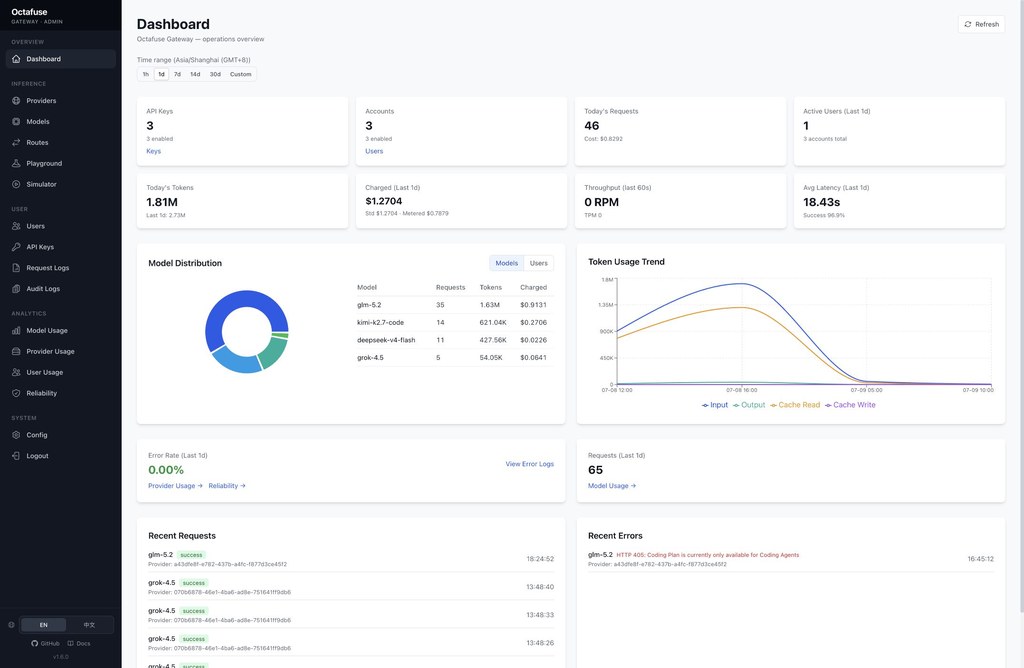
Octafuse 團隊把重點放在 Agent 工作流,而唔係只做一個轉發請求的薄層。Octafuse Gateway 屬於可自託管開源 AI gateway,處理的是多供應商模型、圖像、語音轉寫同 Agent Tools 分散管理的問題,特別適合已經有多組 API Key、不同模型來源,甚至自建服務要一齊協調的團隊。

它最有價值的地方,在於把「接得通」進一步做成「管得住」。同類項目常見重點是模型代理與相容 API,Octafuse Gateway 另外加強了路由、故障轉移、預算、審計、三賬本計費,同埋公開能力目錄,令 Agent 可以透過統一入口發現同調用資源,而管理者亦可以追蹤成本與用量。

部署方向,支援 Cloudflare Workers + D1,以及 Docker 配合 Postgres / MySQL 自託管;Node.js 20+ 亦是明確要求。原始資料未展示完整安裝步驟,但有 operator 文件、Admin 管理界面、Playground 同 Simulator,反映它不是只給開發者讀 API 文件,亦有一套管理與聯調介面可用。

  • 兼容 OpenAI Chat Completions、Anthropic Messages、Gemini、OpenAI Images 與 OpenAI Audio Transcriptions API
  • 可集中管理 Provider API Key、RPM / TPM、並發、熔斷狀態與剩餘容量調度
  • 內置 Provider 與模型導入模板,減少逐個端點手動維護
  • 提供 /v1/tools/* 接入 Agent Tools,現有 web-search、web-fetch、web-deep-search
  • 有 Playground、Simulator、審計與成本觀察能力,方便排查路由與計費設定

它強調的是可靠調度與營運控制,而非單一模型跑分。對需要向內部團隊、客戶或不同項目發放獨立 API Key 的環境,這種以資源治理為核心的取向,比單純聚合模型端點更完整,但相對也代表配置面會更廣,較適合已有多模型、多使用者或多成本中心需求的團隊。

GitHub

Categories: 開源, Agentic, OpenAI, Gemini, API, 框架, Anthropic

Gemini Robotics 2 想令機械人動作更完整

重點唔止係識睇同識答,而係令機械人連身體控制都更連貫。Gemini Robotics 2 指向的是把感知、推理同動作放入同一條工作流。

CSJxggUnu5m5TfompiXP2z7YLThhUvDn2 kBueCZv6HCEWWefUt WLzM6wxnTV1sTGqBbvmXDnOTB12W18NDr2NgFVXvHKCiTtjfXpyzuOYPJZXlg=w1440

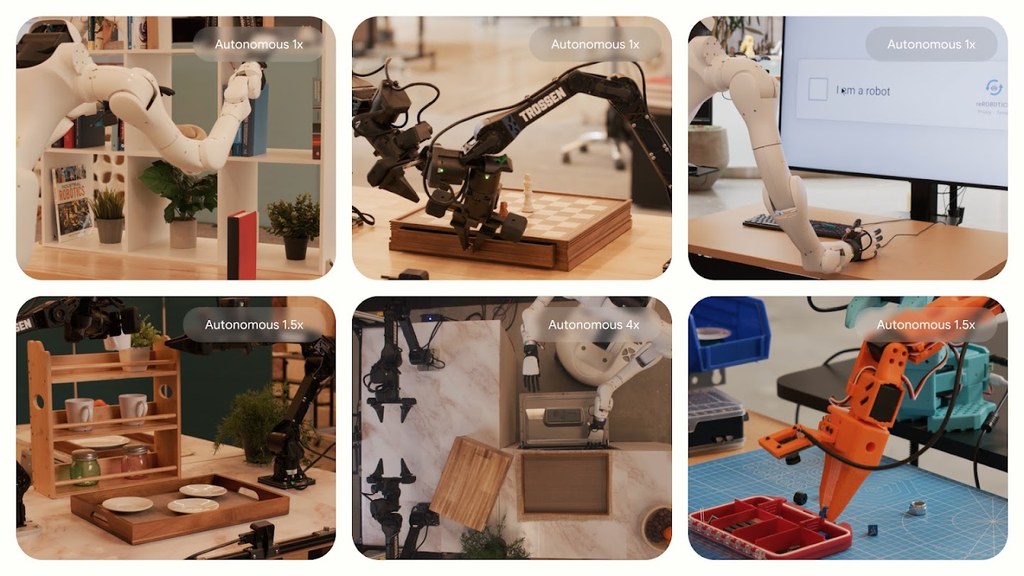
機械人最難處理的,往往不是單一步驟,而是由看見環境、理解指令,到整個身體協調完成動作的連續過程。Gemini Robotics 2 聚焦的正是這個落差,嘗試把 whole body intelligence 帶入機械人,讓系統不只會辨識和規劃,還能更自然地連動身體控制。

Google DeepMind 把它放在 Gemini Robotics 這條 physical AI 路線之下,定位清楚偏向機械人操作與互動。相比只處理螢幕、語言或單一機械臂任務的做法,這個方向更重視整體行為是否連貫,包括感知、推理、用工具與跟環境互動能否接上同一套能力。

對研究機械人、embodied AI 同 VLA 工作流的人來說,這類項目最有參考價值的地方,在於它瞄準真實場景中的協調問題,而不是只展示單點能力。文章提供的內容仍屬簡介層面,未見完整評測細節、量化指標或部署條件,所以現階段較適合當成技術方向觀察,而不是直接當作可落地規格。

  • 把機械人的感知、推理與身體動作放到同一條能力鏈
  • 核心關注點是 whole body intelligence,而不只是語言或視覺理解
  • 屬於 Gemini Robotics 系列,延伸 Google DeepMind 的 physical AI 佈局
  • 現有公開資訊偏介紹性,性能與限制仍有待更多技術資料補充

整體來看,Gemini Robotics 2 反映出機械人模型正在由「識唔識做判斷」走向「能唔能夠完整做完一個動作」。對需要長步驟操作、工具使用與環境互動的場景,這種整合式能力會比單一模組升級更值得留意。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, NanoBanana, Video, VLA, Audio, Robotic, 安全, Skill 技能

DeepSeek-V4-Flash 公測版重點更新

DeepSeek 把 V4-Flash 推上正式版 API 公測,焦點唔止係模型名稱更新,而係 Agent 工作流明顯變得更能打。對寫碼、自動化同工具調用有需求的人,呢次變更值得留意。

Og image

想用同一個 API 入口處理寫碼、自動化操作同工具調用,2026-07-31 呢次更新最值得留意。DeepSeek-V4-Flash 正式版已經開放 API 公測,調用方式維持不變,只要把模型名稱設為 deepseek-v4-flash,就可以切換到最新版本,對現有接入項目來講改動相對少。

今次更新的重點唔係介面改版,而係 Agent 能力明顯加強。官方列出的 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon verified 同 Automation Bench (Public) 等基準分數,都指向同一件事:V4-Flash 針對 Coding Agent、終端操作、工具使用同全棧開發場景做咗強化,而且公開測試成績已經高過 V4-Pro-Preview。

技術上,DeepSeek-V4-Flash-0731 的模型結構、尺寸都同 DeepSeek-V4-Flash-Preview 一致,更新集中在後訓練,意味住提升主要來自調整模型行為,而唔係換咗一個更大架構。它同時原生支援 Responses API 格式,亦有針對 Codex 做適配,對已經圍繞 API 建立 Agent 工作流的團隊會更易接入。

幾個重點可以直接整理如下:
– deepseek-v4-flash 已可直接使用正式版 API 公測
– API 調用方式不變,現有項目遷移成本較低
– Agent 能力是今次更新核心,涵蓋 coding、terminal 同 tool use
– Responses API 已原生支援,並針對 Codex 做咗適配
– 今次只更新 V4-Flash API,DeepSeek-V4-Pro API 以及 APP/WEB 端模型未有改動

使用上亦要留意邊界。現有資料有提供模型名、相容格式同基準測試結果,但未見更完整的安裝步驟、下載方式或者端到端接入流程;另外,官方亦講明今次並未更新 DeepSeek-V4-Pro API。對想盡快把 Agent 能力接入現有產品的人,V4-Flash 呢次公測比較像一次低改動、偏向工作流升級的更新。

項目主頁

Categories: Agentic, 模型, DeepSeek, API, Vibe Coding, 工具, 編程

ReDesign 把平面圖轉為可編輯設計

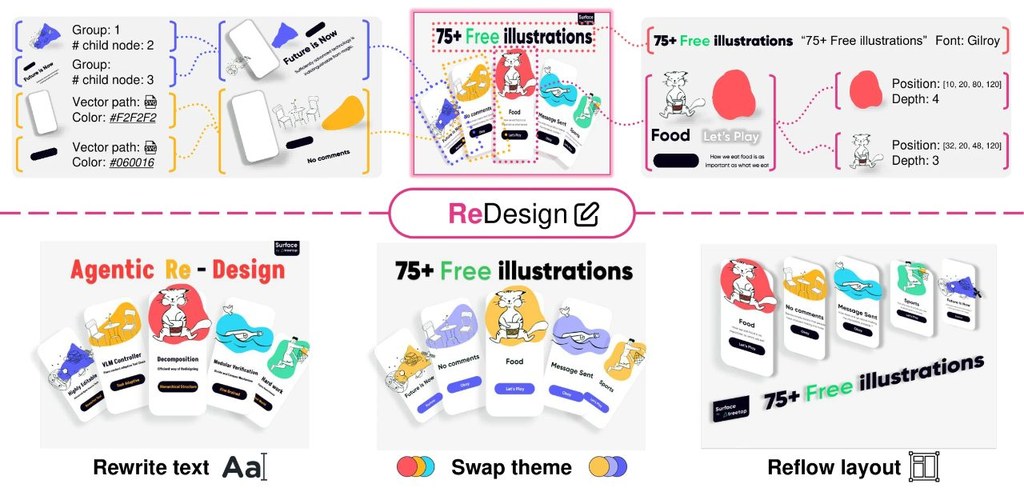
ReDesign想做的,就是把一張匯出圖,文字、圖層轉成獨立像素圖層結構,重新變成可編輯設計。

Repository image for jintae-00/ReDesign

設計原檔遺失之後,最麻煩唔係畫面睇唔到,而係改唔到字、拆唔開圖層、調唔到前後次序。ReDesign屬於Agentic取向的研究型工具,目標係由單張 raster image 重建出可編輯設計結構,輸出成帶有文字、向量形狀、群組同 z-order 的 JSON hierarchy。

它的判斷方式唔係一次過猜完整個版面,而係將設計當成 layer tree,由大區域開始逐層拆細,再用 verifier 檢查每一步成唔成立。呢個取向比起只做 OCR、只做分割,或者直接做多圖層分解更完整,代價就係系統較重,亦要配合多個視覺工具同較高 GPU 記憶體,當中 Qwen 相關 worker 官方已寫明大約要對應 55 GB 級別資源先容易跑得順。

相關模組之間的分工幾清楚:VLM controller 負責揀動作,文字會交由 PaddleOCR、字體辨識、Hi-SAM 同 LaMa 處理;物件與圖層則會用到 Qwen-Image-Layered、GroundingDINO、SAM 2、connected-component analysis 同 VTracer。換句話講,呢個項目唔係單一模型,而係把多個模型與工具串成一條可驗證的還原流程,較適合研究設計還原、可編輯圖形生成,或者想將靜態素材重新帶回設計工作流的團隊。

  • 單張平面圖可還原成可編輯 JSON hierarchy
  • 支援文字、向量形狀、圖片、群組與 z-order
  • 採用 coarse-to-fine tree expansion,加上 verifier 修正分支
  • 效能展示基於 Figma-909,指標上普遍優於多個 baseline

評測方面,項目頁面列出 Figma-909 這個 Dataset 數據集,並顯示 ReDesign 在 L1、PSNR、LPIPS、PQ 同 F1 等指標整體領先 baseline,說明它唔只重建外觀,亦較重視元素級別的可編輯性。儲存庫已提供 agent、baseline 同工具後端結構,但它更似一個研究系統而唔係輕量腳本;較值得留意的是多 GPU 分片、平行 worker 同視覺工具的資源安排,較適合有運算環境的研究者或產品團隊深入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, Qwen, Image, 影像處理, Dataset 數據集

Gemini Spark 登陸香港:AI 代你長時間跟進工作

想交低指示後由 AI 繼續處理雜務,Gemini Spark 就是朝這個方向而來。它把電郵、文件、搜尋與排程串連起來,減少你反覆催促。

Og image

最易理解 Gemini Spark 的方式,是把它看成一個會在背景持續運作的 Agentic AI 助手:你先交代目標,它再慢慢把零散工序接起來,處理那些花時間、又不想不停重複提示的工作。Google 已在香港推出這項服務,定位很清楚,就是幫用家把日常行政與資料整理自動化。

它接上的重點,不是單次問答,而是整段工作流。Gemini Spark 運行於 Google 的雲端基礎設施,能原生連接 Workspace 工具,例如 Gmail 和 Docs,毋須另外設定,就可以整理混亂的電郵往來、彙整行業消息、從舊文件抽資料做後續安排,甚至進行網上資料搜集、比較選項與完成預訂。

Google 提到,系統以 tasks、custom skills 和 schedules 這類機制去安排工作,讓用家用自然語言交代規則、例行事項與時間觸發條件,毋須寫程式。另一個分別在於,它不會因為你闔上手提電腦或鎖上手機就停下來,背景流程仍可繼續運作,較適合需要長時間跟進的文書與研究工作。

  • 支援背景持續執行,不用反覆重新提示
  • 可原生連接 Gmail、Docs 等 Workspace 工具
  • 能處理資訊整理、排程準備、網上研究與預訂類工作
  • 高風險動作前會先要求明確同意

控制權仍然留在用家手上。Google 表示,Gemini Spark 會按照用家指示運作,用家可決定何時啟用,以及容許它接觸哪些應用程式;遇到交易或發送電郵等高風險操作,系統亦會先徵求明確授權。現時香港由 Google AI Ultra 訂閱用家率先使用,Google AI Pro 用家的開放時間會在未來數星期逐步擴展。

項目主頁

Categories: Agentic, Google, Gemini, 提示詞, 框架, 香港, 工具, 編程, Skill 技能

ViMax 把影片生成變成多代理流程

想由一句想法走到完整影片,卡位往往唔係生成本身,而係分鏡、節奏同角色一致性。ViMax把呢條流程拆成多個 Agent 協作,重點放在先規劃、再生成。

Repository image for hkuds/vimax

直接由文字生成影片,最易出問題的通常不是畫面夠不夠靚,而是故事走向會散、鏡頭難連貫、角色設定前後不一。ViMax把這些環節拉回工作流處理:它屬於 Agentic Video Generation 類型的開源項目,用多個 Agent 分別扮演 Director、Screenwriter、Producer 與 Video Generator,目標是把影片生成由單次出圖,變成可規劃的多步驟流程。

這種取向的分別,在於它不只追求「一句提示詞出片」,而是先把敘事、鏡頭與製作安排拆開,再交回生成模組執行。對內容創作者、想做短片原型的團隊,或者研究多代理協作點樣落地到視頻模型工作流的人,這個項目會較有參考價值;但儲存庫提供的資訊目前偏簡短,未見完整測試結果、部署細節或清晰的安裝流程。

從名稱與描述判斷,ViMax較像一個協調層或框架,而不只是單一視頻模型。它想補的是影片生成裡最難靠單一模型穩定完成的前置規劃,因此價值未必在最終某一幀畫質,而在於整段片能否保持節奏與結構。不過,原始資料未交代它串接哪些底層模型、怎樣處理角色一致性,亦未提供性能指標,現階段較適合先當成研究方向與工作流設計來理解。

  • 把影片生成拆成 Director、Screenwriter、Producer、Video Generator 多個 Agent
  • 重點放在規劃與協作,不只是單次提示詞生成
  • 適合研究多代理、多步驟視頻製作流程的人參考
  • 儲存庫描述很短,暫時未見完整安裝、部署與評測資訊

ViMax最吸引人的地方,是它把「生成影片」理解成一條需要分工的製作鏈,而不是單一模型一次完成所有事。現有資訊仍不足以判斷成品穩定性或生產可用度,但作為開源方向,它清楚對準了多模態模型在長段影片敘事上的核心難題。

GitHub

Categories: 開源, 香港大學, Agentic, AI productions, Video

Page 16 of 35
1 … 14 15 16 17 18 … 35