IdeasHaveGenomes:用血統追蹤科研點子

研究提案寫得像樣,未必代表模型真正明白想法點樣演化。IdeasHaveGenomes把重點放在「點子血統」,專門測試 AI 能否追蹤繼承、變化同重組。

Ideas Have Genomes overview

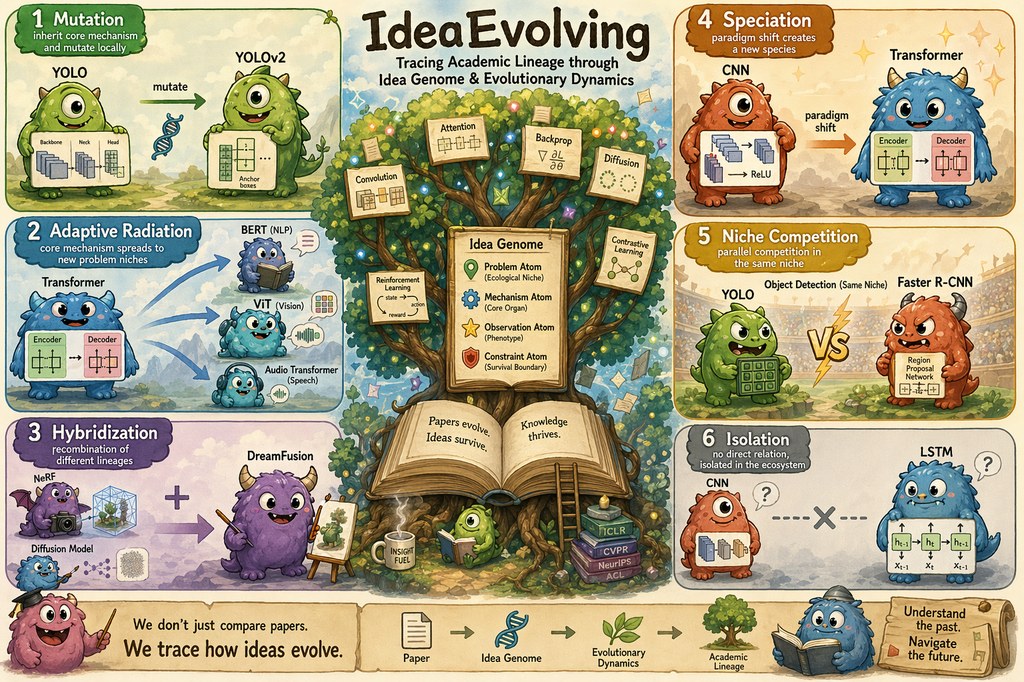
只會搵相似論文,已經唔足夠判斷 AI scientist 是否真係理解研究想法。IdeasHaveGenomes 把科學點子當成有 lineage 的對象去看,屬於 benchmark/數據集類型的項目,針對的正是 Auto Research 入面最難驗證的一環:模型能否講清楚一個 idea 由邊度嚟、點樣修補舊限制,最後點解值得延伸。

現有做法好多時集中在 related paper retrieval、proposal writing,或者用開放式生成結果做人手印象分。作者認為呢種範式捉唔到 inheritance tracing 同 evolutionary reasoning,所以提出 IdeaGene-Bench(IG-Bench),把任務分成封閉式測試 IG-Exam,同埋用 Population-Evolution Score(PES)評分的 IG-Arena,前者問理解是否精準,後者先看生成內容有冇 lineage 根據。

項目的可取之處,在於它唔只問「像不像新點子」,而係追問 Heredity、Variation、Selection 有冇成立。資料規模亦算完整,包括 1,961 條 golden lineage traces、1,085 個 Idea Genome objects、920 筆 GenomeDiff records,覆蓋 10 個 scientific domains;IG-Exam 進一步拆成 42 類 task、1,029 個 closed-form instances,適合做可重覆比較。

  • IG-Exam 主要測 abstraction、inheritance tracing、evolutionary reasoning、lineage verification
  • IG-Arena 針對開放式提案生成,用 PES 檢查血統延續與變化是否合理
  • 項目可用 OpenAI-compatible API 跑 smoke test 或完整評測,不一定綁死單一模型
  • 現有結果反映難度高,最佳 IG-Exam exact accuracy 只有 27.3%,最佳 T4 verification 為 17.4%
  • 榜單涵蓋 GPT、Claude、Qwen、Gemini、DeepSeek,以及 AI Scientist v2、Codex、Claude Code 等系統

部署理解上,這不是拿來直接替代研究助手的成品工具,而是用來測試模型或 agent workflow 是否真的具備「科研點子血統推理」能力。較適合做 AI scientist、research agent、proposal generation pipeline 的團隊評測基準;想比較不同模型、judge 組合,或者檢查生成提案有冇沿住正確 lineage 發展,這個項目比一般文字基準更有辨識度。
項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, 微軟, OpenAI, DeepSeek, Gemini, API, 框架, Anthropic, 中國, Dataset 數據集

AgentCanvas:把 embodied agent 變成可編輯圖譜

想試 embodied agent,最花時間往往不是想法,而是把模擬器、模型與工具串起來。AgentCanvas 把這層 execution stack 圖像化,方便研究團隊直接改結構、跑實驗、比較結果。

AgentCanvas editor: the MapGPT executor loads as a node-and-wire graph, then a live R2R episode runs end-to-end

卡位不在模型夠唔夠新,而在整個 embodied agent 系統太厚:simulator、perception、memory、planning 同 control 全都要接通。AgentCanvas 把這件事收斂成可執行的 typed graph 平台,用單一 JSON 保存一個 agent 結構,讓 VLN、EQA、VLA 一類工作不再每次都由 execution layer 重搭起步。

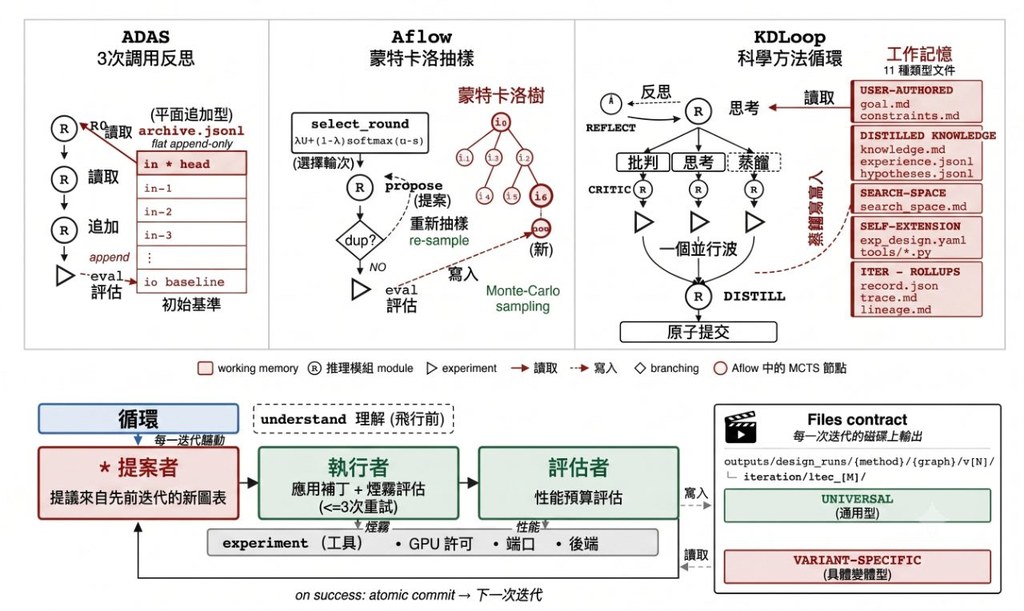
這個項目是把 embodied agent 改寫成可視化、可重播、可修改的圖譜程式。現有做法多數靠手寫 imperative code 逐層綁死 simulator、工具與 foundation models,作者認為這種範式難以比較、難以重現,也不利 architecture search;所以 AgentCanvas 先提供 substrate,再用 KDLoop 與 AAS 讓 coding agent 反覆改圖、驗證、再分析。

AgentCanvas 重點放在把 agent 結構標準化,而不是只交一份論文內部 executor。你可以在 editor 直接載入節點圖,跑真實 R2R episode,也可接 Habitat-Sim、MatterSim、SAPIEN/ManiSkill2、MuJoCo/robosuite 這些 simulator;新加入的 Source tab 還可就選定 node 回看 source slice,改完再 syntax-checked hot-reload,這對反覆試設計特別有用。

  • 支援 hand-built graphs,也支援 AAS 自動搜尋 agent 架構
  • 已接入 29 個 foundation models,包括 Qwen3-VL、InternVL3、Gemma 3、SmolVLM2、SigLIP2、OWLv2、Grounding DINO
  • 可覆蓋 VLN、EQA、VLA 與鄰近 embodied 任務
  • 研究預覽版已開源,環境基礎要求為 Python 3.10+

受益最明顯的,會是做 embodied AI 的研究團隊、要重現論文 executor 的學生,以及想比較不同 graph 設計而不是重寫整個系統的人。現階段它仍是 pre-1.0 research preview,性能數字應結合原論文結果閱讀;但單看定位,AgentCanvas 最有價值的地方,是把「難以維護的 agent 系統工程」變成「可被搜尋與修改的圖譜工作流」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, Qwen, Gemini, VLA, 框架, Vibe Coding, Python, 編程, Anthropic, Dataset 數據集

WildCity 把城市級空間智能拉回真實街道

想做城市級重建或模擬,最缺的往往不是模型,而是夠大、夠亂、又貼近真實道路的資料。WildCity正好補上這個缺口。

wild city

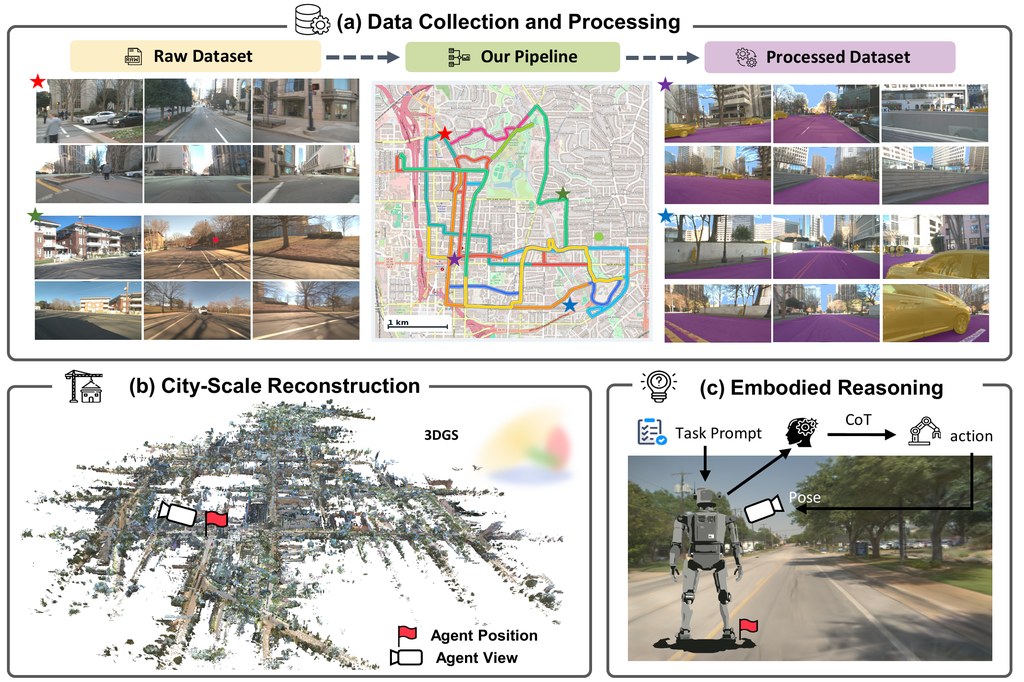
做城市級重建最麻煩的,不是把街景拼得靚,而是要在車流、光線變化、模糊影像同定位誤差同時存在時,仍然保留可用的空間結構。WildCity屬於Dataset 數據集兼研究測試平台,重點不是展示單一模型,而是提供一套面向真實城市環境的資料、重建基線與 closed-loop simulator,處理 rendering、simulation 同 spatial intelligence 之間長期脫節的問題。

這個項目的價值,在於資料規模同場景難度一齊拉高。,它覆蓋美國 6 個城市、18 段長距離行車軌跡、合共 1,507 公里,並整理成 3.01M synchronized keyframes,配合 6 個環視鏡頭、LiDAR、IMU 同 GPS。對研究團隊而言,這不只是多模態資料集,亦是一個可以檢查城市級 reconstruction、extrapolated rendering 與 embodied reasoning 能否真正落地的共同基準。

跟不少較乾淨、較短路段的資料集相比,WildCity的取向明顯更偏向「野外條件」:dynamic objects、lighting and appearance changes、motion blur、imperfect poses 都保留下來。代價是結果未必容易做得好看,但好處是更接近自動駕駛車隊、數碼孿生同機器人模擬會遇到的現實限制。它也不是即插即用型工具,因為 README 已寫明 code、dataset access 同 baseline 仍在準備釋出。

[ECCV26] WildCity: A Real-World City-Scale Testbed for Rendering, Simulation & Spatial Intelligence
  • 以真實車隊採集的城市級多模態資料為核心,而非單一演示場景
  • 除了資料集,亦規劃 urban-tailored 3D Gaussian Splatting baseline 與 closed-loop simulator
  • 適合測試大範圍 reconstruction、rendering 外推與 embodied reasoning
  • 現階段較適合先追蹤研究與評估設計,完整部署流程仍要等官方釋出

現時可以把 WildCity 理解為一個正在成形的基礎設施項目:資料已公開描述,Hugging Face 亦有資料集入口,而官方儲存庫之後會補上 loaders、evaluation scripts、reconstruction baseline 同 simulator。相關模型方向目前最明確的是 urban-tailored 3D Gaussian Splatting;若你做的是自動駕駛感知、城市數碼孿生、robotics simulation 或 spatial intelligence,這套基準值得提早留意,因為它測的不是理想條件下的漂亮結果,而是城市尺度下能否持續運作。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 世界模型, NVIDIA, Robotic, 3D, Dataset 數據集

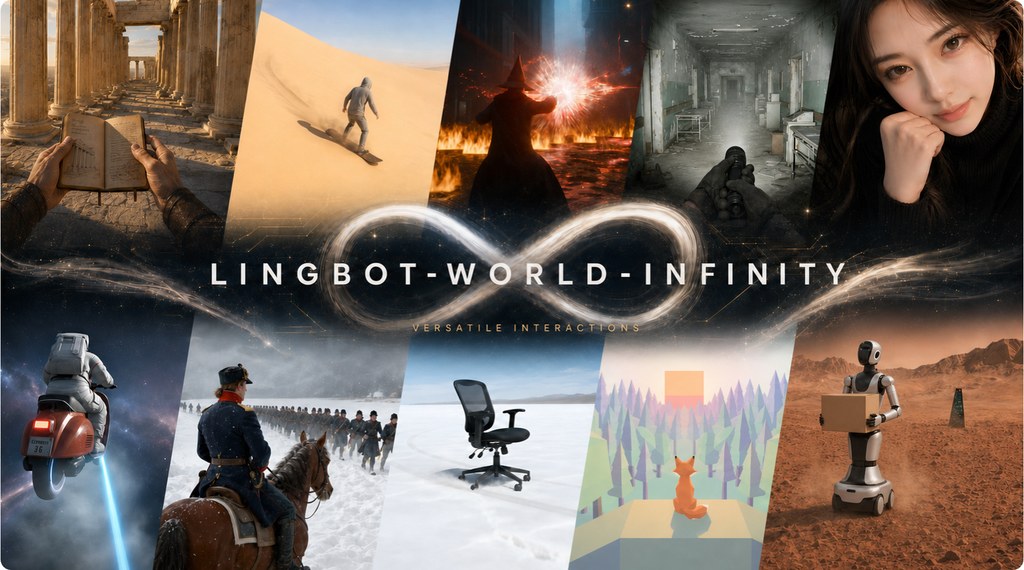
LingBot-World 2.0 把互動世界拉長

想像一個會持續生成、又跟得上操作節奏的互動世界模型。LingBot-World 2.0吸引人的地方,在於它同時追求連續性、速度與可玩性。

teaser

最值得留意的,不是單純生成影片,而是它嘗試把世界模型做成可持續互動的系統:畫面不只要動,還要在長時間互動下維持一致,並且跟得上即時操作。LingBot-World 2.0,也叫 LingBot-World-Infinity,定位上屬於模型項目,處理的是互動式世界生成容易愈玩愈散、反應又唔夠快的問題。

同類做法很多時偏向短片段展示,或者重視視覺效果多於操作連續性;這個版本反而把焦點放在「interaction horizon」拉長,同時保住輸出穩定度。它亦加入 agentic harness,由 pilot agent 規劃角色行為、director agent 補出新環境元素,方向上更接近可演進的遊戲式世界,而唔只係被動播放內容。

現階段最容易理解的試法,是先經 Reactor 的 Web 版本或 LingGuang 的流動平台體驗即時版;README 亦提供 Hugging Face 與 ModelScope 上的模型頁面。官方說明指出,平台版本方便試玩,但完整能力仍以官方設置為準,換句話說,公開體驗較適合感受互動節奏,未必等同完整表現。

  • 支援長時間互動,主打 unbounded interaction horizon
  • 提供即時變體,官方稱可驅動 720p、60 fps 影片串流
  • 動作與事件更豐富,包括攻擊、射箭、施法、射擊等互動
  • 以 pilot agent 與 director agent 分工,推進角色與場景演化

現有資料未見完整基準表或系統化對比結果,性能描述主要來自項目方公開說明,所以較適合把它視為一個展示取向鮮明的前沿模型。相關模型目前可見的是 lingbot-world-v2-14b-causal-fast;而從 Robbyant 整體路線來看,它亦與 LingBot-Vision、LingBot-Depth、LingBot-VLA、LingBot-Video 等項目一起指向 embodied AI 與世界模型的長線布局。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 世界模型, Video, VLA

GitHub Copilot 桌面 app 全面開放

而家唔止付費用戶先可用 GitHub Copilot app,連 Free 同教育方案都可以直接開跑。你可以把它理解成將 agent-driven development 帶到桌面的入口。

Og image

寫程式想快啲進入 agent-driven development,而家門檻低咗好多。GitHub Copilot app 已經開放畀所有 Copilot 方案使用,涵蓋 Copilot Free 同 GitHub Education,並且支援 macOS、Windows 同 Linux,等開發者可以直接由桌面開始工作。

對一般開發者而言,重點唔只係「多一個 app」,而係登入 GitHub 帳戶後,幾下點擊就可以開 session,將 Copilot 由編輯器內的輔助,延伸到更完整的桌面互動流程。呢個變化對想集中用單一入口管理開發節奏、快速試 agent 工作方式的人會更有吸引力。

另一個取向幾清楚:就算冇訂閱 Copilot 方案,仍然可以用 bring your own key(BYOK)接上自己嘅 model provider 跑 session。即係話,GitHub 將入口開放得更闊,一邊照顧現有 Copilot 用戶,一邊容許偏好自選模型供應商嘅團隊或個人保留彈性。

  • 所有 Copilot 方案都可使用,包括 Copilot Free 同 GitHub Education
  • 支援 macOS、Windows、Linux 三個桌面平台
  • 可用 GitHub 帳戶直接登入並快速開始 session
  • 冇 Copilot 訂閱亦可透過 BYOK 連接自有 model provider
  • Business 或 Enterprise 方案需由管理員啟用 Copilot CLI 政策設定

對團隊環境來講,Business 同 Enterprise 用戶仲要留意權限設定:組織或企業管理員需要先在 policy settings 啟用 Copilot CLI,先可以存取 GitHub Copilot app。呢點反映出 GitHub 既想擴大可用範圍,同時亦保留企業管理所需的控管方式。

項目主頁

Categories: Agentic, 微軟, API, Mac, Linux, 編程

AI agents 正接手企業故障追查

當系統愈來愈複雜,單靠工程師逐層查 root cause analysis 已經太慢。企業而家更想交畀 AI agents 先做調查,再由人決定下一步。

當服務一出問題,最花時間往往唔係修復,而係先搵出 root cause analysis。呢篇內容聚焦企業 observability 點樣由 Generative AI 同 agentic AI 推進,令 AI agents 開始負責調查、整理線索同縮窄問題範圍,減少工程團隊喺大量 telemetry 同 log 之間來回切換。

文章提到,企業採用速度已經相當快,約 85% 組織正使用相關 AI 能力,而 Elastic 亦預期多數企業會喺兩年內,將 root cause analysis 更大程度交畀 AI agents。吸引力唔只在於自動化,而係將原本只有少數資深工程師先能處理的觀察與排障流程,慢慢變成更多團隊都可用的能力。

同常見做法相比,分別在於 AI agents 唔止回應查詢,仲會主動串連資料、追查異常脈絡,並以較接近調查員嘅方式處理 incident。呢種模式有機會改善資料存取門檻過高、工具過多同訊號過散嘅問題,但前提仍然係企業要信任結果,並保留人手覆核關鍵判斷。

  • 重點放在 observability、incident investigation 同 root cause analysis
  • Generative AI 與 agentic AI 正由輔助查詢走向主動調查
  • 約 85% 組織已採用相關 AI 能力,企業導入已進入加速期
  • 目標係降低排障門檻,令更多團隊可直接理解系統狀態

對平台工程、SRE、DevOps 同需要處理大型分散式系統嘅團隊,呢種方向尤其有用。現階段最值得留意嘅唔係模型規格,而係 AI agents 能否喺真實企業環境中提供可追溯、可驗證、又足夠穩定嘅調查流程,呢點會直接影響大規模 adoption。

項目主頁

Categories: Agentic, 軟件, 中國

Rank-Then-Act 點樣用影片學出獎勵

想像你只得示範影片、冇現成 reward function,Rank-Then-Act 就係針對呢個卡位而來。它先學會判斷進度,再把次序感轉成強化學習可用的訊號。

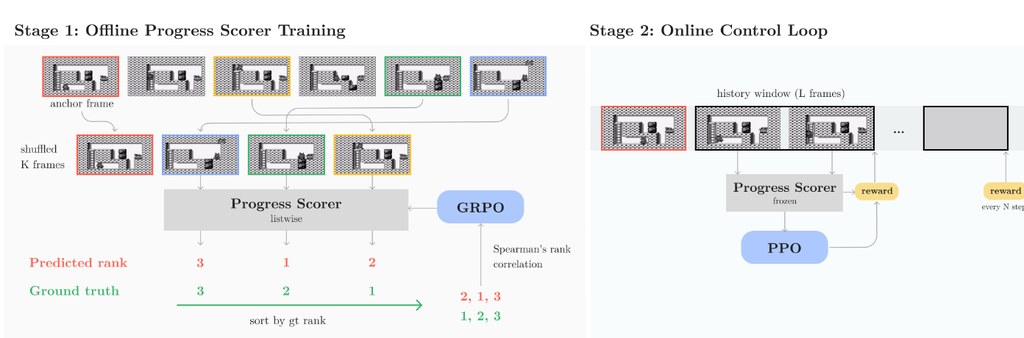
Screenshot

做強化學習最麻煩的地方,往往不是訓練本身,而是根本冇一個好用的 reward function。Rank-Then-Act 針對的正正是這個缺口:它屬於一個以 Vision-Language Model (VLM) 為核心的強化學習框架,目標是在沒有環境獎勵的情況下,從示範影片推回任務進度,再把這種進度感變成 agent 可學習的 dense reward。

同類方法很多時會直接學一個 scalar reward,或者預測成功與否,但作者刻意避開這條路。RTA 先用 GRPO 微調 VLM,要求模型在打亂次序的畫面序列中估計 task-completion 百分比與排序,再用 VOC 這個 rank-correlation reward 去約束模型真的理解時間進展,而不是偷看絕對時間線索;之後在第二階段,系統不是直接輸出分數當 reward,而是用 Spearman rank correlation 比較預測進度排序與真實時間索引,得到一個 bounded、scale-invariant 的學習訊號。

這種取向的好處,是 reward 較不容易因尺度漂移而失真,亦較有機會跨任務重用同一個 progress scorer。現有資料指出,它在離散環境如 PyBoy 上的 Catrap、Kirby,以及連續控制環境如 MetaWorld、PointMaze 都有不錯表現,對 unseen tasks 亦有泛化能力;不過這仍然是研究型項目,重點在方法驗證,未算是即裝即用的成品工具。

  • 重點不是直接預測分數,而是先學會判斷畫面進度排序
  • 第一階段用 GRPO 訓練 VLM,第二階段用 PPO 訓練策略
  • reward 來自 VOC 與 Spearman rank correlation,訊號範圍固定在可控區間
  • 已覆蓋 Game Boy 模擬器 PyBoy 與 MetaWorld 這類不同控制場景
  • 需要 Python 3.10+、CUDA GPU,第二階段還要 xvfb、ROM 與 save state

理解和測試這個項目,最合理的方式不是把它當普通套件安裝,而是當成兩階段實驗流程來看:先在 stage1 用 gameplay videos 訓練 progress scorer,再到 stage2 把該模型凍結成 reward model,放進 PPO 訓練流程。儲存庫已把資料處理、Hydra 設定、多 GPU 配置、PyBoy 包裝器與 VOC 計算分開整理好,適合研究團隊、做 video-based RL 的人,或者想比較 ordinal reward 與 scalar reward 差異的讀者深入追蹤。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Python

SkillOpt-Lite:幫 coding agent 自我改良

想令 coding agent 越跑越準,呢個項目用聊天指令就可以反覆試錯、驗證同回滾。它不是再訓練模型,而是直接改進 skill 與 agent 流程。

SkillOptLite / HarnessOpt pipeline

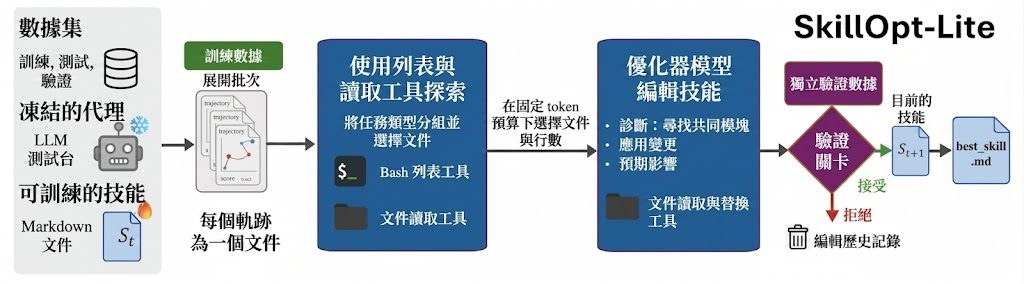
不少人用 coding agent 時,卡位不在模型本身,而在 prompt、skill 文件同執行流程點樣一路修正。SkillOpt-Lite 連同 HarnessOpt 就是針對這個位置而來的 Agentic 工具:把評測、修改、驗證同回滾包成兩個 slash command,讓 coding agent 在對話環境內自動迭代改善。

它反對一種常見範式:每次表現不好,就手動改 prompt、重跑少量樣本,再憑感覺決定有沒有進步。作者改用 looped improvements 配合 validation-gated rollback,先跑一批 scored rollouts,將失敗樣本交回 coding agent 修補,再用 val split 決定保留還是還原;焦點不是 fine-tuning,也不是增加 inference-time overhead,而是把現有 agent workflow 系統化地優化。

部署理解上,這個項目不是叫你在 shell 逐步砌環境,而是把 repo 資料夾直接開進支援 .github/prompts/*.prompt.md 的 coding agent,例如 VS Code Copilot Chat、Codex CLI、Claude Code。環境安裝、驗證、資料下載由 agent 協助處理;現成 benchmark 包括 LiveMath、SpreadsheetBench、ALFWorld、DocVQA、OfficeQA 同 SearchQA,亦支援帶入自家 repo 與資料格式。

  • SkillOpt-Lite 只改 skill.md,適合先驗證 prompt/skill 層面的改善
  • HarnessOpt 連 agent harness 一起改,包括 rollout、react-agent、executor 等程式部分
  • 以 val gate 決定保留或回滾,比單看一次 train 結果更穩陣
  • 官方重點是「no fine-tuning, no inference-time overhead」,取向明顯偏向低成本迭代

跟同類做法相比,它的差異不在於推出新模型,而是把「由 agent 自己根據失敗紀錄修補自己」做成可重覆流程。公開內容提到在 6 個 benchmarks 有結果,亦展示過 GPT-5.4-nano 配合 HarnessOpt 可超過較高階模型配標準 harness 的情況;不過現時較依賴 coding agent 工作流,最適合做 agent 評測、提示工程、內部工具自動化的團隊,而不是單純想下載一個模型即用的人。相關模型與目標例子則包括 GPT-5.4-nano、GPT-5.5,以及各種可讀取 prompt 檔的 coding agents。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Vibe Coding, 編程, Dataset 數據集, Skill 技能

Light-Omni 想把長影片 Agent 變得更快

面對長影片互動,Light-Omni唔再靠一輪輪搜尋同推理。它把記憶、檢索同回應壓縮成較輕量流程,重點放在速度同連續互動。

Light-Omni

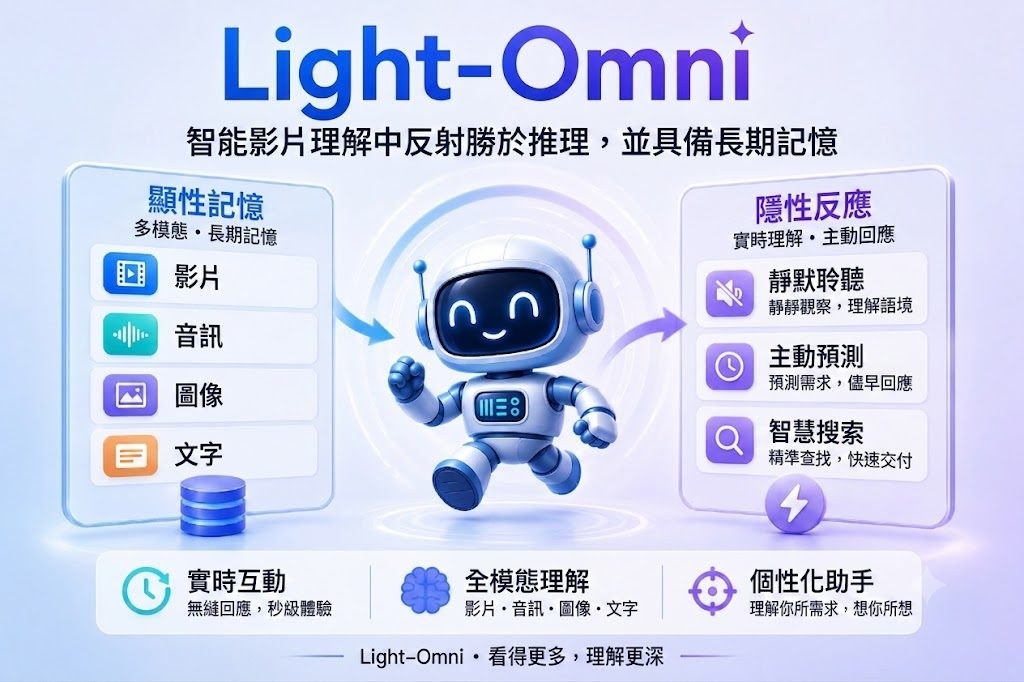
長影片互動最易卡住的位,不是模型看不懂,而是每次都要重新搜尋線索、反覆推理,回應自然會慢。Light-Omni把這件事改寫成一個Agentic video understanding研究項目:用長期多模態記憶處理視覺、語音與文字串流,目標是讓代理在連續對話中更快決定要直接回答、提取記憶,還是補足證據。

現有做法常採用作者所說的 detective-style iterative reasoning,一邊規劃、一邊搜尋、一邊聚合證據;好處是步驟清楚,代價是延遲高、計算開銷大。Light-Omni提出 reflexive video understanding,核心不是拉長 reasoning loop,而是以單次 forward pass 產生全域脈絡與 retrieval embeddings,再配合 Generation Adapter、Memory Adapter、Reaction Adapter 三個模組,分別負責回應、長期記憶整理,以及預測何時檢索。

這個取向的價值很直接:它不是追求最繁複的推理鏈,而是優先解決互動代理在長影片場景的反應速度。項目建基於 Qwen2.5-Omni,示範則用 Qwen3-Omni-30B-A3B-Instruct;記憶設計包含 identity profiles、semantic memory、episodic memory,並加入 sleep-time memory consolidation,把較長時段的觀察壓成緊湊全域狀態,同時保留近期細節。

  • 相比 M3-Agent,平均準確率提升 2.4%
  • 速度達 12.1x,加強長影片互動的即時性
  • GPU 記憶體效率提升 2.6x,較適合資源有限的部署
  • 倉庫附有 eval.py、Flask/Socket.IO demo、Hugging Face 模型與訓練資料

想驗證這個項目,現時可沿三條路理解:先看 web demo 感受反應方式,再用倉庫內的 eval.py 配合 logs/ 檢查長影片 benchmark 結果,最後參考 thirdparty/ 內已修補的 transformers 與 ms-swift 組件做訓練或推理環境配置。較受用的讀者會是做多模態代理、長影片理解、記憶檢索,或者需要低延遲互動系統的研究團隊;它仍屬研究原型,效能數字主要來自項目提供的 benchmark 與示範,部署前仍要按自己的影片長度、硬件條件與任務形式再核實。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, Embedding, 模型, 多模態模型, Video, Dataset 數據集

PaperPilot:把文獻搜尋變成可修改流程

找相關研究唔一定只靠一條關鍵字。PaperPilot把文獻搜尋拆成可檢查、可改寫的流程,令多輪互動真係會改變搜尋策略。

PaperPilot logo

做研究時,最麻煩往往唔係「搵唔到論文」,而係第一輪結果未必貼近你真正想追嘅方向。PaperPilot屬於開源框架,同時亦帶有已訓練代理模型,用 workflow induction 處理多輪學術文獻搜尋:它會圍繞 anchor paper 同查詢,先建立一個 typed DAG,再用澄清問題同後續回應去改動搜尋流程本身,而唔係只係喺原句後面再加條件。

呢個定位同一般固定 pipeline,或者只靠語言模型隱式推理嘅搜尋代理,好唔一樣。作者認為舊範式嘅問題,在於搜尋策略難以控制、難以檢查,亦唔容易根據人嘅偏好逐步修正;PaperPilot就把 keyword search、citation expansion、filtering、scoring、reranking、evidence extraction 組成可執行流程,每一步改動都可以保留,令結果更可追溯。

公開資料已經提供 live demo,亦有 FastAPI 後端、Streamlit 介面、evaluation scripts 同 tests,可理解成一套可部署、可觀察、可重跑嘅研究工具鏈。不過 initial release 未包含 web/ React front-end,同 training_infra/ 亦未完整開放;README 片段亦未見完整安裝流程,現階段較適合先用 demo、閱讀論文,再按儲存庫結構自行部署 backend 與本地介面。

  • 多輪互動唔止改 query,仲會直接編輯 typed DAG workflow
  • 約 50 個 typed operators,覆蓋檢索、集合操作、排序同證據抽取
  • 每次執行會保存流程、逐輪修改、時間與成本,方便重現結果
  • PaperPilot-9B 以 workflow imitation 加 preference optimization 訓練而成
  • 指標上較 base Qwen3.5-9B toolset agent 提升 Hit@5、MRR、nDCG@10,並把 workflow execution errors 由 9.5% 降到 0%

相關模型方面,核心比較對象係 base Qwen3.5-9B toolset agent,而實作後端就標明支援 OpenAI、Together、Anthropic 同 OpenAI-compatible endpoint。呢種設計對研究員、需要做系統性文獻整理嘅學生,或者想把檢索流程納入團隊知識管理嘅人都幾有價值;取捨在於它追求可控與可審核,流程會比單次對話搜尋更重,亦更依賴使用者願意逐輪提供清晰反饋。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, API, Dataset 數據集

Page 20 of 35
1 … 18 19 20 21 22 … 35