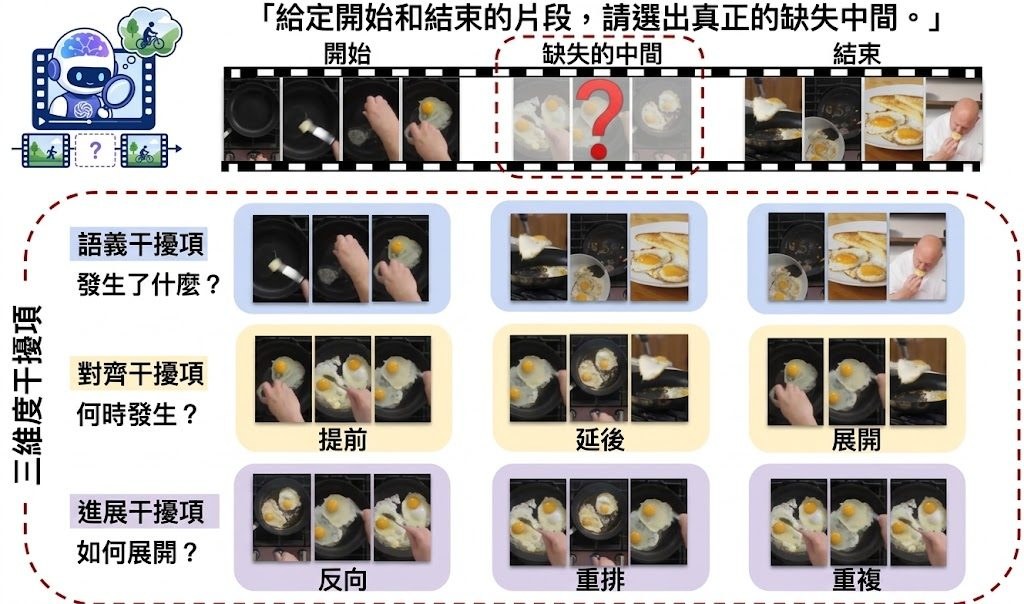
TempCloze 的玩法相當直觀:給一段影片的開頭與結尾,要求模型從四段候選片段中挑出真正屬於中間缺失的那一段。四個選項全部來自同一條影片的素材,連文本線索都壓到最低,等於逼模型只能用眼睛去判斷時間先後與事件流暢度。
這套基準特別針對三個時間維度:語義(Semantic,考「發生了什麼」)、對齊(Alignment,考「應該在何時發生」)、推進(Progression,考「事件如何展開」)。對齊的干擾選項設計得很巧妙,例如把同一段內容前移、後移或拉長;推進維度則把片段倒播、重排、重複,看模型能否識破。題目素材刻意挑選長鏡頭與第一人稱影片,避免靠剪輯或場景切換就能蒙混過關。
跑完 31 個 Video-LLM(10 個閉源加 21 個開源)後結果很殘酷:無論是 GPT 類還是開源權重,模型在對齊任務上的準確率幾乎腰斬,閉源平均從語義 70.73% 跌到對齊 48.13%,開源平均更只剩 26.54%。相比之下,人類在嚴格協議下仍能達到 97% 平均正確率。換言之,現在的 Video-LLM 對畫面在時間軸上的位置幾乎沒概念,只能靠語義關聯硬猜。
對於做影片理解、embodied AI、多模態基準研究的人來說,這份工具包很值得關注。它提供統一抽幀協議(每段 16 幀,六片段題 96 幀),評測流程可直接套用,重點在於指出時間對齊才是視頻推理的真正瓶頸,數字與圖表都已經整理好。
重點摘要:
- 任務設計:四選一影片填空,所有干擾項來自同一條原片,消除文本捷徑
- 三維度考核:語義、對齊、推進,分別測事件、位置、展開方式
- 數據規模:1,521 條影片,長鏡頭與第一人稱為主,七個公開來源
- 核心發現:對齊維度是最大瓶頸,開源模型跌至 26.54%,閉源亦僅 48.13%
- 工具價值:統一抽幀協議與評測腳本,可直接比較現有 Video-LLM 在時間推理上的差距