StreamArena 多模態長片代理的記憶與互動分析

來自香港科大、港大與中大及小紅書的團隊,把長達近 90 分鐘的影片理解拆成可持續觀察、回想、找工具與主動回應四種能力。

StreamArena overview

由 HKUST(香港科技大學)、The University of Hong Kong(香港大學) 與 The Chinese University of Hong Kong(香港中文大學) 及小紅書組成的開發團隊,將焦點放到一個很多多模態代理都未真正處理好的難題:影片唔再係幾秒剪輯,而係接近一個半鐘頭、仲要持續互動。StreamArena 屬於資料集與評測工具包,處理的是 continuous streaming video understanding,目標係用統一方法檢驗代理在長時間影音流之中,能否即時理解、隔一段時間後仍然記得內容,並在合適時機用工具或主動回應。

呢個項目最值得注意的地方,在於它唔用短片加選擇題去掩蓋模型弱點,而係用 243 段 full-length videos、平均 88.8 分鐘、合共 3,646 個 open-ended tasks,分成 Real-Time Perception (RTP)、Historical Retrospection (HR)、External Tool Use (Tool) 同 Proactive Interaction (Pro)。HR 與 Pro 仲按時間跨度分層,HR 最遠拉到 30 分鐘,直接把長期記憶與延遲控制的取捨攤開來測。

StreamArena Evaluation Toolkit:streamarena/ 放資料載入、媒體處理、tool-call protocol、OpenAIBackend、GeminiBackend 同 LLM-as-Judge scorer;method/ 則整理多種被測方法,包括 offline 的 Qwen、MiMo、Kimi、Qwen-Omni、Gemini,以及 MiniCPM-o-4.5、VST、StreamForest、ThinkStream。所有方法都寫入同一套 records JSONL schema,所以 judge/ 可以用同一把尺評分。安裝與執行細節在目前資訊裡未完全展開,但可確認它不是單一模型倉庫,而是用來重跑、對齊與比較不同方法的評測框架。

  • 覆蓋四類能力:RTP、HR、Tool、Pro,唔只問答,仲測持續監看與主動互動
  • 243 段長影片、平均 88.8 分鐘,資料規模明顯偏向長時序理解
  • 同一份 JSONL 輸出格式配合通用 judge,方便橫向比較不同方法
  • StreamMind 在同一 Qwen3.5-397B-A17B backbone 上,把 pooled query-to-answer latency 降低 66.2%

一個重要限制:StreamMind 在這次釋出裡只有 evaluation protocol docs,未附完整可直接重現的實作;AURA 亦只提供 client,server 仍要依賴官方 vLLM。換句話說,StreamArena 現階段更像研究團隊、代理系統開發者同多模態評測工作流會用到的基礎設施。想比較不同 streaming method、檢查長影片代理究竟卡在記憶、反應,還是工具調用,呢個項目比一般短片 benchmark 更接近部署前要面對的現實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, Agentic, 多模態模型, Qwen, Gemini, Video, 香港, Kimi

AVE-Compass:音畫編輯終於有了更嚴格的驗收尺

AVE-Compass 把音效、畫面與指令完成度放在同一套測試中,揭示編輯模型最容易忽略的失真與不同步問題。

AVE-Compass overview

音畫編輯模型最難兼顧「改得夠準」與「其他內容不走樣」。AVE-Compass 是一套針對自由格式音訊影片編輯的診斷基準及評估工具,檢查模型有沒有完成指定修改,同時保留非目標畫面和聲音,亦會捕捉音畫不同步與感知瑕疵。

測試範圍包括145段來源影片、196條經人工核實的音畫指令、2,688項細緻 checklist,以及28種編輯操作,涵蓋聯合音畫、語音、純影片和純音訊修改。它以 Multimodal Large Language Model (MLLM)-as-Judge 配合跨模態、影片及音訊自動指標,分開計算 Instruction Following、Fidelity Preserving、Editing Intent 和 Realism。

MiniMax H3 Turbo LoRA Faster Sampling Steps & Prompt Agent Skill

使用者可從 AVE-Compass-v2 資料集取得樣本,再按設定檔和輸入模板交予評估 pipeline,輸入來源影片、指令、checklist 及模型產生的編輯結果。樣本以共享的識別值配對,來源影片則由 instruction JSON 解決;未啟用或缺失的客觀指標會維持未設定,不會被當成虛構的零分。

重點可整理為:
– Editing Intent 同時要求完成修改及保留非目標內容,避免模型不作修改卻取得偏高保存分數。
– 音訊執行和音畫時間同步是常見失分位置。
– AVE-Agent 加入 planning 和 self-reflection,對複雜指令的 Editing Intent、Instruction Following 及音訊處理有較明顯改善。
– 基準適合研究團隊比較模型,也適合影片生成產品建立回歸測試。

它的價值不在於只給一個總分,而是把「改錯了甚麼」拆開呈現;代價是需要模型輸出影片、完整評估資源及相應 MLLM,部署門檻高於單純像素或音質比較。對正在開發跨模態編輯模型的團隊,AVE-Compass 更像一套找出失敗原因的驗收框架,而不只是排行榜。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 多模態模型, 語音, Dataset 數據集

Vision-DeepResearch:由靜態圖片走向連續影片的 DeepResearch Agent

Video-DeepResearch 將視覺搜尋延伸至連續影片,要求模型先理解跨畫面的證據,再進行網絡探索。

icon

面對需要翻查影片內容、再結合網絡資料回答的問題,單靠文字搜尋往往會漏掉關鍵畫面。Video-DeepResearch 是一個多模態研究型 Agent 項目,透過 Video-DeepResearch(Video-DR)處理連續影片中的時空資訊,並把視覺理解與網絡探索分開安排。

它修正了兩個常見卡位:模型偏向使用文字工具,較少主動檢視影片;模型亦可能直接依賴內部記憶,未有真正完成工具輔助搜尋。Pipeline 先逐階段解鎖視覺工具,要求模型完成跨畫面 grounding,再進入網絡檢索,取捨是流程較嚴謹,但推理成本和執行時間亦可能增加。

訓練流程先以 Supervised Fine-Tuning(SFT)建立基本能力,再使用 Group Relative Policy Optimization(GRPO)強化自主探索。項目同時提供 30 K 個 video-grounded QA pairs、7 K 條整理後的 trajectories,以及程式碼、資料集和模型權重,研究團隊可按需要測試基準、重現訓練或直接載入模型。

  • Video-DR-35B-A3B 在 Video-DR 達到 68.0% accuracy
  • 比 Claude-4.5-Sonnet 的 63.0% 高 5.0 個百分點
  • GPT-5 和 Gemini 2.5 Pro 分別為 57.0% 和 62.0%
  • Vision-DeepResearch-30B-A3B 延續同一研究方向,另有 SFT-only 的 8B 版本

現有結果反映它在影片證據與網絡資料需要互相驗證的工作較有價值,例如研究、媒體核查和長片段問答;但 68.0% 仍代表部分問題會出錯,較適合作為研究平台和可檢驗的 Agent 架構,而不是無需監督的影片分析服務。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港理工大學, Agentic, 多模態模型, 模型訓練, Qwen, OpenAI, Gemini, Video, 香港, Anthropic, Dataset 數據集

awesome-agentic-world-model:由 World Model 走向可互動的 Agent-Centric World Proxy

這份開源索引把世界建模重新連接到代理人的規劃、學習與驗證流程,亦清楚標出目前仍未解決的取捨。

Repository image for worldbench/awesome-agentic-world-model

需要持續試錯的 AI agent,未必每次都要真的操作環境;有時預測未來狀態、渲染視角、模擬執行結果,甚至取回技能或驗證計劃,已足以支援下一步決策。這個項目屬於開源研究索引與分類框架,實際處理的是如何整理 Agentic world modeling 相關工作,讓讀者按代理人需要的資訊尋找合適方法。

它不會像可直接下載的模型或部署服務般產生結果,價值在於把傳統被動預測下一個物理狀態的 World Model,延伸為面向代理人的 Agent-Centric World Proxy。相比只回答「下一刻會發生甚麼」,World Proxy 也可以回答「這個計劃能否執行」、「應取回哪段經驗」或「下一步應觀察甚麼」,但不同研究的成熟度和驗證方式仍然不一致。

分類採用兩條軸線:六種 Proxy functions 包括 Dynamics、Spatial、Execution、Memory / Experience、Skill 及 Reward / Verification;三個 empowerment levels 則分為 L1 inference-time guidance、L2 training-time optimization,以及 L3 Agent-Proxy co-evolution。這個關係有助分辨模型是在決策時提供提示、訓練時改善能力,還是與 agent 一同持續演化。

  • 用途:按功能及能力層級尋找研究工作
  • 內容:整理模型、論文、arXiv ID、發表場合與年份
  • 維護:接受新增項目、分類修正及連結更正
  • 限制:本身沒有推理 API、安裝流程或統一性能基準

它適合研究人員、建立 agent pipeline 的工程團隊,以及需要比較 Dynamics、Memory 或 Verification 方法的人;但若目標是立即部署系統,仍須自行選擇並安裝清單內的個別模型或工具。

項目目前更像一張持續更新的研究地圖,而非完成度一致的 benchmark。它的優點是提供共同語言,將 world modeling 從單一狀態預測重新放回規劃、學習和互動成本的脈絡;限制則是清單依賴社群維護,分類邊界仍會隨 Agentic world modeling 發展而變動。

項目主頁 · GitHub

Categories: 開源, Agentic, 世界模型, 模型訓練, API, Dataset 數據集, Skill 技能

DeepVoyager-VL 把視覺線索放回搜尋流程中

DeepVoyager-VL不只是睇圖再答題,而係會用新取得嘅視覺證據決定下一步搜尋。對長流程多模態檢索項目而言,呢個改動幾關鍵。

Comparison of multimodal search data synthesis paradigms

當一個多模態 agent 要連續查多步資訊,最易失準嘅位置往往唔係答題,而係中途搵錯線索。DeepVoyager-VL處理嘅正正係呢個問題:佢屬於長流程多模態 deep-search 框架,讓新取得嘅圖片證據直接影響下一輪檢索,而唔係只喺輸入開頭或答案結尾先用到視覺資訊。

呢種做法令佢同一般把視覺訊息包裝成前置條件嘅方法有明顯分別。DeepVoyager-VL背後用 EventVoyage-VL 生成帶有中間視覺依賴嘅長流程問題,再用整理過嘅 trajectories 做 Supervised Fine-Tuning(SFT),而唔加額外 reinforcement learning 階段;取捨好清楚,訓練流程較可重現,但效果仍然要靠資料合成質素同軌跡篩選撐住。

倉庫而家已經放出 paper、project page,同可重現嘅 Megatron SFT training bundle,亦提供 DeepVoyager-VL-8B 同 DeepVoyager-VL-30B-A3B 模型,以及 EventVoyage-VL dataset。想理解點樣驗證,最直接係沿住現成模型、資料集同訓練 bundle 睇完整流程;README 亦提到 SWIFT RUNTIME=bundled 會使用儲存庫內嘅 source trees,定位上比較接近研究與訓練復現項目,而唔係即開即用嘅消費級產品。

  • 核心改動:把 vision in the loop 放入搜尋中段,圖片可按需要先載入或裁切
  • 資料來源:EventVoyage-VL 先做 structure-before-language synthesis,再抽出可監督軌跡
  • 訓練路線:以 supervised-only 為主,冇再疊 reinforcement learning 階段
  • 結果:8B 同 30B-A3B 平均分別為 54.8 同 58.6,並在十個 benchmark 入面分別拿下八個同九個最佳成績

分數本身已經講到定位:DeepVoyager-VL不只是追求更大模型,而係想改善「見到新圖之後,下一步應該搵乜」呢個決策環節。較受益嘅會係做多步檢索、多模態問答、研究型 agent pipeline 嘅團隊;要留意嘅限制亦同樣直接,成效高度依賴合成資料點樣把中途視覺依賴編排得夠真實,離開相關 benchmark 之後,泛化深度仲要靠後續驗證。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 北京大學, 華為, Agentic, 模型, 多模態模型, 模型訓練, 框架, Dataset 數據集

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

N0-TWAM 把觸覺帶進機械人決策

鏡頭睇到嘅畫面未必足夠,N0-TWAM連觸覺一齊預測,再生成動作。對接觸密集操作來說,這個方向比只看影像更貼近現場需要。

teaser

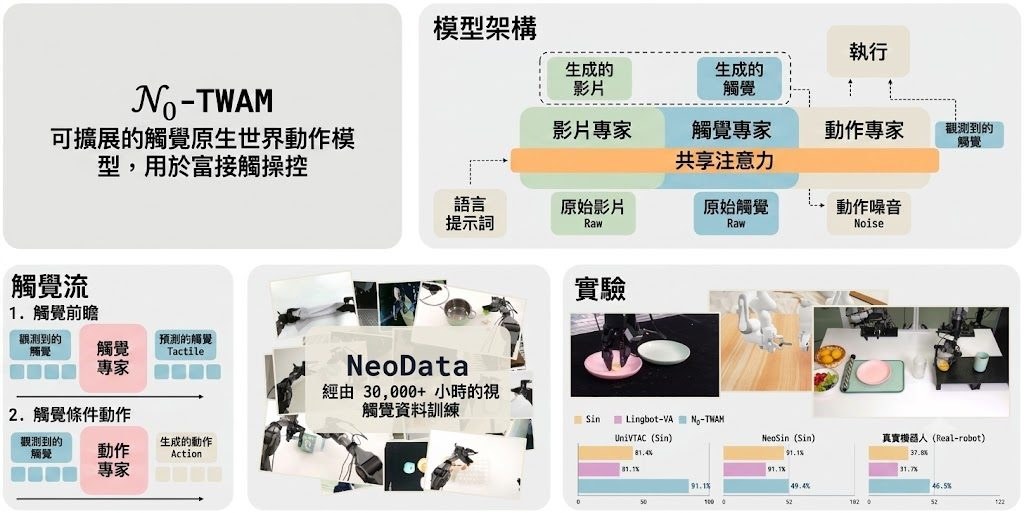
插頭有冇卡住、夾爪有冇真係受力,單靠畫面往往判斷唔完整。N0-TWAM放喺呢個空缺上處理問題:它屬於世界動作模型,將 vision、tactile 同 action 一齊建模,先推進未來會見到乜、摸到乜,再輸出低層動作,目標直指 contact-rich manipulation。

它吸引之處不只是多加一種感測,而係把觸覺當成未來狀態的一部分,而唔係事後補充訊號。相比只預測影片的 world-action model,或者直接由當前觀察回歸動作的 VLA policy,N0-TWAM更著重「預測之後再行動」;代價是系統更重,儲存庫亦只釋出 pretrained checkpoint、inference server 同 post-training toolkit,未包含大規模預訓練流程。

  • 可直接載入 pretrained checkpoint,再用自家 demonstrations 做 post-training
  • 可經 websocket 部署,由 observation 持續取回動作,也可接到自家 robot 或 simulator 做 closed-loop 控制
  • 支援 NeoSim 的 closed-loop benchmark,方便用 vision–tactile 場景驗證表現
  • 核心做法是 Mixture-of-Transformers (MoT),分開 video、tactile、action 三個 experts,再共享注意力交換資訊

模型背後沿用 WAN2.2 TI2V-5B video diffusion transformer 作 backbone,重組成三個 experts,並用 rectified-flow / flow-matching 目標聯合學習。readme 亦交代 action space 是 20-dim dual-arm end-effector,配合 tactile-aware execution,明顯不是聊天式 agent,而是面向機械臂操作與接觸控制的研究模型。

它在 UniVTAC、NeoSim 與八個 real-robot tasks 的平均成功率分別達到 84.5%、49.4% 和 46.3%。這些結果說明觸覺對高接觸操作有實質幫助;同時也要留意,部署門檻仍然偏研究導向,較適合機械人團隊、模擬環境開發者,以及已經有 demonstrations 與感測資料流的項目直接接入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 模型訓練, Video, VLA, Robotic, Dataset 數據集

Reasonix:DeepSeek AI 編碼 agent,用 cache-first 降低長會話嘅 token 成本

Reasonix 係 DeepSeek 嘅終端 AI coding agent,以 cache-first loop 壓低長會話嘅 token 成本,適合反覆改碼、工具呼叫同團隊迭代。支援 CLI/TUI、桌面、Web UI 同 ACP 編輯器整合,配合 /plan、MCP 同 sandbox 權限控制。

Reasonix

Reasonix 是 DeepSeek 一個面向桌面及終端的 AI coding agent,核心價值唔係花巧介面,而係將長會話裡不斷累積的上下文成本壓低。它適合要一路改檔、一路試工具、一路追問模型的人,特別是團隊日常做修補、重構同埋持續迭代時,對 token 成本同回合延遲都會有明顯感受。

Reasonix 主打 cache-first loop,令 prompt 前綴保持 byte-identical,配合 DeepSeek 的 prefix cache 去提升長會話命中率。項目同時提供 CLI/TUI、桌面端、local browser UI,同埋支援 ACP-compatible editor integration,部署方式亦算直接:CLI 可用 npm 安裝,桌面版則有 macOS、Windows、Linux 套件可選。

Deepseek's ~OFFICIAL Code: RIP Claude,Codex! This is CRAZY GOOD!

Reasonix 唔係純粹包住模型嘅殼,而係圍繞工具呼叫修正、成本控制同 sandbox 權限去設計。/plan 會先要求模型規劃,再進入實作;MCP(Model Context Protocol, MCP)亦作為一等入口,方便把外部工具合入同一個 registry。這種做法較適合重視可控性、可追蹤性,亦需要長時間跑 session 的開發流程。

要留意嘅係,呢條 TypeScript 線已經進入 maintenance mode,主力開發搬去 Go rewrite,同步文件亦指向 main-v2 同 migration guide。現時更合理嘅理解方式,係將佢視為一個仍可用但已凍結方向的終端編碼 agent 版本,重點價值在 cache 效率、工具整合與成本壓縮,而唔係追求最新功能擴張。

  • 長會話下,prefix cache 命中率可維持在 90%+,輸入 token 成本可明顯下降
  • 同一套引擎可喺 CLI/TUI、桌面端、Web UI 同編輯器接入使用
  • /plan、權限控制同 workspace sandbox 一齊限制工具呼叫,取向偏向可控
  • 適合經常改碼、反覆驗證、又在意推理成本嘅個人或團隊

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, DeepSeek, Vibe Coding, Mac, Linux, 編程

beautify-github-readme:GitHub README 也可以做成精美首頁

beautify-github-readme 唔係交模板咁簡單,而係教你用項目本身嘅內容同視覺語言,重寫 README 第一眼體驗。

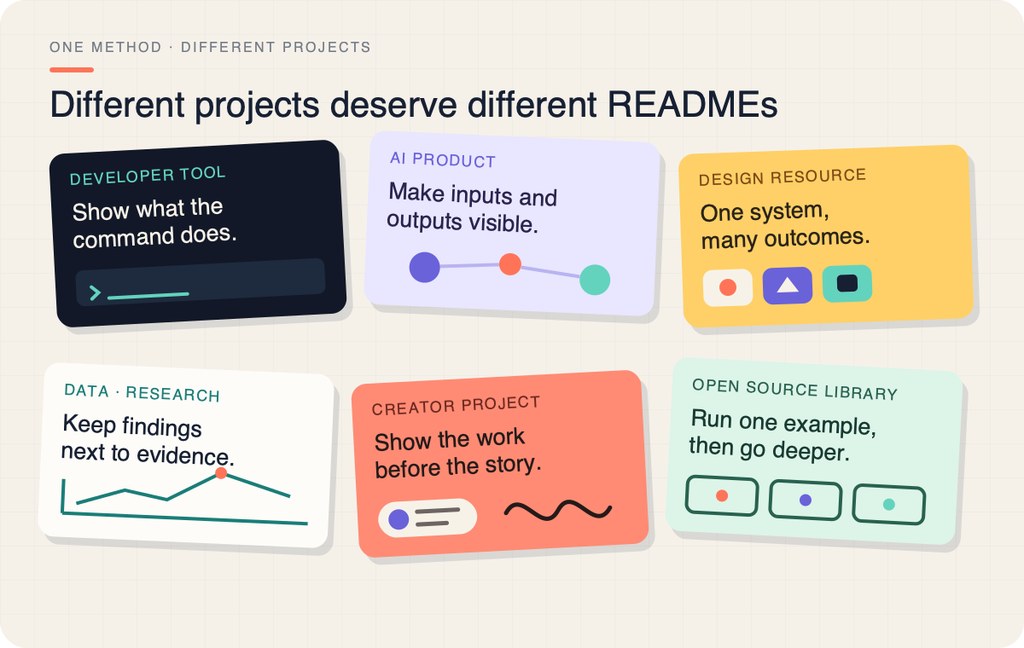
Beautify GitHub README: help visitors understand a repository at first glance.

讀者未打開程式前,往往先被 README 決定去留;beautify-github-readme 正正針對呢一步,屬於一個 README 設計與寫作 Skill,重點唔係美化排版,而係令訪客一眼睇明項目做乜、成果去到邊、應該點開始理解。

佢同常見 README 範本最大分別,在於唔追求統一風格。呢個方法會由項目自身延伸出字體、配色、構圖同證據展示,連 opening screen 都強調真實輸出,而唔係抽象口號。README 入面列出八個公開儲存庫案例,涵蓋 AI 產品、設計資源、研究與開源庫,證明佢不只是概念展示。

  • 重點唔係套版:每個 README hero 都按項目內容重新設計
  • 強調真實證據:用實際 UI、圖示、地圖、角色圖或 dashboard 截圖說明能力
  • 適合公開展示型項目:尤其係要吸引首次訪客、招募協作者或交代成果脈絡嘅團隊
  • 門檻在內容整理:要先有清楚成果、流程同視覺素材,效果先會成立

部署方式比較似參考方法而唔係可直接安裝嘅工具套件;你應該將佢理解成一套可複用的表達框架,再按自己項目改寫。對獨立開發者、開源維護者同想提升 GitHub 展示面的團隊尤其有幫助,因為佢補強咗「功能存在,但讀者三秒內睇唔明」呢個常見卡位。

限制亦相當明顯:佢未提供量化成效、A/B 測試結果或者自動化生成流程,價值主要來自案例說服力,而唔係可驗證指標。當你已經有一定內容資產,同時希望 README 更似產品入口而不只是說明文件,呢個項目比一般範本更值得參考。

GitHub

Categories: 開源, 編程, Skill 技能

Montara 本地優先影片工作台

想用同一套時間軸管理生成、剪接同輸出影片,Montara 提供咗一條幾務實嘅路。它唔靠單一雲端服務,先確保你能穩定產出真正可播放嘅 MP4。

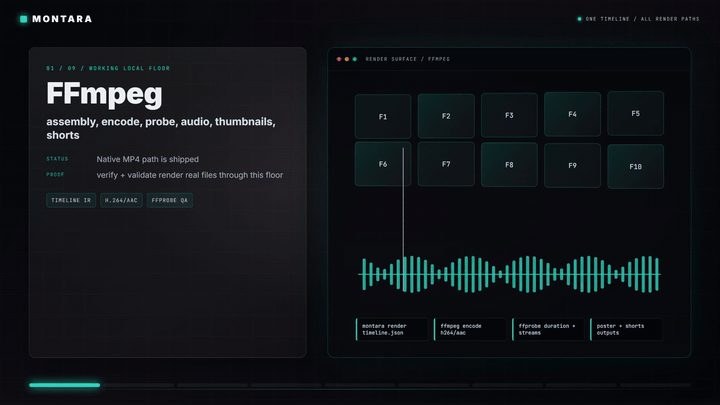
Montara engine matrix demo preview

做影片流程最麻煩,往往唔係生成一段畫面,而係素材、剪接決定、旁白、輸出格式同後續修改散落喺唔同工具。

Montara 就係朝住呢個痛點而來:一個本地優先嘅開源影片製作工具/框架,用 Timeline IR 做唯一時間軸來源,將規劃、編輯、渲染同交接串返埋。

它吸引嘅地方,在於先處理「冇雲端都要交到片」呢個現實限制。就算零 API keys,仍可經 FFmpeg 走本地 fallback 輸出可觀看 MP4,連字幕卡、語音路徑同部分媒體都預留咗本地方案;有裝 Remotion 就做 native smoke,冇裝亦會退回 FFmpeg,呢種設計比起只展示理想雲端流程嘅項目踏實得多。

同類做法常見係綁死某個生成服務或者某款剪片介面,Montara 反而把 provider 放成可插拔層,會建立 request、做 redaction、支援 dry-run 同 live-audit,但付費雲端呼叫要明確開啟。代價亦好清楚:它而家最成熟嘅係時間軸驗證、編輯操作、渲染路徑、editor bridge 匯入匯出,同埋真實 MP4 渲染與 post-render QA;README 亦講明長片規模仍屬 roadmap,唔係所有電影級工作流都已全面驗證。

  • Timeline IR 把場景計劃、剪接決定、匯入 editor cut 同生成素材收斂成一份 JSON
  • 本地路線完整,FFmpeg 係通用底線,部分 video/image/speech/music 有 fallback
  • 可匯出 EDL、OTIO、FCPXML,方便轉去 Premiere、Resolve、Final Cut 繼續做
  • provider 機制重視審計與可驗證性,適合要保留流程紀錄嘅團隊 較受惠嘅會係想把 AI 生成同傳統後期接埋嘅內容團隊、要保留本地控制權嘅創作者,或者打算讓 agent 參與影片流水線嘅開發者。

Montara 已經唔止係 demo 級拼裝,因為它把「可編輯來源」、「真實渲染結果」同「可交畀剪輯軟件接手」放埋同一條線;不過想追求高度成熟嘅長篇製作,仍要留意目前覆蓋範圍主要集中喺已測試嘅 renderer 同橋接能力。

GitHub

Categories: 開源, Agentic, API, Video, 影像處理, 框架, LTX

Page 14 of 35
1 … 12 13 14 15 16 … 35